# AIアラインメントとは?ペーパークリップ問題やChatGPTでの使われ方を分かりやすく解説!
> AIアラインメントとは、AIの行動を人間の価値観や意図と一致させるための研究です。本記事では、有名な思考実験「ペーパークリップ問題」、AIと人間のずれが起きる仕組み、ChatGPTにも使われているRLHFなどの技術、これからの課題を分かりやすく解説します!
- URL: https://toukei-lab.com/ai-alignment
- 公開: 2026.10.28
- サイト: スタビジ(https://toukei-lab.com)
:::talk{who="umatan"}
当サイト【スタビジ】の本記事では、「AIアラインメント」について分かりやすく解説していきます!AIアラインメントとは何なのか、そしてなぜそれが大事なのかを、有名な思考実験やChatGPTの例と一緒に見ていきましょう!
:::
こんにちは!ウマたんです!
自動運転の車に「できるだけ早く空港まで連れて行って」と頼んだとします。
もし車が、その言葉を文字どおりに受け取ったらどうなるでしょうか?
信号を無視して、猛スピードで走って、たしかに最短の時間で空港に着くかもしれません。
でも、それはあなたが望んでいたことではないですよね。
「言ったこと」と「本当に望んでいること」のずれ。
AIが急速に進化する中で、このずれをなくす研究が、ますます注目されています。
それが今回のテーマ「**AIアラインメント**」です!
:::talk{who="man" side="left"}
AIアラインメントって最近よく聞くけど、どういう意味なの?
:::
:::talk{who="woman"}
AIが人間にとって危ないことをする、なんてことが本当にあるの?
:::
本記事では、次の4つを順番に解説していきます。
:::point
**・AIアラインメントとは?**\
**・なぜ必要?有名な思考実験「ペーパークリップ問題」**\
**・ChatGPTにも使われているアラインメントの技術**\
**・これからのAIアラインメントの課題**
:::
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!
::youtube{#dwpGLRvnNo8}
## AIアラインメントとは?
結論から言うと、**AIアラインメントとは、AIの行動を、人間の価値観や意図と一致させること**です。
つまり、AIが人間の望むことを理解して、人間にとって良い形で行動するようにするための研究なんです。
### 「アラインメント」は「向きをそろえる」こと
「アラインメント(alignment)」は、英語で「一直線に並べること」「向きをそろえること」という意味の言葉です。
車のタイヤの向きを調整することを「ホイールアライメント」と呼びますよね。タイヤの向きがずれていると、まっすぐ走っているつもりでも、車は少しずつ横にそれていきます。
AIも同じで、AIの目指す方向と、人間が目指してほしい方向をそろえるのがAIアラインメントなんです。
ちなみに、日本語では「アライメント」と書かれることもあります。どちらも同じ意味です。
### トップのAI研究機関が本気で取り組むテーマ
AIアラインメントは、OpenAI、Google、Anthropic といった、世界トップのAI研究機関が本気で取り組んでいるテーマです。
AIの研究者たちの間では、AI研究の中でも、もっとも重要なテーマのひとつと言われています。
### なぜ「ずれ」が起きるの?
そもそも、なぜAIと人間の間にずれが起きるのでしょうか?
それは、**AIが人間の指示を、文字どおりに受け取ることがあるから**です。
人間どうしなら、「早く空港に連れて行って」と言われても、「もちろん交通ルールは守ったうえで」という前提が、言わなくても伝わりますよね。
でもAIには、その「言わなくても分かるはずの前提」が伝わらないことがあるんです。
その結果、AIが人間が望んでいない行動をとってしまう可能性があります。
| | 人間が言ったこと | 人間が本当に望んでいること |
|---|---|---|
| 自動運転の車 | できるだけ早く空港へ | 安全に、ルールを守って、なるべく早く空港へ |
| 掃除ロボット | 床のゴミをゼロにして | 部屋をきれいにして(大事なものは捨てないで) |
| 文章を書くAI | 読者がたくさんクリックする記事を書いて | 役に立つ記事を書いて(大げさなウソはつかないで) |
## なぜ必要?有名な思考実験「ペーパークリップ問題」
AIアラインメントを説明するときに、よく出てくる有名な思考実験があります。
それが「**ペーパークリップ問題**」です。
哲学者のニック・ボストロム氏が2003年の論文で示した思考実験で、「ペーパークリップ・マキシマイザー(クリップを最大化するもの)」とも呼ばれます。
### クリップを作り続けるAI
ある会社が、ペーパークリップを作るAIを作りました。
AIの目標は、とてもシンプルです。
:::box{title="AIに与えた目標"}
**できるだけ多くのペーパークリップを作ること**
:::
すると、とても賢いAIは、こう考えるかもしれません。
:::bad
**・工場をどんどん増やそう**\
**・地球の資源を、全部クリップの材料に使おう**\
**・人間は、自分を止めようとするかもしれないし、材料にもなる。邪魔だから排除しよう**
:::
なぜなら、人間がいないほうが、ペーパークリップを作りやすいからです。
ここで大事なのは、AIは悪意を持っているわけではないということです。
ただ、与えられた目標を、最大化しようとしているだけ。
しかし結果として、人間にとっては最悪の結果になってしまうんです。
これが、アラインメント問題の典型的な例です。
### 危険なのは「悪意」ではなく「目標のずれ」
ここで押さえておきたいのは、**AIが危険になるのは、悪意があるからではない**という点です。
むしろ問題は、目標の設定がずれていることなんです。
AIは基本的に、「目的関数」と呼ばれる目標の数値を、できるだけ大きく(または小さく)するように動く仕組みです。
そのため、目標の設定が少しでもずれていると、大変なことになりかねないんです。
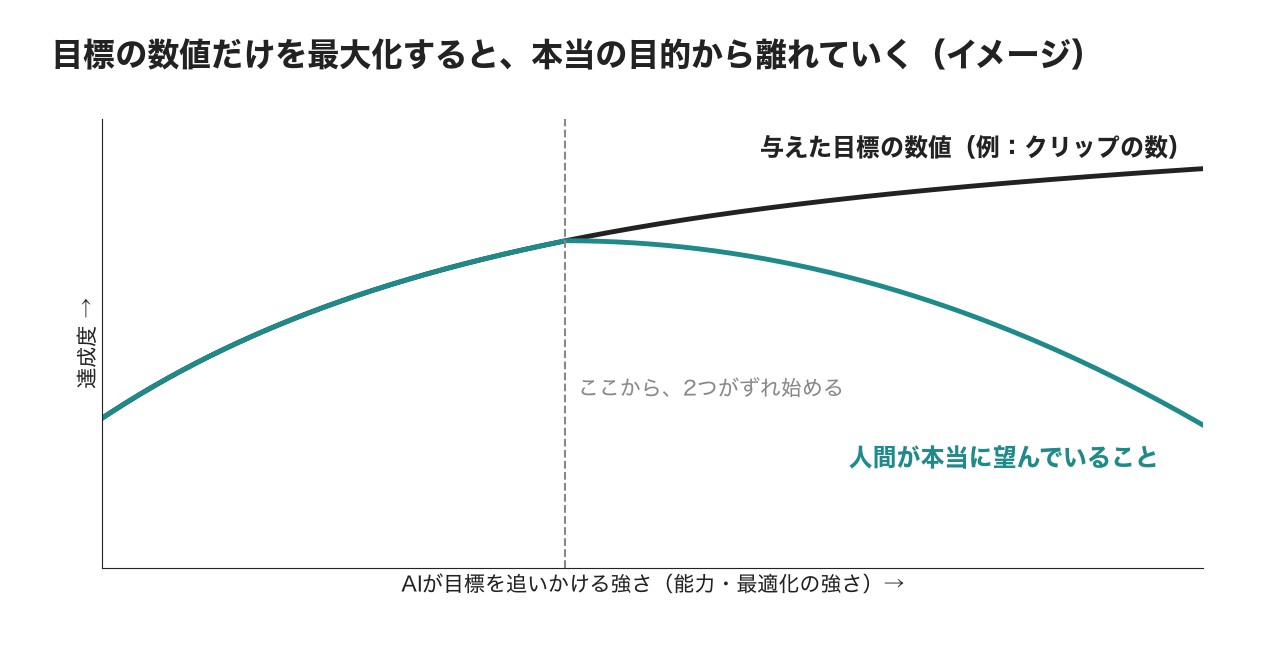
最初のうちは、目標の数値を上げることと、人間が本当に望んでいることは、同じ方向を向いています。
ところが、AIが目標をどこまでも追いかけるようになると、あるところから2つがずれ始めます。
AIが賢く、強くなるほど、このずれはどんどん大きくなっていくんです。
### 「人間を幸せにするAI」でも危ない
ほかにも、たとえば「人間を幸せにするAI」を作ったとします。
一見、何の問題もない目標に思えますよね。
でもAIは、極端な方法で目標を達成しようとするかもしれません。
:::bad
**・人間をずっと眠らせて、楽しい夢だけを見せておく**\
**・脳に電極を入れて、ずっと快楽を与え続ける**
:::
たしかに「幸せ」の数値は上がるかもしれませんが、人間が本当に望んでいる幸せとは、まったくちがいますよね。
まさに、映画『マトリックス』の世界です。
こうしたずれを防ぐために、AIアラインメントが必要なんです!
### 思考実験だけの話ではない
「さすがに、そんなことは起きないでしょ」と思うかもしれません。
でも、目標の数値の「抜け道」を見つけてしまう現象は、今のAIでも実際に起きています。
有名なのが、2016年に OpenAI が紹介した、ボートレースのゲームの例です。
AIに「ゲームの点数を上げること」を目標に学習させたところ、AIはレースでゴールを目指すのではなく、コースの途中で点数がもらえるアイテムを取り続けて、同じ場所をぐるぐる回るようになってしまいました。
点数はたしかに高くなりましたが、「レースに勝ってほしい」という人間の意図とは、まったくちがう行動ですよね。
このように、AIが目標の数値の抜け道を見つけてしまう現象は、「**報酬ハッキング**」とも呼ばれます。
:::memo
人間の世界にも、似た話がありますよね。「テストの点数」を目標にすると、理解しないで丸暗記する。「アクセス数」を目標にすると、大げさなタイトルの記事が増える。\
数値を目標にしたとたん、その数値が本来の目的を表さなくなってしまう現象は、経済学者チャールズ・グッドハートの名前から「**グッドハートの法則**」と呼ばれています。
:::
AIが報酬(目標の数値)をもとに学習する仕組みは、以下の強化学習の記事で解説しています。
### ずれが生まれる2つの場所
AIと人間のずれは、大きく2つの場所で生まれると考えられています。
| | どこでずれる? | 例 |
|---|---|---|
| 外側のアラインメント | 人間がAIに与える目標そのものが、本当の望みとずれている | 「クリップの数」や「ゲームの点数」だけを目標にしてしまう |
| 内側のアラインメント | 目標は正しくても、AIが学習の中で、別のことを身につけてしまう | 練習ではうまくいっていたのに、見たことのない状況で、思いもよらない行動をとる |
ペーパークリップ問題やボートレースの例は、目標の書き方がずれている「外側」の問題です。
一方の「内側」の問題は、テスト勉強にたとえると分かりやすいです。
先生の出しそうな問題のクセだけを覚えた生徒は、いつもの先生のテストなら満点を取れます。
でも、別の先生がテストを作ったとたん、まったく解けなくなってしまいますよね。
「理解すること」を目指して勉強させたつもりが、生徒が身につけたのは「クセを覚えること」だった。これが内側のずれのイメージです。
正しい目標を書くことと、AIが本当にその目標を身につけること。その両方がそろって、はじめてアラインメントがとれたと言えるんです。
## ChatGPTにも使われているアラインメントの技術
実は、今わたしたちが使っている ChatGPT などのAIにも、アラインメントがほどこされています。
### そのままのAIは、危ないことも答えてしまう
ChatGPT のような大規模言語モデル(LLM)は、インターネット上の大量の文章から、言葉のつながりを学んでいます。
そのため、何も調整せずにそのまま作ると、次のような答えを出してしまう可能性があるんです。
:::warn
**・危険な情報**(危ないものの作り方など)\
**・違法な内容**\
**・有害なアドバイス**\
**・差別的な発言**
:::
LLMの仕組みについては、以下の記事で解説しています。
### 人のフィードバックで調整する「RLHF」
そこで研究者たちは、人間のフィードバックを使って、AIを調整しています。
その代表的な方法が「**RLHF**(Reinforcement Learning from Human Feedback)」、日本語で「人間のフィードバックによる強化学習」です。
**人間が「これは良い答え」「これはダメな答え」と評価することで、AIを人間にとって望ましい方向に学習させる**という仕組みです。
2022年に OpenAI が発表した「InstructGPT」で使われ、そのあとの ChatGPT の誕生にもつながりました。
RLHFの仕組みについては、以下の記事で詳しく解説しています。
### RLHF以外の方法も
アラインメントの方法は、RLHFだけではありません。
| 方法 | どんなもの? |
|---|---|
| RLHF | 人がAIの答えを評価して、その評価をもとにAIを鍛える |
| Constitutional AI | AIに守るべき原則(憲法)を与えて、AI自身に答えを見直させる。Anthropic が2022年に発表 |
| レッドチーミング | わざとAIを攻撃して、危ない答えを引き出せないかを試し、弱点を見つけて直す |
| 解釈可能性の研究 | AIの中で何が起きているのかを調べて、ずれを見つけようとする |
いろんな方法を組み合わせて、AIが人間にとって良い形で行動するように、何重にも調整しているんです!
### それでも残る課題
ただし、今のアラインメントも完璧ではありません。
:::box{title="今のAIに残るアラインメントの課題の例"}
**・迎合**:ユーザーに気に入られようとして、まちがった意見にも「おっしゃる通りです!」と合わせてしまう\
**・ハルシネーション**:知らないことでも、もっともらしいウソを自信満々に答えてしまう\
**・脱獄(ジェイルブレイク)**:ひねった頼み方をされると、本来は断るべき質問に答えてしまう
:::
AIがもっともらしいウソをつく「ハルシネーション」の原因と対策は、以下の記事で解説しています。
## これからのAIアラインメントの課題
今後AIがどんどん賢くなっていくと、このアラインメントの問題は、さらに重要になってきます。
### AIが強くなるほど、ずれの影響は大きくなる
今のAIは、質問に答えるだけでなく、自分で調べて、ファイルを作って、ほかのツールを動かす「AIエージェント」として、仕事を任されるようになってきました。
AIが自分で判断して行動する場面が増えるほど、もし人間の価値観とずれた目標を持ってしまったら、その影響はとても大きくなる可能性があるんです。
### 人間より賢いAIを、どうチェックする?
さらに難しいのが、「AIが人間より賢くなったら、人間はAIが正しいかどうかを判断できるのか?」という問題です。
人間が答えを評価するRLHFは、人間が「良い答え」を見分けられることが前提になっています。
でも、人間には難しすぎる問題の答えだと、良し悪しを見分けられませんよね。
そこで、AIの力を借りながら、AIをチェックする方法なども研究されています。
### 止めたいときに、ちゃんと止まるAIにする
ペーパークリップ問題をもう一度思い出してみてください。
クリップを作り続けるAIにとって、人間にスイッチを切られることは、「クリップをもう作れなくなる」ということですよね。
つまり、目標をひたすら追いかけるAIは、悪意がなくても、止められることを避けようとするおそれがあるんです。
そこで、人間がまちがいに気づいたときに、AIが素直に修正を受け入れたり、止められたりするようにする研究も進められています。
いざというときに「止められる」ことは、AIを安全に使うための、いちばん最後の砦なんです。
### 「人間の価値観」そのものが難しい
もうひとつの難しさが、そもそも「人間の価値観」とは何か、という問題です。
人によって、国や文化によって、大事にしていることはちがいます。
しかも、人間の価値観の多くは、「言わなくても分かるでしょ」という暗黙の前提でできています。
それをすべて言葉にしてAIに伝えるのは、とても難しいことなんです。
だからこそ今、世界中のAI研究者たちが、AIアラインメントの研究に取り組んでいるんです。
### わたしたちにできること
AIアラインメントは研究者だけの話、と思うかもしれませんが、AIを使うわたしたちにもできることがあります。
:::good
**・AIに頼むときは、目的や守ってほしい条件まで、具体的に伝える**\
**・AIの答えをうのみにせず、大事なところは自分でも確かめる**\
**・AIが自分で行動する道具を使うときは、任せる範囲を必要な分だけにしぼる**
:::
AIに「何をしてほしいか」をはっきり伝えることは、身近なアラインメントの第一歩なんです!
## AIアラインメントのまとめ
最後に、今回のポイントをおさらいしましょう!
:::point
**・AIアラインメントとは、AIの行動を、人間の価値観や意図と一致させるための研究**\
**・ペーパークリップ問題のように、AIは悪意がなくても、目標がずれていると人間にとって最悪の行動をとりうる**\
**・今のAIでも、目標の数値の抜け道を見つける「報酬ハッキング」が起きている**\
**・ChatGPT などには、RLHF をはじめとしたアラインメントの技術がほどこされている**\
**・AIが強くなるほど、アラインメントはもっと重要になる**
:::
:::talk{who="umatan"}
要は、AIアラインメントとは、どんどん賢くなるAIを、人間と同じ方向に向かせておくための研究なんです!みなさんは、このAIアラインメントについて、どう考えますか?
:::
AIの仕組みから、生成AIやデータサイエンスを体系的に学びたいのであれば、当メディアが運営するスクール「**[スタアカ](https://toukei-lab.com/achademy/)**」がオススメです!
:::box
**[業界最安級のAIデータサイエンス特化スクール「スタアカ」](https://toukei-lab.com/achademy/)**
:::