# データレイク・データウェアハウス・データマートの違いとは?役割と使い分けを分かりやすく解説!
> データレイク・データウェアハウス(DWH)・データマートは、どれもデータをためておく場所ですが、役割がちがいます。本記事では、3つの違いを水にたとえたイメージ、それぞれの特徴と代表的なサービス、ECサイトや個人開発での具体例まで、図解で分かりやすく解説します!
- URL: https://toukei-lab.com/data-lake-dwh-datamart
- 公開: 2026.10.28
- サイト: スタビジ(https://toukei-lab.com)
:::talk{who="umatan"}
当サイト【スタビジ】の本記事では、「データレイク・データウェアハウス・データマートの違い」について分かりやすく解説していきます!データ分析の基盤づくりに欠かせない3つの役割を、しっかり使い分けられるようになりましょう!
:::
こんにちは!ウマたんです!
会社の中には、売上のデータ、お客さんのデータ、Webサイトのアクセスの記録など、いろいろなデータがたまっていきますよね。
でも、ただためておくだけでは、分析には使えません。
「どこに、どんな形でデータを置いておくか」をきちんと設計することが、データ活用の第一歩なんです。
そこでよく出てくるのが、「**データレイク**」「**データウェアハウス**」「**データマート**」という3つの言葉です。
:::talk{who="man" side="left"}
どれもデータを入れておく場所だよね?何がちがうのかよく分からない…
:::
:::talk{who="woman"}
データ分析の基盤をつくるときに、どう使い分ければいいのか知りたい!
:::
本記事では、次の5つを順番に解説していきます。
:::point
**・3つの違いを「水」にたとえると**\
**・データレイクとは?**\
**・データウェアハウス(DWH)とは?**\
**・データマートとは?**\
**・ECサイトや個人開発での具体例**
:::
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!
::youtube{#XGh7gT9wcBI}
## 3つの違いを「水」にたとえると
3つとも「データを入れておく場所」なので、役割のちがいが分かりにくいですよね。
まずは、データを「水」にたとえて、ざっくりとしたイメージを掴みましょう!
| | たとえると | ひとことで |
|---|---|---|
| データレイク | ありのままの水をためる、大きな湖 | 生のデータを、なんでもそのままためる場所 |
| データウェアハウス(DWH) | きれいにした水をためる、貯水タンク | 整理・加工したデータを保存する場所 |
| データマート | 目的ごとに小分けにした、水筒やペットボトル | 目的別に取り出したデータを配る場所 |
とりあえず水をためて、それをきれいにして、最後に目的別に配る。このイメージを持っておいてください!
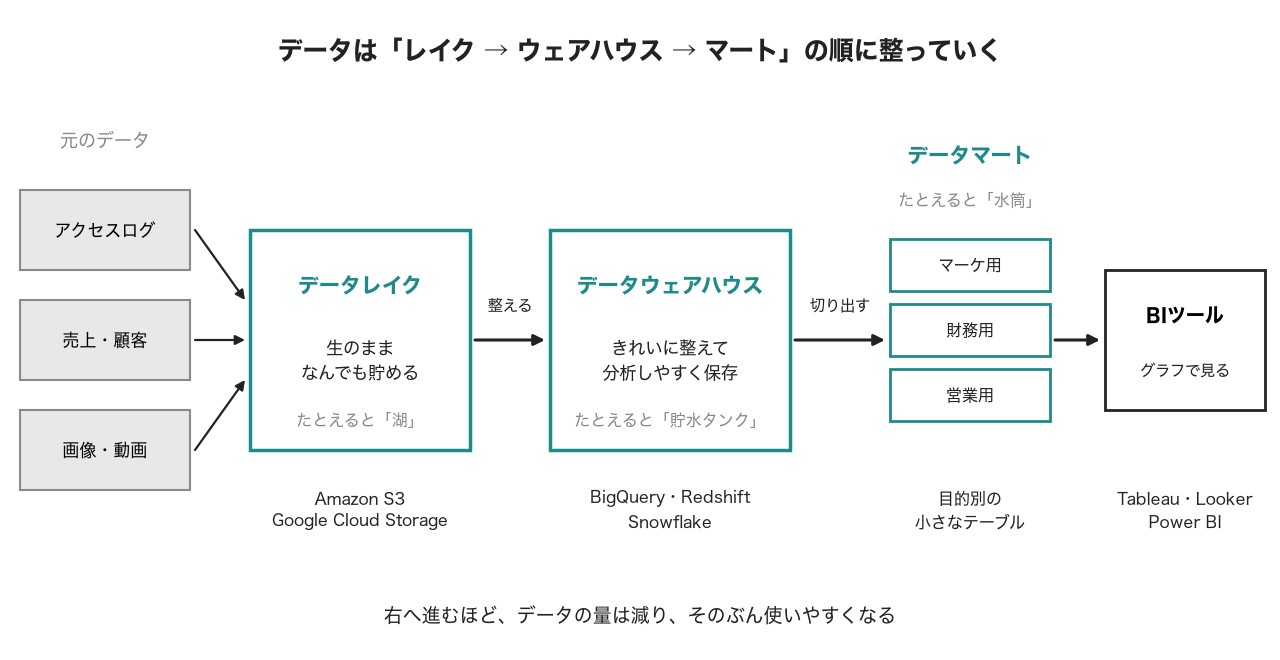
それでは、それぞれについて詳しく見ていきましょう!
## データレイクとは?
まずは**データレイク**です。
### あらゆるデータを「そのまま」ためる湖
**データレイクとは、あらゆる形式のデータを、加工せずにそのままためておく場所**です。
売上のデータ、お客さんのデータ、アプリの操作の記録(ログ)、画像や動画のファイルなど、いろいろな形式のデータを、全部まとめて、未加工のままどんどんためていきます。
まさに「データの湖」のような存在なんですね。
データの形式は、大きく3つに分けられます。
| データの形式 | どんなデータか | 例 |
|---|---|---|
| 構造化データ | 行と列のある、表の形に整ったデータ | 売上の表、会員の名簿 |
| 半構造化データ | 決まった書き方はあるが、表ほどきっちりしていないデータ | JSON形式のログ、XMLファイル |
| 非構造化データ | 決まった形のないデータ | 画像、動画、音声、文章 |
データレイクは、このどれでも受け入れられるのが強みです。
### 「あとで使うかもしれない」データを失わないために
データレイクの目的は、あとで分析やAIの学習に使うために、データを失わないようにためておくことです。
「どんな分析に使うか」が決まっていない段階でも、加工や選別をせずに、とりあえずためておきます。
あとから「この分析がしたい」となったときに、元のデータが残っていれば、いつでも取り出して使えるわけですね。
代表的なサービスとしては、Amazonの「**Amazon S3**」や、Googleの「**Google Cloud Storage**」が有名です。
:::warn
何も考えずにためるだけだと、どこに何のデータがあるのか誰にも分からない「**データスワンプ(データの沼)**」になってしまいます。データの説明や置き場所のルールを決めて、管理しておくことが大切です。
:::
## データウェアハウス(DWH)とは?
次に、**データウェアハウス**です。英語の「Data WareHouse」の頭文字をとって、「**DWH**」とも呼ばれます。
### 分析しやすく整えたデータの倉庫
**データウェアハウスとは、データレイクなどから必要なデータを取り出して、分析しやすい形に整えて保存しておくデータベース**のことです。
「ウェアハウス」は、英語で「倉庫」という意味です。つまり、加工済みのデータの倉庫なんですね。
データウェアハウスでは、次のような作業をしてデータを整えます。
:::box{title="データウェアハウスでの主な作業"}
**・形をそろえる**:日付の書き方や、商品のコードの表し方を統一する\
**・きれいにする**:重複したデータや、明らかなまちがいを取りのぞく\
**・つなぎ合わせる**:売上のデータと商品のデータを、商品のコードでつなぐ\
**・速く検索できるようにする**:大量のデータでも、すばやく集計できる形で保存する
:::
### SQLで、すぐに集計できる
データウェアハウスに整えておくと、**SQL**という言葉で問い合わせるだけで、集計がすぐにできるようになります。
たとえば、「今月の商品の売上トップ10」を出すなら、次のように書きます。
```sql
SELECT
product_name,
SUM(amount) AS sales
FROM sales
WHERE order_date >= '2026-10-01'
GROUP BY product_name
ORDER BY sales DESC
LIMIT 10;
```
データが整っているからこそ、こうした集計がすぐにできるんです。
SQLの基本となるSELECT文については、以下の記事で解説しています。
代表的なサービスとしては、Googleの「**BigQuery**」、Amazonの「**Amazon Redshift**」、「**Snowflake**」などがあります。
## データマートとは?
最後に、**データマート**です。
### 部署や目的ごとに取り出したデータ
**データマートとは、データウェアハウスから、特定の部署や目的ごとに必要なデータだけを取り出したもの**です。
「マート」は、英語で「市場、お店」という意味です。必要なデータを、必要な人にすぐ届けるお店のようなイメージですね。
| データマート | まとめるデータの例 |
|---|---|
| マーケティング部のデータマート | 広告の効果、お客さんの年代や地域などの属性 |
| 財務部のデータマート | 支出、収益、予算と実績のちがい |
| 営業部のデータマート | 顧客のリスト、担当者ごとの販売の実績 |
つまり、現場の担当者が、必要なデータだけをすぐに見られるようにする場所こそがデータマートなんです!
データウェアハウスには、会社中のデータが入っていて、とても大きく複雑です。全部をそのまま現場の人に渡しても、どこを見ればいいのか分かりませんよね。
だからこそ、目的ごとに小さく切り出して渡すわけです。
### BIツールとつないで使う
データマートは、**BIツール**とつないで使われることが多いです。
BIツールとは、データをグラフや表にして、ひと目で分かるように見せてくれる道具のこと。「**Tableau**」「**Looker**」「**Power BI**」などが有名です。
Googleが無料で提供している「Looker Studio」もよく使われます。使い方は以下の記事で解説しています。
## 3つの違いを比べてみよう
ここまでの内容を、表で整理しておきましょう!
| | データレイク | データウェアハウス | データマート |
|---|---|---|---|
| 役割 | 生のデータをそのまま貯める | データをきれいに整えて保存する | 目的別に分けてデータを配る |
| データの状態 | 未加工。形式もバラバラ | 加工済み。形がそろっている | 目的に合わせて集計・絞りこみ済み |
| データの量 | とても多い | 多い | 少ない |
| 主に使う人 | データエンジニア、データサイエンティスト | データアナリスト | 各部署の担当者 |
| 代表的なサービス | Amazon S3、Google Cloud Storage | BigQuery、Redshift、Snowflake | DWHの中のテーブル+BIツール |
データは「レイク → ウェアハウス → マート」という流れで、だんだん整理・最適化されていくんですね!
### データを運んで整える「ETL」と「ELT」
データを、元の場所からデータウェアハウスへ運んで整える処理は、「**ETL**」や「**ELT**」と呼ばれます。
:::box
**・Extract(抽出)**:元のシステムやデータレイクから、データを取り出す\
**・Transform(変換)**:データの形をそろえたり、集計したりする\
**・Load(格納)**:データウェアハウスに入れる
:::
昔は、データウェアハウスに入れる前に整える「ETL」の順番が主流でした。
最近は、BigQueryのようなクラウドのデータウェアハウスの計算の力が大きくなったので、先にそのまま入れてしまって、データウェアハウスの中で整える「ELT」の順番もよく使われています。
## 具体例で見てみよう
### ECサイトの場合
たとえば、ネットでものを売っているECサイトの会社を想像してみましょう。
まず、サイトのアクセスの記録や購入の履歴を、全部データレイクに保存します。
アクセスの記録は、たとえば次のような形で、1回のアクセスごとに1行ずつたまっていきます。
```json
{"time": "2026-10-01T10:15:03", "user": "u123", "page": "/item/45", "ad": "campaign_a"}
{"time": "2026-10-01T10:15:40", "user": "u123", "event": "purchase", "item": 45, "price": 3980}
```
そこからデータウェアハウスで、「売上 × 商品のカテゴリー × 期間」のような、分析しやすい表に整えます。
| 日付 | 商品のカテゴリー | 広告 | 売上(円) |
|---|---|---|---|
| 2026-10-01 | キッチン用品 | campaign_a | 128,400 |
| 2026-10-01 | 文房具 | campaign_b | 45,200 |
さらに、マーケティングのチーム向けに、キャンペーンの分析専用のデータマートをつくります。
| 広告 | 売上(円) | 購入した人の数 |
|---|---|---|
| campaign_a | 1,250,000 | 312 |
| campaign_b | 830,000 | 205 |
こうしておけば、マーケティングのチームは「どの広告がいちばん売上に貢献したか」をすぐに分析できるんです!
### 個人開発のサービスの場合
ちなみに、僕が友人と個人開発している本のレビューのサービス「[Yomeru(ヨメル)](https://yomeru.jp/)」でも、この3つの考え方を使っています。
:::box{title="Yomeruのデータの流れ(動画を撮った時点の構成)"}
**・データレイク**:Google Cloud Storageにデータをためる\
**・データウェアハウス**:BigQueryに取りこんで、加工・集計の処理をする\
**・データマート**:BigQueryの中に、目的別のテーブルをつくる\
**・BIツール**:その一部を、Looker Studioにつないでグラフで見る
:::
このように、データウェアハウスとデータマートは、別々のサービスではなく、同じBigQueryの中で「層」として分けて管理することも多いです。
BigQueryの中でのデータの加工・集計には、「dbt」という道具がよく使われます。
## 最近の流れ:データレイクハウス
最近は、データレイクとデータウェアハウスのいいところを1つにまとめた「**データレイクハウス**」という考え方も広がっています。
データレイクのように、いろいろな形式のデータを安くためておきながら、データウェアハウスのように、SQLですばやく分析もできる、というものです。
Databricksなどのサービスがこの考え方を打ち出していて、BigQueryやSnowflakeも、データレイクに置いたファイルをそのまま分析できる機能を備えています(2026年10月時点)。
ただ、「生のデータ → 整えたデータ → 目的別のデータ」と、段階を分けて整えていく考え方そのものは変わりません。まずはこの3つの役割をしっかりおさえておきましょう。
データをどう管理していくかの全体像は、データマネジメントの教科書「DMBOK」に沿って解説した、以下の記事も参考にしてみてください。
## データレイク・データウェアハウス・データマートの違いのまとめ
最後に、今回のポイントをおさらいしましょう!
:::point
**・データレイクは、あらゆるデータを生のままためる「湖」**\
**・データウェアハウスは、データをきれいに整えて保存する「貯水タンク」**\
**・データマートは、目的別に取り出してデータを配る「水筒」**\
**・データは「レイク → ウェアハウス → マート」の順に、だんだん整理・最適化されていく**
:::
:::talk{who="umatan"}
要は、生のデータをためて、きれいにして、目的別に配る、という流れなんです!データエンジニアリングやデータマネジメントでとても大事な考え方なので、ぜひ実際に自分でデータの構造を設計して、手を動かしてみてください!
:::
データの集め方・整え方から分析まで、体系的に学びたいのであれば、当メディアが運営するスクール「**[スタアカ](https://toukei-lab.com/achademy/)**」がオススメです!
:::box
**[業界最安級のAIデータサイエンス特化スクール「スタアカ」](https://toukei-lab.com/achademy/)**
:::