# ディープラーニングでできることとできないこと!Pythonでの実装例とともに見ていこう!
> 当サイト【スタビジ】の本記事では、ディープラーニングができることとできないことについて適宜Pythonでの実装例をはさみながら解説していきます。何でも出来ると思われがちなディープラーニングについてちゃんと理解しておきましょう!
- URL: https://toukei-lab.com/deep-learning-can
- 公開: 2022.11.29 / 更新: 2024.11.25
- サイト: スタビジ(https://toukei-lab.com)
:::talk{who="umatan"}
当サイト【スタビジ】の本記事では、ディープラーニングでできることとできないことについて適宜Pythonでの実装例をはさみながら解説していきます。何でも出来ると思われがちなディープラーニングについてちゃんと理解しておきましょう!
:::
こんにちは!
データサイエンティストのウマたん([@statistics1012](https://twitter.com/statistics1012?lang=ja))です。
最近はどっぷり**ディープラーニング**に浸かっています。
ディープラーニングと聞くとどんなイメージを持ちますか?
**なんでもできる魔法のような技術?**
いえいえそんなことはありません。
ディープラーニングは何でもできるように世間でもてはやされていますが、もちろん出来ることと出来ないことがあります。
:::talk{who="robotan"}
んー、たしかにブラックボックスで中身がよく分からないイメージ・・
:::
:::talk{who="umatan"}
そうだよねー!出来ることと出来ないことを明確に分けることでディープラーニングの全貌がクリアになるよ!
:::
少しでもディープラーニングについて多くの人に理解して欲しい!
ということで、この記事ではディープラーニングができることとできないことについてまとめていきます!
ところどころで実装例も一緒に紹介していきますよー!
:::box{title="読み飛ばしガイド"}
・[ディープラーニングと機械学習/AIの違い](#ディープラーニングと機械学習aiの違いは)\
・[ディープラーニングができること](#ディープラーニングができることまとめ)\
・[ディープラーニングができないこと](#ディープラーニングができないこと)\
・[ディープラーニングを学ぶ方法](#ディープラーニングを学ぶ方法)
:::
## ディープラーニングとは
まずは、ディープラーニングとは一体何なのか、大枠からとらえていきましょう!
:::talk{who="umatan"}
動画でも10分ほどで分かりやすく解説しているのでぜひチェックしてみてください!
:::
::youtube{#i2jqy0gCfXk}
ディープラーニングの原型となる「[ニューラルネットワーク](/nn)」の理論は実は1940年~1950年の間に既に確立されているんです。
:::talk{who="robotan"}
え!?そんなに昔からあるの!?
:::
:::talk{who="umatan"}
そうなんだよー、最新の技術だと思われているんだけど既に理論自体はだいぶ昔から確立されていたんだ!
:::
人間の神経が信号を伝播させていくように、ある入力を次の層へと重み付けをして伝播させていき出力を求めます。 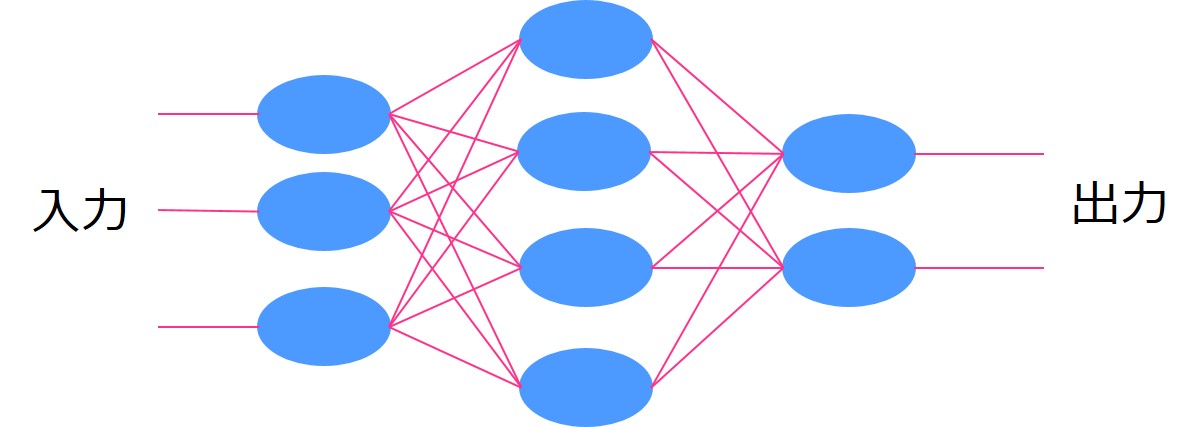
:::talk{who="robotan"}
なんで今さら50年以上も前の手法が注目されてるの?
:::
:::talk{who="umatan"}
当時の状況では層を積み重ねていくことができなかったんだ!
:::
この層を多層にしていくのがディープラーニングなのですが、当時のマシンパワーでは計算量が膨大過ぎて実現不可能でした。
計算負荷を軽減する[誤差逆伝播法(バックプロパゲーション)](/backpropagation)などの計算手法の登場やマシンパワーの増強により現在に至ります。
そんな計算負荷の問題が解消され深層ニューラルネットワーク(ディープラーニング)が日の目を浴びたのは**2006年**。
このブレークスルーによって再びAIのブームが巻き起こり、第3次AIブームへと突入していくのです。
AIの歴史については以下の記事でまとめていますのでよければご覧ください!
実は、ディープラーニングはアルゴリズム自体は非常にシンプルで昔からある手法なんですねー。
ディープラーニングの詳しくアルゴリズムや仕組みに関しては以下の記事でまとめていますのでチェックしてみてください!
## ディープラーニングと機械学習・AIの違いは?
さて、ではそんな**ディープラーニングと機械学習やAI**は何が違うのでしょうか?
結構違いがあやふやで間違った使われ方をしていることもあるのですが、定義は以下のような図のようになっています。
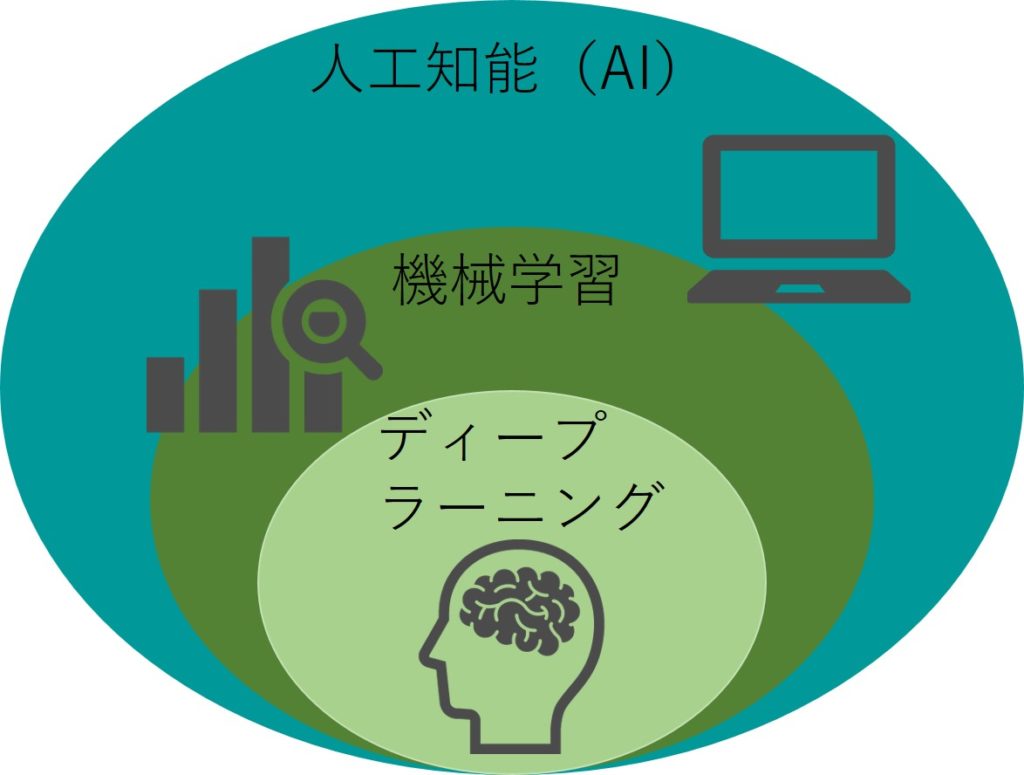
実はAIの中に機械学習があって機械学習の中にディープラーニングがあるという関係なんですねー。
AIというとディープラーニングを思い浮かべるという場合もありますが、本来の定義ではAI=ディープラーニングではないのです。
もちろんAIがディープラーニングを指している文脈もありますので注意が必要です。
機械学習の中には大きく分けて
:::box
**・教師あり学習** **・教師なし学習** **・強化学習**
:::
の3つがありますが、それぞれに属する可能性があるのがディープラーニング。
ディープラーニングは深層学習とも言われるので教師ありなし学習などと並列かと思いきや、別なんですねー。
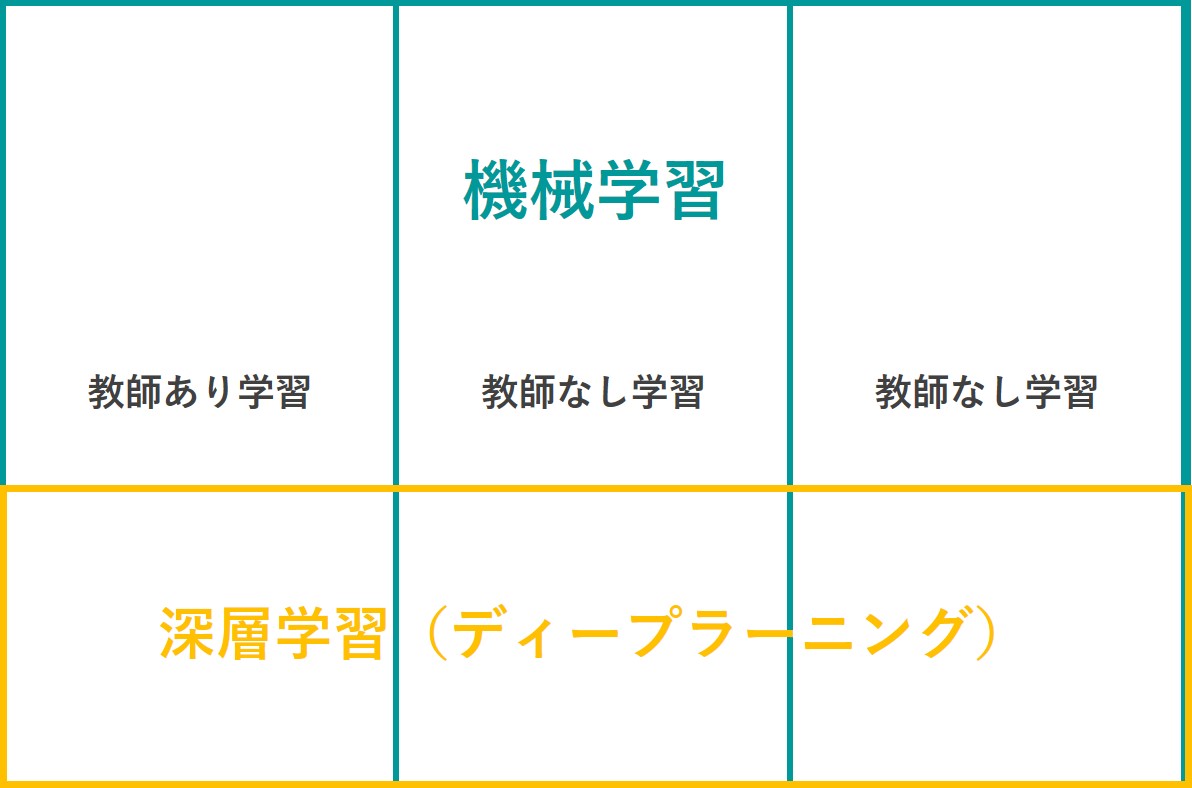
**教師あり学習・教師なし学習**については以下の記事でまとめています。
ディープラーニングと機械学習・AIはごっちゃにされてしまうことが多いので、違いを明確に理解しておきましょう!
以下の記事でディープラーニングと機械学習の違いをより詳しくまとめていますのでぜひチェックしてみてください!
## ディープラーニングでできることを事例と共に紹介
ディープラーニングの概念や機械学習やAIとの違いが分かったところで、ディープラーニングを用いて実際にどんなことが実現できるのかまとめていきたいと思います!
### 画像を識別
ディープラーニングと言えば、**[画像認識](/python-image)!!**
犬と猫の画像を大量にインプットさせて学習することで、人間と同程度の識別能力を発揮することができるという例はよく耳にするディープラーニングの定番ですね。
画像のピクセルを特徴量としてインプットさせるので、基本的な機械学習手法の分類問題として解くことも可能です。
ただ、ディープラーニングに畳み込み層と組み合わせた[CNN(畳み込みニューラルネットワーク)](/cnn)によって、複雑な画像に対してもより高い精度を出力することが可能になっています。
実際にCNNをPythonで実装してみましょう!
ここで使用するのはMnistという手書き文字のデータセット。 Mnistは「[Gradient-based learning applied to document recognition](http://yann.lecun.com/exdb/publis/pdf/lecun-01a.pdf)」で用いられたデータセットであり、現在でも多くの論文で用いられています。
Modified National Institute of Standards and Technologyの略であり、0\~9の数字が手書き文字として格納されているデータセットです。
学習用に60000枚、検証用に10000枚のデータセットが格納されています。
```python title="Deep-learning.py"
import numpy as np
from sklearn.model_selection import train_test_split
import tensorflow as tf
from tensorflow.keras.datasets import mnist
from tensorflow import keras
from tensorflow.keras.layers import Dense, Activation
from tensorflow.keras.models import Sequential
from tensorflow.keras.utils import to_categorical
# Kerasに付属の手書き数字画像データをダウンロード
np.random.seed(0)
(X_train_base, labels_train_base), (X_test, labels_test) = mnist.load_data()
# Training set を学習データ(X_train, labels_train)と検証データ(X_validation, labels_validation)に8:2で分割する
X_train,X_validation,labels_train,labels_validation = train_test_split(X_train_base,labels_train_base,test_size = 0.2)
# 各画像は行列なので1次元に変換→X_train,X_validation,X_testを上書き
X_train = X_train.reshape(-1,784)
X_validation = X_validation.reshape(-1,784)
X_test = X_test.reshape(-1,784)
#正規化
X_train = X_train.astype('float32')
X_validation = X_validation.astype('float32')
X_test = X_test.astype('float32')
X_train /= 255
X_validation /= 255
X_test /= 255
# labels_train, labels_validation, labels_test をダミー変数化して y_train, y_validation, y_test に格納する
y_train = to_categorical(labels_train)
y_validation = to_categorical(labels_validation)
y_test = to_categorical(labels_test)
# パラメータの設定
n_features = 784
n_hidden = 100
bias_init = 0.1
# 学習率
rate = 0.01
# Sequentialクラスを使ってモデルを準備する
model = Sequential()
# 隠れ層を追加
model.add(Dense(n_hidden,activation='relu',input_shape=(n_features,)))
model.add(Dense(n_hidden,activation='relu'))
model.add(Dense(n_hidden,activation='relu'))
# 出力層を追加
model.add(Dense(10,activation='softmax'))
# TensorFlowのモデルを構築
model.compile(optimizer=tf.optimizers.Adam(rate),
loss='categorical_crossentropy', metrics=['mae', 'accuracy'])
# Early stoppingを適用してフィッティング
log = model.fit(X_train, y_train, epochs=3000, batch_size=100, verbose=True,
callbacks=[keras.callbacks.EarlyStopping(monitor='val_loss',
min_delta=0, patience=10,
verbose=1)],
validation_data=(X_validation, y_validation))
# Test dataで予測を実行。
pred_test = model.predict_classes(X_test)
validation = (pred_test == labels_test)
size = validation.size
size
correct = np.count_nonzero(validation)
print(f"{correct}/{size} correct ({correct*100/size:.3f}%)")
```
詳細は省きますが、最終的にテストデータに対して**96.96%の精度**を算出することができました。
なかなか判別の難しい手書き文字も入っているのでなかなかの精度。
[パラメータチューニング](/hyper-para-tuning)を頑張ることで精度を99%くらいまで持っていくことが可能です。
以下の記事で詳しくまとめています。
ちなみに機械学習手法の中で[データ解析コンペ](/data-competition)でよく使われる**勾配ブースティング手法**でも同様のMnistのデータを分類させて精度を比較しているのでぜひチェックしてみてください!
結果だけ見ると、
:::box
**Xgboost>LightGBM>ディープラーニング(CNN)>Catboost**
:::
となってます。
どれも非常に高い精度を誇っており、シンプルに実装しているのでもう少しパラメータチューニングをすることで精度の逆転は全然あり得ます。
体感としてはライトに実装するならLightGBM、本気で精度求めるならCNNかなーという感じ。
### 文脈を読み取る
ディープラーニングを用いて文章を予測したり文脈を読み取ることが可能です。
そしてそのような手法群は専門用語では**自然言語処理**と言われます。
実は、文脈を読み取ることは過去データの流れから未来のデータを予測することになるので、広義では時系列問題となるんですねー!
そこで登場するのが**Recurrent neural network(再帰型ニューラルネットワーク)**。
**RNN**と略されて呼ばれます。
今までのディープラーニングでは、時系列要素はなくシンプルにいくつかの同列要素のインプットに対して重みパラメータを変化させて出力を調整します。
RNNでは同一の中間層を用いて再帰的にインプットが行われます。
再帰的という部分がReccurentと言われるゆえんです。
こんなイメージ
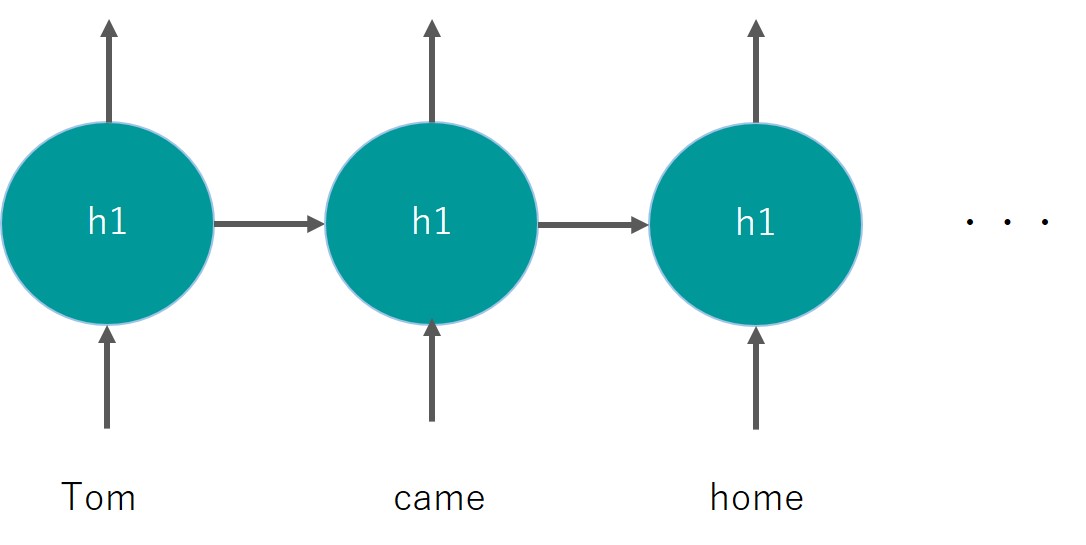
同じレイヤーh1を用いているのがミソです。
なんとなーく、こんなもんなんだなーくらいの理解で大丈夫です。
Google翻訳や音声AIなどにもRNNの概念が用いられています。
テキストであろうが音声であろうが、文脈を読み取る技術にディープラーニングが用いられているんですね。
RNNを用いて時系列問題を解いてみましょう!
使うデータセットはKaggleのホームページが落とせる航空会社の乗客数データ!
:::box{title="参考サイト"}
[Kaggle-“Air Passenger”](https://www.kaggle.com/rakannimer/air-passengers)
:::
1949年から1960年までの月別乗客数がデータとして入っています。
149行2列のシンプルなデータセット。
1変数の時系列データを基に過去のデータから未来の値を予測します。
この時、tflearnというライブラリを使ってRNN(正確には[LSTM](/lstm))を実装していきます。tflearnは[keras](/keras)と似たようなライブラリでディープラーニングの実装が感覚的に容易にできます。
実際にモデルを構築していきましょう!
```python title="rnn_airplane.py"
import tensorflow
import tflearn
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
tensorflow.reset_default_graph() #モデルを初期化
df = pd.read_csv('AirPassengers.csv',usecols=[1])
dataset = df.values
dataset = df.astype('float32')
dataset = (dataset - np.min(dataset))/(np.max(dataset)-np.min(dataset))
dataset = np.array(dataset)
def create_dataset(dataset, steps_of_history, steps_in_future):
X, Y = [], []
for i in range(0, len(dataset)-steps_of_history, steps_in_future):
X.append(dataset[i:i+steps_of_history])
Y.append(dataset[i + steps_of_history])
X = np.reshape(np.array(X), [-1, steps_of_history, 1])
Y = np.reshape(np.array(Y), [-1, 1])
return X, Y
def split_data(x, y, test_size=0.1):
pos = round(len(x) * (1 - test_size))
trainX, trainY = x[:pos], y[:pos]
testX, testY = x[pos:], y[pos:]
return trainX, trainY, testX, testY
steps_of_history = 1
steps_in_future = 1
X, Y = create_dataset(dataset, steps_of_history, steps_in_future)
trainX, trainY, testX, testY = split_data(X, Y, test_size = 0.33)
net = tflearn.input_data(shape=[None, steps_of_history, 1])
net = tflearn.lstm(net, n_units=6)
net = tflearn.fully_connected(net, 1, activation='linear')
net = tflearn.regression(net, optimizer='adam', learning_rate=0.001,
loss='mean_square')
model = tflearn.DNN(net, tensorboard_verbose=0)
model.fit(trainX, trainY, validation_set=0.1, batch_size=1, n_epoch=150)
test_predict = model.predict(testX)
rmse = np.sqrt(np.mean((test_predict-testY)**2))
print(rmse)
```
最終的な評価はRMSE(Root Mean Square Error)で算出しています。
RMSEは0.10079201となりました。
それなりに良い予測ができてる!
RNNについては以下の記事で詳しくまとめていますのでチェックしてみてください!
自然言語処理では、Googleが2019年に正式にアルゴリズム導入を決めたBERTについてもあわせてチェックしておくと理解が深まるでしょう!
Pythonで実際に文章予測を行ってます。
### 画像→テキスト生成
そんなディープラーニングの画像識別の技術と文脈予測の技術を組み合わせることで、画像から自動的にテキストを生成することが可能です。
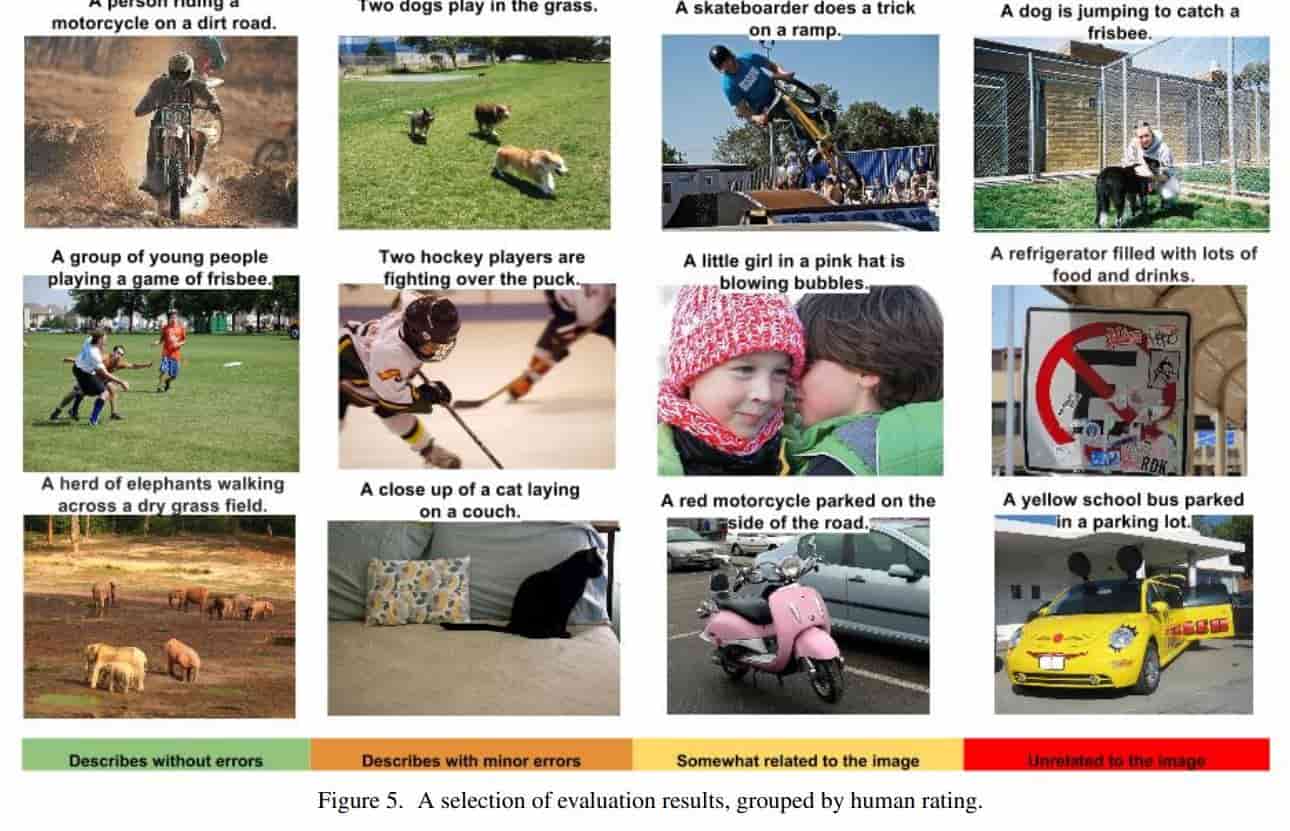(引用元:Google-“[Show and Tell: A Neural Image Caption Generator](https://www.cv-foundation.org/openaccess/content_cvpr_2015/papers/Vinyals_Show_and_Tell_2015_CVPR_paper.pdf)“)
これを見るとかなりの高精度で画像データを読み取りテキスト変換することが出来ていることが分かります。
:::talk{who="robotan"}
わー!ほんとだ!こんなに高精度なのか!ディープラーニングってすごいなー!
:::
:::talk{who="umatan"}
すごいでしょー!もうこんなことも出来るようになっているんだよー!
:::
### フェイク画像生成
続いて、GAN(敵対的生成ネットワーク)という手法によって存在しない画像を生成することが可能です。
実際に存在しないホテルの部屋の画像を生成したのが以下になります。
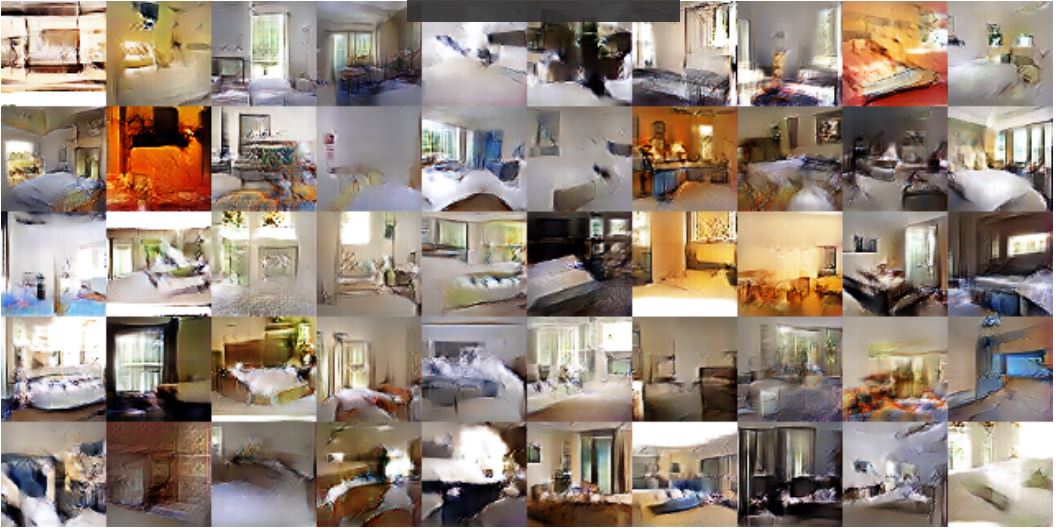
(引用元: Google-“[UNSUPERVISED REPRESENTATION LEARNING WITH DEEP CONVOLUTIONAL GENERATIVE ADVERSARIAL NETWORKS](https://arxiv.org/pdf/1511.06434.pdf)” )
:::talk{who="robotan"}
なんだこれはー!!本物にしか見えない!!
:::
:::talk{who="umatan"}
まさかこれが実在しないホテルの部屋だとは誰も思わないよねー!
:::
GANでは2つのニューラルネットワークを使います。片方がGenerator、もう片方がDiscriminator。
Generatorが生成した偽物のデータと実際に存在する本物のデータをDiscriminatorに判別させ、 Discriminatorが上手く判別できないようなデータを Generator が生成していきます。
Discriminatorはどんどん判別の難しくなるデータを上手く判別できるようにしていきます。
この学習が進むと最終的にGeneratorが生成される画像は本物にきわめて近くなっているという手法です。
実際の写真にゴッホのタッチを合成することも可能なんです。
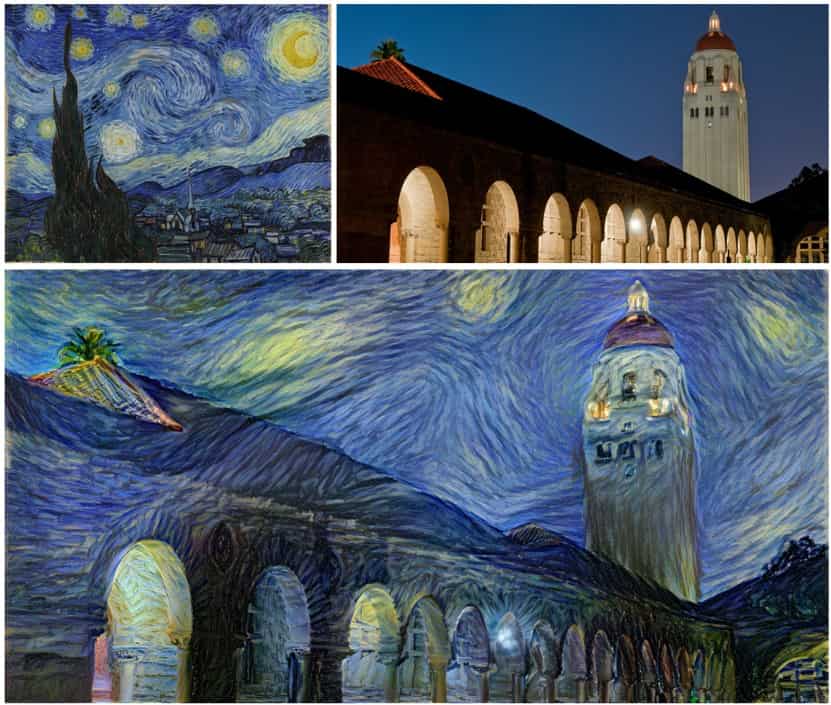
(引用元:)
:::talk{who="robotan"}
なんじゃこれ!!こんなこともできるのかー。
:::
:::talk{who="umatan"}
人間にできることを超越してきているのが現状なんだ!
:::
GANについて詳しくは以下の記事で解説しています!
こうした技術で作られた偽の映像「ディープフェイク」の被害や見分け方は、以下の記事で解説しています。
### 最適化
囲碁でAIが人間を負かしたのは記憶に新しいと思います。
そのAIのアルゴリズムに搭載されているのがこの「Deep Q Network」。
強化学習であるQ-Learningにディープラーニングを応用した作りになっています。
強化学習自体は、ゲームのCPUの動きに適応されるなど既に様々な分野で実装されていました。
しかし、強化学習はそもそも学習に時間がかかるため行動パターンが複雑だと解を導くことができません。
囲碁は19×19もの数の交点があり、状態(s)と行動(a)のパターンが膨大です。
そこで登場したのがディープラーニング。
ディープラーニングとQ学習を組み合わせたDeep-Q-networkという手法が開発され、それを基にプロ棋士をも凌駕する人工知能Alpha Goが作られたのです。
## ディープラーニングができないこと
ここまででディープラーニングができることについて徹底的にまとめてきましたが、まだまだディープラーニングができないことは多くあります。
現在の延長線上では、ディープラーニングが真の人工知能を実現できるとは思えません。
:::tweet{url="https://twitter.com/statistics1012/status/1216853654533111808?ref_src=twsrc%5Etfw"}
ダーウィンの進化論は、
・生物は突然変異(一種のエラー)が稀に起きる\
・その変異が現環境に優位だとその種が生き残る
優位な特性が得られるように変異してきたわけじゃなくて、悪い変異もめちゃくちゃ起こるんです。
つまり、様々な変異が起きるようにプログラムしないと真の人工知能はあり得ない
— ウマたん@スタビジ (@statistics1012) [January 13, 2020](https://twitter.com/statistics1012/status/1216853654533111808?ref_src=twsrc%5Etfw)
:::
そのため論点として、ディープラーニングができないことは、
:::box
**・現在のディープラーニングの延長線上で実現可能だけど現在できていないこと**\
**・現在のディープラーニングの延長線上では実現不可能なこと**
:::
の2つに分けて考えた方がいいです。
### 延長線上で実現可能だけど現在できていないこと
この領域に関してはいろいろとあると思います。
例えば、**音声分離の問題**がありますねー。
現在音声AIの技術は日々進歩していますが、複数人が話している音声を上手く分離して聞き取ることはほぼ不可能です。
:::tweet{url="https://twitter.com/statistics1012/status/1223012634301087744?ref_src=twsrc%5Etfw"}
音声認識の課題は話者分離
単独話者のスピーチなどは相当精度が上がってきてるけど、多数での会話を話者分離して音声認識するのはまだまだハードルが高い
— ウマたん@スタビジ (@statistics1012) [January 30, 2020](https://twitter.com/statistics1012/status/1223012634301087744?ref_src=twsrc%5Etfw)
:::
また、**自動運転や翻訳などの精度**もまだまだ完璧ではありません。
ただここら辺の技術は精度が向上していけば実現するのは時間の問題ですね。
### 延長線上では実現不可能なこと
現在の延長線上では、ディープラーニングはどう考えても人間以上の知能を得ることはできません。
ある種、過去にデータのあることは見通すことが出来ても過去に事例のないケースはディープラーニングでは予測不可能なんです。
さらにあえて過去の成功を踏襲せず失敗に踏み込むことが大きな成功につながることがあります。
:::tweet{url="https://twitter.com/statistics1012/status/1216855706940239872?ref_src=twsrc%5Etfw"}
前のアリが辿った経路を完璧に辿れる優秀なアリだけのアリ塚と、ランダムで経路を間違えるダメアリが混ざったアリ塚で、どっちがエサを効率的に運べるか・・・実は後者
思わぬミスが最適経路の発見に繋がるんです
一定のエラーは全体最適になる
完璧な個体だけの人工知能は全体最適にならない
— ウマたん@スタビジ (@statistics1012) [January 13, 2020](https://twitter.com/statistics1012/status/1216855706940239872?ref_src=twsrc%5Etfw)
:::
アリの世界でさえ局所的な失敗は大局的な成功につながるんです。
そんな観点から考えると、クリエイティブな職能に関してはどれもディープラーニングでは実現できないでしょう。
例えば、起業家・経営者・クリエイティブディレクターなどなど・・・
そして音楽家・芸術家・政治家などの職能もディープラーニングで実現することは難しいです。
しかし、それらの職能の一部はどんどんディープラーニングで代替されていくでしょうねー!
:::talk{who="robotan"}
「失敗は成功のもと」をディープラーニングに学習させればいいんじゃない!?
:::
:::talk{who="umatan"}
確かにそれができたら人間と同じような知能を獲得できるかも!笑
:::
AIにとって「関係のあることだけを考える」のが難しいという「フレーム問題」も、昔から議論されてきた難問です。くわしくは以下の記事で解説しています。
## ディープラーニングを学ぶ方法
さて、ここまでディープラーニングができることとできないことについて見てきましたが、そんなディープラーニングを学ぶにはどうすればよいでしょうか?
まずは、機械学習や統計学そしてPythonの土台が必要ですがそれをクリアしている前提なら・・・
理論は以下の書籍が圧倒的に分かりやすいんでぜひチェック!
::product[ゼロから作るDeep Learning ―Pythonで学ぶディープラーニングの理論と実装]{url="https://www.amazon.co.jp/dp/4873117585?tag=statistic08-22&linkCode=ogi&th=1&psc=1" image="https://m.media-amazon.com/images/I/513J77QZHgL._SL160_.jpg" amazon="https://www.amazon.co.jp/dp/4873117585?tag=statistic08-22&linkCode=ogi&th=1&psc=1" rakuten="https://af.moshimo.com/af/c/click?a_id=858168&p_id=54&pc_id=54&pl_id=616&url=https%3A%2F%2Fsearch.rakuten.co.jp%2Fsearch%2Fmall%2F%25E3%2582%25BC%25E3%2583%25AD%25E3%2581%258B%25E3%2582%2589%25E4%25BD%259C%25E3%2582%258BDeep%2BLeaning%2F%3Ff%3D1%26grp%3Dproduct"}
目から鱗の内容です。アルゴリズムを1からわかりやすーく教えてくれます。
ディープラーニングをちゃんと理解したいなら必読です。
書籍では、Pythonを使ってディープラーニングのアルゴリズムを0から組み立てていくのですが、実際に使う時はライブラリが多数用意されているのでライブラリを使った実データ分析も一緒に学んでいくとよいでしょう!
ライブラリ実装はオンラインスクールもしくはオンライン動画がおすすめ!
オンラインスクールはいくつかありますが、[Techacademy(テックアカデミー)のAIコース](https://techacademy.jp/course/ai)を受講してみてパーソナルメンターのクオリティが高かったのでおすすめです!
::button[テックアカデミーの公式サイトを見てみる!]{href="https://techacademy.jp/"}
以下にテックアカデミーの体験談をまとめています!
ちなみに当メディアが運営するスクール「スタアカ」でもディープラーニングについてアニメーションを使いながら分かりやすく学べるようになっているので是非チェックしてみてください!
:::box
**[業界最安値のAIデータサイエンススクール:スタビジアカデミー(スタアカ)](https://toukei-lab.com/achademy/)**
:::
月額1,280円のライトプランで、統計学から機械学習・生成AIまで全コースが受講し放題です!
プレミアムプランでは、24時間以内の質問対応と現役データサイエンティストとの1on1(30分×4回)を実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
::button[スタアカを見てみる]{href="https://toukei-lab.com/achademy/"}
理論を深めるには先ほどの書籍「[ゼロから作るディープラーニング](https://www.amazon.co.jp/dp/4873117585?tag=statistic08-22\&linkCode=ogi\&th=1\&psc=1)」と並行して進めるのがオススメです。
ディープラーニングのプログラミングスクールは以下の記事で詳しく解説していますのであわせてチェックしてみてください!
## ディープラーニングができること まとめ
本記事では、ディープラーニングができることとできないことを徹底的にまとめてきました!
最後にできることについてもう一度まとめておきましょう!
:::box
- [画像を識別](/deep-learning-can#i-3)
- [文脈を読み取る](/deep-learning-can#i-4)
- [画像→テキスト生成](/deep-learning-can#i-5)
- [フェイク画像生成](/deep-learning-can#i-6)
- [最適化](/deep-learning-can#i-7)
:::
しっかりディープラーニングについて理解しておくことで、これからの時代を生き抜く糧になります!
:::talk{who="robotan"}
すごいディープラーニングについての理解が進んだよー!
:::
:::talk{who="umatan"}
ディープラーニングの基礎となる機械学習や統計学の知識も忘れずにね!
:::
機械学習や統計学の知識は以下の記事をチェック!
ディープラーニング実装に必要なPythonに関しては以下の記事で勉強方法をまとめているのであわせてチェックしてみてくださいね!