# 【初心者向け】ディープラーニングの勉強ロードマップまとめ!
> 当サイト【スタビジ】本記事では、ディープラーニングの学習方法について詳しくまとめていきます!ディープラーニングは難しいと思われがちですが、アルゴリズムは意外とシンプルで実装自体も非常に簡単なんです!Pythonでの実装もおこなっていきますよー!
- URL: https://toukei-lab.com/deep-learning-study
- 公開: 2022.11.29 / 更新: 2024.10.25
- サイト: スタビジ(https://toukei-lab.com)
:::talk{who="umatan"}
当サイト【スタビジ】の本記事では、ディープラーニング(深層学習)の学習方法について詳しくまとめていきます!ディープラーニングは難しいと思われがちですが、アルゴリズムは意外とシンプルで実装自体も非常に簡単なんです!Pythonでの実装もおこなっていきますよー!
:::
こんにちは!
消費財メーカーでデジタルマーケター・データサイエンティストを経験後、現在は独立して働いているウマたん([@statistics1012](https://twitter.com/statistics1012?lang=ja))です!
最近はどっぷりディープラーニングに浸かっています。
ディープラーニングってなんだか難しいイメージがあるかもしれませんが、案外シンプルでそんなに難しくないんですよー!
:::talk{who="robotan"}
ディープラーニングって複雑なイメージがあるけど、そんなことないの??
:::
:::talk{who="umatan"}
もちろん簡単ではないけど、基礎的な部分は非常にシンプルなんだ!!
:::
この記事では、そんな**ディープラーニングを初心者がある程度のレベルまでマスターするまでの学習ロードマップ**をまとめました。
理論と実装の2つの視点から見ていきましょう!
ちなみにデータサイエンスの基本からディープラーニングまで一気通貫で学びたい方は当サイト「スタビジ」が提供する「[スタアカ(スタビジアカデミー)](https://toukei-lab.com/achademy/)」というサービスで体系的に学ぶことが可能ですので是非チェックしてみてください!
[](https://toukei-lab.com/achademy/)
## ディープラーニングとは
さて、まずはディープラーニングとは何なのかカンタンに見ていきましょう!
:::talk{who="umatan"}
動画でも10分ほどで分かりやすく解説しているのでぜひチェックしてみてください!
:::
::youtube{#i2jqy0gCfXk}
得たいの知れないモノの正体をクリアにしていくことで学習へのハードルがグッと下がりますよー!
:::talk{who="umatan"}
まずは、ディープラーニング=新しくて複雑なモノというイメージを払拭だ!
:::
実は、ディープラーニングの原型は**1940年代から存在していた**と言われています。
:::talk{who="robotan"}
え!?そんなに昔からあるの!?
:::
:::talk{who="umatan"}
そうなんだよー、最新の技術だと思われているんだけど既に理論自体はだいぶ昔から確立されていたんだ!
:::
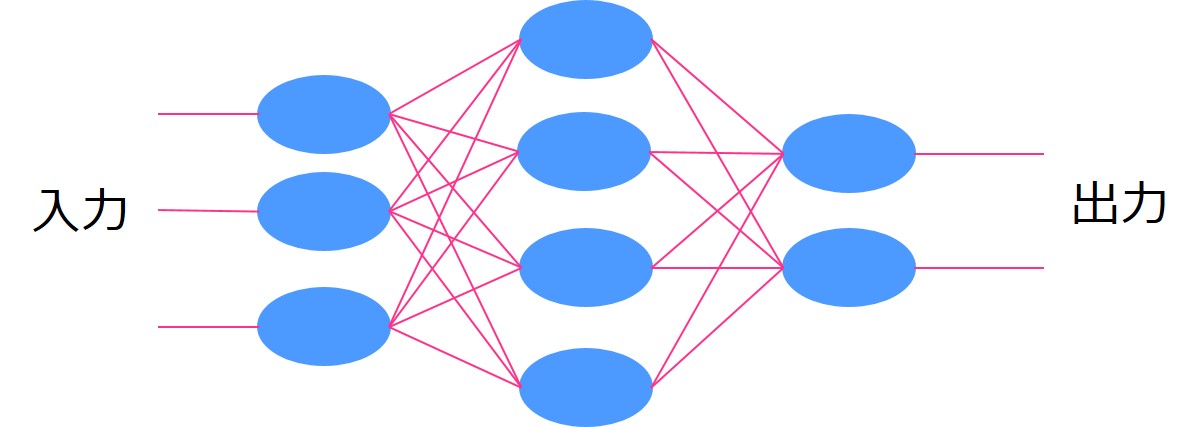
1940年~1950年にかけて人間の神経を模した仕組み「[ニューラルネットワーク](/nn)」が確立されました。
人間の神経が信号を伝播させていくようにある入力を次の層へと重み付けをして伝播させていき出力を求めます。
:::talk{who="robotan"}
なんで今さら50年以上も前の手法が注目されてるの?
:::
:::talk{who="umatan"}
当時の状況では層を積み重ねていくことができなかったんだ!
:::
この層を多層にしていくのがディープラーニングなのですが、当時のマシンパワーでは計算量が膨大過ぎて実現不可能でした。
計算負荷を軽減する[誤差逆伝播法(バックプロパゲーション](/backpropagation))などの計算手法の登場やマシンパワーの増強により現在に至ります。
そんな計算負荷の問題が解消され深層ニューラルネットワーク(ディープラーニング)が日の目を浴びたのは2006年。
このブレークスルーによって再びAIのブームが巻き起こり、第3次AIブームへと突入していくのです。
意外とディープラーニングの原点は古く、最新の複雑なアルゴリズムではないということを覚えておいてください!
詳しく知りたい場合,DeepLearningの論文を読むとよいでしょう!
> We describe an effective way of initializing the weights that allows deep autoencoder networks to learn low-dimensional codes that work much better than principal components analysis as a tool to reduce the dimensionality of data.
>
> 引用:[Google-“Reducing the Dimentionality of Data with Neural Networks”](https://www.scinapse.io/papers/2100495367)
ディープラーニングに関して詳しくは以下の記事をチェック!
## ディープラーニングでできること

さて、ディープラーニングの全体像が分かったところで、どんなことが実現できるのか見ていきましょう!
### 画像識別
ディープラーニングと言えば、**[画像認識](/python-image)**!!
Mnistという手書き文字を実際に分類してみたコードを以下に載せておきます。
Mnistは「[Gradient-based learning applied to document recognition](http://yann.lecun.com/exdb/publis/pdf/lecun-01a.pdf)」で用いられたデータセットであり、現在でも多くの論文で用いられています。
Modified National Institute of Standards and Technologyの略であり、0\~9の数字が手書き文字として格納されているデータセットです。
学習用に60000枚、検証用に10000枚のデータセットが格納されています。
```python title="Deep-learning.py"
import numpy as np
from sklearn.model_selection import train_test_split
import tensorflow as tf
from tensorflow.keras.datasets import mnist
from tensorflow import keras
from tensorflow.keras.layers import Dense, Activation
from tensorflow.keras.models import Sequential
from tensorflow.keras.utils import to_categorical
# Kerasに付属の手書き数字画像データをダウンロード
np.random.seed(0)
(X_train_base, labels_train_base), (X_test, labels_test) = mnist.load_data()
# Training set を学習データ(X_train, labels_train)と検証データ(X_validation, labels_validation)に8:2で分割する
X_train,X_validation,labels_train,labels_validation = train_test_split(X_train_base,labels_train_base,test_size = 0.2)
# 各画像は行列なので1次元に変換→X_train,X_validation,X_testを上書き
X_train = X_train.reshape(-1,784)
X_validation = X_validation.reshape(-1,784)
X_test = X_test.reshape(-1,784)
#正規化
X_train = X_train.astype('float32')
X_validation = X_validation.astype('float32')
X_test = X_test.astype('float32')
X_train /= 255
X_validation /= 255
X_test /= 255
# labels_train, labels_validation, labels_test をダミー変数化して y_train, y_validation, y_test に格納する
y_train = to_categorical(labels_train)
y_validation = to_categorical(labels_validation)
y_test = to_categorical(labels_test)
# パラメータの設定
n_features = 784
n_hidden = 100
bias_init = 0.1
# 学習率
rate = 0.01
# Sequentialクラスを使ってモデルを準備する
model = Sequential()
# 隠れ層を追加
model.add(Dense(n_hidden,activation='relu',input_shape=(n_features,)))
model.add(Dense(n_hidden,activation='relu'))
model.add(Dense(n_hidden,activation='relu'))
# 出力層を追加
model.add(Dense(10,activation='softmax'))
# TensorFlowのモデルを構築
model.compile(optimizer=tf.optimizers.Adam(rate),
loss='categorical_crossentropy', metrics=['mae', 'accuracy'])
# Early stoppingを適用してフィッティング
log = model.fit(X_train, y_train, epochs=3000, batch_size=100, verbose=True,
callbacks=[keras.callbacks.EarlyStopping(monitor='val_loss',
min_delta=0, patience=10,
verbose=1)],
validation_data=(X_validation, y_validation))
# Test dataで予測を実行。
pred_test = model.predict_classes(X_test)
validation = (pred_test == labels_test)
size = validation.size
size
correct = np.count_nonzero(validation)
print(f"{correct}/{size} correct ({correct*100/size:.3f}%)")
```
詳細は省きますが、最終的にテストデータに対して**96.96%の精度**を算出することができました。
なかなか判別の難しい手書き文字も入っているのでなかなかの精度。
以下の記事で詳しくまとめています。
ちなみに画像タスクの応用で通常の写真にゴッホのスタイルを入れるなんてことが、ディープラーニングを使えば出来ちゃうんです!
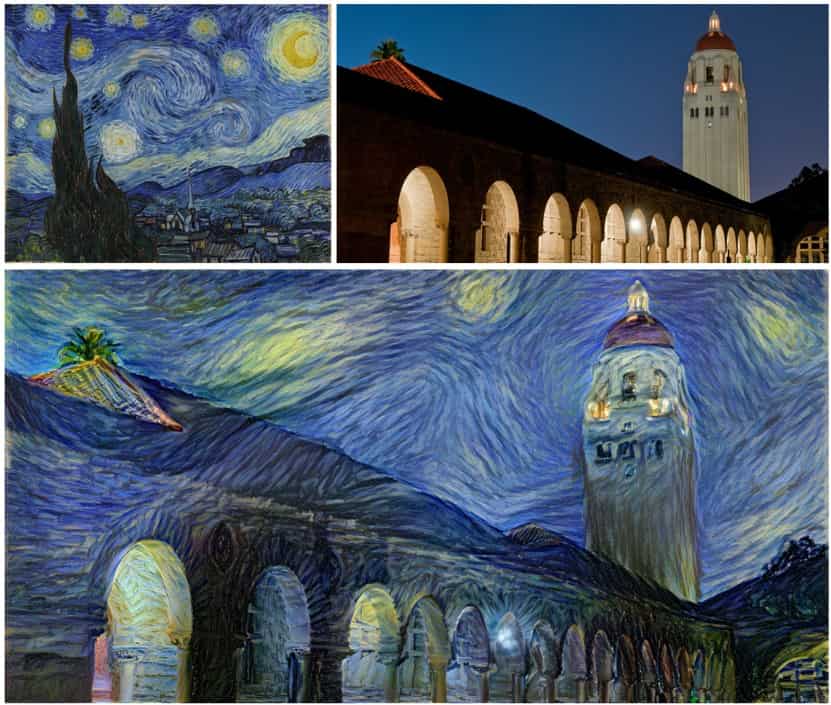
(引用元:)
可能性は無限大です!
### 文脈を読み取る
また、ディープラーニングを用いて文章を予測したり文脈を読み取ることが可能です
ここで登場するのが**Recurrent neural network(再帰型ニューラルネットワーク)**。
**RNN**と略されて呼ばれます。
RNNを用いて時系列問題を解いてみましょう!
使うデータセットはKaggleのホームページから落とせる航空会社の乗客数データ!
:::box{title="参考サイト"}
[Kaggle-“Air Passenger”](https://www.kaggle.com/rakannimer/air-passengers)
:::
1949年から1960年までの月別乗客数がデータとして入っています。
149行2列のシンプルなデータセット。
1変数の時系列データを基に過去のデータから未来の値を予測します。
この時、tflearnというライブラリを使ってRNN(正確には[LSTM](/lstm))を実装していきます。tflearnはkerasと似たようなライブラリでディープラーニングの実装が感覚的に容易にできます。
実際にモデルを構築していきましょう!
```python title="rnn_airplane.py"
import tensorflow
import tflearn
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
tensorflow.reset_default_graph() #モデルを初期化
df = pd.read_csv('AirPassengers.csv',usecols=[1])
dataset = df.values
dataset = df.astype('float32')
dataset = (dataset - np.min(dataset))/(np.max(dataset)-np.min(dataset))
dataset = np.array(dataset)
def create_dataset(dataset, steps_of_history, steps_in_future):
X, Y = [], []
for i in range(0, len(dataset)-steps_of_history, steps_in_future):
X.append(dataset[i:i+steps_of_history])
Y.append(dataset[i + steps_of_history])
X = np.reshape(np.array(X), [-1, steps_of_history, 1])
Y = np.reshape(np.array(Y), [-1, 1])
return X, Y
def split_data(x, y, test_size=0.1):
pos = round(len(x) * (1 - test_size))
trainX, trainY = x[:pos], y[:pos]
testX, testY = x[pos:], y[pos:]
return trainX, trainY, testX, testY
steps_of_history = 1
steps_in_future = 1
X, Y = create_dataset(dataset, steps_of_history, steps_in_future)
trainX, trainY, testX, testY = split_data(X, Y, test_size = 0.33)
net = tflearn.input_data(shape=[None, steps_of_history, 1])
net = tflearn.lstm(net, n_units=6)
net = tflearn.fully_connected(net, 1, activation='linear')
net = tflearn.regression(net, optimizer='adam', learning_rate=0.001,
loss='mean_square')
model = tflearn.DNN(net, tensorboard_verbose=0)
model.fit(trainX, trainY, validation_set=0.1, batch_size=1, n_epoch=150)
test_predict = model.predict(testX)
rmse = np.sqrt(np.mean((test_predict-testY)**2))
print(rmse)
```
最終的な評価は[RMSE](/rmse_mae_mse)(Root Mean Square Error)で算出しています。
RMSEは0.10079201となりました。
それなりに良い予測ができてる!
RNNについては以下の記事で詳しくまとめていますのでチェックしてみてください!
ここでは一部だけ取り上げましたが、ディープラーニングでできることはもっともっと幅広いんです!
ディープラーニングでできることをもっと知りたい方は、以下の記事をチェックしてみてください!
## ディープラーニングの学習ロードマップ
さて、ディープラーニングの全体像・できることが分かったところで本題に入りましょう!
ディープラーニングをマスターするためには、**どのように学習していけばよいのか。**
CNNでの画像識別ができるところまでを目指します。
ディープラーニング学習は、以下の4ステップ!
:::box
**Step1\:基礎固め**\
**Step2\:ディープラーニングの概論**\
**Step3\:ディープラーニングの理論\
Step4\:ディープラーニングの実装**
:::
それぞれについて具体的に見ていきましょう!
### Step1\:基礎固め
ディープラーニングをしっかり学んでいくためには、まず
:::box
**・基本的な統計学の知識**\
**・機械学習手法の理論**\
**・Pythonスキル**
:::
が前提として必要です。
この3つの最低限知識・スキルを固めず、ディープラーニングを学習しても効率が悪いですし頭デッカチになっちゃいます。
遠回りに思えるかもしれませんが、しっかり順を追って学ぶことが後々効いてきます。
それぞれについては以下の記事を参考にして学習を進めてください。
この時に注意して欲しいのが、「**統計学・機械学習の知識**」と「**Pythonスキル**」は切り分けて勉強するのではなく並行して学習を進めていってください。
そうすることで理解が深まり効率が高まります。
知識だけ入れてから・・・と進めると挫折します。
:::talk{who="robotan"}
数式だらけで何が何だかわからなくなりそう、、、
:::
:::talk{who="umatan"}
Pythonでの実装も同時に行いながら学習を進めることで、手法のイメージが掴みやすくなるよ!
:::
### Step2\:ディープラーニングの概論
さてさて、基礎固めが出来たらディープラーニングの理論と概論に移りましょう!
まずディープラーニングの将来性や現状・そしてどのようにビジネスに活用されているかについて学びましょう。
ディープラーニングはあくまで手段です。
ディープラーニングを使って何がしたいかを明確にしておかないと学習効率は上がりません。
ふわっとしていても良いので、Step3に進む前にディープラーニングを学習した先に目指すものをつくりましょう!
たくさん書籍が出ていますが、以下の2つが個人的にはよかったです。
::product[人工知能は人間を超えるか ディープラーニングの先にあるもの (角川EPUB選書)]{url="https://www.amazon.co.jp/dp/4040800206?tag=statistic08-22&linkCode=ogi&th=1&psc=1" image="https://m.media-amazon.com/images/I/31I10MCuvyL._SL160_.jpg" amazon="https://www.amazon.co.jp/dp/4040800206?tag=statistic08-22&linkCode=ogi&th=1&psc=1" rakuten="https://af.moshimo.com/af/c/click?a_id=858168&p_id=54&pc_id=54&pl_id=616&url=https%3A%2F%2Fsearch.rakuten.co.jp%2Fsearch%2Fmall%2F%25E4%25BA%25BA%25E5%25B7%25A5%25E7%259F%25A5%25E8%2583%25BD%25E3%2581%25AF%25E4%25BA%25BA%25E9%2596%2593%25E3%2582%2592%25E8%25B6%2585%25E3%2581%2588%25E3%2582%2589%25E3%2582%258C%25E3%2582%258B%25E3%2581%258B%2F%3Ff%3D1%26grp%3Dproduct"}
::product[いまこそ知りたいAIビジネス]{url="https://www.amazon.co.jp/dp/4799323970?tag=statistic08-22&linkCode=ogi&th=1&psc=1" image="https://m.media-amazon.com/images/I/41O1wDPy0HL._SL160_.jpg" amazon="https://www.amazon.co.jp/dp/4799323970?tag=statistic08-22&linkCode=ogi&th=1&psc=1" rakuten="https://af.moshimo.com/af/c/click?a_id=858168&p_id=54&pc_id=54&pl_id=616&url=https%3A%2F%2Fsearch.rakuten.co.jp%2Fsearch%2Fmall%2F%25E3%2581%2584%25E3%2581%25BE%25E3%2581%2593%25E3%2581%259D%25E7%259F%25A5%25E3%2582%258A%25E3%2581%259F%25E3%2581%2584%2F%3Ff%3D1%26grp%3Dproduct"}
東大の松尾教授は、日本のディープラーニング第1人者。
ぜひチェックしてみてください。
### Step3\:ディープラーニングの理論
概論のイメージを膨らませたら続いては本格的な理論の学習に入っていきましょう!
ディープラーニングの理論の学習には書籍がもっとも適しています。
名著「**ゼロから作るディープラーニング**」!
::product[ゼロから作るDeep Learning ―Pythonで学ぶディープラーニングの理論と実装]{url="https://www.amazon.co.jp/dp/4873117585?tag=statistic08-22&linkCode=ogi&th=1&psc=1" image="https://m.media-amazon.com/images/I/513J77QZHgL._SL160_.jpg" amazon="https://www.amazon.co.jp/dp/4873117585?tag=statistic08-22&linkCode=ogi&th=1&psc=1" rakuten="https://af.moshimo.com/af/c/click?a_id=858168&p_id=54&pc_id=54&pl_id=616&url=https%3A%2F%2Fsearch.rakuten.co.jp%2Fsearch%2Fmall%2F%25E3%2582%25BC%25E3%2583%25AD%25E3%2581%258B%25E3%2582%2589%25E4%25BD%259C%25E3%2582%258BDeep%2BLeaning%2F%3Ff%3D1%26grp%3Dproduct"}
この本に出会いディープラーニングの魅力に取りつかれました。
[パーセプトロン](/perceptron)の話からニューラルネットワークに入り、そこからCNNまで解説しています。
タイトルの通り0からアルゴリズムを組み立てていき、Pythonで0からコーディングしていきます。
とにかくめちゃくちゃ分かりやすいです。
必読の1冊。
理論はこの1冊読んでおけば基本問題ないです。
::youtube{#nQgu3SWfAo0}
また、「**ゼロから作るディープラーニング②**」では、自然言語処理の領域に利用されているRNNについて詳しく解説しています。
::product[ゼロから作るDeep Learning ❷ ―自然言語処理編]{url="https://www.amazon.co.jp/dp/4873118360?tag=statistic08-22&linkCode=ogi&th=1&psc=1" image="https://m.media-amazon.com/images/I/512wqsxOrsL._SL160_.jpg" amazon="https://www.amazon.co.jp/dp/4873118360?tag=statistic08-22&linkCode=ogi&th=1&psc=1" rakuten="https://af.moshimo.com/af/c/click?a_id=858168&p_id=54&pc_id=54&pl_id=616&url=https%3A%2F%2Fsearch.rakuten.co.jp%2Fsearch%2Fmall%2F0%25E3%2581%258B%25E3%2582%2589%25E4%25BD%259C%25E3%2582%258B%25E3%2583%2587%25E3%2582%25A3%25E3%2583%25BC%25E3%2583%2597%25E3%2583%25A9%25E3%2583%25BC%25E3%2583%258B%25E3%2583%25B3%25E3%2582%25B0%2F%3Ff%3D1%26grp%3Dproduct"}
少々レベルが上がりますが、興味のある方は読んでみるとよいでしょう!
ディープラーニングの書籍を以下の記事でまとめていますのでチェックしてみてください!
ビジネスサイドからディープラーニングの活用を学べる書籍も紹介していますよー!
### Step4\:ディープラーニングの実装
理論のStepでは、ディープラーニングがどんなアルゴリズムで動いているかを理解するためにゼロからPythonで実装してみましたが、実際の場面でゼロから作り上げることは多くありません。
実装するだけなら便利なライブラリが用意されていてライブラリを呼び出すだけで実装が可能なんです。
ライブラリ実装によるディープラーニングはオンラインスクールもしくはオンライン動画で学習するとよいでしょう!
オンラインスクールはいくつかありますが、[Techacademy(テックアカデミー)のAIコース](https://techacademy.jp/course/ai)を受講してみてパーソナルメンターのクオリティが高かったのでおすすめです!
このコースでは、機械学習の初歩的な内容から[CNN(畳み込みニューラルネットワーク)](/cnn)の実装まで学びます。
::button[テックアカデミーの公式サイトを見てみる!]{href="https://techacademy.jp/"}
教材のクオリティは高くないので先ほどの書籍「[ゼロから作るディープラーニング](https://www.amazon.co.jp/dp/4873117585?tag=statistic08-22\&linkCode=ogi\&th=1\&psc=1)」と並行して進めるのがオススメです。
ちなみに先ほども紹介しましたが、データサイエンスの基本からディープラーニングまで一気通貫で学びたい方は当サイト「スタビジ」が提供する「[スタアカ(スタビジアカデミー)](https://toukei-lab.com/achademy/)」というサービスで体系的に学ぶことが可能ですので是非チェックしてみてください!
他のスクールと比較して圧倒的に格安で提供しています!
[](https://toukei-lab.com/achademy/)
ディープラーニングの学習をしっかり集中的に行うのであればプログラミングスクールは比較的オススメです。
以下の記事でまとめているのでぜひチェックしてみてください!
## ディープラーニングの学習で注意すべき点とアドバイス

ディープラーニングの学習ロードマップ、無事進められそうでしょうか?
最後に学習をしっかり完遂し初心者脱却するために注意すべき点とアドバイスをまとめておきます。
学習の一助になれば幸いです。
### ディープラーニングで最終的に何がしたいかを明確に
ディープラーニングは手段でしかないので、ディープラーニングを学習した先の目的を明確にしておいた方がよいです。
目的は些細なことでも実現ハードルが高そうなことでも何でもよいと思っています。
:::talk{who="umatan"}
目的があるとモチベーションも上がるね!
:::
### 他の機械学習手法と比較すると良い

当サイトでは、同様のMnistのデータを勾配ブースティング手法とディープラーニングで分類していますが、
ご自身で勉強する時もぜひ他の機械学習手法と比較してみてください。
**精度と計算負荷**を他の手法と比較することで、ディープラーニングへの理解がより深まります。
### 出力層の関数は要注意
ディープラーニングを組み立てていく時、出力層・中間層の関数を決めるのですが出力層の関数を適切なものに設定しないと出力値が見当はずれのものになるので注意が必要。
当たり前ですが、出力したい値が0・1の2クラスなのか、多クラスなのか、それとも量的数値なのか、明確にして設定しましょう。
## ディープラーニングの学習 まとめ
本記事では、ディープラーニングの学習方法についてまとめてきました!!
学習ロードマップは以下の4STEPでしたね!
:::box
- [Step1\:基礎固め](/deep-learning-study#Step1)
- [Step2\:ディープラーニングの概論](/deep-learning-study#Step2)
- [Step3\:ディープラーニングの理論](/deep-learning-study#Step3)
- [Step4\:ディープラーニングの実装](/deep-learning-study#Step4)
:::
このステップが必ず正解というわけではないので、参考にしながら自分のペースで学習を進めていってください。
以下のポイントには留意しておきましょう!
:::point
・ディープラーニングで最終的に何がしたいかを明確に\
・他の機械学習手法と比較すると良い\
・出力層の関数は要注意
:::
:::talk{who="robotan"}
ディープラーニング学習についてだいぶクリアになったよ!
:::
:::talk{who="umatan"}
ディープラーニングを学んで世界にはばたこう!
:::
以下の記事でPythonの学習方法やデータサイエンティストへの勉強法をまとめているのあわせてチェックしてみてください!
また、ディープラーニングの資格としてG検定・E資格というものがあります。興味がある方は以下の記事をチェックしてみてください。