# 差分の差分法(DID)とは?施策の効果を正しく測る方法を具体例とPythonで分かりやすく解説!
> 差分の差分法(DID)とは、施策をしたグループとしなかったグループの「前後の変化」の差で、施策の効果を測る方法です。本記事では、考え方と具体例の計算、大事な前提「平行トレンド」、有名な最低賃金の研究、注意点、Pythonでの回帰分析のやり方を図解で解説します!
- URL: https://toukei-lab.com/difference-in-differences
- 公開: 2026.11.03
- サイト: スタビジ(https://toukei-lab.com)
:::talk{who="umatan"}
当サイト【スタビジ】の本記事では、施策の効果を正しく測る方法「差分の差分法(DID)」について分かりやすく解説していきます!考え方から具体例での計算、大事な前提、注意点、Pythonでのやり方まで見ていきましょう!
:::
こんにちは!ウマたんです!
「キャンペーンをやったら、売上が上がった!」
仕事でこんな報告を聞いたことはありませんか?
でもそれ、本当にキャンペーンのおかげでしょうか?
たまたま季節が良かっただけかもしれないし、景気が良くなっただけかもしれませんよね。
そんなときに使えるのが「**差分の差分法**」です。
:::talk{who="man" side="left"}
施策の前と後で売上を比べるだけじゃダメなの?
:::
:::talk{who="woman"}
「差分の差分」って、何と何の差をとるのか知りたい!
:::
本記事では、次の4つを順番に解説していきます。
:::point
**・差分の差分法とは?**\
**・具体例で計算してみよう**\
**・大事な前提「平行トレンド」**\
**・使うときの注意点(Pythonでのやり方)**
:::
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!
::youtube{#rhGaJqZe1s0}
## 差分の差分法とは?
**差分の差分法とは、施策の効果を、データから正しく測るための方法**です。
英語では「Difference-in-Differences」と言い、頭文字をとって「**DID**」とも呼ばれます。「差の差法」と呼ばれることもあります。
### 前後を比べるだけではダメな理由
施策の前と後で売上を比べるだけだと、季節や景気の変化まで、効果に混ざってしまいますよね。
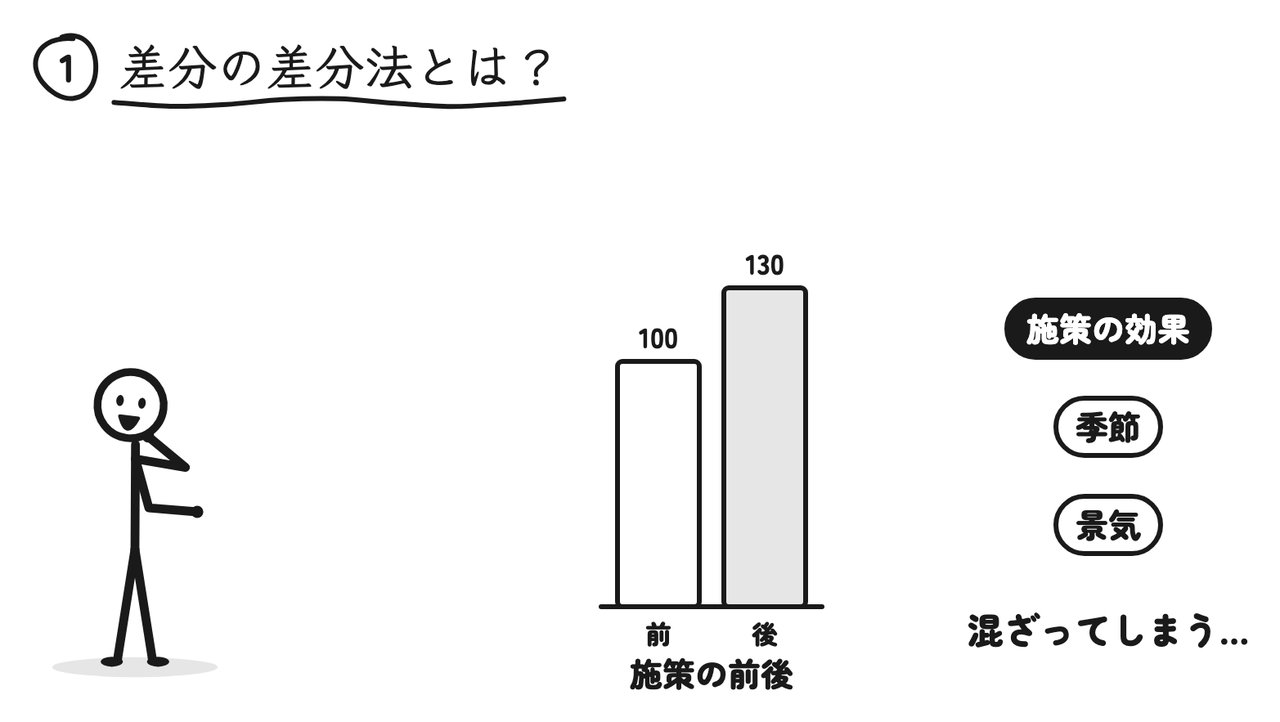
たとえば、12月にキャンペーンをして売上が上がったとしても、12月はもともと年末で売上が伸びやすい時期かもしれません。
すると、売上の伸びのうち、どこまでがキャンペーンのおかげで、どこからが季節のせいなのか、区別がつかないんです。
:::warn
施策の前後の変化 = 施策の効果 + 季節や景気など、施策以外の理由による変化
:::
前後の比較だけでは、施策以外の理由による変化を取り除けない。ここが問題なんです。
### 「変化」と「変化」の差をとる
そこで、施策をした「グループ」と、しなかった「グループ」の両方で、前後の変化を比べます。
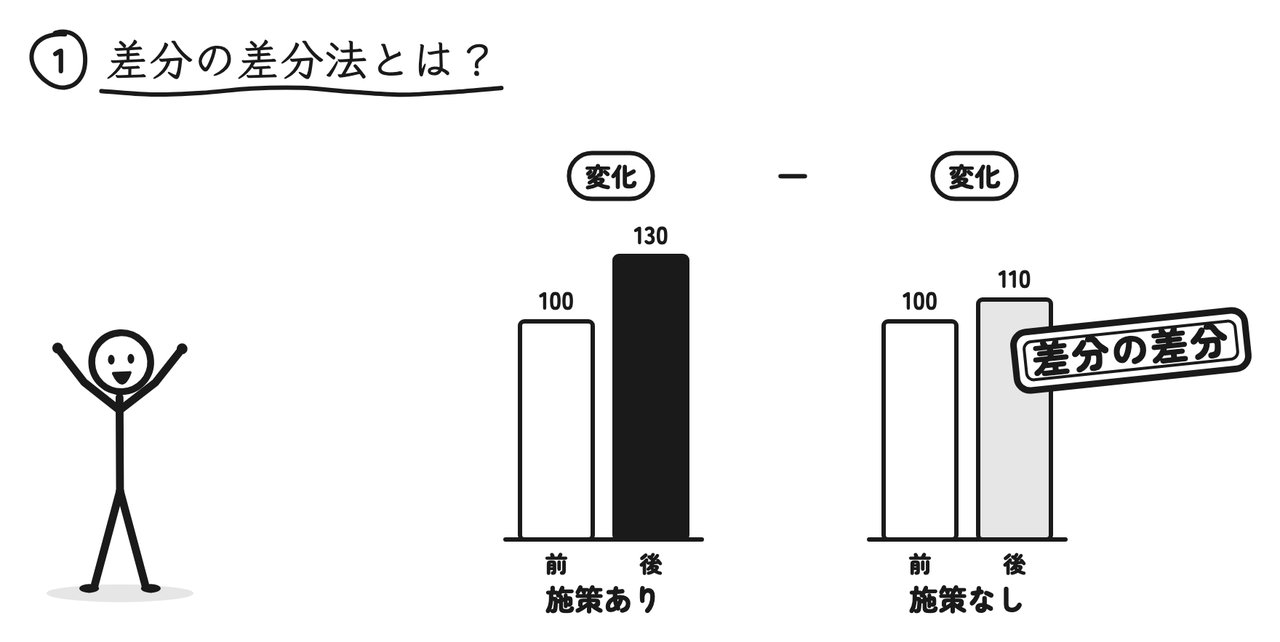
施策をしなかったグループにも、季節や景気の影響は同じようにかかっているはず。
だから、施策をしなかったグループの変化は、「施策以外の理由による変化」の目安になります。
施策をしたグループの変化から、それを差し引けば、施策の効果だけが残るというわけです。
まず、それぞれのグループで「前後の差」をとる。
そして、その2つの差の、さらに差をとる。
「変化」と「変化」の差をとる。だから「差分の差分」なんです!
比べ方を整理すると、こんな違いがあります。
| 比べ方 | 何と何を比べるか | 問題点 |
|---|---|---|
| 前後の比較 | 施策をしたグループの、前と後 | 季節や景気など、施策以外の理由による変化が混ざる |
| あり・なしの比較 | 施策の後の、施策をしたグループとしなかったグループ | もともとのグループの違い(お店の大きさなど)が混ざる |
| 差分の差分法 | 2つのグループの「前後の変化」どうし | 「平行トレンド」という前提が必要(後で解説) |
差分の差分法は、時間による変化と、もともとのグループの違いの両方を、まとめて取り除けるのが強みなんです。
施策の効果のように「原因と結果」をデータから明らかにする方法は、まとめて「統計的因果推論」と呼ばれます。全体像は以下の記事で解説しています。
## 具体例で計算してみよう
それでは、具体例で計算してみましょう。
ある会社が、東京のお店だけで、新しいキャンペーンを始めました。大阪のお店では、何もしていません。
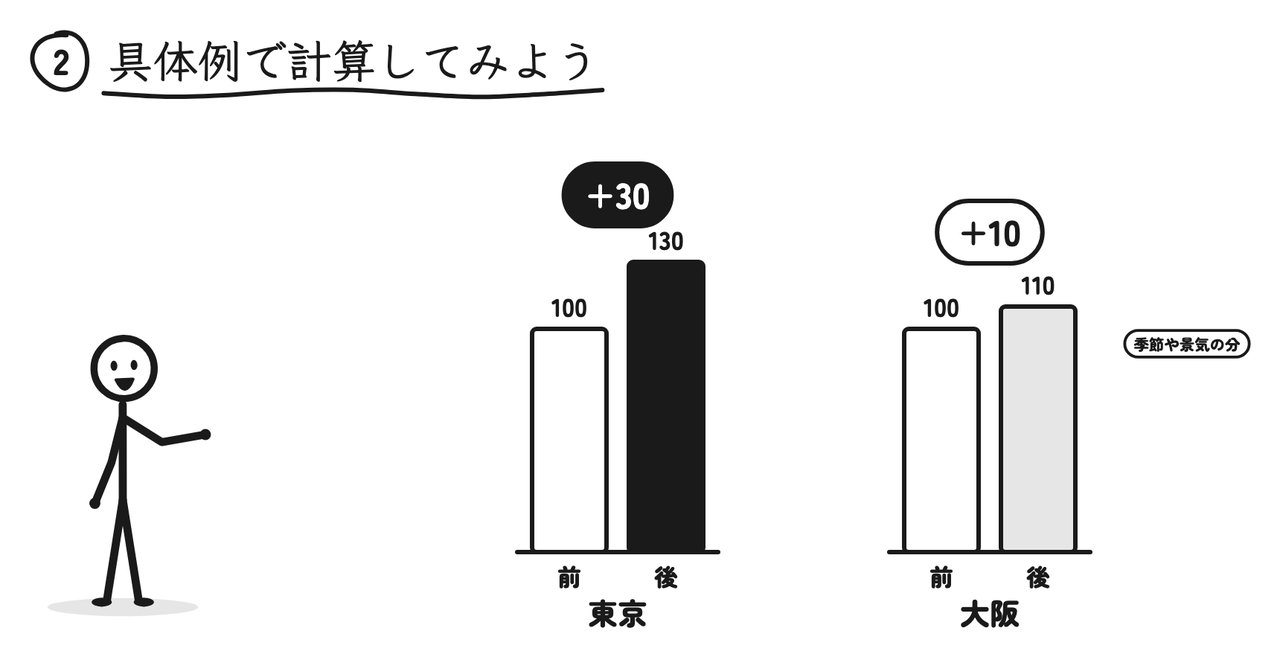
東京のお店の売上は、キャンペーンの前が100、後が130になりました。30の増加です。
でも同じ時期に、何もしていない大阪のお店も、100から110に増えていました。こちらは10の増加。
大阪の10の増加は、季節や景気など、キャンペーン以外の理由による変化だと考えられます。
表にまとめると、こうなります。
| | キャンペーン前 | キャンペーン後 | 前後の変化 |
|---|---|---|---|
| 東京(キャンペーンあり) | 100 | 130 | +30 |
| 大阪(キャンペーンなし) | 100 | 110 | +10 |
| 差分の差分 | | | 30 − 10 = **20** |
すると、キャンペーンの本当の効果は、30から10を引いた、20。
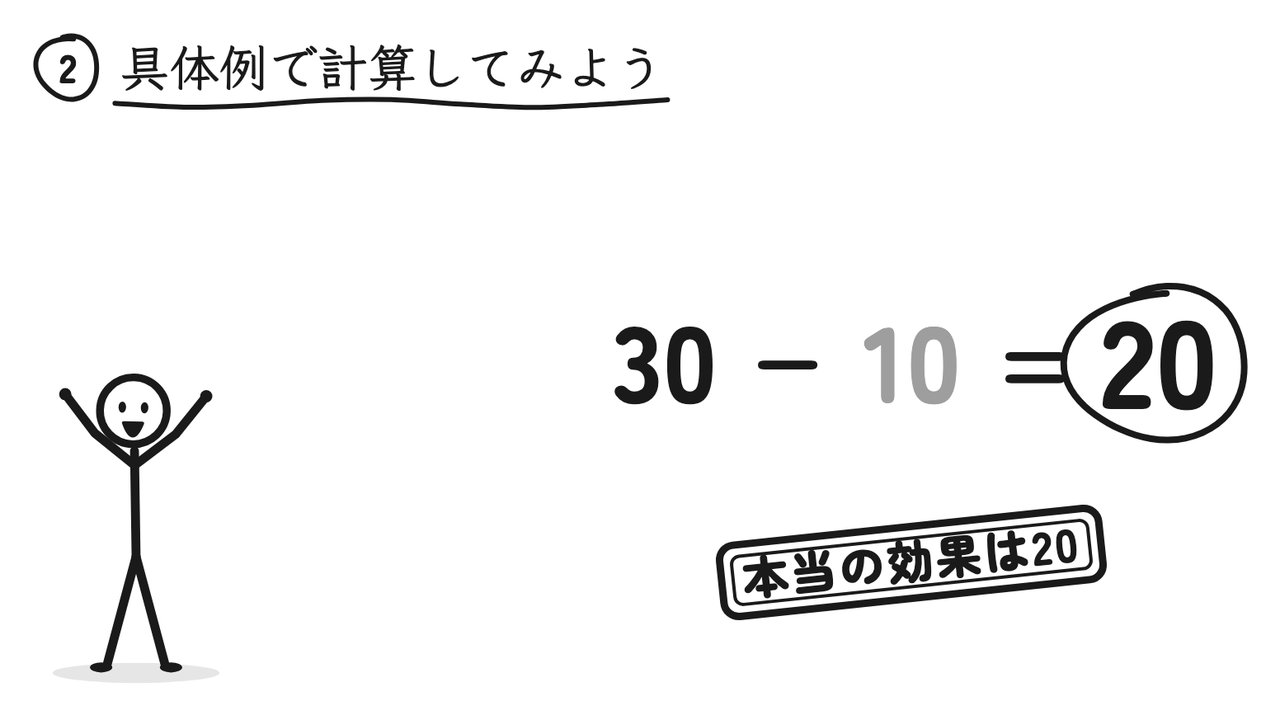
単純に前後を比べた30ではなく、20こそが、キャンペーンの効果なんです!
もし前後の比較だけで「キャンペーンで30も伸びた!」と報告していたら、効果を1.5倍も大きく見積もっていたことになりますね。
式で書くと、こうなります。施策をしたグループを $T$(Treatment)、しなかったグループを $C$(Control)として、$\bar{Y}$ はそれぞれの売上の平均です。
$$
\text{DID} = \left(\bar{Y}_{T,\text{after}} - \bar{Y}_{T,\text{before}}\right) - \left(\bar{Y}_{C,\text{after}} - \bar{Y}_{C,\text{before}}\right)
$$
今回の例に当てはめると、$(130 - 100) - (110 - 100) = 30 - 10 = 20$ です。
## 大事な前提「平行トレンド」
今の計算には、ひとつ前提があります。
それは、「もしキャンペーンをしなかったら、東京も、大阪と同じように10だけ増えていたはず」ということ。
つまり、**施策がなければ、2つのグループは同じ傾きで動いていたはず**、という前提です。
これを「**平行トレンドの仮定**」と呼びます。
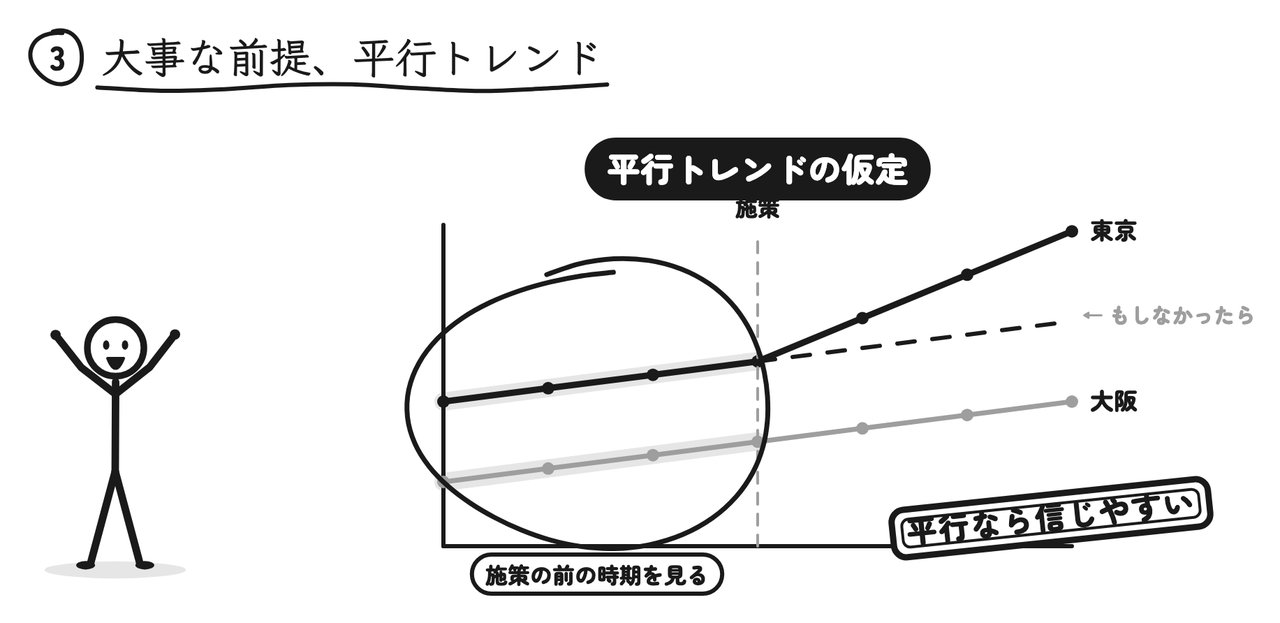
図の点線は、「キャンペーンがなかったら、東京はこう動いていたはず」という線です。
実際の東京の線と、この点線との差が、キャンペーンの効果になります。
ただ、「キャンペーンがなかったら」の東京は、実際には見ることができませんよね。
そこで、大阪の動きを借りてきて、「東京も大阪と平行に動いていたはず」と考えるわけです。
### 平行トレンドの確かめ方
確かめるには、施策の前の時期のグラフを見るのが基本です。
施策の前に、2つのグループが平行に動いていれば、この前提は信じやすいんです!
| 施策の前の2つのグループの動き | 平行トレンドの前提 |
|---|---|
| ほぼ平行に動いている | 信じやすい |
| 片方だけ急に伸びている・落ちている | 疑わしい(差分の差分法の結果も信じにくい) |
逆に、施策の前から東京だけがぐんぐん伸びていたとしたら、施策の後の伸びも、もともとの勢いの続きかもしれません。
そのときは、差分の差分法で出した効果も、大きく見積もりすぎている可能性があります。
なお、「施策の後」については、平行かどうかを確かめることはできません。施策の後は、東京にはもうキャンペーンの影響が入っているからです。
だからこそ、施策の前のデータを、なるべく長い期間そろえておくことが大切なんです。
### 差分の差分法を有名にした「最低賃金の研究」
差分の差分法が有名になった研究のひとつが、経済学者のデビッド・カードとアラン・クルーガーによる、最低賃金の研究です(1994年の論文)。
1992年、アメリカのニュージャージー州で、最低賃金が引き上げられました(時給4.25ドルから5.05ドル)。
当時は、「最低賃金を上げると、雇用が減る」と考える経済学者が多くいました。
お店にとって人を雇うコストが上がるので、雇う人数を減らすだろう、という考え方です。
そこで、引き上げなかった隣のペンシルベニア州と、ファストフード店の雇用の変化を比べました。
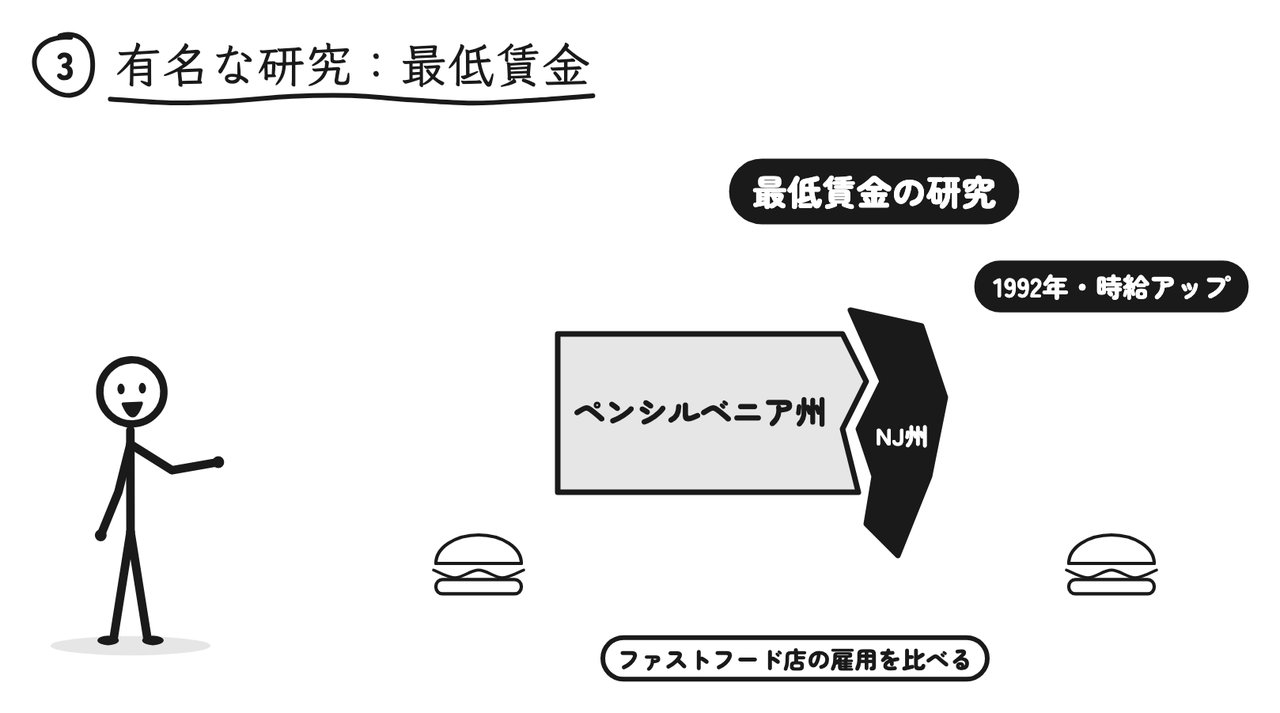
| | 東京と大阪の例 | 最低賃金の研究 |
|---|---|---|
| 施策をしたグループ | 東京のお店 | ニュージャージー州のファストフード店 |
| 施策をしなかったグループ | 大阪のお店 | ペンシルベニア州のファストフード店 |
| 施策 | キャンペーン | 最低賃金の引き上げ |
| 見る数字 | 売上 | 雇用(働く人の数) |
すると、はっきりした雇用の減少は見られなかったんです。
隣どうしの州なら、景気の波や季節の影響は似ているはず。だから、比べる相手としてぴったりだったわけです。
この研究は大きな議論を呼び、研究者の一人、デビッド・カードは、のちに2021年のノーベル経済学賞を受賞しています。
## 使うときの注意点
それでは最後に、差分の差分法を使うときの注意点です。
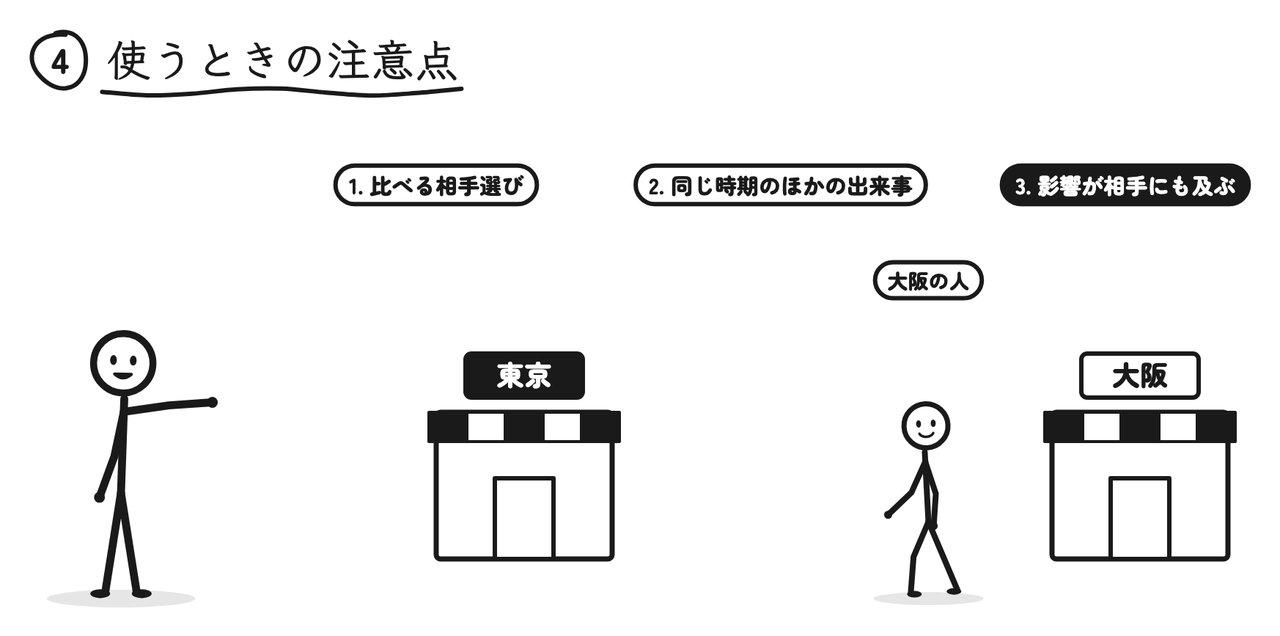
### 1つ目:比べる相手選び
1つ目は、比べる相手選びです。
施策をしなかったグループには、施策をしたグループと似た動きをするところを選びましょう。
施策の前のグラフを見て、売上の上がり下がりのタイミングが似ている相手を選ぶのがコツです。
### 2つ目:同じ時期に起きた、ほかの出来事
2つ目は、同じ時期に起きた、ほかの出来事です。
たとえば東京だけで大きなイベントがあったら、その影響も効果に混ざってしまいます。
差分の差分法で取り除けるのは、「2つのグループに同じようにかかった変化」だけ。片方のグループだけに起きた出来事は、取り除けないんです。
### 3つ目:施策の影響が、比べる相手にも及ぶこと
3つ目は、施策の影響が、比べる相手にも及んでしまうことです。
東京のキャンペーンを見て、大阪の人が東京で買い物をしたら、正しく比べられません。
この場合、大阪の売上が下がり、東京の売上が上がるので、効果を大きく見積もってしまいます。
:::warn
**・比べる相手は、施策をしたグループと似た動きをするところを選ぶ**\
**・同じ時期に、片方のグループだけに起きた出来事がないか確かめる**\
**・施策の影響が、比べる相手にまで及んでいないか確かめる**
:::
### 回帰分析で効果を推定する
実際の分析では、回帰分析を使って、ほかの要因も一緒に考えながら効果を推定することが多いです。
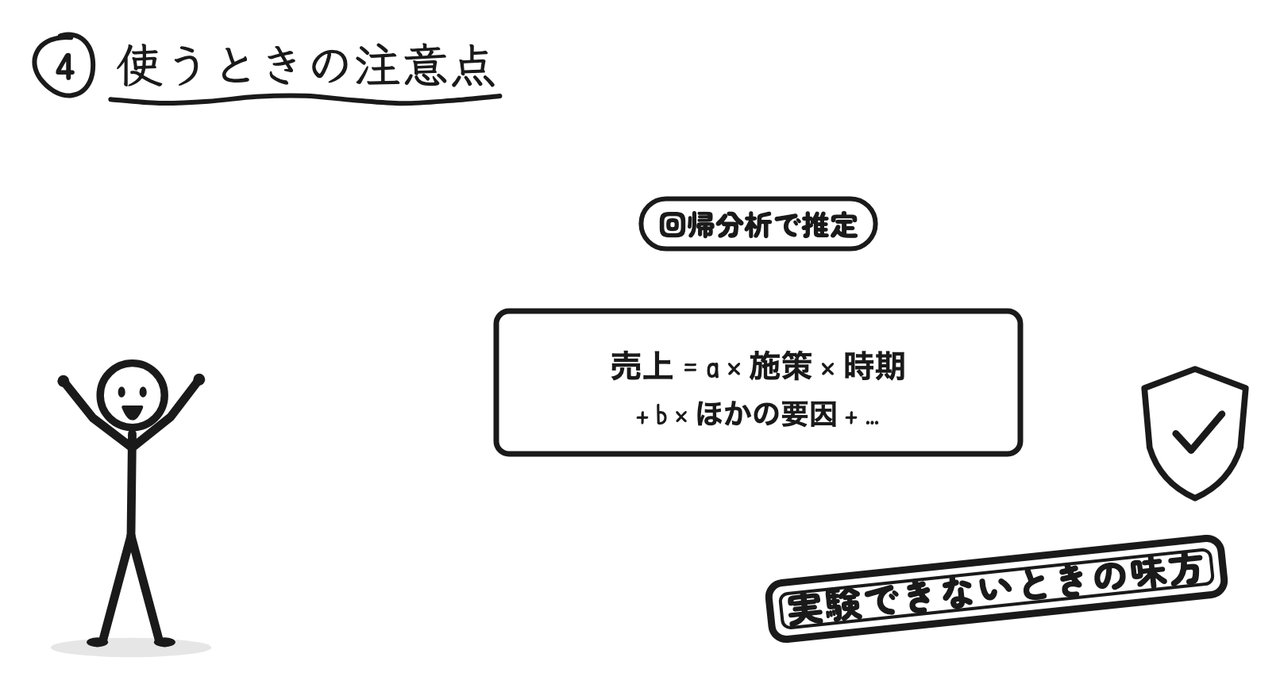
よく使われるのは、次のような式です。
$$
Y = \beta_0 + \beta_1 \cdot \text{treat} + \beta_2 \cdot \text{post} + \beta_3 \cdot (\text{treat} \times \text{post}) + \varepsilon
$$
ここで、$\text{treat}$ は施策をしたグループなら1、しなかったら0。$\text{post}$ は施策の後なら1、前なら0、という変数です。
それぞれの係数の意味は、こうなります。
| 係数 | 意味 | 東京と大阪の例 |
|---|---|---|
| $\beta_0$ | 施策をしなかったグループの、施策の前の平均 | 100(大阪の前) |
| $\beta_1$ | もともとの2つのグループの差 | 0(東京も大阪も前は100) |
| $\beta_2$ | 施策と関係なく起きた変化 | 10(大阪の変化) |
| $\beta_3$ | 施策の効果(差分の差分) | **20** |
ポイントは、$\text{treat} \times \text{post}$ という掛け算の項(交互作用項)の係数 $\beta_3$ が、差分の差分そのものになることです。
回帰分析にすると、ほかに売上に影響しそうな要因(お店の広さや、近くの人口など)も、式に足して一緒に考えられるのが便利なところです。
Pythonでは、statsmodelsを使って、次のように書けます。東京と大阪のお店50店ずつの、キャンペーン前後の売上のデータを作って試してみましょう。
```python
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf
rng = np.random.default_rng(0)
# 東京と大阪のお店(50店ずつ)の、キャンペーン前後の売上をつくる
rows = []
for store in range(100):
treat = 1 if store < 50 else 0 # 1=東京(キャンペーンあり)、0=大阪(なし)
for post in [0, 1]: # 0=キャンペーン前、1=キャンペーン後
sales = 100 + 10 * post + 20 * treat * post + rng.normal(0, 5)
rows.append({"store": store, "treat": treat, "post": post, "sales": sales})
df = pd.DataFrame(rows)
# treat * post は treat + post + treat:post(交互作用項)の省略形
model = smf.ols("sales ~ treat * post", data=df).fit()
print(model.params.round(1))
```
実行すると、次のような結果になります。
```text
Intercept 99.4
treat 0.6
post 10.8
treat:post 20.2
dtype: float64
```
`treat:post` の係数がおよそ20になっていて、データを作るときに入れた「キャンペーンの効果=20」をちゃんと取り出せていますね!
`model.summary()` を見れば、この効果の標準誤差や信頼区間も確かめられます。
同じお店を前と後の2回ずつ見ているデータなので、実際の分析では、お店ごとのまとまりを考えた標準誤差(クラスターロバスト標準誤差)を使うことも多いです。statsmodelsでは、次のように指定できます。
```python
model = smf.ols("sales ~ treat * post", data=df).fit(
cov_type="cluster", cov_kwds={"groups": df["store"]}
)
```
### ランダムな実験ができないときの強い味方
施策の効果を測るいちばん確かな方法は、お店やお客さんをランダムに2つに分けて、片方にだけ施策をする「ランダム化比較実験(RCT)」です。
でも、「東京だけでキャンペーンをする」のように、ビジネスの現場では、ランダムに分けられないことのほうが多いですよね。
ランダムに分けた実験ができないときの、強い味方。
それが差分の差分法なんです!
ランダム化比較実験については、以下の記事で解説しています。
また、ランダムに分けられないデータで効果を測る方法には、ほかにも「傾向スコア」を使う方法などがあります。
因果推論をもっと深く学びたい方は、以下の記事で紹介している本もぜひチェックしてみてください!
## 差分の差分法のまとめ
最後に、今回のポイントをおさらいしましょう!
:::point
**・差分の差分法は、施策をしたグループと、しなかったグループの「前後の変化」の差で、効果を測る方法**\
**・キャンペーン以外の理由による変化を、施策をしなかったグループの変化で差し引ける**\
**・大事な前提は、施策がなければ同じように動いていたはず、という「平行トレンド」**\
**・比べる相手選びと、同じ時期のほかの出来事には注意**
:::
:::talk{who="umatan"}
要は、「変化」と「変化」を比べることで、本当の効果をあぶり出すのが、差分の差分法なんです!ぜひ、身近な施策の効果を測るときに使ってみてください!
:::
差分の差分法のような因果推論や統計学、データサイエンスを体系的に学びたいのであれば、当メディアが運営するスクール「**[スタアカ](https://toukei-lab.com/achademy/)**」がオススメです!
:::box
**[業界最安級のAIデータサイエンス特化スクール「スタアカ」](https://toukei-lab.com/achademy/)**
:::