# リーケージ(リーク)とは?機械学習でAIが「カンニング」してしまう原因と防ぎ方を解説!
> リーケージ(リーク)とは、機械学習のモデルが本来知り得ない未来の情報や正解のヒントを先に知ってしまい、精度が実力以上に良く見えてしまう現象です。本記事では、時系列データの分け方や特徴量の選び方などリーケージが起きやすい例と防ぎ方を、図とPythonの実験で分かりやすく解説します!
- URL: https://toukei-lab.com/leakage
- 公開: 2026.10.28
- サイト: スタビジ(https://toukei-lab.com)
:::talk{who="umatan"}
当サイト【スタビジ】の本記事では、AIや機械学習で気をつけなければいけない「リーケージ(リーク)」について分かりやすく解説していきます!どんなときに起きるのか、どうすれば防げるのかを、Pythonの実験もまじえて見ていきましょう!
:::
こんにちは!ウマたんです!
テストで満点を取った生徒が、実はテストの前に答えを見ていた…。
これでは、本当の実力は分かりませんよね。
実は、これと同じことが、AIや機械学習の世界でも起きるんです。
「検証してみたら精度99%!」と喜んだのに、いざ本番で使ってみると、まったく当たらない。
その原因としてよくあるのが、今回のテーマ「**リーケージ**」です。
:::talk{who="man" side="left"}
モデルの精度がやけに高く出たことがあるけど、もしかしてリーケージだったのかな…
:::
:::talk{who="woman"}
リーケージって、どんなときに起きるの?防ぐにはどうしたらいい?
:::
本記事では、次の5つを順番に解説していきます。
:::point
**・まずはおさらい:モデルの作り方と検証**\
**・リーケージとは?**\
**・リーケージが起きやすい例**\
**・気づきにくい「微妙なリーケージ」**\
**・リーケージを防ぐ方法**
:::
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!
::youtube{#5keqZt_0zF0}
## まずはおさらい:モデルの作り方と検証
リーケージの話に入る前に、AIや機械学習でモデルを作るときの流れを、おさらいしておきましょう。
### データからパターンを学ぶ
AIや機械学習は、たくさんのデータからパターンを学びます。
たとえば、画像から「これは猫か犬か」を学んだり、家のデータから「この家はいくらくらいかな」と予測したり。
このように、判別したり予測したりするモデルを作るんですね。
### 学習データとテストデータに分ける
このとき、手元のデータを「**学習データ**」と「**テストデータ**」に分けて、本当にうまく予測できているかをチェックします。
もし、手元のデータを全部使って学習し、同じデータで精度をチェックしてしまうと、実際に運用したときの精度との間に、ずれ(乖離)が生まれてしまうんです。
本来、モデルを使う本番では、これから来る未来のデータは知り得ません。
そこで、手元のデータを「学習に使うデータ」と「まだ見ぬ未来のデータ(の代わり)」に分けて、本番と同じ状況を疑似的に作ってあげるというわけですね。
| | 役割 | テストでたとえると |
|---|---|---|
| 学習データ | モデルがパターンを学ぶためのデータ | 問題集(答えつきで勉強する) |
| テストデータ | 学習したモデルの実力を確かめるためのデータ | 本番のテスト(初めて見る問題) |
データの分け方や、分け方を変えて何度も確かめる「交差検証」については、以下の記事で解説しています。
## リーケージとは?
それでは、リーケージとは何なのでしょうか?
### AIが「カンニング」してしまうこと
**リーケージとは、AIが本来知り得ないはずの未来の情報や正解のヒントを、ずるして先に知ってしまうこと**です。
英語の「leakage(漏れ)」から来ていて、「データリーケージ」とも呼ばれます。「リークしている」「リークが起きている」という言い方もしますね。
たとえば、こんなことが起きると、リーケージになります。
:::warn
**・本当はAIが知らないはずの、正解のヒントがデータに入っていた**\
**・学習用とテスト用のデータが、混ざっていた**\
**・未来のデータを使って学習して、過去を予測していた**
:::
こんなことが起きると、AIは「知り得ない答えを知っている」という状態になります。
これは、人間がテストでカンニングをするようなものです。
つまり、リーケージとは、AIがカンニングしているようなものなんです!
### 精度が「実力以上」に良く見えてしまう
リーケージがやっかいなのは、精度が実力以上に良く見えてしまうことです。
すごく高い精度が出たと思っても、実は、知ってはいけない情報を事前に知っていただけだった…ということになるんです。
そして、本番ではそのカンニングができないので、精度がガクッと下がってしまいます。
| | 検証での精度 | 本番での精度 |
|---|---|---|
| リーケージなし | ほどほど | 検証と同じくらい |
| リーケージあり | とても高い | 検証よりずっと低い |
「手元のデータにぴったり合いすぎて、新しいデータで当たらない」という点では「過学習」と似ていますが、リーケージは検証のしかた自体にずるが入りこんでいるので、検証の結果を見ても気づきにくいのがこわいところです。
## リーケージが起きやすい例
「そんなの簡単に防げるじゃん」と思うかもしれません。
でも、リーケージは意外と、思いがけないタイミングで起きやすいんです。
いくつか例を紹介していきましょう。
### 例1:時系列データをランダムに分けてしまう
1つ目は、時間の情報が入っている「時系列データ」で、未来のデータを使って学習して、過去のデータを予測してしまうケースです。
先ほど話したとおり、モデルを作るときは、データを学習データとテストデータに分けます。
このとき、ランダムに分ける(ランダムスプリット)というやり方がよく使われます。
ところが、時系列データでランダムに分けてしまうと、未来のデータが学習データに入り、過去のデータがテストデータになるということが起きてしまうんです。
架空のお店の、3年分の毎日の売上データで見てみましょう。
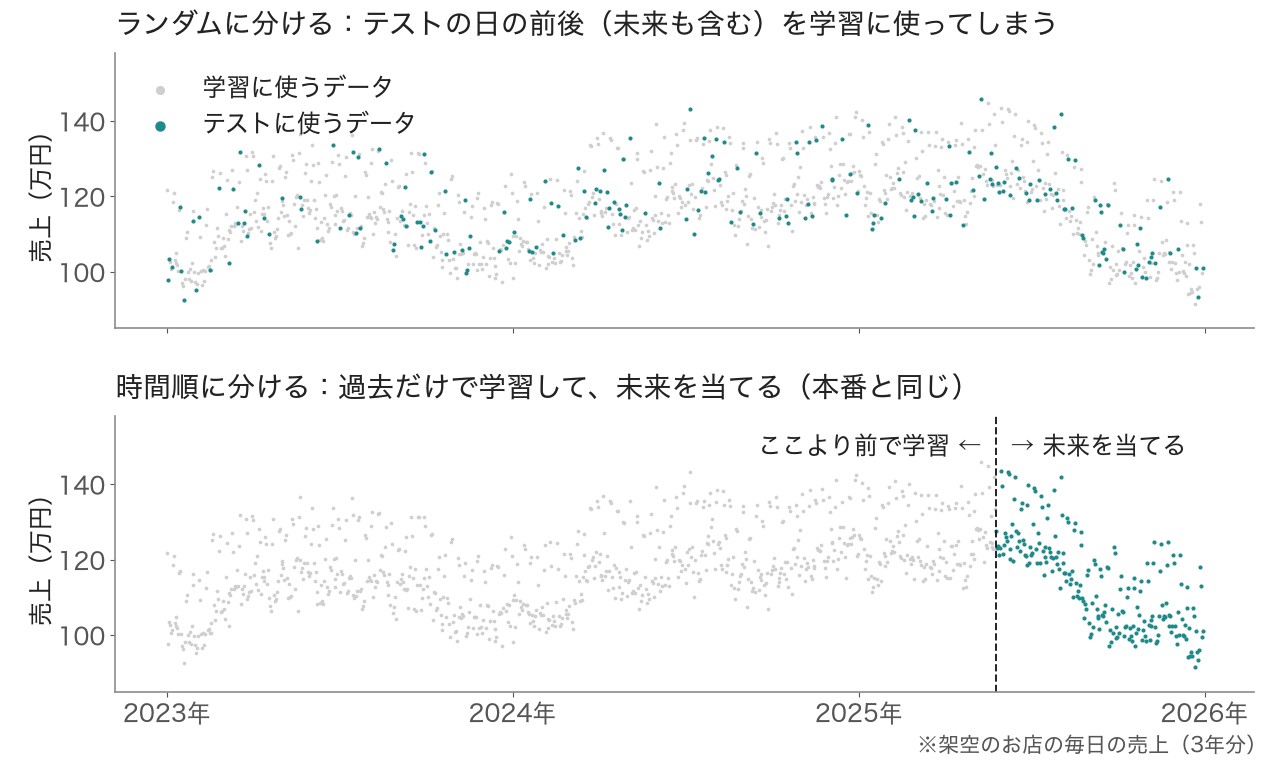
上のようにランダムに分けると、テストに使う日(青緑)のすぐ後の日のデータも、学習に使われてしまいます。
「明日の売上」を知った状態で「今日の売上」を当てるようなものなので、当たって当然ですよね。
これは現実の世界では起こりえないので、リーケージになってしまうんです。
時系列データを使う場合は、ちゃんと時間の順番に沿って分ける必要があります。
### Pythonで差を確かめてみよう
実際に、同じデータ・同じモデルで、分け方だけを変えて比べてみましょう。
```python
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestRegressor
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_absolute_error
# 架空の「お店の毎日の売上(万円)」を3年分つくる
rng = np.random.default_rng(0)
days = pd.date_range("2023-01-01", periods=365 * 3, freq="D")
t = np.arange(len(days))
trend = 100 + 0.05 * t # ゆるやかに伸びる
wave = np.cumsum(rng.normal(0, 1.0, len(days))) # 景気などの読めない波
week = np.where(days.day_of_week >= 5, 15, 0) # 土日は多め
sales = trend + wave + week + rng.normal(0, 3, len(days))
X = pd.DataFrame({"通し番号": t, "曜日": days.day_of_week, "月": days.month})
y = sales
# ① ランダムに分ける(未来のデータで学習して、過去を当てることになる)
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.2, random_state=0)
model = RandomForestRegressor(random_state=0).fit(X_tr, y_tr)
print(f"ランダムに分けた検証:{mean_absolute_error(y_te, model.predict(X_te)):.1f}万円のずれ")
# ② 時間の順番に分ける(前の8割で学習して、最後の2割=未来を当てる)
cut = int(len(X) * 0.8)
model = RandomForestRegressor(random_state=0).fit(X[:cut], y[:cut])
print(f"時間順に分けた検証:{mean_absolute_error(y[cut:], model.predict(X[cut:])):.1f}万円のずれ")
```
```text
ランダムに分けた検証:3.0万円のずれ
時間順に分けた検証:15.4万円のずれ
```
1日あたりの予測のずれ(平均絶対誤差)は、ランダムに分けると約3.0万円、時間順に分けると約15.4万円になりました。
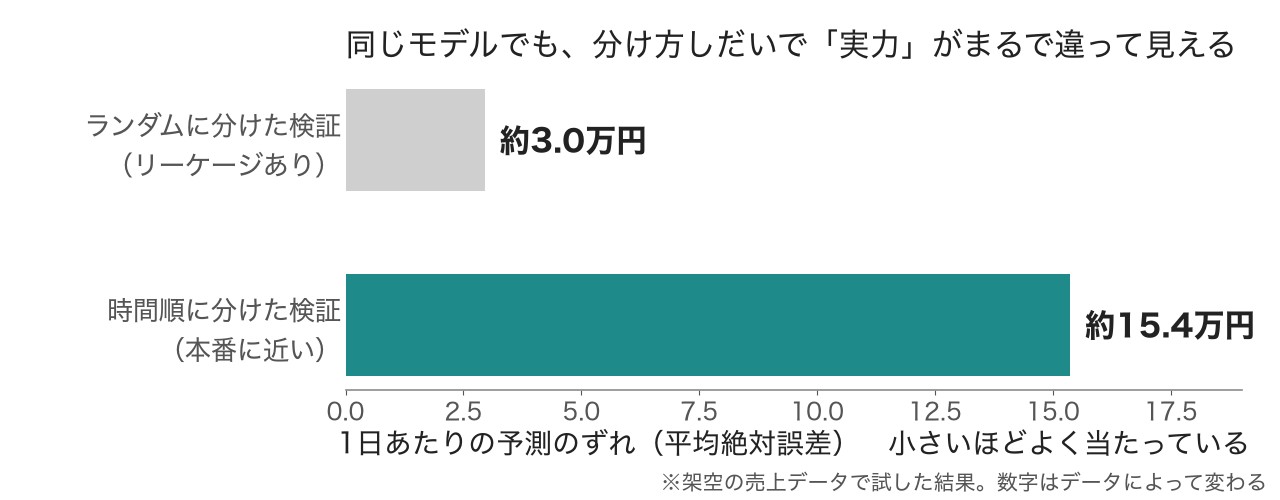
ランダムに分けた検証だけを見ていたら、「このモデルは1日あたり3万円くらいのずれで当てられる!」と思ってしまいますよね。
でも、本番で未来を当てるときの実力に近いのは、時間順に分けた15.4万円のほうです。
同じモデルでも、分け方しだいで「実力」がまるで違って見えてしまうんです。
※架空のデータで試した結果なので、数字そのものはデータによって変わります。
時系列データで交差検証をしたいときは、scikit-learnの `TimeSeriesSplit` を使うと、いつも「過去で学習して、その先を当てる」形で分けてくれます。
```python
import numpy as np
from sklearn.model_selection import TimeSeriesSplit
X = np.arange(10).reshape(-1, 1) # 時間の順に並んだ10日分のデータ
for train_idx, test_idx in TimeSeriesSplit(n_splits=3).split(X):
print("学習:", train_idx, "→ テスト:", test_idx)
```
```text
学習: [0 1 2 3] → テスト: [4 5]
学習: [0 1 2 3 4 5] → テスト: [6 7]
学習: [0 1 2 3 4 5 6 7] → テスト: [8 9]
```
どの回も、学習に使うのはテストより前の日だけになっていますね!
時系列データの扱い方については、以下の記事も参考にしてみてください。
### 例2:予測したいものと「ほぼ同じ情報」を使ってしまう
2つ目は、今月の売上を予測するのに、「今月の販売数量」という項目(カラム)を使ってしまうケースです。
今月の販売数量と売上は、ほぼ比例するはずですよね。
つまり、今月の販売数量が分かれば、今月の売上もだいたい分かってしまいます。
そのため、このモデルは検証ではとても良い精度が出ます。
でも、よく考えてみてください。
売上を予測したいタイミングでは、今月の販売数量もまだ分かっていないはずです。
販売数量を使って予測するモデルを作っても、本番では使えません。
いい精度が出たと喜んだのもつかの間、実運用に乗せようと思ったら運用できない…ということになるんです。
ほかにも、こんな例があります(説明のための例です)。
| 予測したいもの | リーケージになる特徴量の例 | なぜダメ? |
|---|---|---|
| 今月の売上 | 今月の販売数量 | 予測する時点では、まだ分からない |
| サービスを解約するか | 解約手続きのページを開いた日時 | 解約が決まったあとに生まれる情報 |
| 病気かどうか | その病気の治療薬を使ったかどうか | 診断がついたあとに生まれる情報 |
| ローンを返せなくなるか | 督促の連絡をした回数 | 返せなくなったあとに増える情報 |
どれも、「答えが出たあと」や「答えとほぼ同じタイミング」にしか手に入らない情報です。
「予測する時点で、その情報は本当に手に入る?」と問いかけるのが、このタイプのリーケージを見抜くコツです。
## 気づきにくい「微妙なリーケージ」
「こんなの当たり前でしょう」と思うかもしれませんが、意外とリーケージが起きていることは多いので注意しましょう。
リーケージの中にも、「明らかなリーケージ」と「微妙なリーケージ」があります。
| | 明らかなリーケージ | 微妙なリーケージ |
|---|---|---|
| 精度 | 異様に高くなる(正解率99%など) | 少しだけ良くなる |
| 気づきやすさ | おかしいと気づきやすい | 気づかないことも多い |
| 例 | 答えそのものが特徴量に入っている | 前処理で、テストデータの情報を少しだけ使ってしまう |
明らかなリーケージは、精度が異様に高くなるので分かりやすいんですが、微妙なリーケージには気づかないこともあります。
### 前処理でテストデータの情報を使ってしまう
微妙なリーケージの代表が、データを分ける前に、全部のデータを使って前処理をしてしまうケースです。
たとえば、「たくさんある特徴量の中から、正解とよく関係していそうなものを選ぶ」という作業を、データを分ける前に全部のデータでやってしまうと、テストデータの正解の情報がこっそり混ざってしまいます。
正解とまったく関係のない、でたらめなデータで試してみましょう。本当なら、正解率は50%くらいにしかならないはずです。
```python
import numpy as np
from sklearn.feature_selection import SelectKBest, f_classif
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import make_pipeline
# 正解とまったく関係のない、でたらめなデータ(100人分 × 5,000個の特徴量)
rng = np.random.default_rng(0)
X = rng.normal(size=(100, 5000))
y = rng.integers(0, 2, size=100) # 正解もでたらめ → 本当の正解率は50%くらいのはず
# だめな例:全部のデータを見て「効きそうな特徴量」を20個選んでから検証する
X_selected = SelectKBest(f_classif, k=20).fit_transform(X, y)
bad = cross_val_score(LogisticRegression(), X_selected, y, cv=5).mean()
print(f"選んでから検証:{bad:.2f}")
# よい例:特徴量を選ぶところも、学習データの中だけでやる(パイプラインにまとめる)
pipe = make_pipeline(SelectKBest(f_classif, k=20), LogisticRegression())
good = cross_val_score(pipe, X, y, cv=5).mean()
print(f"検証の中で選ぶ:{good:.2f}")
```
```text
選んでから検証:0.85
検証の中で選ぶ:0.48
```
でたらめなデータなのに、先に全部のデータで特徴量を選んでしまうと、正解率が85%も出てしまいました!
テストデータの正解を見て「たまたま正解と合っていた特徴量」を選んでいるので、テストでも当たってしまうんです。
特徴量を選ぶ作業も学習データの中だけで行うと、正解率は48%。でたらめなデータらしい、本当の実力が見えました。
同じように、標準化(平均や標準偏差で値をそろえる)や、欠損値の穴埋めに使う平均値なども、学習データだけから計算するのが基本です。scikit-learnの `Pipeline`(`make_pipeline`)を使うと、こうした前処理を学習データの中だけで行う形にまとめられます。
また、目的変数(正解)の平均を特徴量にする「ターゲットエンコーディング」も、やり方によってはリークの原因になります。特徴量の作り方については、以下の記事で解説しています。
### 同じものが学習とテストの両方に入ってしまう
ほかにも、気づきにくいリーケージとして、同じ人や同じ物のデータが、学習データとテストデータの両方に入ってしまうケースがあります。
たとえば、1人の患者さんから何枚もレントゲン画像を撮っていて、それをランダムに分けると、同じ人の画像が学習とテストの両方に入ってしまいます。
するとモデルは、「病気の特徴」ではなく「その人の特徴」を覚えて当ててしまうかもしれません。
このような場合は、人ごとにまとめて分ける(scikit-learnなら `GroupKFold` など)ようにしましょう。
常にリーケージが起きていないか、頭に入れておきましょう!
## リーケージを防ぐ方法
では、リーケージはどうすれば防げるのでしょうか?
### データをよくチェックするクセをつける
まずは、「リーケージは起きるものだ」ということを念頭において、データをよくチェックすることが大事です。
未来の情報や、答えそのもののような情報が入っていないか、確認するクセをつけましょう。
そのうえで、学習用とテスト用のデータをしっかり分けて、変な特徴量を使わず、本当に必要な情報だけを使うようにしましょう。
### リーケージを防ぐチェックリスト
具体的には、次のポイントを確認するのがおすすめです。
:::good
**・その特徴量は、予測する時点で本当に手に入る情報か?**\
**・時系列データは、時間の順番に沿って分けているか?**\
**・前処理(特徴量の選択・標準化・穴埋めなど)は、学習データだけで行っているか?**\
**・同じ人や同じ物のデータが、学習とテストの両方に入っていないか?**\
**・精度が良すぎるときは、特徴量の重要度を見て、怪しい特徴量がないか確かめたか?**
:::
特に最後の「精度が良すぎたら疑う」は大事です。
モデルが特定の特徴量にばかり頼っているときは、その特徴量が答えのヒントになっていないかを確かめてみましょう。
ちなみに、Kaggleのようなデータ分析コンペでも、リークはたびたび話題になる有名な問題です。実際に手を動かしてデータと向き合うと、リーケージに気づく感覚も身についていきますよ。
## リーケージのまとめ
最後に、今回のポイントをおさらいしましょう!
:::point
**・リーケージとは、AIが本来知り得ない未来の情報や正解のヒントを先に知ってしまう「カンニング」のこと**\
**・リーケージがあると、検証の精度は高いのに、本番ではまったく当たらないモデルになってしまう**\
**・時系列データのランダムな分割や、予測したいものとほぼ同じ情報を使うことが、よくある原因**\
**・前処理を全部のデータでしてしまうなど、気づきにくい「微妙なリーケージ」もある**\
**・「予測する時点で手に入る情報か?」を考え、学習用とテスト用のデータをしっかり分けよう**
:::
:::talk{who="umatan"}
要は、AIにカンニングをさせないことが、本当に使えるモデルを作る第一歩なんです!精度が良すぎるときこそ、「これ、リークしてない?」と疑ってみてください!
:::
機械学習やデータ分析を体系的に学びたいのであれば、当メディアが運営するスクール「**[スタアカ](https://toukei-lab.com/achademy/)**」がオススメです!
:::box
**[業界最安級のAIデータサイエンス特化スクール「スタアカ」](https://toukei-lab.com/achademy/)**
:::