# 教師あり学習と教師なし学習の違いとは?【データサイエンティストが解説】
> 当サイト【スタビジ】の本記事では、機械学習の基本である教師あり学習と教師なし学習の違いを、回帰・分類・クラスタリングなどの具体例とともにわかりやすく解説します。どちらにも当てはまらない強化学習についても紹介しますよ!
- URL: https://toukei-lab.com/learning-nonlearning
- 公開: 2022.11.29 / 更新: 2024.11.09
- サイト: スタビジ(https://toukei-lab.com)
こんにちは!
データサイエンティストのウマたん([@statistics1012](https://twitter.com/statistics1012?lang=ja))です!
データサイエンスの世界で登場するのが、「**教師あり学習と教師なし学習**」という概念。
[ディープラーニング](/deep-learning)が台頭してきたことにより、さらに良く聞くようになってきました。
今回は、そんな教師あり学習と教師なし学習の違いについてまとめていきます。
## 教師あり学習と教師なし学習
:::talk{who="umatan"}
**教師あり学習**ってなに?
:::
:::talk{who="robotan"}
言葉を分解してみようか。まず、学習とはデータを解析して何らかのモデルを作ることだよ。次に、教師とは答えとなるデータのことだよ。つまり、各サンプルに対して与えられている正解データを基準にしてモデルを作ることを教師あり学習というよ。
:::
:::talk{who="umatan"}
ちょっとイメージがしづらいなあ。
:::
:::talk{who="robotan"}
具体例として下のようなデータを考えてみよう!
:::

:::talk{who="robotan"}
このデータを二つのグループに分類することを考えてみよう。どう分類するかな?分類する境界線を引いてみると・・・
:::
:::talk{who="umatan"}
うーん、データの集まり方で分類するなら右で、赤と黒で分類するなら左のような感じかな?
:::

:::talk{who="robotan"}
いいね。左のように分類するときには、x1とx2の情報以外に赤と黒というもう一つの情報を使ったね。これが教師あり学習だよ。一方で、右のように分類するときにはx1とx2の集まり方のみで決めたね。これが教師なし学習だよ。
:::
:::talk{who="umatan"}
x1とx2のデータのみで決めるか、特徴を表す教師データを使って決めるかということか!
:::
:::talk{who="robotan"}
そういうことだね。教師あり学習の例は[回帰分析](/%e5%9b%9e%e5%b8%b0%e5%88%86%e6%9e%90)などがあり、教師なし学習の例は[主成分分析](/pca)などがあるんだ。色々勉強していこう!
:::
そう、言葉から何となくイメージが出来るように、教師あり学習はあらかじめ決められたラベルが付いていて、教師なし学習はラベルが付いていないんです。
:::box
**教師あり学習・・・ラベルあり**\
**教師なし学習・・・ラベルなし**
:::
統計の言葉で言うと、目的変数が定義された解析を行う場合それは教師あり学習。
目的変数がない場合は教師なし学習です。
例えば、先ほどの例だと、X1とX2という変数に対して赤黒という質的変数が存在するのですが、とくに赤黒というラベルを気にせず目的変数を定義せずに解析を行う場合は教師なし学習になるんです。
教師あり学習の場合は、答えが分かっている教師データを基にモデルを作って、それを答えの分からない未知データに当てはめます。
## 教師あり学習の例
続いて、教師あり学習の例を見ていきましょう!
### 回帰分析
教師あり学習の定番は、[回帰分析](/%E5%9B%9E%E5%B8%B0%E5%88%86%E6%9E%90)。
回帰分析では、ある目的変数と説明変数の関係を見ていくことになります。
元々正解の分かっているデータから回帰モデルを作って、それを新たなデータに当てはめます。
アイスクリームの需要予測などが良い例。
アイスクリームの売れた個数(これがいわゆる教師ラベル)をその日の温度や湿度などから予測するモデルを作ります。
正解が分かっている教師データが与えられているので教師あり学習になります。
回帰分析についてはこちらの記事にまとめていますので良ければご覧ください!
### 判別分析
回帰分析が、量的変数を目的変数として扱うのに対して判別分析は質的変数を目的変数として扱います。
先ほどの赤黒の例などは、赤というラベルと黒というラベルが与えられており、それらは質的変数なので判別分析の分野ですね。
判別分析系のように質的変数を目的変数として扱うタイプとしては先ほどの機械学習手法や決定木などの手法も当てはまります。
### 決定木
[決定木](/%e6%b1%ba%e5%ae%9a%e6%9c%a8)は、回帰にも分類にも用いることが可能な手法。
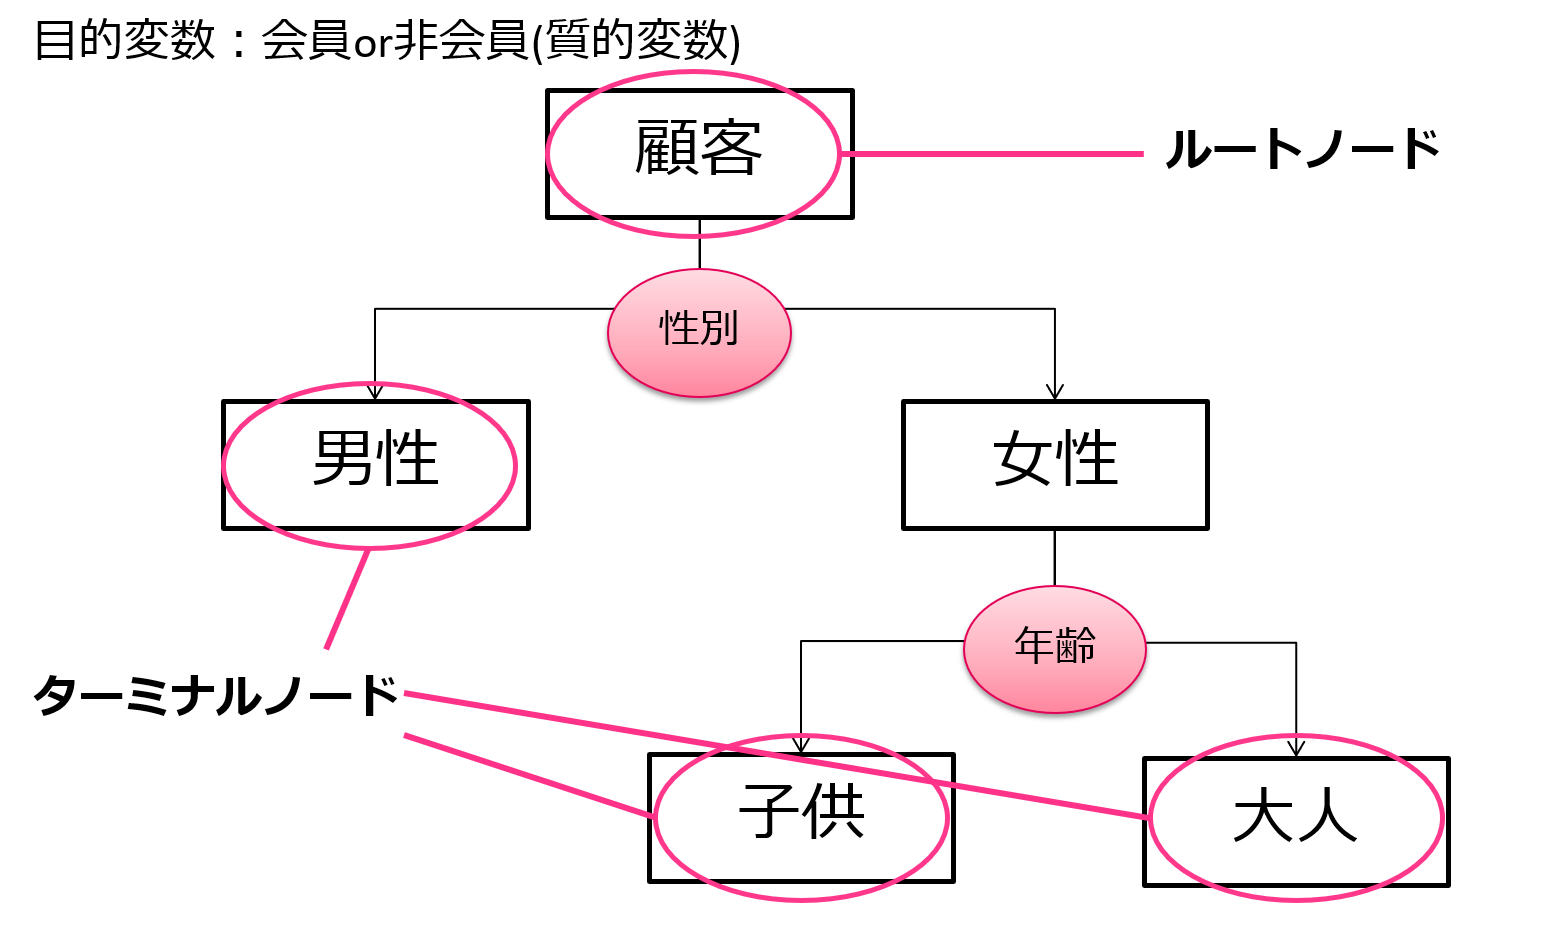
決定木っていうのはその名の通り**木構造でデータ分類していく手法**で、そこそこの精度と結果の視認性から実務の場で良く用いられています!
決定木に関しては以下の記事でまとめています!
### 各種機械学習手法
各種強力な機械学習手法も基本的には教師あり学習に分類されます。
それぞれ強みや弱みがありますのでここでは細かくは紹介しませんが、回帰問題・分類問題どちらにも使うことができる手法群です。
:::box
・[ランダムフォレスト](/%e3%83%a9%e3%83%b3%e3%83%80%e3%83%a0%e3%83%95%e3%82%a9%e3%83%ac%e3%82%b9%e3%83%88)\
・[サポートベクターマシン](/svm)\
・[ナイーブベイズ](/naivebaise)\
・[ニューラルネットワーク](/nn)\
・[k近傍法](/%ef%bd%8b%e8%bf%91%e5%82%8d%e6%b3%95)\
・[XGboost](/xgboost)\
・[LightGBM](/light-gbm)\
・[Catboost](/catboost)\
・[ディープラーニング](/deep-learning)
:::
以下の記事で詳しくまとめています!
## 教師なし学習
続いて教師なし学習の例を見ていきましょう!
### クラスター分析
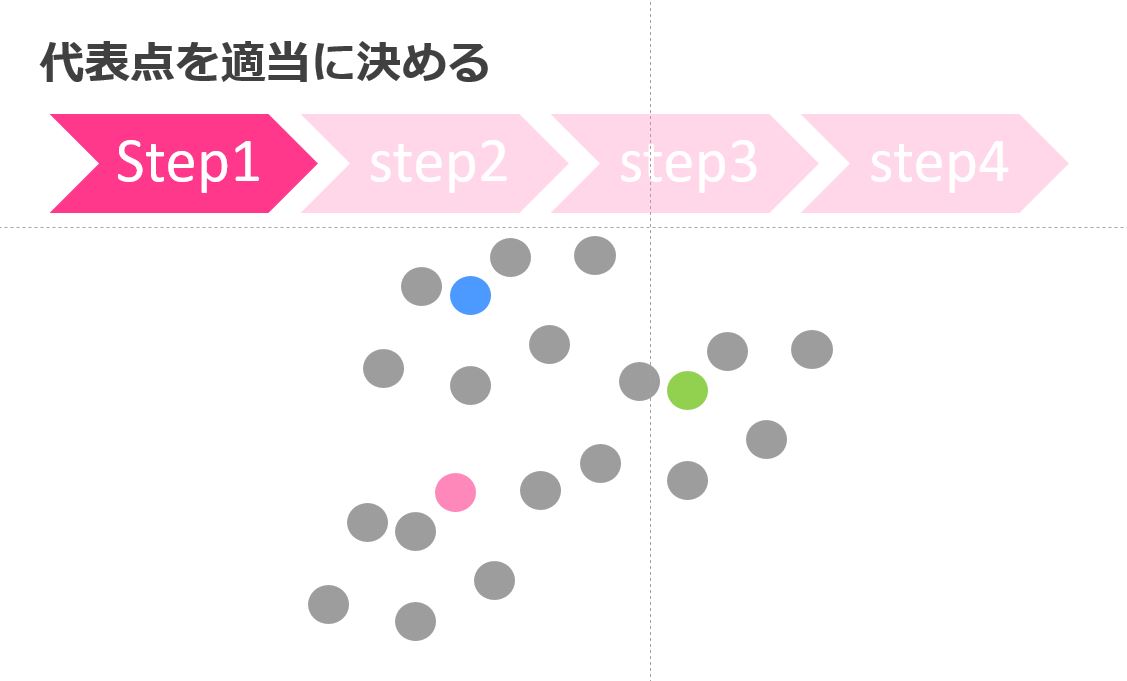
[クラスター分析](/%E3%82%AF%E3%83%A9%E3%82%B9%E3%82%BF%E3%83%BC%E5%88%86%E6%9E%90)は教師なし学習の中でもっとも有名ですね!
クラスター分析では、正解となるラベルが与えられていません。**膨大なデータの中からあるパターンを見つけ出す手法**になります。
例えば、顧客の行動データなどをクラスター分析にかけることによって、そのままでは見えてこない顧客セグメントが浮かび上がってくることがあります。
クラスター分析には**階層的**クラスター分析と**非階層的**クラスター分析があります。
非階層的クラスター分析ではあらかじめクラスター数を決めなくてはいけませんが膨大なデータでも比較的計算が早いです。
非階層的クラスター分析の定番はk-means法。非常に簡単に実装できるんですよー!
クラスター分析に関してはこちらの記事にまとめていますので良ければご覧ください!
### 主成分分析
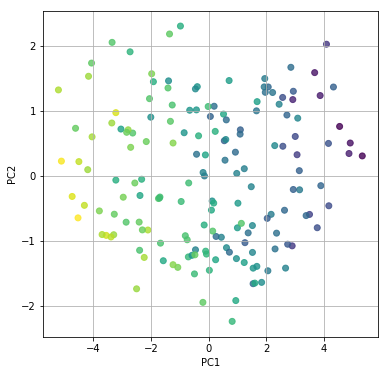
[主成分分析](/pca)は次元削減のために用いられることが多い手法です。
イメージ的にはクラスター分析に近いのですが、クラスター分析がサンプルをカテゴライズしていたのに対して、主成分分析では変数をカテゴライズします。
例えば、各教科の点数があった時(数学・化学・物理・世界史・日本史・英語などなど)それらに主成分分析をかけることによって、変数をいくつかにまとめあげることができます。
この場合、理系・文系というように分けられることが想像できます。
主成分分析により次元圧縮をしてからクラスター分析をすることなども方法として考えられます。
主成分分析に関してはこちらにまとめています!
:::talk{who="robotan"}
教師あり学習は「予測」、教師なし学習は「グルーピング」ってイメージ?
:::
:::talk{who="umatan"}
そのイメージで大丈夫!
:::
## 教師なしでもありでもない強化学習
実は、教師あり学習でも教師なしでもない[強化学習](/reinforcement-learning)という手法があります。
強化学習は、昨今最も注目を集めている分野です。
教師あり学習と似ていますが、教師あり学習は全ての変数(特徴量)に対してフィードバックがありますが、強化学習は最終的な結果にのみフィードバックをします。
それを強化学習の世界では報酬と言いますが、報酬をたくさんもらえるように最適化すると最終的に精度の高いモデルが構築されるというイメージです。

まだまだビジネスの世界への適応例は少ない手法です。
強化学習については以下の記事にまとめています!
## 教師あり学習と教師なし学習 まとめ
本記事では主に、**教師あり学習と教師なし学習の違い**について見てきました。
時と場合によって教師あり学習と教師なし学習を使い分けましょう!
クラスター分析をしてラベルを作ったあとにそれらを目的変数として教師あり学習を行うなどの組み合わせ技などもあります。
機械学習・統計学・データサイエンス全般についてもっと学びたい方は以下の記事でまとめていますのでチェックしてみてください!
またAIデータサイエンスを網羅的に学べるスクール「[スタアカ(スタビジアカデミー)](https://toukei-lab.com/achademy/)」を当メディアが運営しております!是非のぞいてみてください!
:::box
**[業界最安級AIデータサイエンス特化スクール:スタアカ(スタビジアカデミー)](https://toukei-lab.com/achademy/)**
:::
イラスト出典:**[Illustration by Stories by Freepik](https://stories.freepik.com/)**