# LoRAとは?大規模言語モデルを軽く追加学習する仕組みを分かりやすく解説!
> LoRA(ローラ)とは、大規模なAIモデルの重みは固定したまま、小さな行列だけを学習して効率よくファインチューニングする技術です。本記事では、意味や仕組み、計算が少なくて済む理由、LLMや画像生成AIでの活用例、使うときの注意点を図解で分かりやすく解説します!
- URL: https://toukei-lab.com/lora
- 公開: 2026.10.28
- サイト: スタビジ(https://toukei-lab.com)
:::talk{who="umatan"}
当サイト【スタビジ】の本記事では、「LoRA」について分かりやすく解説していきます!大規模なAIを少ない計算で自分好みに育てる仕組みから、活用例、使うときの注意点まで見ていきましょう!
:::
こんにちは!ウマたんです!
ChatGPTやGeminiのような大規模言語モデル(LLM)を、自分たちの業務や用途に合わせてカスタマイズしたい。
そんな声が、どんどん増えています。
でも、大規模なAIをゼロから学習させるには、ばく大な計算とお金がかかってしまいますよね。
そこで注目されているのが「**LoRA**」という技術です。
画像生成AIの世界で「LoRAを配布しています」「このLoRAを使うと〇〇風の絵が描ける」といった言葉を見かけたことがある人もいるかもしれません。
:::talk{who="man" side="left"}
LoRAって名前はよく見るけど、結局なにをしているの?
:::
:::talk{who="woman"}
ふつうのファインチューニングと何が違うのか知りたい!
:::
本記事では、次の4つを順番に解説していきます。
:::point
**・LoRAとは?**\
**・LoRAの仕組み**\
**・LoRAのメリット**\
**・LoRAの活用例と注意点**
:::
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!
::youtube{#hw9ukrPSC9c}
## LoRAとは?
まずは結論からいきましょう!
**LoRA(ローラ)とは、大規模なAIモデルを、少ないパラメータで効率よくファインチューニングする技術**です。
LoRAは「**Low-Rank Adaptation**」の略で、日本語にすると「低ランク適応」。2021年に、Microsoftの研究者たちが論文で発表しました。
ひとことで言うと、すでに賢いAIを全部作り直すのではなく、ほんの少しの「差分」だけを追加で学習させる方法なんです。
### 料理人のたとえで考えてみよう
身近な例で考えてみましょう。
あなたが、とても腕のいい料理人を雇ったとします。その料理人はフランス料理のプロです。
でも、あなたのお店は和食屋さん。
このとき、料理人に包丁の握り方から全部教え直す必要はありませんよね。
火の通し方や味のバランスといった基礎はそのまま活かして、だしの取り方や和食の盛り付けといった「和食に必要な部分」だけを追加で覚えてもらえばいいわけです。
LoRAは、まさにこのイメージです。
:::box{title="LoRAを料理人にたとえると"}
**・フランス料理のプロの腕前**:大規模言語モデルがもともと持っている、ばく大な知識(元の重み)\
**・和食のために追加で覚えること**:特定の仕事に必要な、小さな差分(LoRAで学習する部分)
:::
もともと持っている知識はそのままにして、特定の仕事に必要な差分だけを小さく学習させる。
だから、少ないコストで高い性能を出せるんです!
### ファインチューニングのおさらい
LoRAは、「ファインチューニング」のやり方の一つです。
ここで、AIを育てる流れを簡単におさらいしておきましょう。
今の大規模言語モデルは、まずインターネット上の大量の文章などで「**事前学習**」をして、言葉や世の中の幅広い知識を身につけます。
そのうえで、特定の仕事や話し方に合わせて追加で学習させるのが「**ファインチューニング**」です。
| やり方 | 何を学習する? | かかるコスト |
|---|---|---|
| ゼロから学習 | すべてのパラメータを一から | とてつもなく大きい |
| ふつうのファインチューニング | 事前学習ずみのパラメータを、ほぼすべて更新 | 大きい |
| LoRA | 元のパラメータは固定して、小さな差分だけ | 小さい |
ファインチューニングと、よく似た言葉の転移学習の違いについては、以下の記事で解説しています。
:::memo
IoT(モノのインターネット)の世界にも「**LoRa**」という言葉があります。こちらは「Long Range」の略で、少ない電力で遠くまで届く無線通信の規格のことです。名前の読み方は同じですが、本記事で解説するAIのLoRAとはまったくの別物なので、検索するときは気をつけましょう!
:::
## LoRAの仕組み
それでは、LoRAの仕組みをもう少しくわしく見ていきましょう!
### AIの中身は「パラメータ」の巨大な表
AIモデルの内部には、「**パラメータ**」と呼ばれるばく大な数の数値が入っています。「重み」とも呼ばれます。
この数値は、縦と横に数字がずらっと並んだ表、つまり「**行列**」の形で入っています。
AIは、入力された文章を数字に変えて、この行列と掛け算をくり返すことで答えを出しているんです。
大規模言語モデルの場合、このパラメータの数は数十億から、数千億、さらにそれ以上にもなります。
### ふつうのファインチューニングは「全部」を更新する
ふつうのファインチューニングでは、このパラメータを基本的に全部更新します。
数千億個の数値を一つひとつ少しずつ動かしていくので、計算も、それを覚えておくためのメモリも、ばく大に必要になってしまいます。
さらに、用途ごとにファインチューニングすると、そのたびに元のモデルと同じ大きさのモデルが1つずつ増えていきます。
用途が10個あれば、巨大なモデルが10個。これでは保存するだけでも大変ですよね。
### LoRAは「変える分」だけを小さな2つの行列で表す
そこでLoRAは、発想を変えます。
元のパラメータの行列 $W$ はそのまま固定して、「どれだけ変えるか」という差分だけを、小さな2つの行列の掛け算で表すんです。
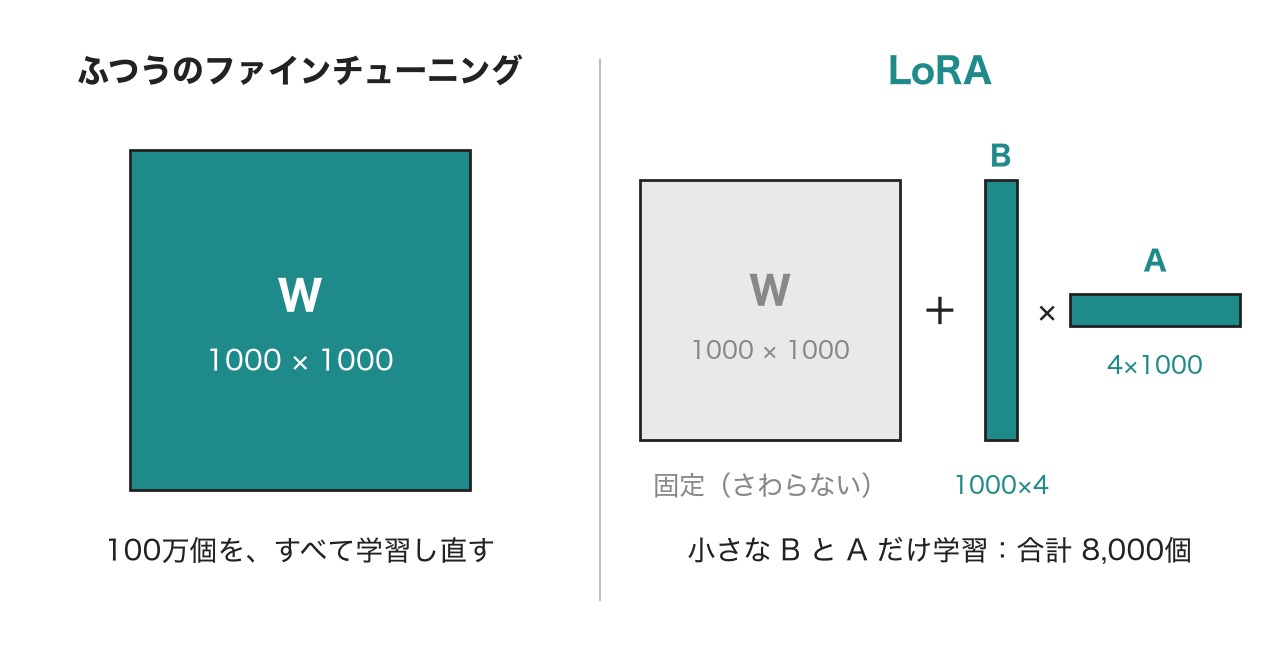
式で書くと、こんな形です。
$$
W' = W + \Delta W = W + BA
$$
$W$ が元のパラメータ(固定)、$\Delta W$ が追加の学習で変える差分です。
この差分 $\Delta W$ を、縦に細長い行列 $B$ と、横に細長い行列 $A$ の掛け算 $BA$ で表します。学習するのは、この $A$ と $B$ だけです。
### 100万個が8,000個に
具体的な数字で見てみましょう。
元のパラメータの行列が、1000×1000の大きさだったとします。中に入っている数値は100万個です。
ふつうのファインチューニングなら、この100万個すべてを学習します。
一方、LoRAで細長い行列の幅を「4」にすると、学習するのは次の数だけです。
$$
1000 \times 4 + 4 \times 1000 = 8{,}000
$$
100万個に対して、わずか8,000個。学習するパラメータは125分の1(0.8%)になるんです!
この細長い行列の幅(上の例の「4」)を「**ランク**」と呼び、記号では $r$ と書きます。LoRAの名前にある「Low-Rank(低ランク)」は、このランクを小さくすることから来ています。
ランクは、差分の表現力を決めるつまみのようなものです。大きくすると細かい変化まで表せますが、そのぶん学習するパラメータも増えます。実際には4、8、16といった小さな値がよく使われます。
### なぜ小さな行列だけで足りるの?
「そんなに小さくして、ちゃんと覚えられるの?」と思いますよね。
LoRAの論文では、追加の学習で必要になる変化は、実は少ない方向だけで表せるのではないかという考え方をもとにしています。
料理人のたとえでいえば、フランス料理から和食に切り替えるときに必要な調整は、「だしを中心にした味つけ」「季節を感じさせる盛り付け」のように、いくつかの大きな方向にまとまる、というイメージです。
基礎がしっかりしているからこそ、変えるべきところは意外と少ない。
だから、小さな行列だけでも十分に仕事に合わせられるんです!
ちなみに、学習を始めるときは $B$ をすべて0にしておくのがふつうです。こうすると、最初は差分 $BA$ が0なので、元のモデルとまったく同じ状態から、少しずつ差分を育てていけます。
## LoRAのメリット
続いて、LoRAを使うと何がうれしいのかを見ていきましょう!
### 計算とメモリが大幅に減る
1つ目は、計算とメモリが大幅に減ることです。
LoRAの論文では、GPT-3(1,750億パラメータ)で試したところ、ふつうのファインチューニングと比べて、学習するパラメータの数を約1万分の1に、学習に必要なGPUのメモリを約3分の1に減らせたと報告されています。
それでいて、いくつかのタスクでは、ふつうのファインチューニングと同じくらいか、それ以上の性能が出ています。
### 保存するファイルが小さい
2つ目は、保存するファイルが小さいことです。
LoRAで保存するのは、学習した小さな行列だけ。同じ論文では、GPT-3の例で、保存するデータが約350GBから約35MBになったと書かれています。
用途ごとにLoRAを作っても、小さなファイルが増えるだけで済むんです。
### 付け替えができて、いつでも元に戻せる
3つ目は、付け替えができることです。
元のモデルには一切手を加えていないので、1つの元のモデルに対して、用途ごとのLoRAを差し替えて使えます。
:::box{title="LoRAの付け替えのイメージ"}
**・元のモデル**+「お客さま対応用のLoRA」→ 丁寧な言葉づかいで答えるAI\
**・元のモデル**+「社内マニュアル用のLoRA」→ 社内の決まりに沿って答えるAI\
**・元のモデル**+「何もなし」→ もとのままのAI
:::
LoRAを外せば、いつでも元のモデルに戻せるのも安心なポイントです!
### 答えるときに遅くならない
4つ目は、答えるときのスピードが落ちないことです。
学習が終わったあとは、$W + BA$ を足し合わせて、1つの行列にまとめてしまえます。
そのため、ふつうのモデルと同じ速さで答えられるんです。
| | ふつうのファインチューニング | LoRA |
|---|---|---|
| 学習するパラメータ | ほぼすべて | ほんの一部 |
| 必要なGPUのメモリ | 大きい | 小さい |
| 保存するファイル | 元のモデルと同じくらい大きい | 小さい |
| 用途ごとの切り替え | モデルごと入れ替える | LoRAだけ差し替える |
| 答えるときの速さ | ふつう | ふつう(まとめれば変わらない) |
## LoRAの活用例
では、LoRAは実際にどんな場面で使われているのでしょうか?
### 社内の文書に合わせたAIアシスタント
1つ目は、企業が自社に合わせたAIアシスタントを作るときです。
社内でよく使う言葉、報告書の書き方、問い合わせへの答え方などを、オープンなLLMにLoRAで覚えさせる、といった使い方ですね。
ただし、日々変わる情報や、たくさんの社内資料の中身を正確に答えさせたいときは、資料を検索して答えに使う「**RAG**」という方法も有力です。
一般に、決まった書き方や作業の型を覚えさせるのはファインチューニングが得意、新しい情報をもとに答えさせるのはRAGが得意と言われます。目的に合わせて使い分けたり、組み合わせたりするのがおすすめです。
RAGの仕組みは、以下の記事でPythonの実装と一緒に解説しています。
### 画像生成AIで、好きな絵柄やキャラクターを覚えさせる
2つ目は、画像生成AIです。
実は、LoRAがいちばん身近に使われているのは、画像生成AIの世界かもしれません。
Stable Diffusionのような画像生成AIに、特定の絵柄やキャラクター、ものの形などを、少ない枚数の画像からLoRAで覚えさせる使い方が大人気なんです。
作ったLoRAは小さなファイルなので、ネット上で配布されたり、いくつかのLoRAを組み合わせて使ったりもされています。
Stable Diffusionの仕組みや使い方は、以下の記事で解説しています。
### 手元のGPUでLLMを育てる「QLoRA」
3つ目は、個人や小さなチームがLLMを育てるときです。
2023年には、LoRAを発展させた「**QLoRA**」という方法も発表されました。
QLoRAは、元のモデルの数値を4ビットという粗い形に圧縮(量子化)したうえで、LoRAで学習する方法です。論文では、650億パラメータのモデルを、48GBのメモリを持つGPU 1枚でファインチューニングできたと報告されています。
こうした工夫のおかげで、大きな会社でなくても、オープンなLLMを自分たちの用途に合わせて育てられるようになってきたんです!
### PythonでLoRAを使うと?
Pythonでは、Hugging Faceの「**PEFT**」というライブラリを使うと、数行でLoRAを設定できます。
```python
from transformers import AutoModelForCausalLM
from peft import LoraConfig, get_peft_model
# 元になるモデルを読み込む(この重みは固定される)
model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen2.5-0.5B")
# LoRAの設定(r がランク。どの行列に差分を足すかも指定する)
config = LoraConfig(
r=8,
lora_alpha=16,
target_modules=["q_proj", "v_proj"],
lora_dropout=0.05,
task_type="CAUSAL_LM",
)
model = get_peft_model(model, config)
model.print_trainable_parameters() # 学習するパラメータが全体の何%かを表示
```
`print_trainable_parameters()` を実行すると、学習するパラメータが全体のほんの一部だけになっていることが確かめられます。
あとは、ふつうの学習と同じようにデータを流していけばOKです。`target_modules` に指定する名前は、モデルによって変わるので注意しましょう。
## LoRAを使うときの注意点
便利なLoRAですが、使うときに気をつけたいポイントもあります。
### 元のモデルの力を超えることはできない
LoRAは、あくまで元のモデルに小さな差分を足す方法です。
料理人のたとえでいえば、基礎の腕前がない人に和食のコツだけ教えても、一流の料理人にはなれませんよね。
土台になるモデルの性能が、LoRAで作るAIの性能の上限を大きく左右するんです。
土台になるAI、つまり「基盤モデル」については、以下の記事で解説しています。
### 学習データの質がそのまま出る
少ないデータで学習できるぶん、データの質がそのまま結果に出ます。
間違いや偏りのあるデータで学習させると、AIもその間違いや偏りをしっかり覚えてしまいます。
### 元のモデルの利用条件や権利を守る
オープンなモデルにも、それぞれ利用条件(ライセンス)があります。商用で使えるか、作ったモデルを配布してよいかなどを、必ず確かめましょう。
:::warn
画像生成AIでは特に、他人の作品や実在の人物の写真を勝手に集めてLoRAを作ると、著作権や肖像権のトラブルにつながるおそれがあります。学習に使ってよいデータかどうかを、必ず確かめてから使いましょう!
:::
## LoRAのまとめ
最後に、今回のポイントをおさらいしましょう!
:::point
**・LoRAは、大規模なAIモデルを少ないパラメータで効率よくファインチューニングする技術**\
**・元の重みは固定して、差分だけを小さな2つの行列(BとA)の掛け算で学習する**\
**・計算やメモリが減り、保存するファイルも小さく、用途ごとに付け替えられる**\
**・LLMのカスタマイズや、画像生成AIで絵柄・キャラクターを覚えさせるのに大人気**\
**・土台のモデルの性能やデータの質、権利には注意**
:::
:::talk{who="umatan"}
要は、賢いAIの「基礎」はそのままに、必要なコツだけを小さく覚えさせるのがLoRAなんです!AIがどんどん大きくなるほど、こうした軽い学習の技術はますます大事になっていきますよ!
:::
LLMのカスタマイズや生成AIの仕組みを体系的に学びたいのであれば、当メディアが運営するスクール「**[スタアカ](https://toukei-lab.com/achademy/)**」がオススメです!
:::box
**[業界最安級のAIデータサイエンス特化スクール「スタアカ」](https://toukei-lab.com/achademy/)**
:::