# 欠損値の埋め方を確認して実際にPandasで欠損値補完してみよう!
> 当サイト【スタビジ】の本記事では、欠損があるデータの解析方法について説明していきます。欠損データ解析は非常に重要ですが知っておくべきことが多いので、まずは全体の概要と方法について理解してもらえたら嬉しいです。最後のパートではPandasで欠損値の補完をしていきますよ!
- URL: https://toukei-lab.com/missing-value
- 公開: 2022.11.29 / 更新: 2024.11.09
- サイト: スタビジ(https://toukei-lab.com)
:::talk{who="umatan"}
当サイト【スタビジ】の本記事では、欠損があるデータの解析方法について説明していきます。欠損データ解析は非常に重要ですが知っておくべきことが多いので、まずは全体の概要と方法について理解してもらえたら嬉しいです。最後のパートではPandasで欠損値の埋め方を学び実際に補完をしていきますよ!
:::
実データにつきものなのが、データの欠損。
そのようなデータを欠損データとか欠測データとか言ったりしますが、この記事では欠損データで統一します。
欠損データをそのまま分析してしまうと様々な不都合が生じます。
そこでこの記事では、そんな**欠損データへの対応方法**を徹底的にまとめていきます!
最後には、Pandasでの実装やオススメの本を紹介していきますよ!
ちなみに以下のYoutube動画で詳しく解説していますので是非こちらも参考にしてみてください!
::youtube{#fyAcNZfXQeY}
## 欠損データとは?
欠損データとはデータの一部が何かしらの理由によって取得できなかったデータのことを言います。
例えば、「**毎日の売り上げデータがあったとしてパソコンの故障である日のデータが消えてしまった!**」なんてことになると欠損データになります。
データに欠損があると通常の[回帰分析](/%e5%9b%9e%e5%b8%b0%e5%88%86%e6%9e%90)などをしようとしてもそのままでは解析出来ないので何かしらの対応をする必要があります。
[決定木](/%e6%b1%ba%e5%ae%9a%e6%9c%a8)系のツリーモデル([XGBoost](/xgboost)、[LightGBM](/light-gbm)、[ランダムフォレスト](/%e3%83%a9%e3%83%b3%e3%83%80%e3%83%a0%e3%83%95%e3%82%a9%e3%83%ac%e3%82%b9%e3%83%88))では欠損値があっても分析が出来ますが、やはり欠損値があると正しい[評価](/evaluation)が出来ない可能性があります。
表:欠損データ
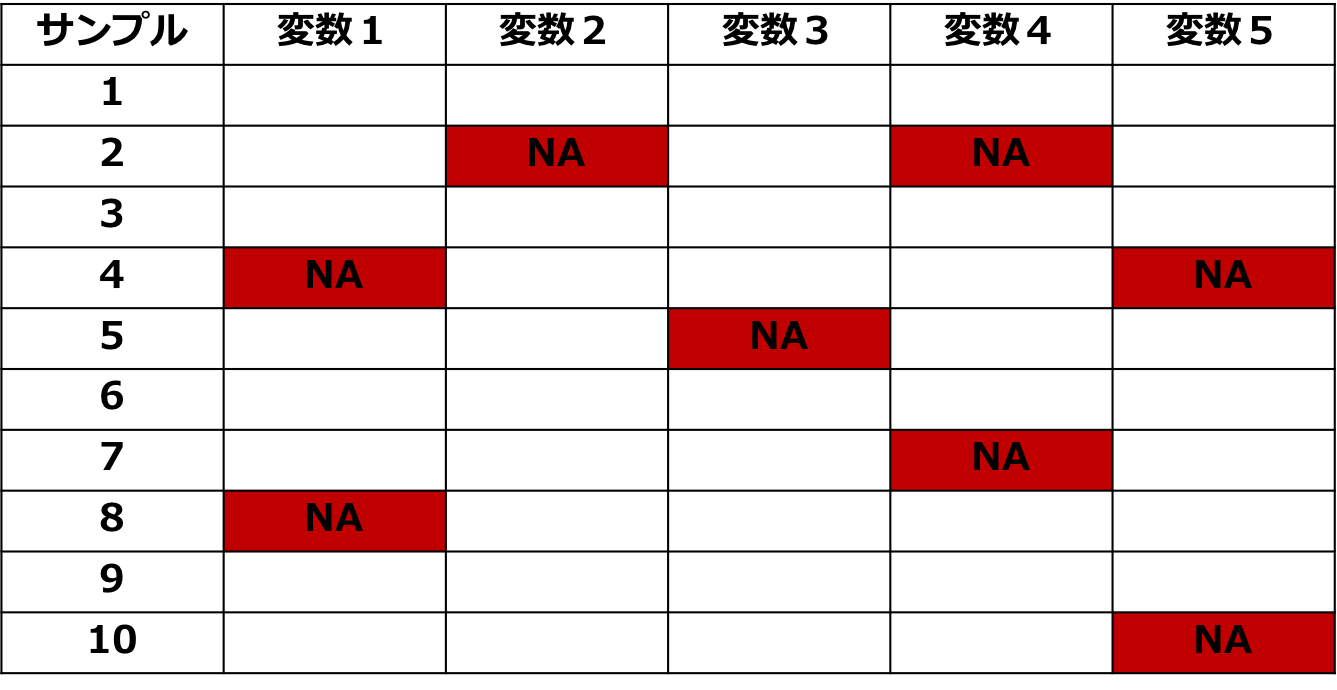
欠損データの扱いには二つの重要なポイントあります。
:::point
**・欠損メカニズム**\
**・解析のための処理方法**
:::
解析したいデータの欠損メカニズムを把握して適切な処理をしないと結果に偏りが出るおそれがあります。
## 欠損値の発生メカニズム
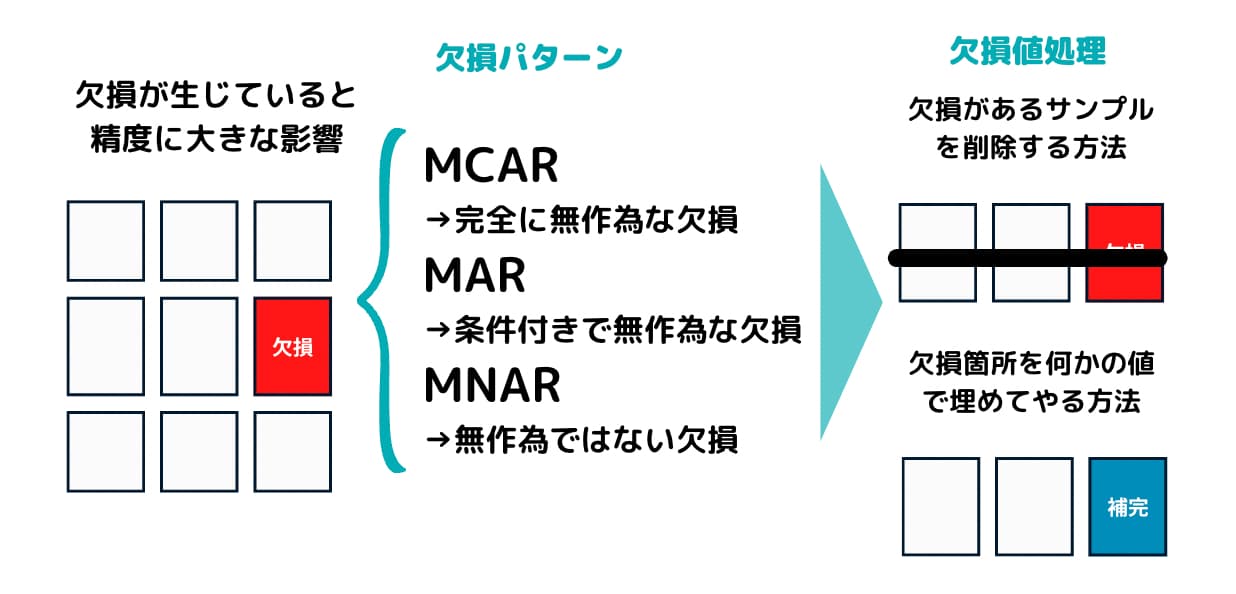
欠損メカニズムとはLittleさんとRubinさんによって提唱されたなぜ欠損をするのかを考えたものです。
メカニズムの種類によって欠損は「**無視可能**」と「**無視不可能**」に分類されます。
無視可能とは「欠損データの解析結果ともし欠損していなかった場合の完全なデータの解析結果との間に違いがない」ことを言います。
このように重要である欠損メカニズムは三つに分類されます。
### MCAR
一つ目は完全に無作為な欠損という意味で**Missing Completely At Random**の略で「MCAR」と呼びます。
これはある値の欠損する確率がデータと全く関係がない、完全にランダムに欠損することを言います。
先のデータでいうと体重を測ってもらう人ごとにサイコロを振ってもらって1が出たら体重を計らないとすれば欠損はMCARになります。
この欠損は常に無視可能です。
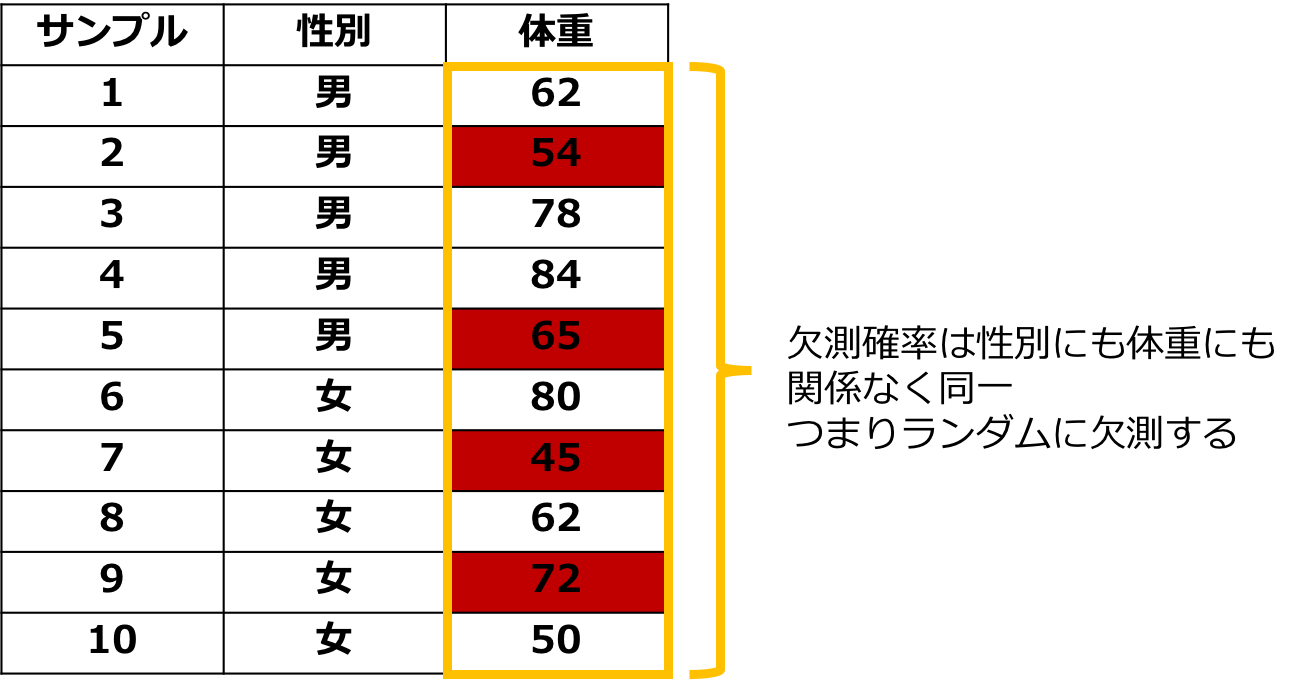
図:MCARのイメージ
### MAR
二つ目は条件付きで無作為な欠損というもので**Missing At Random**の略で「MAR」と呼びます。
これは、ある値が欠損する確率が観測されたデータで条件づけるとランダムになることを言います。
先のデータでいうと、男性と比べて女性の方が体重を計りたくないと考えるので性別によって欠損確率が変わります。
しかし、女性だけに絞ると欠損はランダムと考えられるのでMARになります。
欠損がMARの場合は欠損が存在するサンプルを削除して分析をすると推定結果が偏ることがあるので適切に処理する必要があります。
MARの場合でも無視可能とすることが多いです。
実際のデータでは欠損はMARの場合が多いです。
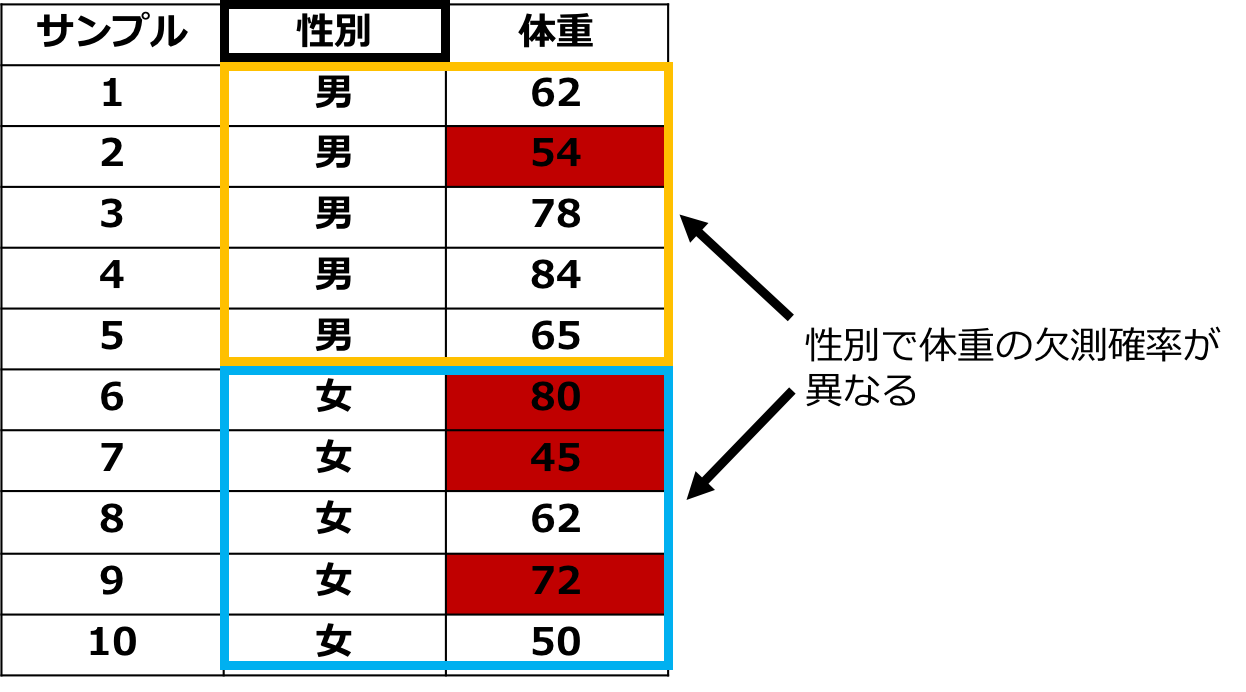
図:MARのイメージ
### MNAR
三つ目は無作為ではない欠損というもので**Missing Not At Random**の略で「MNAR」と呼びます。
これは、ある値が欠損する確率が欠損データ自体に依存していることを表します。
先のデータでいうと、体重が重い人ほど体重を計りたくないと考えると体重によって欠損確率が変わります。
データの中に体重を予測できる情報がなければ欠損は無視不可能になります。
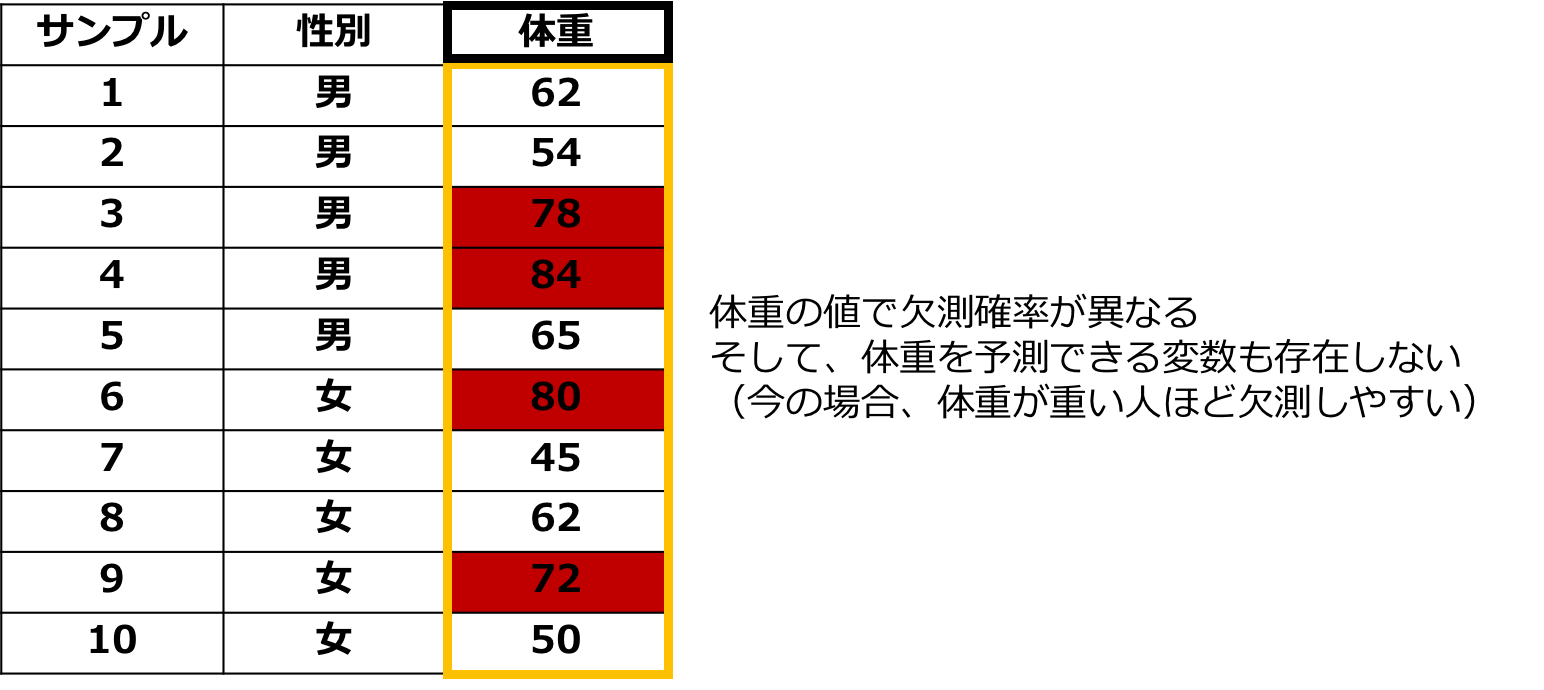
図:MNARのイメージ
:::talk{who="robotan"}
このパターンが一番厄介そうだね
:::
:::talk{who="umatan"}
その通り!適切に欠損値を処理しないと実際の傾向とは大きくずれた分析結果になってしまうよ・・!
:::
## 欠損値の処理方法
処理方法はざっくり三つに分けられます。
### 欠損があるサンプルを削除する方法
最も単純なのは各サンプルで欠損が発生しているのであればそのサンプルを削除してしまう方法があります。
削除して完全なデータにしてから回帰分析などの解析を行います。
これは**リストワイズ法**と呼ばれます。
リストワイズ法は欠損がMCARであれば推定結果は不偏ですがMARの場合には偏りが出ることがあります。
また、サンプルを削除するので解析するときに推定効率が下がるなどの問題も起こりかねません。
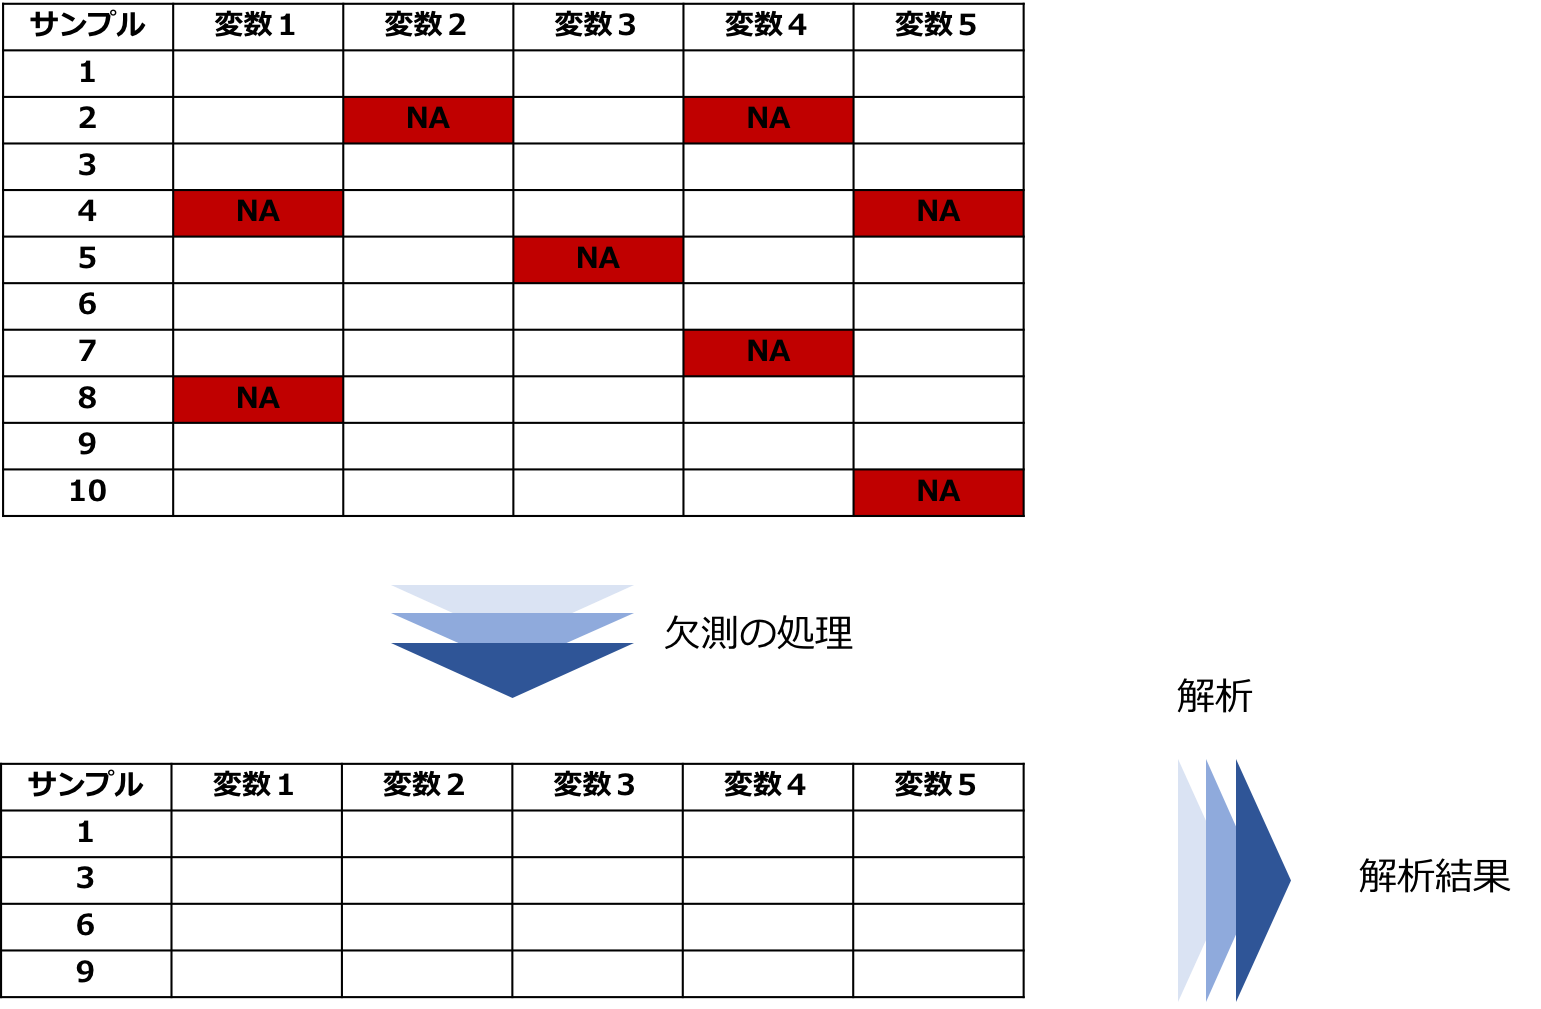
図:リストワイズ法での処理と解析
### 欠損箇所を何かの値で埋める方法
二つ目は欠損箇所を何かの値で埋める方法で代入法あるいは補完法と呼ばれます。
欠損部分に何かの値を代入することで完全なデータにしてから[回帰分析](/%E5%9B%9E%E5%B8%B0%E5%88%86%E6%9E%90)などの解析を行います。
欠損がMARの場合でも代入法だとリストワイズ法のような問題が起きません。
代入法には単一代入法と多重代入法に分けられます。
#### 単一代入法
これは一つの欠損部分に一つの値を代入する方法です。
手法としては
:::box
**・平均値代入法**\
**・比率代入法**\
**・回帰代入法**\
**・確率的回帰代入法**\
**・ホットデック法**
:::
などがあります。
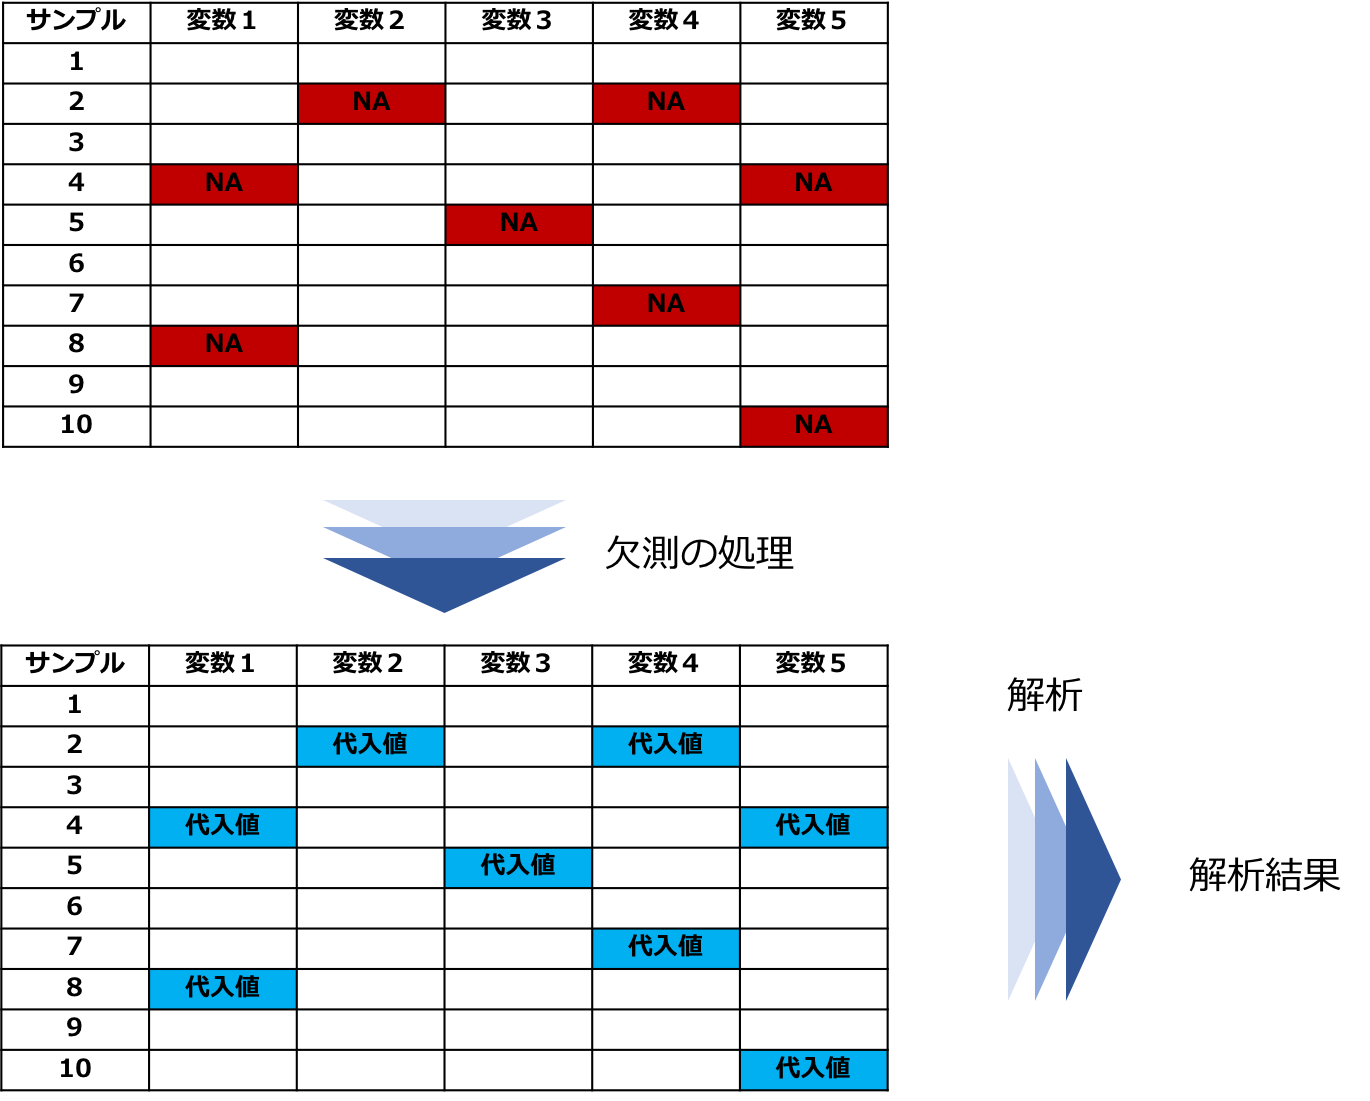
図:単一代入法での処理と解析
#### 多重代入法
これは一つの欠損部分に複数の値を代入する方法です。
単一代入法では代入に用いるモデルが一つだけであり代入のためのモデルのばらつきを評価できていません。
そこで考えられたのが多重代入法です。
欠損データの事後予測分布から無作為に抽出されたM個のデータセットそれぞれで代入を行い、その後それぞれのデータセットで回帰分析などの目的としている解析を行います。
そして最後にM個の解析結果を統合することで最終的な解析結果とします。
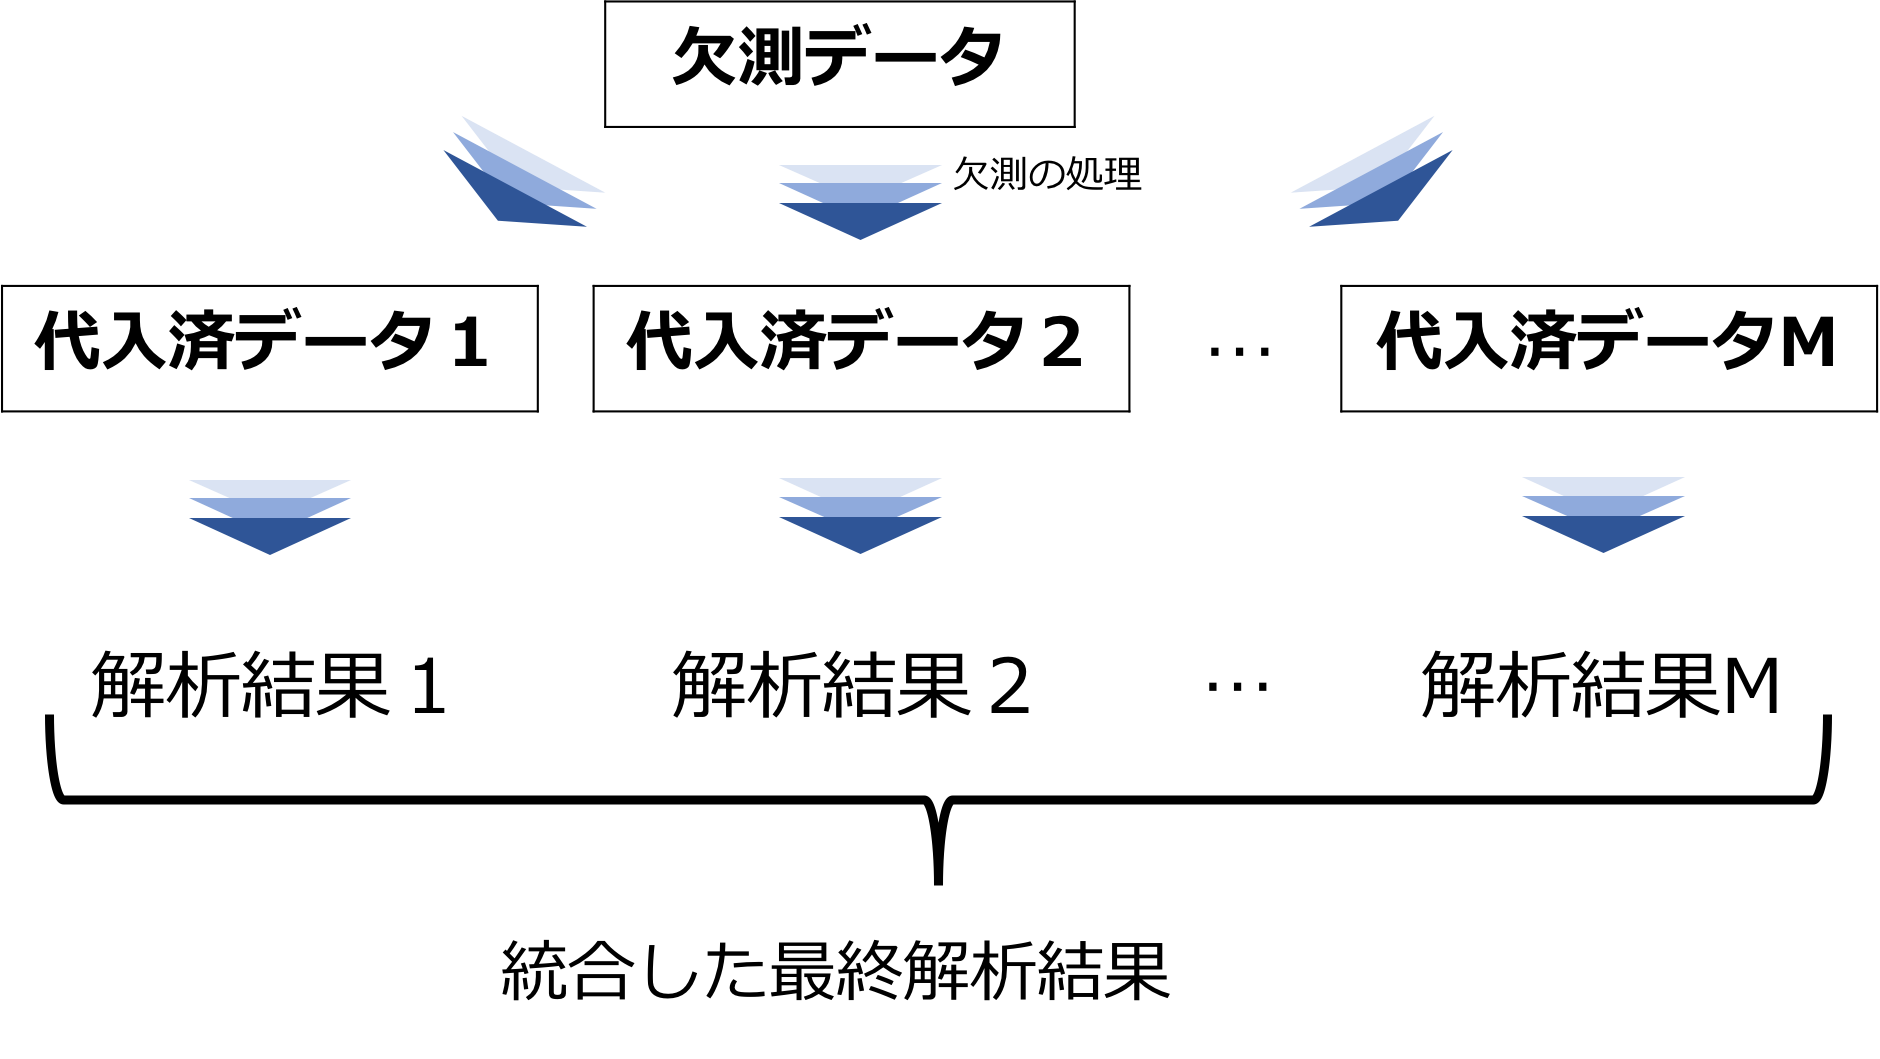
図:多重代入法での処理と解析
### 欠損があってもそのまま解析する方法
三つ目は欠損があっても、統計モデルなどを仮定することで尤度に基づく解析方法があります。
手法としては
**「完全情報最尤推定法」**
などがあります。
:::talk{who="robotan"}
処理方法にも色々あるんだな〜
:::
:::talk{who="umatan"}
その時のデータの欠損パターンあわせて使っていこう!
:::
## 欠損データをPandasで確認・補完してみよう!
最後に実際にカンタンな例を用いてPythonのPandasで欠損値の確認・補完をしていきます!
Pandasはデータ加工に便利なPythonのライブラリです。
ここでは実際にデータがあった方が分かりやすいので、[Kaggle](/kaggle)で有名な[タイタニックのデータセット](https://www.kaggle.com/c/titanic/data)を使用します。
ちなみにpandasには既存のサンプルデータセットは入っていないのですが、seabornというライブラリを使えばサンプルデータセットを読み込むことが可能です。
タイタニックのデータであれば以下のように記述することで読み込みが可能。
```python
import seaborn as sns
df = sns.load_dataset('titanic')
```
タイタニックの生死データは非常に有名ですが、実は結構な欠損があるんです。
欠損値を確認してみましょう!
```python
df.isnull().sum()
```
によって各カラムの欠損値の数を集計することができます。
> survived 0\
> pclass 0\
> sex 0\
> age 177\
> sibsp 0\
> parch 0\
> fare 0\
> embarked 2\
> class 0\
> who 0\
> adult_male 0\
> deck 688\
> embark_town 2\
> alive 0\
> alone 0\
> dtype: int64
続いて欠損値を処理する方法について見ていきましょう!
```python
df.dropna()
```
dropnaを使うことで欠損値が1つでも入っている行を削除することができます。
処理後の行数を確認してみると、
```python
df.dropna().shape
```
> (182, 15)
182行に減っていることが分かります。
元々は891行ありました。
fillna()を使うことで欠損値を埋めることができます。
```python
df['age'].head(10)
```
> 0 22.0\
> 1 38.0\
> 2 26.0\
> 3 35.0\
> 4 35.0\
> 5 NaN\
> 6 54.0\
> 7 2.0\
> 8 27.0\
> 9 14.0\
> Name: age, dtype: float64
年齢の欠損値を埋めてみましょう!
```python
df['age'].fillna(0).head(10)
```
> 0 22.0\
> 1 38.0\
> 2 26.0\
> 3 35.0\
> 4 35.0\
> 5 0.0\
> 6 54.0\
> 7 2.0\
> 8 27.0\
> 9 14.0\
> Name: age, dtype: float64
6行目を0で埋めることができましたね!
ここで平均値などを代入することもできます。
このようにPandasを使うことで簡単にデータの欠損値を補完することができるんです。
Pandasでの各種処理は以下の記事でまとめていますので是非参考にしてみてください!
## 欠損データのまとめとおすすめ参考書
本記事では、欠損データについて見てきました!
最後に欠損データのおすすめ書籍を紹介しておきましょう!
なかなか欠損データについてまとめられた書籍は少ないんですが、以下の二冊は非常に分かりやすいので是非読んでみてください!
**■欠損データの統計解析 (統計解析スタンダード)**
::product[欠測データの統計解析 (統計解析スタンダード)]{url="https://www.amazon.co.jp/dp/4254128592?tag=statistic08-22&linkCode=ogi&th=1&psc=1" image="https://m.media-amazon.com/images/I/51LiJBr9PoL._SL160_.jpg" amazon="https://www.amazon.co.jp/dp/4254128592?tag=statistic08-22&linkCode=ogi&th=1&psc=1" rakuten="https://af.moshimo.com/af/c/click?a_id=858168&p_id=54&pc_id=54&pl_id=616&url=https%3A%2F%2Fsearch.rakuten.co.jp%2Fsearch%2Fmall%2F%25E6%25AC%25A0%25E6%25B8%25AC%25E3%2583%2587%25E3%2583%25BC%25E3%2582%25BF%25E3%2581%25AE%25E7%25B5%25B1%25E8%25A8%2588%25E8%25A7%25A3%25E6%259E%2590%2B%2528%25E7%25B5%25B1%25E8%25A8%2588%25E8%25A7%25A3%25E6%259E%2590%25E3%2582%25B9%25E3%2582%25BF%25E3%2583%25B3%25E3%2583%2580%25E3%2583%25BC%25E3%2583%2589%2529%2F%3Ff%3D1%26grp%3Dproduct"}
欠損データの扱いを全体的に分かりやすくまとめています。
**■欠損データ処理: Rによる単一代入法と多重代入法 (統計学One Point)**
::product[欠測データ処理: Rによる単一代入法と多重代入法 (統計学One Point)]{url="https://www.amazon.co.jp/dp/4320112563?tag=statistic08-22&linkCode=ogi&th=1&psc=1" image="https://m.media-amazon.com/images/I/416GDCxXaiL._SL160_.jpg" amazon="https://www.amazon.co.jp/dp/4320112563?tag=statistic08-22&linkCode=ogi&th=1&psc=1" rakuten="https://af.moshimo.com/af/c/click?a_id=858168&p_id=54&pc_id=54&pl_id=616&url=https%3A%2F%2Fsearch.rakuten.co.jp%2Fsearch%2Fmall%2F%25E6%25AC%25A0%25E6%25B8%25AC%25E3%2583%2587%25E3%2583%25BC%25E3%2582%25BF%25E5%2587%25A6%25E7%2590%2586%253A%2BR%25E3%2581%25AB%25E3%2582%2588%25E3%2582%258B%25E5%258D%2598%25E4%25B8%2580%25E4%25BB%25A3%25E5%2585%25A5%25E6%25B3%2595%25E3%2581%25A8%25E5%25A4%259A%25E9%2587%258D%25E4%25BB%25A3%25E5%2585%25A5%25E6%25B3%2595%2F%3Ff%3D1%26grp%3Dproduct"}
欠損データの扱いの中でも代入法、特に多重代入法のやり方が詳しく分かりやすく書かれています。
Rのコードも載っているので実際に解析してみると理解が早く進みます。
以下の記事で統計学全般のオススメ書籍を紹介しているのであわせてご覧ください!
また機械学習やPythonについての勉強方法については以下の記事でまとめています!
ちなみに機械学習やPythonについて網羅的に学びたい方は当メディアが運営するAIデータサイエンス特化のスクール「**[スタアカ(スタビジアカデミー)](https://toukei-lab.com/achademy/)**」をチェックしてみてください!
:::box
**[業界最安級AIデータサイエンス特化スクール:スタアカ(スタビジアカデミー)](https://toukei-lab.com/achademy/)**
:::