# MoE(Mixture of Experts)とは?専門家を使い分けるAIの仕組みを分かりやすく解説!
> MoE(Mixture of Experts)とは、AIの中に複数の「専門家」を用意して、入力ごとに必要な専門家だけを選んで動かす仕組みです。本記事では、意味や仕組み(ルーター)、計算を減らせる理由、MoEを使った主なモデル、弱点や注意点を図解で分かりやすく解説します!
- URL: https://toukei-lab.com/mixture-of-experts
- 公開: 2026.10.28
- サイト: スタビジ(https://toukei-lab.com)
:::talk{who="umatan"}
当サイト【スタビジ】の本記事では、「MoE(Mixture of Experts)」について分かりやすく解説していきます!最新のAIを支える「専門家の使い分け」の仕組みから、なぜ重要なのか、弱点まで見ていきましょう!
:::
こんにちは!ウマたんです!
新しいAIのモデルが発表されると、「総パラメータ数は〇〇億、そのうち動くのは〇〇億」といった説明を見かけることが増えましたよね。
全部で〇〇億あるのに、動くのはその一部だけ?と不思議に思った人もいるかもしれません。
実はこれ、「**MoE(Mixture of Experts)**」という仕組みを使ったモデルの特徴なんです。
公開されている情報を見ると、今の最先端のAIモデルの多くが、裏側でこのMoEを使っています。
:::talk{who="man" side="left"}
効率よくAIを動かせる技術があるらしい、とは聞いたことあるけど……
:::
:::talk{who="woman"}
そもそもMoEって何なのか、なんでそんなに大事なのか知りたい!
:::
本記事では、次の4つを順番に解説していきます。
:::point
**・MoEとは?**\
**・MoEの仕組み**\
**・MoEが重要な理由と、MoEを使った主なモデル**\
**・MoEの弱点とこれから**
:::
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!
::youtube{#a-ksOu8Mq20}
## MoEとは?
まずは結論からいきましょう!
**MoEとは、AIの中に複数の「専門家(エキスパート)」を用意しておき、入力に応じて使う専門家を切り替える仕組み**です。
MoEは「**Mixture of Experts**」の略で、直訳すると「専門家の混合」。「エムオーイー」と読むことが多いです。
なんでも1人でこなすジェネラリストではなく、それぞれ得意分野を持つ専門家のチームを、うまく使い分けるイメージです。
### 総合病院のたとえで考えてみよう
身近な例で考えてみましょう。
大きな総合病院をイメージしてください。
患者さんが来たとき、骨が折れていたら整形外科、心臓が悪ければ循環器内科、目が見えにくければ眼科、というように、症状によって担当のお医者さんが変わりますよね。
病院には何十人ものお医者さんがいますが、1人の患者さんを診るのは、その症状に合った数人だけです。全員が毎回集まって診察するわけではありません。
そして、症状を聞いて「この患者さんは整形外科へ」と振り分けているのが、受付の係です。
:::box{title="MoEを病院にたとえると"}
**・お医者さん(各科の専門医)**:専門家(エキスパート)\
**・受付の係**:どの専門家に回すかを決める「ルーター」\
**・患者さん**:AIに入力されたデータ
:::
これとまったく同じことを、AIの中でやっているのがMoEなんです!
### ジェネラリスト1人と、専門家チームの違い
ふつうのAIモデルは、どんな入力が来ても、モデルの中のすべてのパラメータを使って処理します。
いわば、たった1人のスーパージェネラリストが、どんな相談にも全力で対応しているような状態です。
一方MoEは、たくさんの専門家を抱えたチームです。入力ごとに、合いそうな専門家だけが呼ばれて働きます。
| | ふつうのモデル | MoEのモデル |
|---|---|---|
| たとえると | なんでも1人でこなすジェネラリスト | 得意分野を持つ専門家のチーム |
| 1回の処理で動くパラメータ | すべて | 選ばれた専門家の分だけ |
| 1回あたりの計算 | モデルが大きいほど増える | 全体が大きくても少なく抑えられる |
## MoEの仕組み
それでは、MoEの仕組みをもう少しくわしく見ていきましょう!
### 専門家と「ルーター」
MoEには、2つの役者がいます。
1つ目は、**専門家(エキスパート)**。それぞれが小さなニューラルネットワークになっていて、MoEのモデルの中には、これが何個から、多いものでは数百個も並んでいます。
2つ目は、**ルーター**。「ゲーティングネットワーク」とも呼ばれ、入力を見て、どの専門家に仕事を回すかを決める振り分け係です。
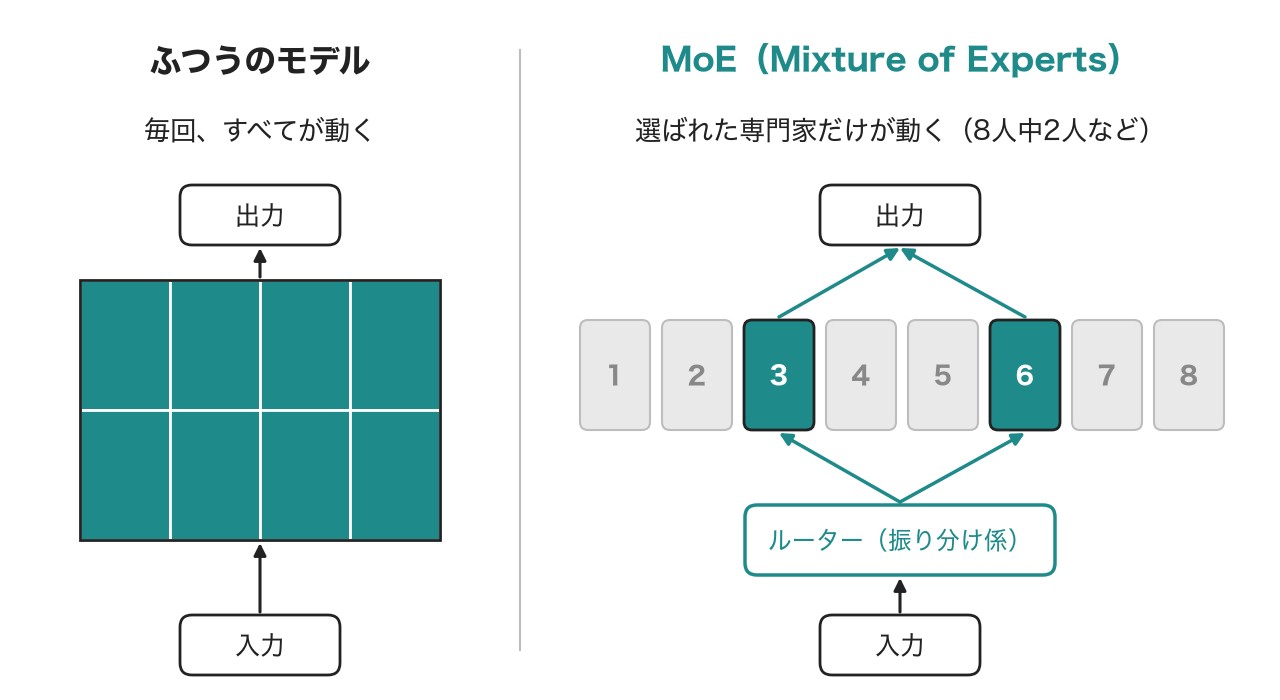
処理の流れは、次のようになります。
:::box{title="MoEの処理の流れ"}
**1. ルーターが入力を見て、それぞれの専門家に「どれくらい向いているか」の点数をつける**\
**2. 点数の高い専門家を、上から数人だけ選ぶ(たとえば8人中2人)**\
**3. 選ばれた専門家だけが計算をする**\
**4. 専門家たちの答えを、点数に応じた重みで混ぜ合わせて出力にする**
:::
選ばれなかった専門家は、その入力については何も計算しません。ここが計算を減らせるポイントなんです!
ちなみに、ルーター自身も学習で育てられます。どの入力をどの専門家に回すとうまくいくのかを、AIが自分で覚えていくわけです。
### 言葉(トークン)ごとに専門家を選んでいる
ChatGPTのような大規模言語モデル(LLM)の場合、専門家の選び方には少しコツがあります。
LLMは、文章を「トークン」と呼ばれる言葉の切れはしに分けて、1つずつ処理しています。
MoEのLLMでは、質問の文章全体ではなく、トークン1つ1つごとに専門家を選んでいます。同じ文章の中でも、言葉ごとに違う専門家が働いているんです。
さらに、LLMはたくさんの層が積み重なってできていて、MoEはそれぞれの層の中に入っています。層ごとにルーターがいて、層ごとに専門家を選び直しているイメージです。
今のLLMのもとになっている「Transformer」という仕組みについては、以下の記事で解説しています。
### 本物の専門家は「数学担当」「言語担当」とは限らない
ここで1つ、注意しておきたいことがあります。
説明では「この質問は言語の専門家に、この質問は計算の専門家に」と、分かりやすく人間の分野でたとえることが多いです。
でも実際のMoEでは、専門家の担当分野を人間が決めているわけではありません。どの専門家が何を担当するかは、学習の中で自然に決まっていきます。
:::memo
フランスのMistral AIが2024年に公開した論文では、同社のMoEモデル「Mixtral」で、数学の論文、生物学の論文、哲学の文章といった分野ごとに、どの専門家が選ばれているかを調べています。その結果、分野によって選ばれる専門家がはっきり分かれる、という傾向は見られなかったと報告されています。人間から見た「〇〇分野の専門家」とは、だいぶ違う分け方をしているようです。
:::
「専門家」という名前は、あくまで仕組みを分かりやすくするための呼び名だと思っておくとよいですね。
## MoEが重要な理由
続いて、なぜMoEが最新のAIにとってこんなに重要なのかを見ていきましょう!
### 全体は大きく、動かすのは一部だけ
MoEのいちばんのメリットは、**計算の効率がいいこと**です。
AIは一般に、パラメータの数を増やすほど、たくさんの知識を覚えられて賢くなりやすいことが知られています。
でも、ふつうのモデルでパラメータを増やすと、1回の処理で必要な計算もそのまま増えてしまいます。
MoEなら、全体のパラメータは大きくしながら、1回の処理で実際に動くのは、選ばれた専門家の分だけ。
知識の量(全体の大きさ)と、答えるときの計算(動く部分の大きさ)を、切り分けられるんです!
### スケールアップの壁を越えるカギ
AIのモデルは、どんどん大きくなっています。
でも、大きくなればなるほど、次のような問題が出てきます。
:::warn
**・学習にかかる計算とお金が、ばく大になる**\
**・答えるとき(推論のとき)の処理が遅くなる**\
**・電力をたくさん使う**
:::
MoEは、このスケールアップの壁を乗り越えるためのカギとして使われているんです。
### MoEを使った主なモデル
実際に、MoEを使っていることが公表されているモデルの例を見てみましょう。
| モデル | 発表 | 全体のパラメータ | 1つのトークンで動くパラメータ |
|---|---|---|---|
| Mixtral 8x7B(Mistral AI) | 2023年12月 | 約467億 | 約129億 |
| DeepSeek-V3(DeepSeek) | 2024年12月 | 約6,710億 | 約370億 |
| Llama 4 Maverick(Meta) | 2025年4月 | 約4,000億 | 約170億 |
| gpt-oss-120b(OpenAI) | 2025年8月 | 約1,170億 | 約51億 |
| DeepSeek-V4-Pro(DeepSeek) | 2026年4月 | 約1.6兆 | 約490億 |
| Gemma 4 26B A4B(Google) | 2026年 | 約252億 | 約38億 |
たとえばDeepSeek-V3は、全体で約6,710億個のパラメータを持っていますが、1つのトークンを処理するときに動くのは約370億個だけ。全体の5〜6%ほどです。
モデル名に「A4B」のような書き方があるときは、「動く(Active)パラメータが約40億(4B)」という意味で使われていることが多いです。
このほかにも、Googleは2024年に発表したGemini 1.5でMoEを使っていることを公表しています。一方で、中身の作りを公表していないモデルも多いので、「最先端のモデルがすべてMoE」とまでは言えない点には気をつけましょう。
:::ref
表の数字は、各社の発表や公開されているモデルの説明をもとにした2026年10月時点のものです。新しいモデルは次々に出ているので、最新の情報は各社の発表を確かめてみてください。
:::
中国のDeepSeekが、MoEなどの工夫でどうやって安く高性能なAIを作ったのかは、以下の記事でくわしく解説しています。
### MoEの歴史をざっくり
MoEは、実は最近生まれたアイデアではありません。
| 年 | できごと |
|---|---|
| 1991年 | ジェイコブス氏、ジョーダン氏、ヒントン氏らが、複数の専門家のネットワークを使い分ける考え方を論文で発表 |
| 2017年 | Googleの研究者らが、ニューラルネットワークの中に大量の専門家を入れ、一部だけを動かす方法を発表 |
| 2021年 | Googleが、1つのトークンにつき1人の専門家だけを選ぶ「Switch Transformer」を発表 |
| 2023年 | Mistral AIが、重みを公開したMoEのLLM「Mixtral」を公開 |
| 2024年〜 | DeepSeekをはじめ、大きな公開モデルの多くがMoEを採用 |
30年以上前からある考え方が、大規模言語モデルの時代になって、一気に主役になったわけです!
## MoEの弱点と注意点
いいことずくめに見えるMoEですが、弱点もあります。
### メモリはたっぷり必要
1回に動くのは一部の専門家だけでも、どの専門家が呼ばれるかは入力しだいなので、すべての専門家をメモリに置いておく必要があります。
つまり、計算は少なくて済んでも、動かすためのメモリ(GPUのメモリなど)は、全体のパラメータの分だけ必要になるんです。
:::box{title="2つの数字の意味"}
**・全体のパラメータ数**:モデルを置いておくのに必要なメモリの大きさを左右する\
**・動くパラメータ数**:1回の処理にかかる計算と速さを左右する
:::
MoEのモデルを手元のパソコンで動かそうとするときは、「動くパラメータ」だけでなく「全体のパラメータ」も見ておくことが大切です。
### 専門家の仕事が偏りやすい
学習の途中で、ルーターが特定の専門家ばかりを選ぶようになってしまうことがあります。
人気の専門家には仕事が集中し、ほかの専門家はほとんど育たない……となると、せっかくの専門家チームがもったいないですよね。
そこで、専門家に仕事がなるべく均等に回るように調整する工夫(ロードバランシング)が、MoEの学習には欠かせません。
### 作るのも動かすのも扱いが難しい
専門家の数が多いMoEは、たくさんのGPUに専門家を分けて置くことがよくあります。
すると、トークンを担当の専門家がいるGPUへ送ったり、結果を集めたりする通信が必要になります。
このように、ふつうのモデルに比べて学習や運用の仕組みが複雑になりやすいのも、MoEの難しいところです。
## MoEとほかの技術との関係
最後に、似た考え方の技術との関係も整理しておきましょう。
### アンサンブル学習との違い
機械学習には、複数のモデルの答えを組み合わせる「**アンサンブル学習**」という方法もあります。
アンサンブル学習は、基本的に全員に答えを出してもらって、それを合わせる方法です。
一方MoEは、入力ごとに選ばれた専門家だけが答えるのがポイントです。
| | アンサンブル学習 | MoE |
|---|---|---|
| 動くモデル | 基本的に全員 | 選ばれた専門家だけ |
| ねらい | 答えを安定させて精度を上げる | 大きさと計算の効率を両立する |
アンサンブル学習については、以下の記事で解説しています。
### AIエージェントにも広がる「専門家の組み合わせ」
「得意なものを組み合わせて、必要なときに必要なものだけを使う」という発想は、MoEの外にも広がっています。
たとえば、調べもの担当のAI、プログラミング担当のAI、文章をまとめる担当のAIを組み合わせて、仕事に応じて振り分けるAIエージェントの仕組みも登場しています。
1つのモデルの中で専門家を使い分けるMoEと、AI同士を組み合わせるエージェントは仕組みとしては別物ですが、根っこにある考え方はよく似ています。
データサイエンティストやAIエンジニアとして働くうえでも、MoEの考え方を押さえておくと、新しいモデルやサービスの説明がぐっと読みやすくなりますよ!
## MoEのまとめ
最後に、今回のポイントをおさらいしましょう!
:::point
**・MoEは、AIの中に複数の専門家を用意し、入力に応じて必要な専門家だけを選んで使う仕組み**\
**・どの専門家に回すかは、ルーター(ゲーティングネットワーク)が決める**\
**・全体は大きく、1回に動くのは一部だけなので、賢さと計算の効率を両立できる**\
**・DeepSeek、Llama 4、gpt-ossなど、MoEを採用したモデルが増えている**\
**・すべての専門家をメモリに置く必要があり、仕事の偏りなど扱いの難しさもある**
:::
:::talk{who="umatan"}
要は、AIの中に「専門医がたくさんいる総合病院」を作って、受付が上手に振り分けているのがMoEなんです!モデルの説明で「全体〇〇億、動くのは〇〇億」と書かれていたら、MoEを思い出してみてください!
:::
最新のAIの仕組みや生成AIを体系的に学びたいのであれば、当メディアが運営するスクール「**[スタアカ](https://toukei-lab.com/achademy/)**」がオススメです!
:::box
**[業界最安級のAIデータサイエンス特化スクール「スタアカ」](https://toukei-lab.com/achademy/)**
:::