# マルチモーダルAIとは?文字・画像・音声をまとめて理解する仕組みを分かりやすく解説!
> マルチモーダルAIとは、テキスト・画像・音声・動画など複数の種類の情報をまとめて扱えるAIのことです。本記事では、意味や仕組み(ベクトル・ネイティブマルチモーダル)、できること・ビジネスでの活用例、使うときの注意点を図解で分かりやすく解説します!
- URL: https://toukei-lab.com/multimodal-ai
- 公開: 2026.10.28
- サイト: スタビジ(https://toukei-lab.com)
:::talk{who="umatan"}
当サイト【スタビジ】の本記事では、「マルチモーダルAI」について分かりやすく解説していきます!文字・画像・音声をまとめて理解するAIの仕組みから、できること、注意点まで見ていきましょう!
:::
こんにちは!ウマたんです!
スマホで冷蔵庫の中を撮って「これで何が作れる?」と聞くと、AIがレシピを考えてくれる。
そんな使い方が、もう当たり前になってきましたよね。
この裏側にあるのが「**マルチモーダルAI**」です。
:::talk{who="man" side="left"}
マルチモーダルってよく聞くけど、普通のAIと何が違うの?
:::
:::talk{who="woman"}
写真や声をどうやってAIが理解しているのか知りたい!
:::
本記事では、次の4つを順番に解説していきます。
:::point
**・マルチモーダルAIとは?**\
**・マルチモーダルAIの仕組み**\
**・マルチモーダルAIでできること・活用例**\
**・マルチモーダルAIの注意点**
:::
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!
::youtube{#URUHlMDXzqU}
## マルチモーダルAIとは?
**マルチモーダルAIとは、テキスト・画像・音声・動画など、複数の種類の情報をまとめて扱えるAIのこと**です。
冒頭の冷蔵庫の例では、AIは「冷蔵庫の写真(画像)」と「これで何が作れる?という質問(テキスト)」を同時に受け取って、答えを返しています。
### 「モーダル」は情報の種類のこと
「モーダル」は、情報の種類を表す「**モダリティ(modality)**」から来た言葉です。
テキスト、画像、音声、動画などが、それぞれひとつのモダリティにあたります。
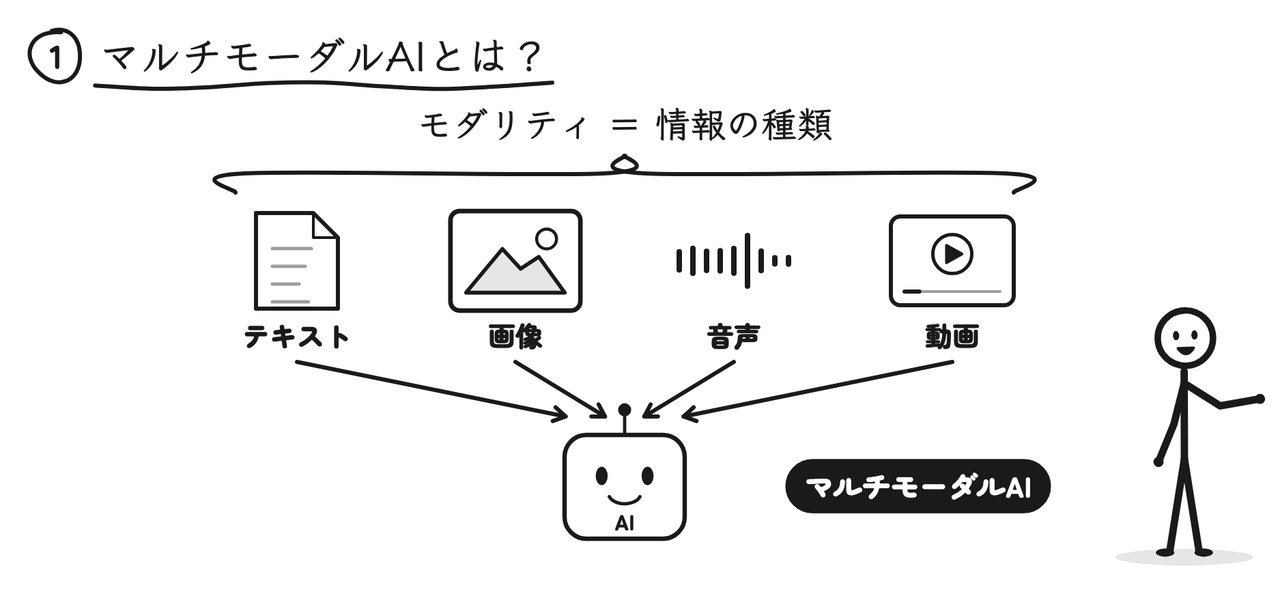
つまり「マルチ(複数の)」+「モーダル(情報の種類)」で、複数の種類の情報をまとめて扱えるAIというわけです!
ちなみに、文字だけ・画像だけのように、1種類の情報だけを扱うAIは「**シングルモーダルAI**」と呼ばれます。
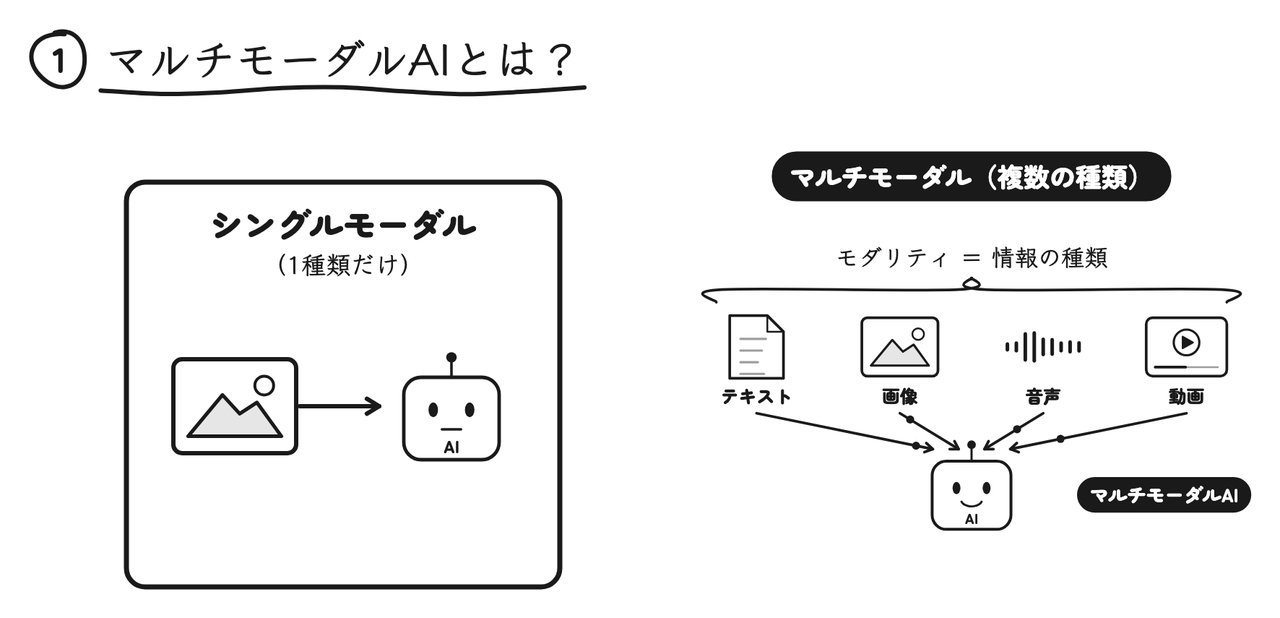
| | 扱う情報 | 例 |
|---|---|---|
| シングルモーダルAI | 1種類だけ | 文章だけを読む翻訳AI、画像だけを見る画像分類AI |
| マルチモーダルAI | 複数の種類をまとめて | 写真を見ながら質問に答えるAI、声で会話できるAI |
### 人間はもともとマルチモーダル
実は、僕たち人間は、もともとマルチモーダルなんです。
人と話すとき、僕たちは言葉だけでなく、声のトーンや表情からも気持ちを読み取っていますよね。
同じ「大丈夫!」でも、笑顔で言うのと、うつむいて言うのとでは、意味がまったく違います。
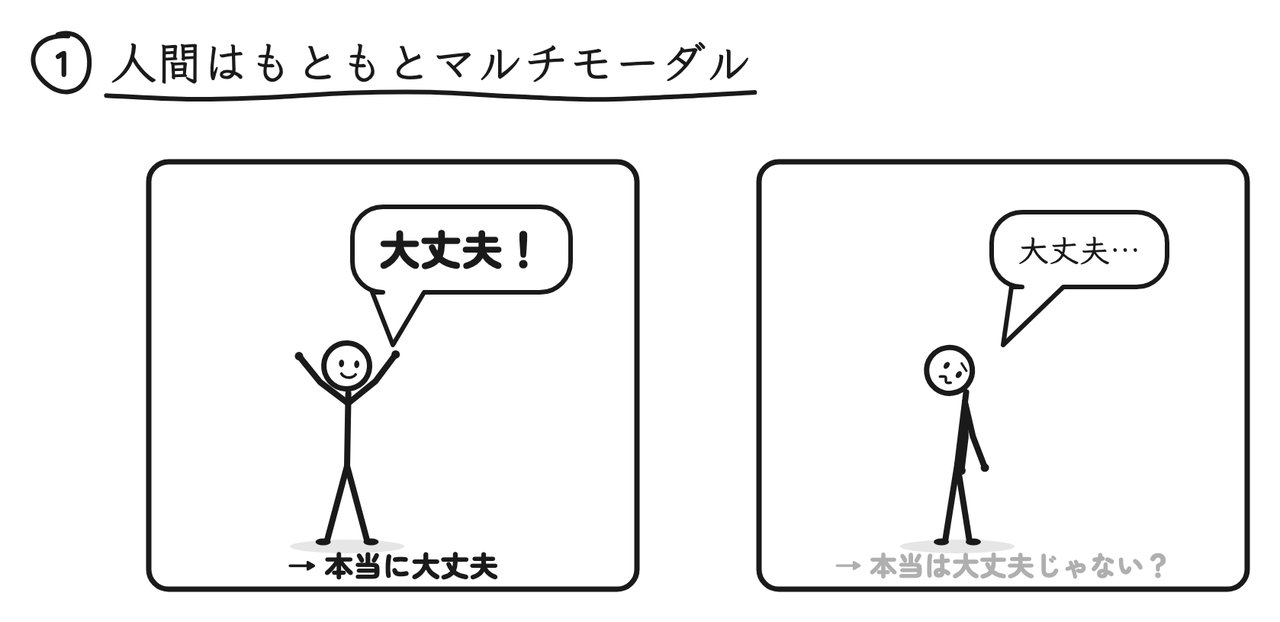
目と耳と言葉を組み合わせるからこそ、本当の意味が分かる。
マルチモーダルAIは、この人間の当たり前をAIで実現しようとしている技術なんです!
## マルチモーダルAIの仕組み
では、AIはどうやって種類のちがう情報をまとめて扱っているのでしょうか?
### どんな情報も「数字の並び(ベクトル)」に変える
ポイントは、**どんな情報も、数字の並び、つまり「ベクトル」に変えてしまうこと**です。
テキストは文章用の、画像は画像用の、音声は音声用の変換器(エンコーダー)を通して、ベクトルにします。
このとき、猫の写真と「猫」という言葉が、近いベクトルになるように学習させておくのがミソ。
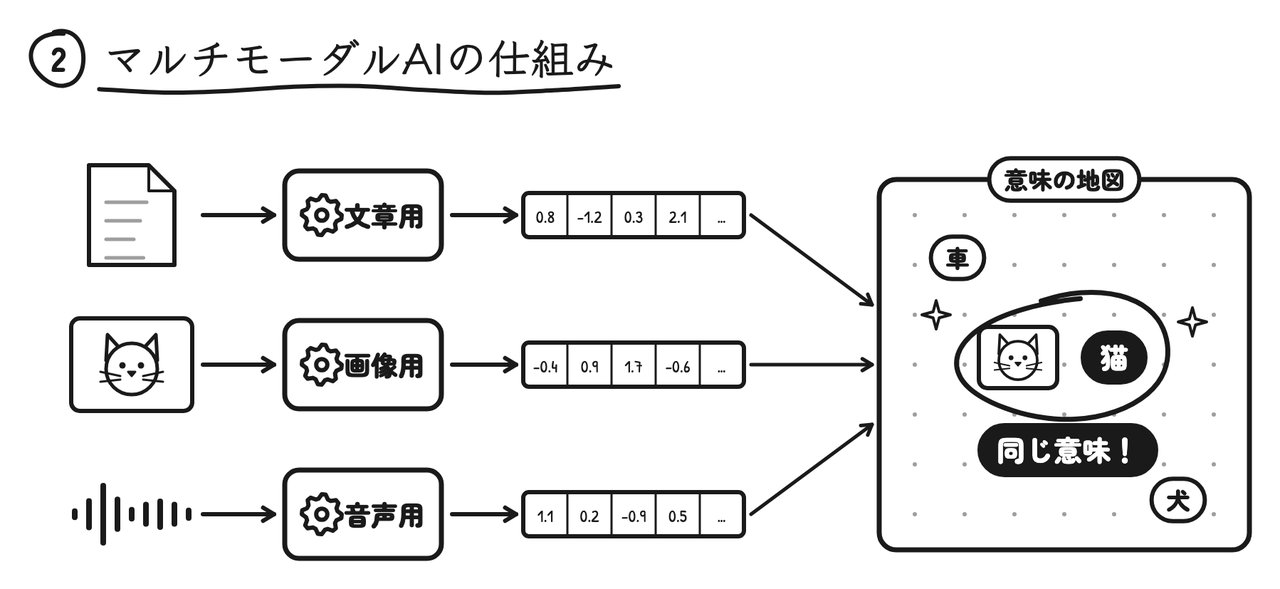
こうすることで、写真と言葉がAIの中で同じ意味として結びつきます。
写真を見せて「これは何?」と聞かれても、写真のベクトルの近くにある言葉を手がかりに答えられるわけです。
画像と言葉をこのように結びつける代表的なモデルが、2021年にOpenAIが発表した「**CLIP**」です。大量の「画像とその説明文」の組み合わせから、画像と言葉を同じベクトルの空間に並べる方法を学んでいます。
文章をベクトルにする考え方は、以下の記事でも詳しく解説しています。
### 「つなぎ合わせ」から「最初から一緒」へ
少し前までは、種類ごとに別々のAIをつなぎ合わせる方法が主流でした。
たとえば声で話すAIなら、「文字起こし」「考える」「読み上げ」の3つのAIを、順番につないでいたんです。
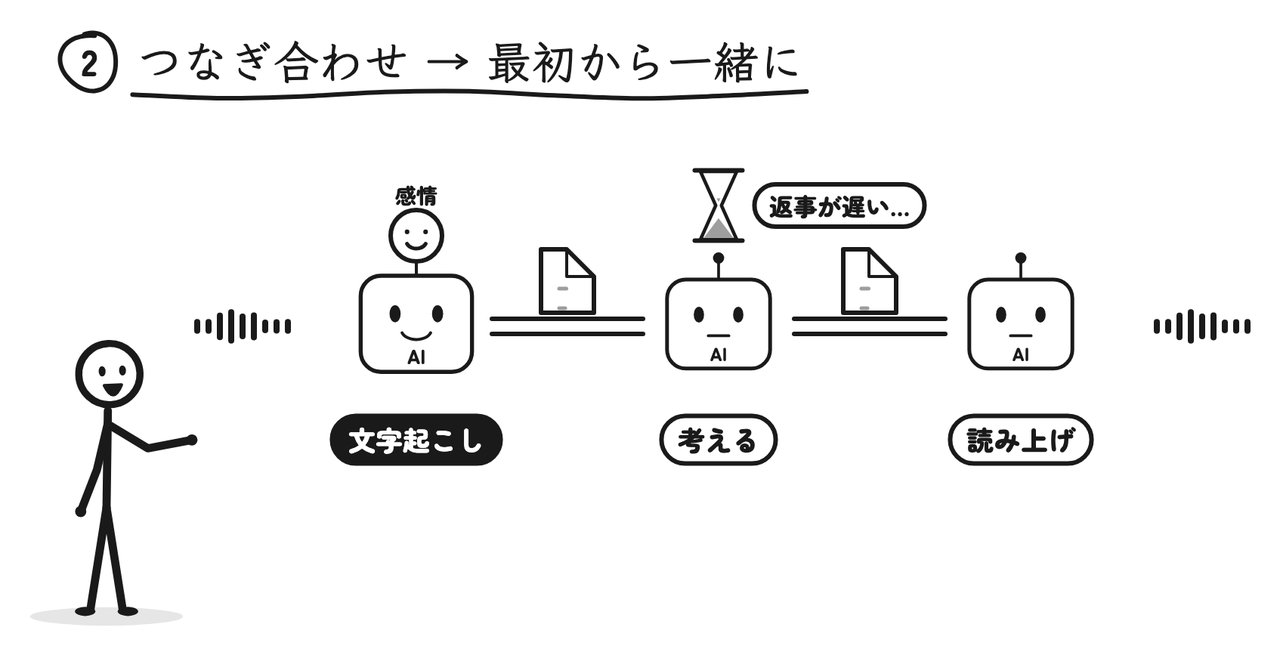
でもこれだと、次のような弱点があります。
:::warn
**・3つのAIを順番に通すので、返事が遅くなる**\
**・声のトーンや感情が、文字にした時点で抜け落ちてしまう**
:::
そこで登場したのが、最初からいろんな種類の情報をまとめて学んだ「**ネイティブ・マルチモーダル**」なAIです。
2023年にはGoogleの「**Gemini**」、2024年にはOpenAIの「**GPT-4o**」が登場しました。
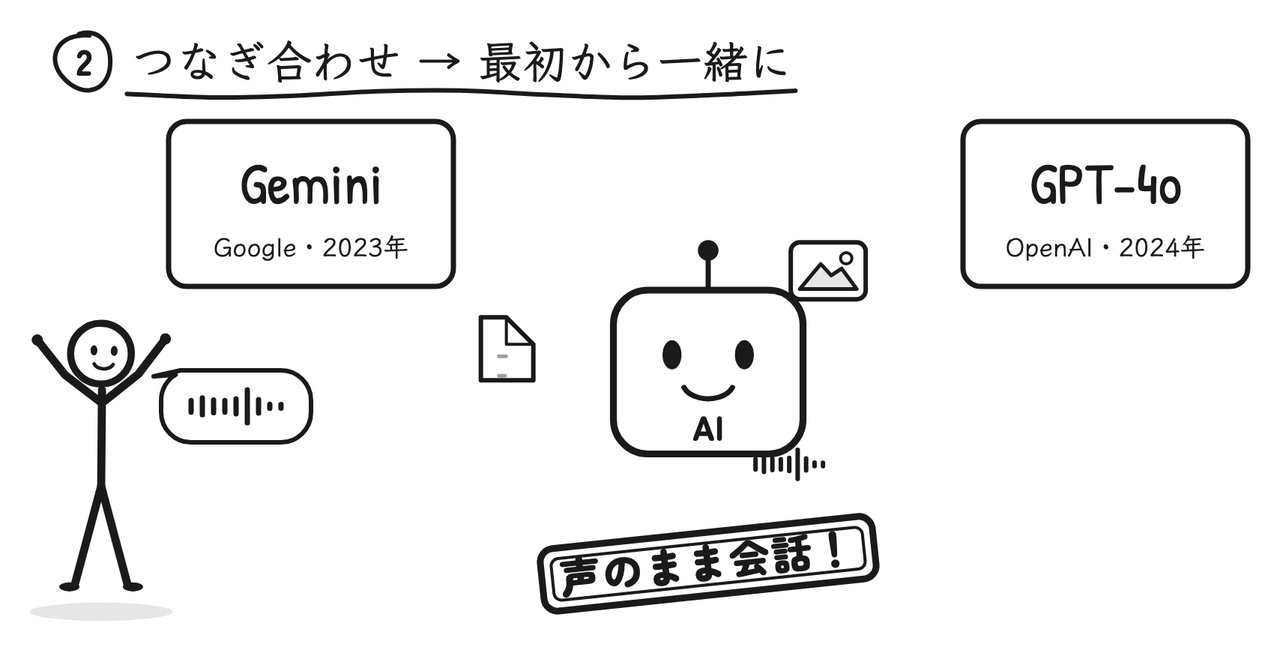
ネイティブ・マルチモーダルなAIは、声を文字に置き換えずにそのまま扱えます。
そのおかげで、声のまま、人と話すような速さで会話できるようになったんです!
ChatGPTのもとになっている大規模言語モデル(LLM)の仕組みについては、以下の記事を参考にしてみてください。
## マルチモーダルAIでできること・活用例
続いて、マルチモーダルAIで実際に何ができるのかを見ていきましょう!
### 身近なところでできること
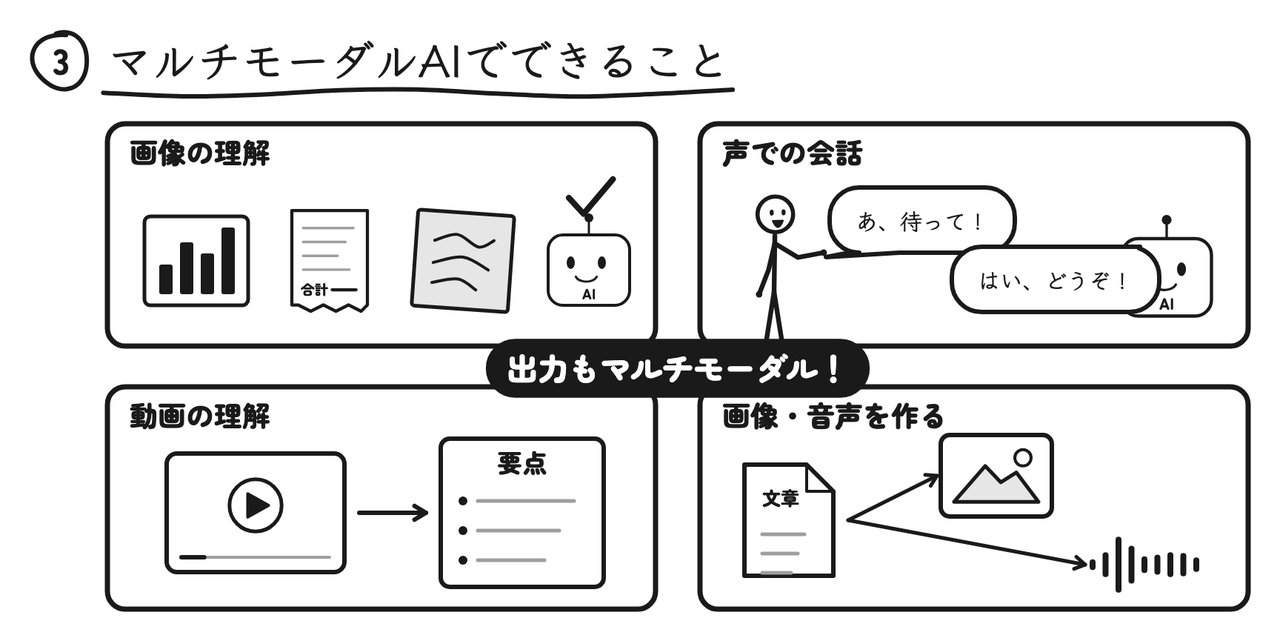
:::box{title="マルチモーダルAIでできること"}
**・画像の理解**:グラフやレシート、手書きのメモを撮るだけで、内容を読み取ってくれる\
**・声での会話**:話しかけるだけで声で返事をくれて、途中で割り込んでも会話が続く\
**・動画の理解**:会議の録画を渡せば、要点をまとめてくれる\
**・画像や声を作る**:文章から画像を作ったり、声で読み上げたりできる
:::
最後の「作る側」もポイントです。
入力だけでなく、出力もテキスト以外にどんどん広がっているんです!
画像を作るAIの仕組みについては、以下の記事で解説しています。
### ビジネスでの活用例
ビジネスの現場でも、活用はどんどん広がっています。
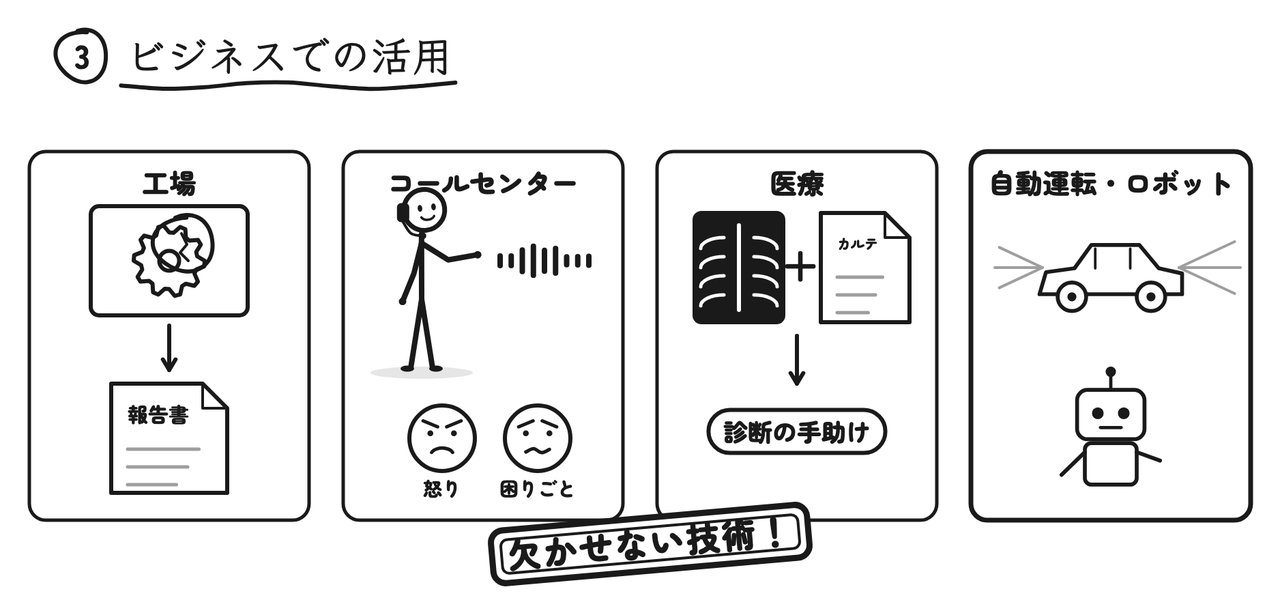
| 現場 | マルチモーダルAIの使い方 |
|---|---|
| 工場 | 製品の写真から傷を見つけて、報告書の文章までまとめて作る |
| コールセンター | お客さんの声の調子から、怒っているのか、困っているのかを読み取る |
| 医療 | レントゲンの画像とカルテを合わせて、診断を手助けする(研究が進んでいる段階) |
| 自動運転・ロボット | カメラやセンサーで周りを見て、状況を判断する |
特に自動運転やロボットは、カメラの映像・センサーの数値・人からの指示など、いろんな種類の情報を組み合わせて判断する必要があります。
マルチモーダルAIは、こうした分野に欠かせない技術なんです!
## マルチモーダルAIの注意点
マルチモーダルAIも、完璧ではありません。
使うときに気をつけたいポイントを3つ紹介します。
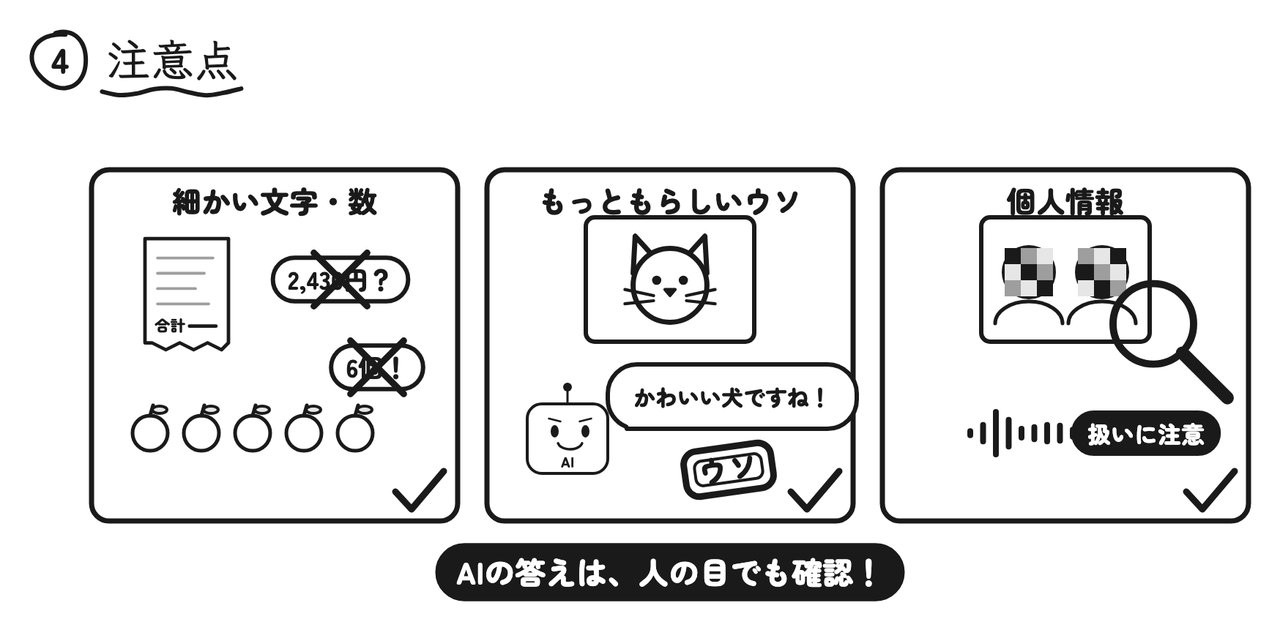
### 細かい文字や数は意外と間違える
画像の中の細かい文字を読んだり、物の数を数えたりするのは、意外と間違えることがあります。
レシートの金額や、写真に写っているものの個数などは、AIの答えをそのまま使わずに確かめましょう。
### 画像についても「もっともらしいウソ」をつく
文章と同じように、画像についても、もっともらしいウソをつくことがあります。
猫の写真を見せたのに「かわいい犬ですね!」と自信満々に答える、といった具合です。
このような現象は「ハルシネーション」と呼ばれます。原因と対策は以下の記事で解説しています。
### 写真や録音の個人情報に気をつける
写真や録音には、人の顔や声、個人情報がうっかり入りがちです。
AIに渡す前に、写っている人や、読み取れる情報がないかを確かめるようにしましょう。
:::warn
大事な場面では、AIの答えをうのみにせず、人の目でも確かめることが大切です!
:::
## マルチモーダルAIのまとめ
最後に、今回のポイントをおさらいしましょう!
:::point
**・マルチモーダルAIは、テキスト・画像・音声・動画など、複数の種類の情報をまとめて扱えるAI**\
**・仕組みのカギは、種類のちがう情報を、同じベクトルの世界で結びつけること**\
**・最近は、最初から複数の種類をまとめて学んだ「ネイティブ・マルチモーダル」なAIが主流**\
**・細かい文字や数の読み取り、もっともらしいウソ、個人情報には注意**
:::
:::talk{who="umatan"}
要は、AIが「目」と「耳」を手に入れて、人間にぐっと近づいた、ということなんです!ぜひ手元のスマホで写真を撮って、AIに話しかけてみてください!
:::
生成AIやデータサイエンスを体系的に学びたいのであれば、当メディアが運営するスクール「**[スタアカ](https://toukei-lab.com/achademy/)**」がオススメです!
:::box
**[業界最安級のAIデータサイエンス特化スクール「スタアカ」](https://toukei-lab.com/achademy/)**
:::