# ナイーブベイズ(単純ベイズ)とは?概要とRでの実装!
> 当サイト【スタビジ】の本記事では、ベイズ推定を用いた機械学習手法であるナイーブベイズについてまとめていきます!ナイーブベイズの仕組みや応用場面を見ていったあと、ナイーブベイズと他の機械学習手法をRで実装して精度を比較していきますよー!
- URL: https://toukei-lab.com/naivebaise
- 公開: 2022.11.29 / 更新: 2024.11.21
- サイト: スタビジ(https://toukei-lab.com)
:::talk{who="umatan"}
当サイト【スタビジ】の本記事では、ベイズ推定を用いた機械学習手法であるナイーブベイズについてまとめていきます!ナイーブベイズの仕組みや応用場面を見ていったあと、ナイーブベイズと他の機械学習手法をRで実装して精度を比較していきますよー!
:::
こんにちは!
データサイエンティストのウマたん([@statistics1012](https://twitter.com/statistics1012?lang=ja))です!
この記事では、機械学習手法の中でも比較的単純なアルゴリズムで高い効果が見込める「**ナイーブベイズ**」について見ていきましょう!
ナイーブベイズは[ベイズ統計学](/bayes)の概念を用いており、様々な分野へ応用されています。
ベイズ統計学を研究している人を巷ではベイジアンと呼ぶのですが、僕自身大学院時代はベイジアンでした。
:::talk{who="umatan"}
ナイーブベイズは非常に簡単に実装可能で使いやすい機械学習手法!
:::
## ナイーブベイズとは?
ナイーブベイズはベイズの定理に基づいた機械学習手法です。
**ベイズの定理**はベイズ統計学の基本中の基本。大事な式なので覚えておきましょう。
$$
p(A|B)=\frac{p(B|A)p(A)}{p(B)}
$$
これは以下の条件付き確率と同時確率の関係から導出できます。
$$
p(A,B)=p(B|A)p(A)=p(A|B)p(B)
$$
この関係式を変形するとベイズの定理が導出されることが分かるでしょう。
ベイズの定理では基本的に確率を元に考えていました。
しかし、ベイズの枠組みはそれだけではおさまりません。
ベイズ推定ではベイズの定理における確率を確率分布へと拡張させ考えていきます。
ベイズ推定に関しては事前分布と事後分布、そして尤度という考え方が非常に重要です。
事前分布は前から持っている情報。
尤度は手に入れた情報。
事後分布は前情報と手に入れた情報を合わせた情報というイメージを持っていれば良いでしょう。
$$
p(A|B){\propto}p(B|A)p(A)=事後分布{\propto}尤度×事前分布
$$
ベイズ推定を用いた判別手法が「ナイーブベイズ」です。
実はベイズ推定の理論自体は古くからあったのですが、伝統的な統計学との対立とマシーンパワーの問題で現代まで流行りませんでした。
ベイズ統計学に関しては以下の記事をご覧ください!
:::talk{who="umatan"}
伝統的な統計学とベイズ統計学、どちらも基本を抑えておこう!
:::
## ナイーブベイズが応用される場面
ナイーブベイズが用いられる場面として最も有名なのはスパムメールの判別ですね。
スパムメールの判別では、文章に含まれる単語に対して迷惑メールである確率を算出しベイズ推定を使って迷惑メールであるか否かを推定します。
$$
p(迷惑メール|ダウンロード)=\frac{p(ダウンロード|迷惑メール)p(迷惑メール)}{p(ダウンロード)}
$$
ダウンロードというワードが入っていた場合に迷惑メールであるか判別するためには、「**迷惑メールの中にダウンロードが入っている確率**」と「**迷惑メールの確率**」と「**メールにダウンロードが入っている確率**」が分かれば算出することが可能です。
これらを手元の教師データから判別していくのがナイーブベイズによるスパムメールの判別アルゴリズムになります。
なんとなくイメージが湧きましたでしょうか?
## ナイーブベイズをRで実装してみる
それではナイーブベイズを実際にRで実装してみます。
実装と言ってもパッケージを使ってしまうので非常に簡易的な実装になります。
**有名なタイタニックのデータ**を用います。[Kaggleの公式サイト](https://www.kaggle.com/c/titanic/data)からデータをダウンロードできます。
まず、データのクレンジングを行い、欠損値は削除、不要と考えられる項目は削除しました。
項目8つ
:::box
**Survived:生死 pclass:客室のクラス sex:性別 age:年齢 sibsp:兄弟・配偶者の数 parch:親・子供の数 fare:乗船料金 embarked:乗船した港**
:::
サンプル数714
この時、生死を目的変数としそれ以外を説明変数とします。
サンプル数714のうちランダムに400個のデータを取り出し学習データとし、残りの314を予測データとします。
学習データで予測モデルを作り、予測データにあてはめ真値と予測値の判別率を精度として比較します。
シミュレーション回数は10回とし、上記の手順を10回繰り返し、結果を平均したものを最終アウトプットとします。シミュレーション回数をもっと増やせば精度の信頼性は上がります。
Bayes(ナイーブベイズ)を[SVM(サポートベクターマシン)](/svm)、[RF(ランダムフォレスト)](/%e3%83%a9%e3%83%b3%e3%83%80%e3%83%a0%e3%83%95%e3%82%a9%e3%83%ac%e3%82%b9%e3%83%88)、[NN(ニューラルネットワーク)](/nn)、[xgb(XGboost)](/xgboost)、[knn(k近傍法)](/%ef%bd%8b%e8%bf%91%e5%82%8d%e6%b3%95)の5手法と比較します!
基本的に引数は全部デフォルトで!果たして結果はどうなるでしょうか!
```r title="knn-comparison.R"
##様々な手法で予測精度の比較を行う##
##randomForest,SVM,ナイーブベイズ,ニューラルネット
library(xgboost)
library(caret)
library(Matrix)
library(kernlab)
library(randomForest)
library(e1071)
library(nnet)
library(ggplot2)
library(class)
titanic<-read.csv("タイタニック乗船者リスト.csv")##データの読み込み
titanic<-na.omit(titanic)##欠損値削除
titanic$Survived<-as.factor(titanic$Survived)##質的変数に変換
sim<-10##シミュレーション回数
result<-matrix(0,sim,6)##結果の箱
titanic[,4]<-as.numeric(titanic[,4])
titanic[,9]<-as.numeric(titanic[,9])
for(i in 1:sim){
####学習データとテストデータに分ける####
train.id<-sample(nrow(titanic),400)
train.data<-titanic[train.id,-1]
test.data<-titanic[-train.id,-1]
##randomForest##
rf<-randomForest(Survived~.,train.data)
test.data.rf<-cbind(test.data,"predict"=predict(rf,test.data))
result[i,1]<-sum(test.data.rf$predict==test.data.rf$Survived)/nrow(test.data.rf)
##SVM##
svm<-ksvm(Survived~.,train.data)
test.data.svm<-cbind(test.data,"predict"=predict(svm,test.data))
result[i,2]<-sum(test.data.svm$predict==test.data.svm$Survived)/nrow(test.data.svm)
##ナイーブベイズ##
nb<-naiveBayes(Survived~.,train.data)
test.data.nb<-cbind(test.data,"predict"=predict(nb,test.data))
result[i,3]<-sum(test.data.nb$predict==test.data.nb$Survived)/nrow(test.data.nb)
##ニューラルネット##
nn<-nnet(Survived~.,train.data,size=5)
test.data.nn<-cbind(test.data,"predict"=round(predict(nn,test.data),0))
result[i,4]<-sum(test.data.nn$predict==test.data.nn$Survived)/nrow(test.data.nn)
##XGboost##
label.data.train<-as.integer(train.data$Survived)-1##目的変数を01に
label.data.predict<-as.integer(test.data$Survived)-1
train.data.xg<-train.data[,-1]##目的変数取り除く
test.data.xg<-test.data[,-1]
xgb.data<-xgb.DMatrix(data.matrix(train.data.xg),label=label.data.train)##Xgb型へ成型
xgb.data.predict<-xgb.DMatrix(data.matrix(test.data.xg))
param <- list(
"objective" = "binary:logistic"
,"eta" = 0.01
# ,"max_depth" = 10
,"min_child_weight" = 5
# ,"subsample" = 1
# ,"colsample_bytree" = 1
)##パラメータ適当
model <- xgboost(
param=param
,data=xgb.data
,nrounds=1000
)##実際の学習
predict_xgb<-predict(model,xgb.data.predict)
a<-c()
m<-length(predict_xgb)#行数
for(l in 1:m){
if(predict_xgb[l]>0.5){a[l]<-1}
else{a[l]<-0}
}
result[i,5]<-sum(a==label.data.predict)/length(a)
#k-nn
knn<-knn(train.data,test.data,train.data[,"Survived"] ,prob=T,k=3)
test.data.knn<-cbind(test.data,"predict"=knn)
result[i,6]<-sum(test.data.knn$predict==test.data.knn$Survived)/nrow(test.data.knn)
}
result.c<-apply(result,2,mean)##simの平均値
result.c<-t(as.matrix(result.c))
result.c<-rbind(result.c,result.c)
result.c<-round(result.c,3)
##グラフ描画
colnames(result.c) <- c("RF","SVM","Bayes","NN","xgb","knn")
df<-data.frame(method=colnames(result.c),result=colMeans(result.c))
gp<-ggplot(df,aes(x=method,y=result,fill=method))
gp<-gp+geom_bar(width=0.8,stat="identity")
gp<-gp+ylab("result")
gp<-gp+geom_text(label=colMeans(result.c),vjust=1)
plot(gp)
```
e1071というパッケージに入っているnaiveBayesという関数を用いて解析を行っていきます。
> \##ナイーブベイズ##\
> nb<-naiveBayes(Survived\~.,train.data)\
> test.data.nb<-cbind(test.data,”predict”=predict(nb,test.data))\
> result\[i,3]<-sum(test.data.nb\$predict==test.data.nb\$Survived)/nrow(test.data.nb)
データ加工は描画でいくつかコードを書いていますが、実際にナイーブベイズを行っているのはこの数行!
Survived\~.はSurvivedを目的変数としてそれ以外を説明変数にするよーということです。
結果は以下のようになりました!
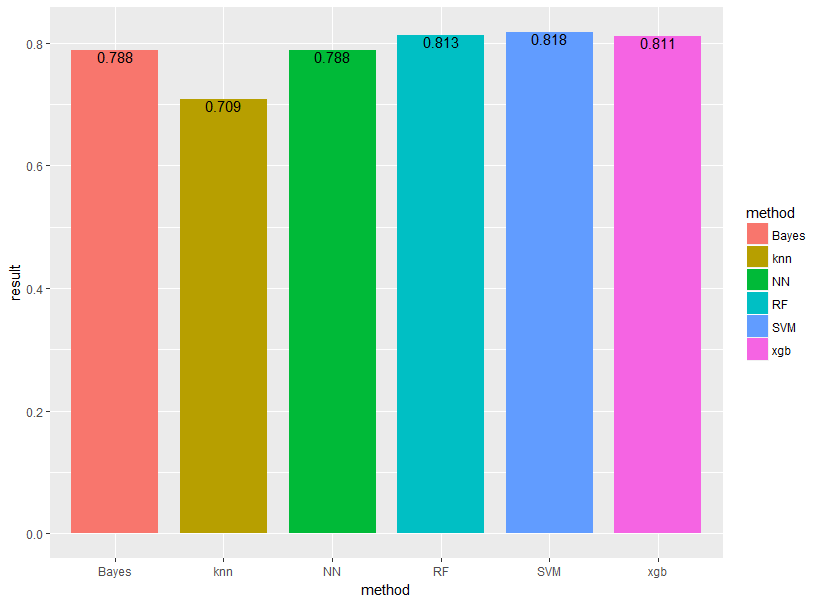
それぞれBayes(ナイーブベイズ)、knn(k近傍法)、NN(ニューラルネットワーク)、RF(ランダムフォレスト)、SVM(サポートベクターマシン)、xgb(XGboost)と表示しています。
やはり**ランダムフォレスト・SVM・XGboost**あたりが強いですね!
今回はパラメータをいじらずデフォルト設定で行ったためグリッドサーチなどでチューニングを行えば、もっと良い精度が出るでしょう。
他の手法についても是非見てみてください!
## ナイーブベイズ まとめ
**ナイーブベイズ**は、アルゴリズム自体が単純でRやPythonでも簡単に実装できる優秀な手法です。
ナイーブベイズのポイントについて最後に簡単にまとめておきましょう!
:::point
**・ベイズ統計学の理論を基にした手法である**\
**・スパムメール判別に良く用いられる**\
**・RやPythonでの実装が非常に簡単である**
:::
ベイズの識別規則について深く学びたい方は以下の書籍がオススメです!
::product[はじめてのパターン認識]{url="https://www.amazon.co.jp/dp/4627849710?tag=statistic08-22&linkCode=ogi&th=1&psc=1" image="https://m.media-amazon.com/images/I/51YFB3Y0EYL._SL160_.jpg" amazon="https://www.amazon.co.jp/dp/4627849710?tag=statistic08-22&linkCode=ogi&th=1&psc=1" rakuten="https://af.moshimo.com/af/c/click?a_id=858168&p_id=54&pc_id=54&pl_id=616&url=https%3A%2F%2Fsearch.rakuten.co.jp%2Fsearch%2Fmall%2F%25E3%2581%25AF%25E3%2581%2598%25E3%2582%2581%25E3%2581%25A6%25E3%2581%25AE%25E3%2583%2591%25E3%2582%25BF%25E3%2583%25BC%25E3%2583%25B3%2F%3Ff%3D1%26grp%3Dproduct"}
機械学習やデータサイエンスや統計学の勉強法は以下の記事でまとめているのでチェックしてみてください!
機械学習やデータサイエンスについてより深く学びたい方は、当メディアが運営している「スタアカ(スタビジアカデミー)」を是非チェックしてみてください!
:::box
**[業界最安級のAIデータサイエンス特化スクール:スタアカ(スタビジアカデミー)](https://toukei-lab.com/achademy/)**
:::
格安でデータサイエンスが一通り学べます!ご受講お待ちしております!