# ニューラルネットワークとは?仕組みとRでの実装!
> 当サイト【スタビジ】の本記事では、ディープラーニングの原型となるニューラルネットワークについてまとめていきます!ニューラルネットワークはディープラーニングを学ぶ上での基礎知識としておさえておいてほしい手法。Rでの実装も一緒におこなっていきますよー!
- URL: https://toukei-lab.com/nn
- 公開: 2022.11.29 / 更新: 2024.11.21
- サイト: スタビジ(https://toukei-lab.com)
:::talk{who="umatan"}
当サイト【スタビジ】の本記事では、ディープラーニングの原型となるニューラルネットワークについてまとめていきます!ニューラルネットワークはディープラーニングを学ぶ上での基礎知識としておさえておいてほしい手法。Rでの実装も一緒におこなっていきますよー!
:::
こんにちは!
データサイエンティストのウマたん([@statistics1012](https://twitter.com/statistics1012?lang=ja))です!
最近巷で話題の[ディープラーニング](/deep-learning)。
そんなディープラーニングの基となっている手法は50年以上前から存在していたのをご存知でしょうか?
それが「**ニューラルネットワーク**」。
簡単に言ってしまうと、ニューラルネットワークを複雑にしたのがディープラーニングであり、ディープラーニングは実際のところ、さして新しい手法ではないのです。
今回は、そんなニューラルネットワークについて理解を深めていきましょう!
:::talk{who="umatan"}
ニューラルネットワークを知っておくことで、昨今のディープラーニングの理解も深まるよ!
:::
ちなみにディープラーニングについては、以下の記事でまとめています!
ディープラーニング系、その他のAI用語を一挙にまとめた以下の記事も合わせて要チェックです!
:::box{title="読み飛ばしガイド"}
・[ニューラルネットワークとは](/nn#i)\
・[ニューラルネットワークの種類](/nn#i-2)\
・[ニューラルネットワークをRで実装してみよう!](/nn#R)
:::
## ニューラルネットワークとは
ニューラルネットワークとは、人間の脳の仕組みを模倣して作られたアルゴリズムです。
以下の図を見てください
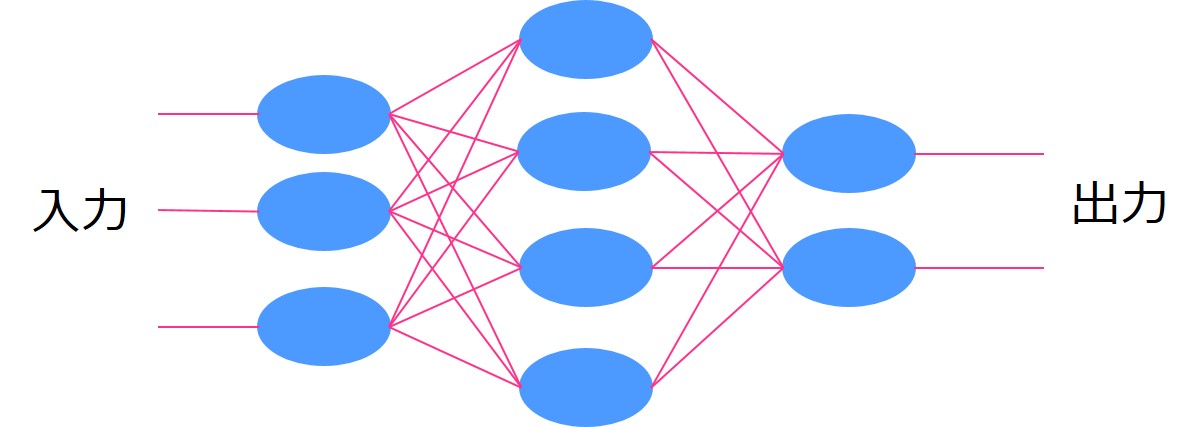
このようにいくつかの層に分かれていて情報が伝播していくイメージ。
一番左を**入力層**、一番右を**出力層**と言います。
入力層と出力層の間にある層のことを**隠れ層**とか**中間層**とか言います。
層の中の青い〇を**ニューロン**と言います。
ニューロンからニューロンに情報が渡る時、ある重みがかけられて、その重みによって出力の値が変わってくるんです。
そして、最終的な出力と教師データの誤差をなるべく小さくするように重みをチューニングしていくことでモデルの精度を高めていくのです。
ニューラルネットワークは入力層・隠れ層1つ・出力層の3層からなっていました。
一方、ディープラーニングは隠れ層が2つ以上のモデルを指します。
層を増やすと、その分組み合わせが爆発的に増加し計算負荷が大きくなります。
そのため従来のマシーンパワーでは計算できませんでした。
しかし昨今マシーンパワーが上がったことにより隠れ層を増やしても計算が行えるようになったんです。
そのような背景があり、台頭してきたのが「**ディープラーニング**」。
そのため基本的なアルゴリズムの考え方は50年以上前からあるんです。
このニューラルネットワークの仕組みはまさに人間の神経が信号を送り合い情報を伝達する姿に似ていますよね!
:::talk{who="robotan"}
じゃあ違いって隠れ層の数だけってこと?
:::
:::talk{who="umatan"}
そういうこと!層が1つ増えるだけで精度が大きく向上するんだ!
:::
## ニューラルネットワークの種類
続いて、そんな**ニューラルネットワークの種類**について簡単に見ていきましょう!
### ディープラーニング(ディープニューラルネットワーク)
最も有名なディープラーニング。
ディープラーニングの定義は、隠れ層が複数あるモデルですが、これ以降に紹介するモデルも場合によってはディープラーニングと紹介されていたりするので注意が必要です。
### CNN(畳み込みニューラルネットワーク)
畳み込みニューラルネットワークは、[画像認識](/python-image)などの分野でよく使われています。
基本的にニューラルネットワークは隣接する層の全てのニューロンは結合しています。
しかし畳み込みニューラルネットワークは一部のニューロンしか結合していません。
画像認識では、画像をピクセル単位に分解し隣接するピクセルを見ることで判別するので畳み込みニューラルネットワークが向いています。
以下の記事でCNNについて詳しく解説していますのでチェックしてみてください!
### RNN(再帰型ニューラルネットワーク)
再帰型ニューラルネットワークは、時系列要素が組み込まれたニューラルネットワークになります。
前後の関係をかんがみることができるので[自然言語処理](/natural-language-python)にも向いています。
自然言語処理の発展に非常に寄与しておりGoogle翻訳などにも用いられています。
RNNをさらに進化させたLSTMも注目を集めています。
RNNについては以下の記事でPythonでの実装も合わせてまとめています!
LSTMについては以下の記事でPythonでの実装も合わせてまとめています!
### GAN(敵対的生成ネットワーク)
最近注目を集めているモデル。
偽物を生成する生成器と偽物と見破る識別器をお互い争わせ、識別器が見破りにくい偽物を作ることが出来たらそれがもはや本物であるという考え方です。
GANによって実際に存在しないホテルの部屋の画像を生成したのが以下になります。
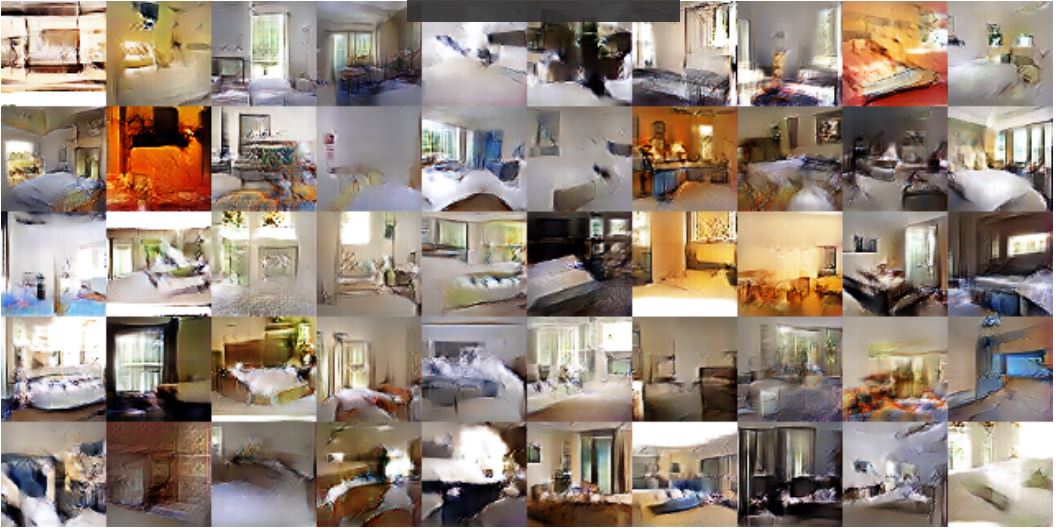
(引用元: Google-“[UNSUPERVISED REPRESENTATION LEARNING WITH DEEP CONVOLUTIONAL GENERATIVE ADVERSARIAL NETWORKS](https://arxiv.org/pdf/1511.06434.pdf)” )
:::talk{who="robotan"}
なんだこれはー!!本物にしか見えない!!
:::
:::talk{who="umatan"}
まさかこれが実在しないホテルの部屋だとは誰も思わないよねー!
:::
GANでは2つのニューラルネットワークを使います。片方が**Generator**、もう片方が**Discriminator**。
Generatorが生成した偽物のデータと実際に存在する本物のデータをDiscriminatorに判別させ、 Discriminatorが上手く判別できないようなデータを Generator が生成していきます。
Discriminatorはどんどん判別の難しくなるデータを上手く判別できるようにしていきます。
この学習が進むと最終的にGeneratorが生成される画像は本物にきわめて近くなっているという手法です。
## ニューラルネットワークをRで実装してみよう!
それでは、最後にニューラルネットワークをRで実装してみます。
ニューラルネットワーク自体はパッケージが用意されているので非常に簡単に実装することが可能です。
**有名なタイタニックのデータ**を用います。[Kaggleの公式サイト](https://www.kaggle.com/c/titanic/data)からデータをダウンロードできます。
まず、データのクレンジングを行い、欠損値は削除、不要と考えられる項目は削除しました。
**項目8つ**
:::box
Survived:生死 pclass:客室のクラス sex:性別 age:年齢 sibsp:兄弟・配偶者の数 parch:親・子供の数 fare:乗船料金 embarked:乗船した港
:::
**サンプル数714**
この時、生死を目的変数としそれ以外を説明変数とします。
サンプル数714のうちランダムに400個のデータを取り出し学習データとし、残りの314を予測データとします。
学習データで予測モデルを作り、予測データにあてはめ真値と予測値の判別率を精度として比較します。
シミュレーション回数は10回とし、上記の手順を10回繰り返し、結果を平均したものを最終アウトプットとします。シミュレーション回数をもっと増やせば精度の信頼性は上がります。
ニューラルネットワークを[ランダムフォレスト](/%E3%83%A9%E3%83%B3%E3%83%80%E3%83%A0%E3%83%95%E3%82%A9%E3%83%AC%E3%82%B9%E3%83%88)、[サポートベクターマシン](/svm)、[ナイーブベイズ](/naivebaise)、[ニューラルネットワーク](/nn)、[XGboost](/xgboost)、[k近傍法](/%ef%bd%8b%e8%bf%91%e5%82%8d%e6%b3%95)の5手法と比較します!
基本的に引数は全部デフォルトで!果たして結果はどうなるでしょうか!
```r title="knn-comparison.R"
##様々な手法で予測精度の比較を行う##
##randomForest,SVM,ナイーブベイズ,ニューラルネット
library(xgboost)
library(caret)
library(Matrix)
library(kernlab)
library(randomForest)
library(e1071)
library(nnet)
library(ggplot2)
library(class)
titanic<-read.csv("タイタニック乗船者リスト.csv")##データの読み込み
titanic<-na.omit(titanic)##欠損値削除
titanic$Survived<-as.factor(titanic$Survived)##質的変数に変換
sim<-10##シミュレーション回数
result<-matrix(0,sim,6)##結果の箱
titanic[,4]<-as.numeric(titanic[,4])
titanic[,9]<-as.numeric(titanic[,9])
for(i in 1:sim){
####学習データとテストデータに分ける####
train.id<-sample(nrow(titanic),400)
train.data<-titanic[train.id,-1]
test.data<-titanic[-train.id,-1]
##randomForest##
rf<-randomForest(Survived~.,train.data)
test.data.rf<-cbind(test.data,"predict"=predict(rf,test.data))
result[i,1]<-sum(test.data.rf$predict==test.data.rf$Survived)/nrow(test.data.rf)
##SVM##
svm<-ksvm(Survived~.,train.data)
test.data.svm<-cbind(test.data,"predict"=predict(svm,test.data))
result[i,2]<-sum(test.data.svm$predict==test.data.svm$Survived)/nrow(test.data.svm)
##ナイーブベイズ##
nb<-naiveBayes(Survived~.,train.data)
test.data.nb<-cbind(test.data,"predict"=predict(nb,test.data))
result[i,3]<-sum(test.data.nb$predict==test.data.nb$Survived)/nrow(test.data.nb)
##ニューラルネット##
nn<-nnet(Survived~.,train.data,size=5)
test.data.nn<-cbind(test.data,"predict"=round(predict(nn,test.data),0))
result[i,4]<-sum(test.data.nn$predict==test.data.nn$Survived)/nrow(test.data.nn)
##XGboost##
label.data.train<-as.integer(train.data$Survived)-1##目的変数を01に
label.data.predict<-as.integer(test.data$Survived)-1
train.data.xg<-train.data[,-1]##目的変数取り除く
test.data.xg<-test.data[,-1]
xgb.data<-xgb.DMatrix(data.matrix(train.data.xg),label=label.data.train)##Xgb型へ成型
xgb.data.predict<-xgb.DMatrix(data.matrix(test.data.xg))
param <- list(
"objective" = "binary:logistic"
,"eta" = 0.01
# ,"max_depth" = 10
,"min_child_weight" = 5
# ,"subsample" = 1
# ,"colsample_bytree" = 1
)##パラメータ適当
model <- xgboost(
param=param
,data=xgb.data
,nrounds=1000
)##実際の学習
predict_xgb<-predict(model,xgb.data.predict)
a<-c()
m<-length(predict_xgb)#行数
for(l in 1:m){
if(predict_xgb[l]>0.5){a[l]<-1}
else{a[l]<-0}
}
result[i,5]<-sum(a==label.data.predict)/length(a)
#k-nn
knn<-knn(train.data,test.data,train.data[,"Survived"] ,prob=T,k=3)
test.data.knn<-cbind(test.data,"predict"=knn)
result[i,6]<-sum(test.data.knn$predict==test.data.knn$Survived)/nrow(test.data.knn)
}
result.c<-apply(result,2,mean)##simの平均値
result.c<-t(as.matrix(result.c))
result.c<-rbind(result.c,result.c)
result.c<-round(result.c,3)
##グラフ描画
colnames(result.c) <- c("RF","SVM","Bayes","NN","xgb","knn")
df<-data.frame(method=colnames(result.c),result=colMeans(result.c))
gp<-ggplot(df,aes(x=method,y=result,fill=method))
gp<-gp+geom_bar(width=0.8,stat="identity")
gp<-gp+ylab("result")
gp<-gp+geom_text(label=colMeans(result.c),vjust=1)
plot(gp)
```
nnetというパッケージに入っているnnetという関数を用いて解析を行っていきます。
> \##ニューラルネット##\
> nn<-nnet(Survived\~.,train.data,size=5)\
> test.data.nn<-cbind(test.data,”predict”=round(predict(nn,test.data),0))\
> result\[i,4]<-sum(test.data.nn\$predict==test.data.nn\$Survived)/nrow(test.data.nn)
データ加工は描画でいくつかコードを書いていますが、実際にランダムフォレストを行っているのはこの数行!
Survived\~.はSurvivedを目的変数としてそれ以外を説明変数にするよーということです。
結果は以下のようになりました!
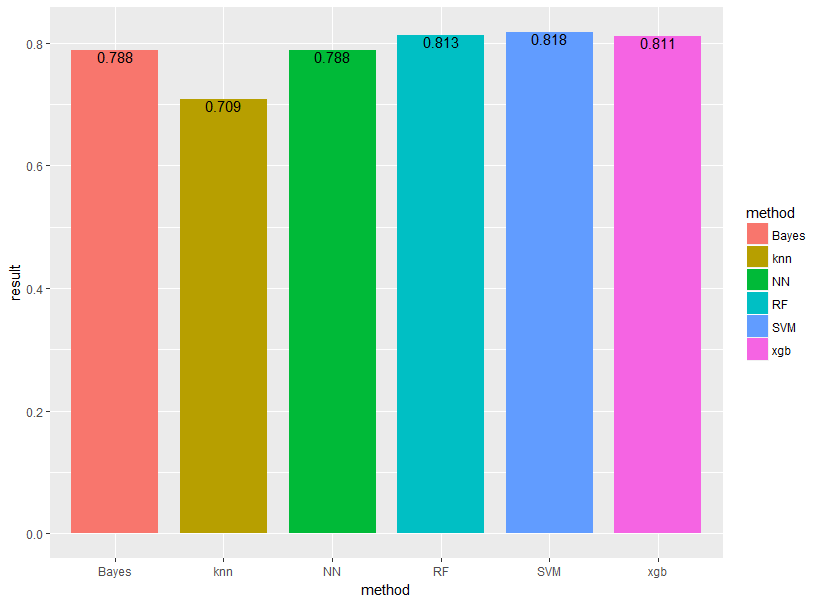
それぞれBayes(ナイーブベイズ)、knn(k近傍法)、NN(ニューラルネットワーク)、RF(ランダムフォレスト)、SVM(サポートベクターマシン)、xgb(XGboost)と表示しています。
やはりランダムフォレスト・SVM・XGboostあたりが強いですね!
他の手法についても是非見てみてください!
今回はパラメータをいじらずデフォルト設定で行ったためグリッドサーチなどでチューニングを行えば、もっと良い精度が出るでしょう。
## ニューラルネットワーク まとめ
ニューラルネットワークはこれからも応用が期待される手法であり、形を変えて様々な分野で活用されています。
これからもニューラルネットワークの発展をウォッチしていきたいですね!
最後にニューラルネットワークについてまとめておきましょう!
:::point
**・人間の神経回路を模倣したモデル**\
**・実は50年ほど前からある古いモデル**\
**・CNN・RNNなど派生手法が複数ある**
:::
ニューラルネットワークという言葉は出てきませんが、[パーセプトロン](/perceptron)による識別という文脈で以下の書籍でまとめられていますので、より深く勉強したいという方はオススメです!
::product[はじめてのパターン認識]{url="https://www.amazon.co.jp/dp/4627849710?tag=statistic08-22&linkCode=ogi&th=1&psc=1" image="https://m.media-amazon.com/images/I/51YFB3Y0EYL._SL160_.jpg" amazon="https://www.amazon.co.jp/dp/4627849710?tag=statistic08-22&linkCode=ogi&th=1&psc=1" rakuten="https://af.moshimo.com/af/c/click?a_id=858168&p_id=54&pc_id=54&pl_id=616&url=https%3A%2F%2Fsearch.rakuten.co.jp%2Fsearch%2Fmall%2F%25E3%2581%25AF%25E3%2581%2598%25E3%2582%2581%25E3%2581%25A6%25E3%2581%25AE%25E3%2583%2591%25E3%2582%25BF%25E3%2583%25BC%25E3%2583%25B3%2F%3Ff%3D1%26grp%3Dproduct"}
他の機械学習手法についてもっと詳しく知りたい方は以下の記事でまとめていますのでチェックしてみてください!
ニューラルネットワークを深めてディープラーニングに進みたい方は以下の記事をチェックしてみてください!
今回はRでの実装でしたがPythonを学びたいという方は以下の記事でまとめているのでチェックしてみてください!
もしこれらを包括的により深く学びたい方は、当メディアが運営している「スタアカ(スタビジアカデミー)」を是非チェックしてみてください!
:::box
**[業界最安級のAIデータサイエンス特化スクール:スタアカ(スタビジアカデミー)](https://toukei-lab.com/achademy/)**
:::
格安でデータサイエンスが一通り学べます!ご受講お待ちしております!