# UMAPとは?次元削減の仕組みとt-SNEとの違い、Pythonでの使い方を分かりやすく解説!
> UMAPとは、たくさんの次元を持つデータを2次元や3次元の地図にして眺める次元削減の手法です。本記事では、意味や仕組み(近所づきあいを保って並べ直す)、t-SNEとの違い、n_neighbors・min_distの設定のコツと注意点、Python(umap-learn)での使い方を図解で解説します!
- URL: https://toukei-lab.com/umap
- 公開: 2026.11.02
- サイト: スタビジ(https://toukei-lab.com)
:::talk{who="umatan"}
当サイト【スタビジ】の本記事では、次元削減の手法「UMAP(ユーマップ)」について分かりやすく解説していきます!仕組みから、t-SNEとの違い、使うときのコツと注意点、Pythonでの使い方まで見ていきましょう!
:::
こんにちは!ウマたんです!
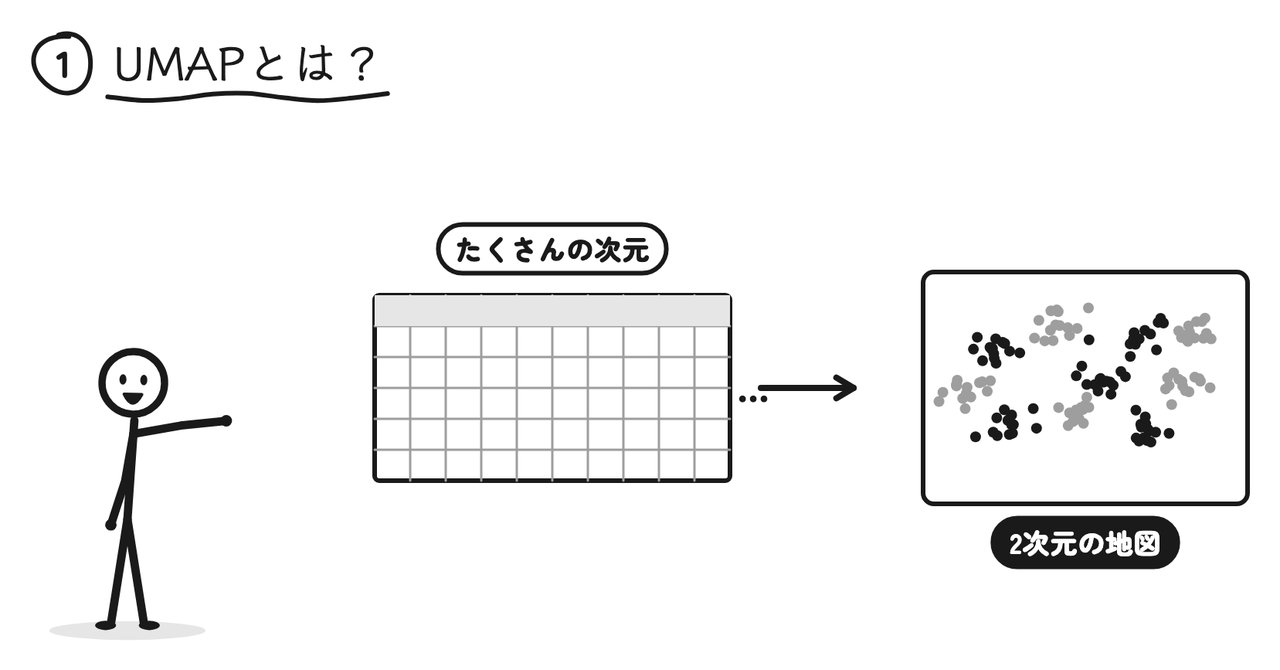
たくさんの特徴を持つデータを、2次元の地図にして眺める。
データ分析では、そんな場面がよくあります。
たとえば、何百もの項目があるデータでも、2次元の散布図にできれば「どんなグループがありそうか」がひと目で分かりますよね。
この「たくさんの次元を、少ない次元に縮める」ことを**次元削減**と呼びます。
今回解説する「**UMAP(ユーマップ)**」は、その次元削減の手法のひとつです。
:::talk{who="man" side="left"}
次元削減って、主成分分析とかt-SNEとかいろいろあるけど、UMAPは何が違うの?
:::
:::talk{who="woman"}
UMAPの地図って、どうやって読めばいいのか知りたい!
:::
本記事では、次の4つを順番に解説していきます。
:::point
**・UMAPとは?**\
**・UMAPの仕組み**\
**・t-SNEとの違い**\
**・使うときのコツと注意点(Pythonでの使い方)**
:::
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!
::youtube{#Xs_r4msx7Bc}
## UMAPとは?
**UMAPとは、たくさんの次元を持つデータを、2次元や3次元に縮めて、目に見える形にする次元削減の手法**です。
正式な名前は「Uniform Manifold Approximation and Projection」。2018年に、リーランド・マッキネス(Leland McInnes)らが発表しました。
### 手書きの数字が「島」に分かれる
たとえば、手書きの数字の画像を考えてみましょう。
機械学習でよく使われる手書き数字のデータ「MNIST」では、1枚の画像が28×28=784個のピクセルでできています。
つまり、画像1枚が、784個もの数字の集まり。784次元のデータというわけです。
これでは、データがどう並んでいるのか、人の目ではまったく見えません。
ところが、UMAPで2次元に縮めると、「0」は0どうし、「1」は1どうし、似たものが集まった地図ができるんです!
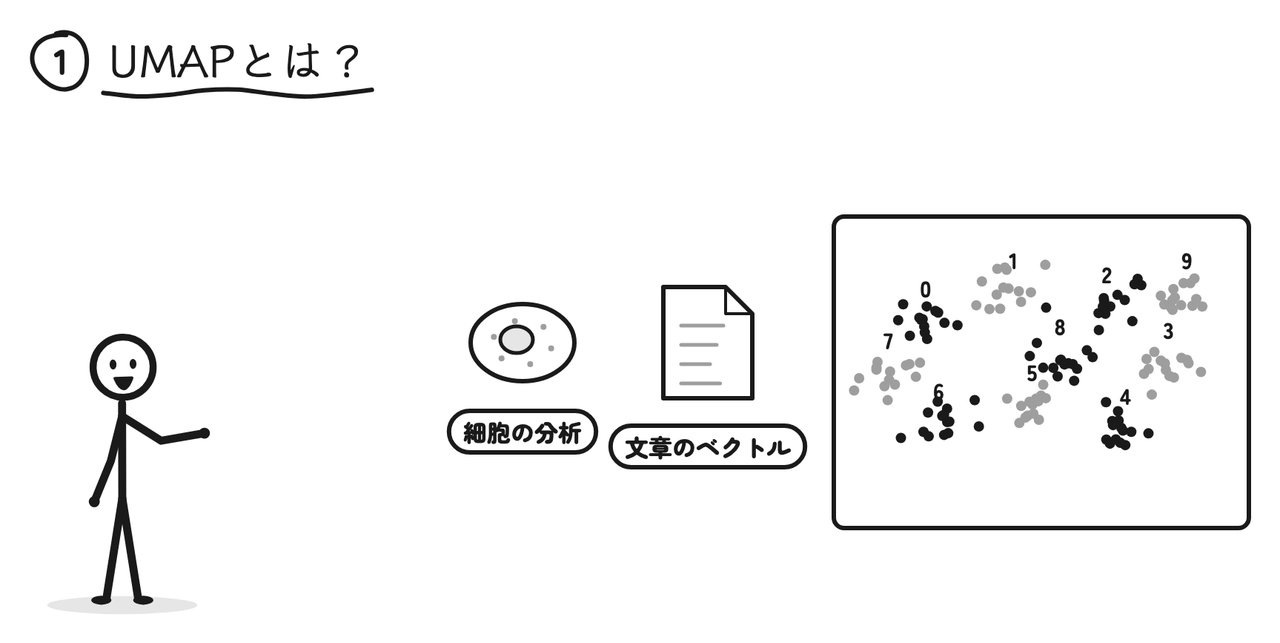
元のデータには「これは0」「これは1」という答えを教えていないのに、似た画像どうしが自然と集まって、数字ごとの「島」に分かれる。
これがUMAPの面白いところです。
### どんな分野で使われている?
いまでは、UMAPはいろいろな分野で使われています。
| 分野 | 使い方 |
|---|---|
| 生物学 | 細胞1つ1つの遺伝子のはたらき方のデータを2次元にして、細胞の種類ごとのまとまりを見る |
| 自然言語処理 | 文章をベクトルにしたもの(埋め込み)を2次元にして、似た内容の文章のまとまりを見る |
| 画像 | 画像の特徴を2次元にして、似た画像がどう集まっているかを見る |
| ビジネスのデータ | お客さんの購買データなどを2次元にして、どんなタイプのお客さんがいそうかを眺める |
特に、文章や画像をAIでベクトルにしたものは、数百〜数千次元になることもよくあります。
そんなデータの全体像をつかむのに、UMAPはとても便利なんです。
文章をベクトルにする方法については、以下の記事で解説しています。
ちなみに、次元が多すぎると分析がうまくいかなくなる問題は「次元の呪い」と呼ばれます。こちらもあわせて読んでみてください。
## UMAPの仕組み
それでは、UMAPがどうやって地図を作っているのかを見ていきましょう!
UMAPは、大きく2つのステップで動きます。
:::box{title="UMAPの2つのステップ"}
**ステップ1**:元のデータで「近所づきあい」を調べる\
**ステップ2**:そのつながりを、なるべく保ったまま、2次元に並べ直す
:::
### ステップ1:近所づきあいを調べる
1つ目は、元のデータで「近所づきあい」を調べることです。
それぞれのデータについて、近くにいるデータを探して、近いものどうしを線でつなぎます。
そうしてできるのが、網目のような「つながりの地図」です。
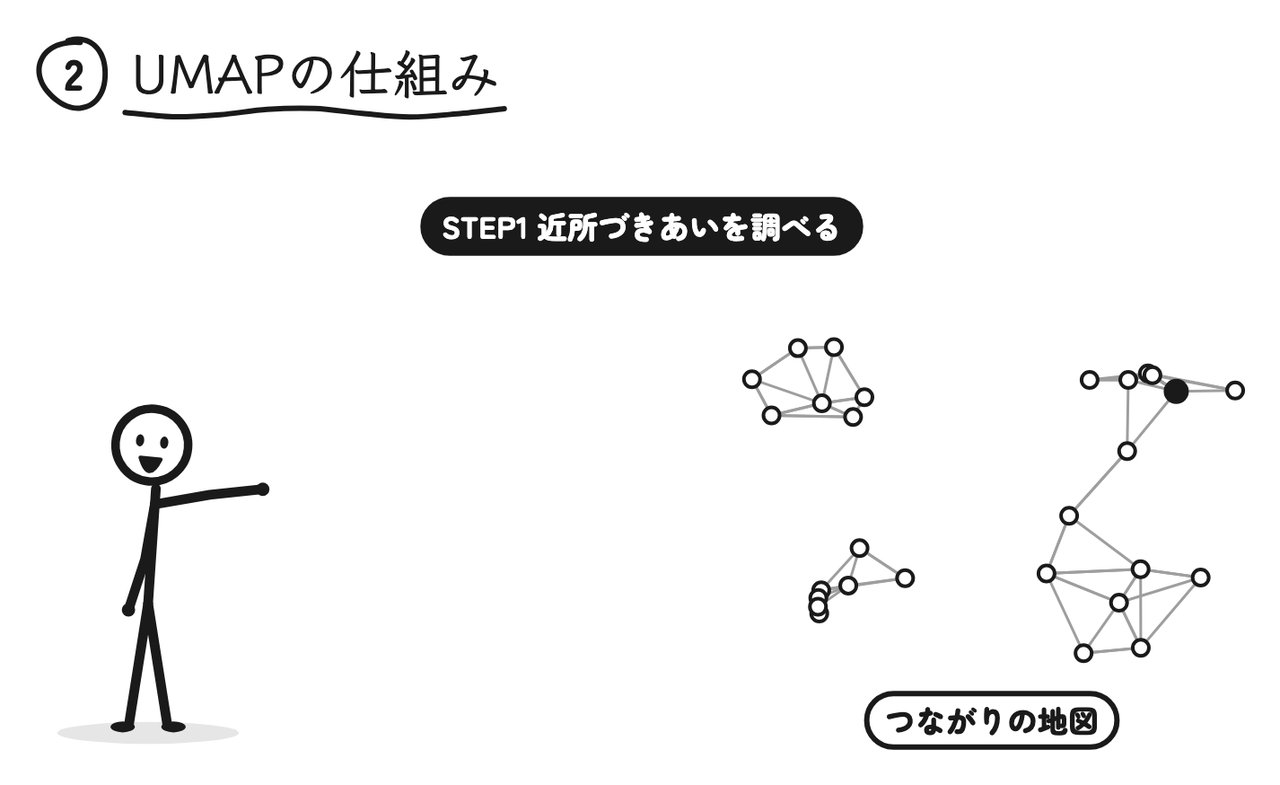
このように、近くにいる何個かのデータとつないだ網目は「**k近傍グラフ**」と呼ばれます。
ここでの「近い」は、元の高い次元の世界での近さです。
784次元の手書き数字なら、784個のピクセルの値が似ている画像ほど「近い」と考えます。
### ステップ2:つながりを保って2次元に並べ直す
2つ目は、そのつながりを、なるべく保ったまま、2次元に並べ直すことです。
元の世界で仲が良かったデータは、2次元でも近くに。
そうでないデータは、離れた場所に。
少しずつ位置を調整して、元のつながりにいちばん近い並べ方を探すんです!
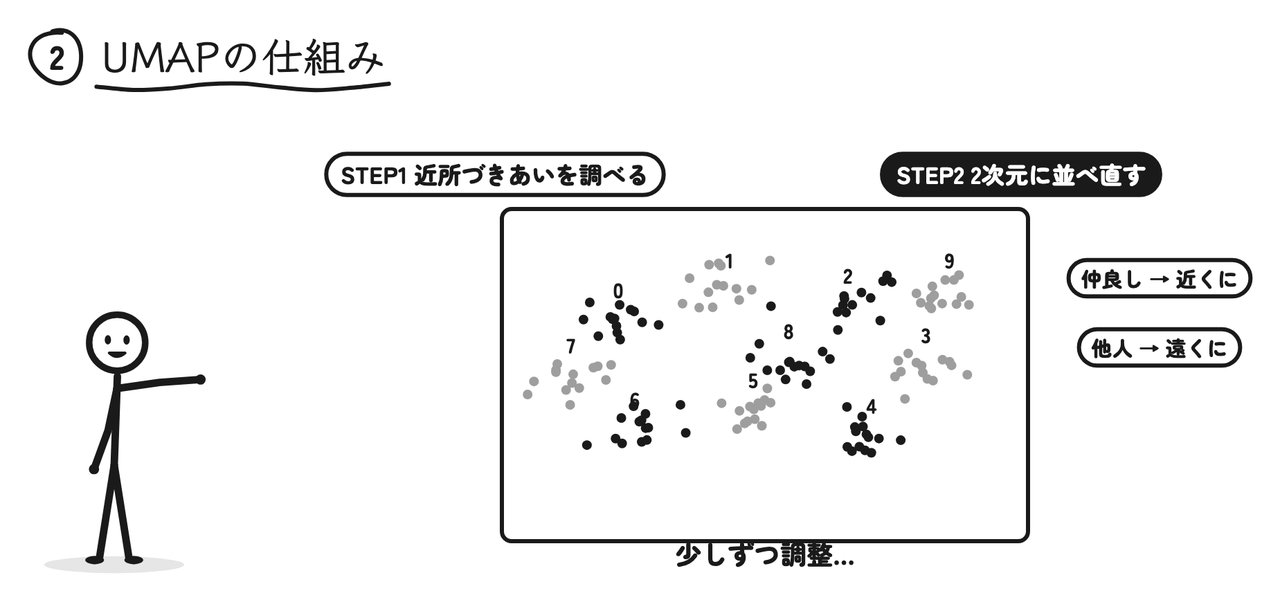
たとえるなら、クラスの席替えのようなイメージです。
:::box{title="席替えでたとえると"}
**・ステップ1**:クラス全員に「仲の良い友達は誰?」とアンケートをとる\
**・ステップ2**:仲の良い人どうしが近くの席になるように、教室の座席表を作る
:::
教室は平らなので、全員の人間関係を完璧に再現することはできません。
それでも、仲良しグループがまとまって座れるような、いちばん良い座席表を探す。
UMAPがやっているのは、まさにそういうことなんです!
## t-SNEとの違い
UMAPとよく比べられるのが、同じ次元削減の手法「**t-SNE(ティースニー)**」です。
t-SNEも、似たものどうしを近くに並べる、人気の手法です。2008年に発表され、UMAPが出てくる前から、データの可視化によく使われてきました。
UMAPとt-SNEの違いは、大きく3つあります。
| | t-SNE | UMAP |
|---|---|---|
| 速さ | 大きなデータでは時間がかかりやすい | 計算が速く、大きなデータでも扱いやすい |
| 全体の形 | 近所の関係を重視するぶん、グループどうしの位置関係が崩れやすい | 全体の配置も比較的よく残せる |
| 新しいデータ | 一度作った地図に、あとから当てはめにくい | 一度作った地図に、あとから来たデータを当てはめられる |
### 1つ目:速さ
1つ目は、速さです。
UMAPは計算が速く、大きなデータでも扱いやすいんです。
数万件、数十万件といったデータを地図にしたいときには、この差が大きく効いてきます。
### 2つ目:全体の形
2つ目は、全体の形です。
t-SNEは近所の関係を重視するぶん、グループどうしの位置関係が崩れやすいんです。
UMAPは、全体の配置も比較的よく残せます。
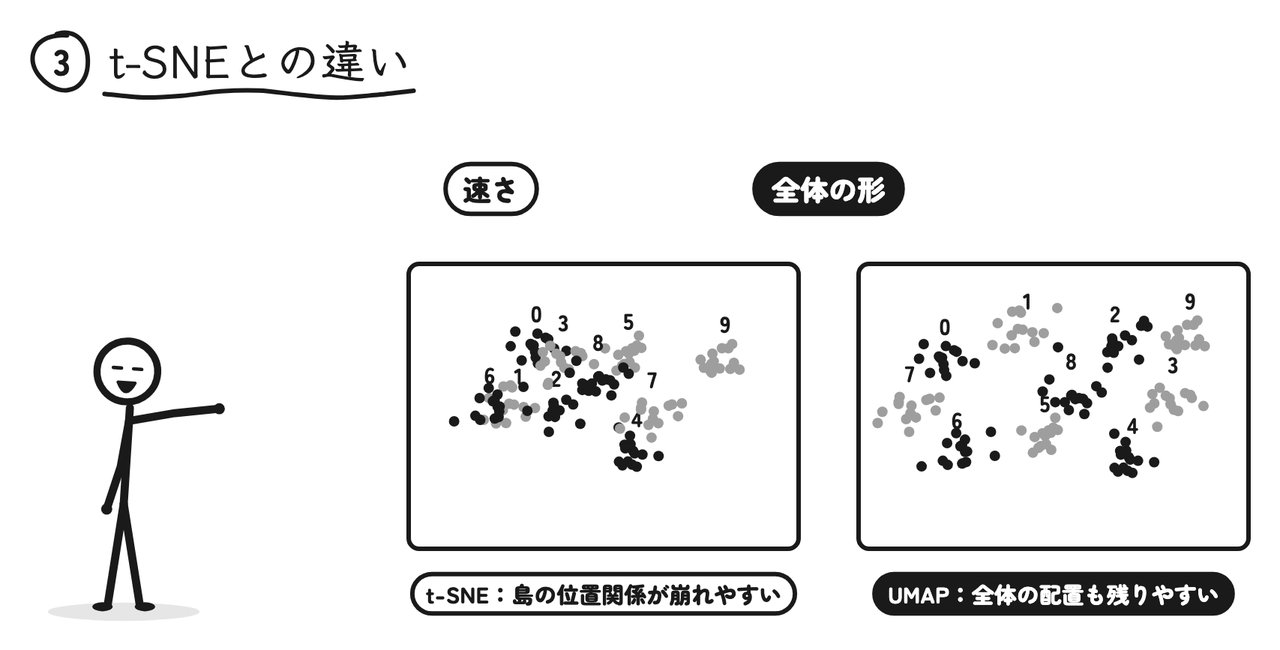
たとえば手書きの数字なら、t-SNEでも「0の島」「1の島」はきれいに分かれます。
でも、「どの島とどの島が近いか」という全体の並びは、UMAPのほうが元のデータの関係を残しやすい、というわけです。
### 3つ目:新しいデータ
3つ目は、新しいデータです。
UMAPは、一度作った地図に、あとから来たデータを当てはめることができます。
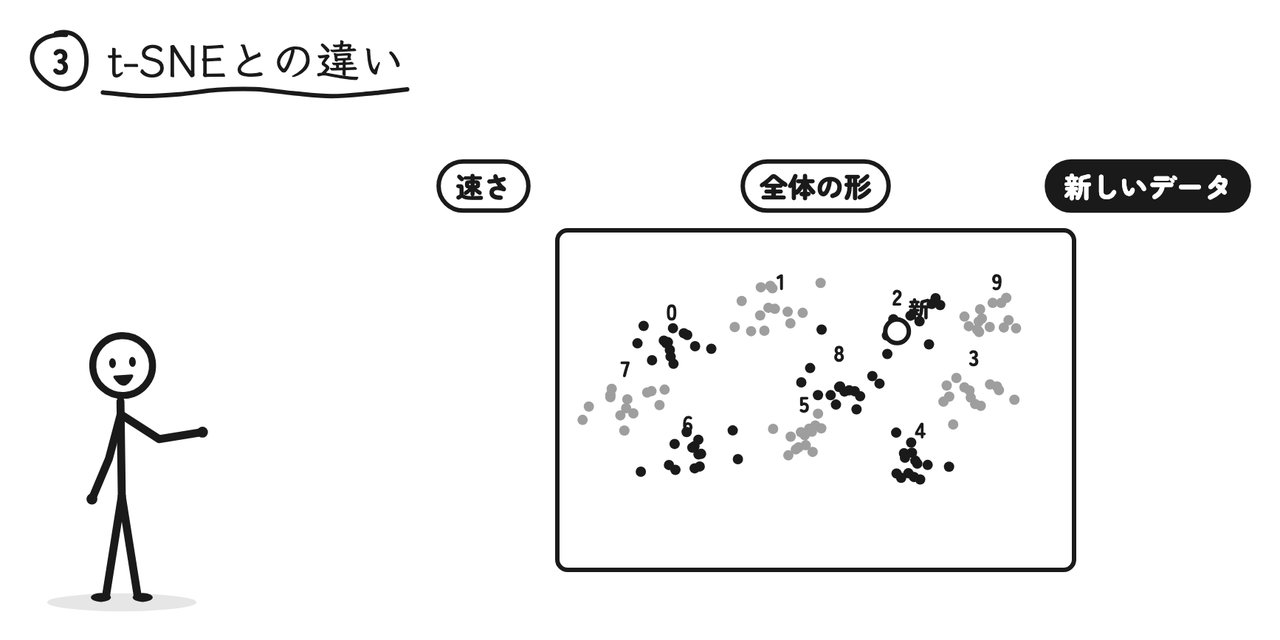
たとえば、先月のデータで地図を作っておけば、今月の新しいデータを、同じ地図のどこに来るかで見比べられます。
Pythonでよく使われるscikit-learnのt-SNE(`TSNE`)には、このように新しいデータを当てはめる機能がありません。
### 主成分分析(PCA)ともくらべてみよう
次元削減の定番といえば、**主成分分析**(PCA)もありますよね。
3つの手法をくらべると、こんな特徴があります。
| | 主成分分析(PCA) | t-SNE | UMAP |
|---|---|---|---|
| 縮め方 | 直線的(線形) | 曲がった関係も扱える(非線形) | 曲がった関係も扱える(非線形) |
| 得意なこと | データのばらつきが大きい方向をとらえる | 近所のまとまりをはっきり見せる | 近所のまとまりと全体の配置をバランスよく見せる |
| 速さ | とても速い | 遅め | 速い |
| 新しいデータの当てはめ | できる | できない(scikit-learnの場合) | できる |
| 軸の意味 | 読み取れる(第1主成分など) | 意味はない | 意味はない |
主成分分析は、軸の意味が読み取れるのが強みです。
一方、UMAPやt-SNEの地図の縦軸・横軸には、意味がありません。
「何が効いているか」を知りたいなら主成分分析、「どんなまとまりがあるか」を眺めたいならUMAP、と使い分けるのがおすすめです!
主成分分析については、以下の記事で詳しく解説しています。
## 使うときのコツと注意点
それでは最後に、UMAPを使うときのコツと注意点です。
### 大事な設定は「n_neighbors」と「min_dist」
UMAPで特に大事な設定は、2つあります。
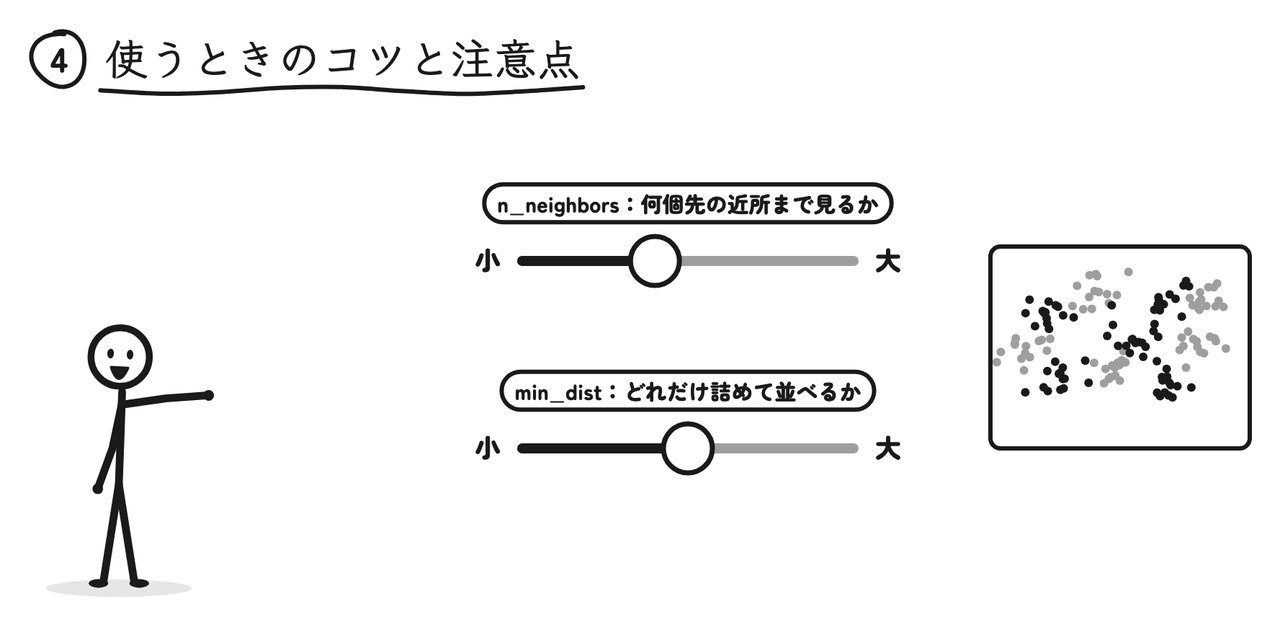
1つ目の「**n_neighbors(エヌ・ネイバーズ)**」は、何個先の近所まで見るか。
小さくすると細かい違いが、大きくすると全体の形が見えやすくなります。
2つ目の「**min_dist(ミン・ディスト)**」は、点どうしをどれだけ詰めて並べるか。
小さいほど、ぎゅっと固まった島になります。
| 設定 | 小さくすると | 大きくすると | 初期値 |
|---|---|---|---|
| n_neighbors(何個先の近所まで見るか) | 細かい違いが見えやすい(小さな島がたくさん) | 全体の形が見えやすい(大きなまとまり) | 15 |
| min_dist(どれだけ詰めて並べるか) | ぎゅっと固まった島になる | ふんわり散らばる | 0.1 |
※初期値は、Pythonのライブラリ「umap-learn」のものです。
まずは初期値で試してみて、細かいまとまりを見たいならn_neighborsを小さく、全体をつかみたいなら大きく、というように調整していくのがおすすめです。
### 地図の読み方に注意
注意したいのは、地図の読み方です。
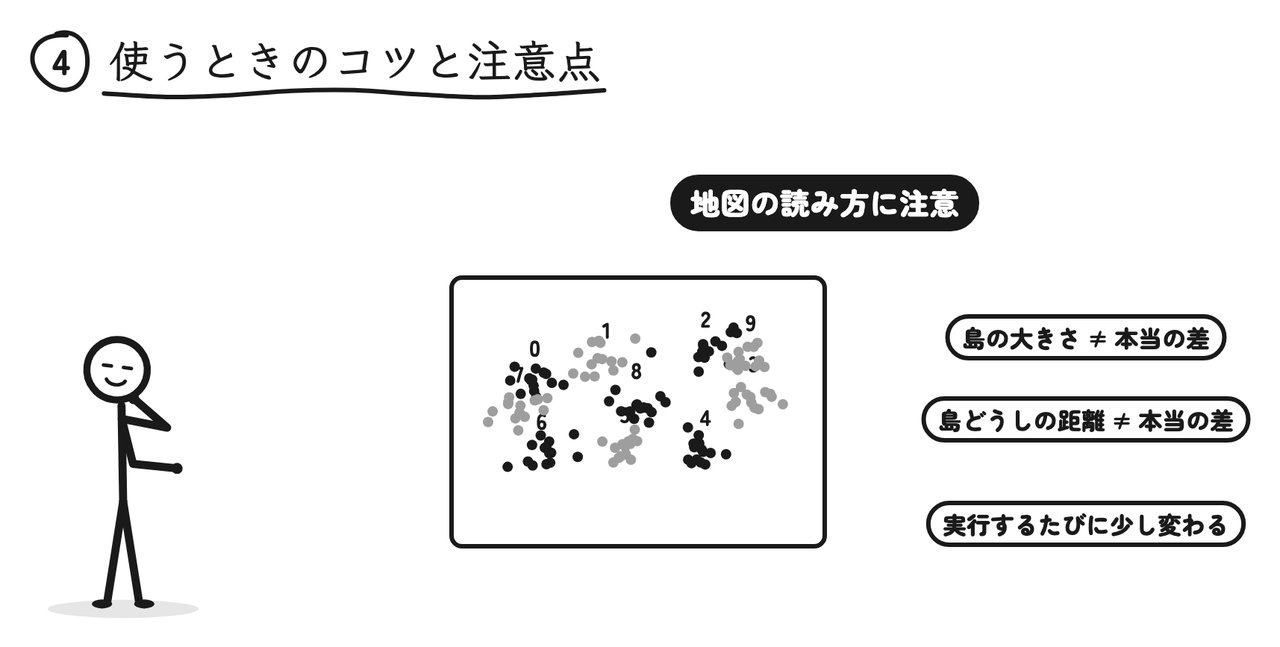
:::warn
**・島の大きさは、そのまま元のデータのばらつきの大きさを表しているとは限らない**\
**・島どうしの距離も、そのまま元のデータの差を表しているとは限らない**\
**・実行するたびに、地図の形が少し変わることもある**
:::
たとえば、「Aの島がBの島の2倍大きいから、Aのほうがばらつきが2倍大きい」とは言えないんです。
また、地図の上で島に分かれて見えても、それがそのままデータのグループ分けの正解とは限りません。
グループ分けをきちんとしたいときは、クラスター分析の手法も組み合わせて考えましょう。
UMAPの地図は、データの全体像をつかむための「下見」として使うのがおすすめなんです!
### Pythonで試してみよう
Pythonでは「**umap-learn**」というライブラリで、手軽に試せます。
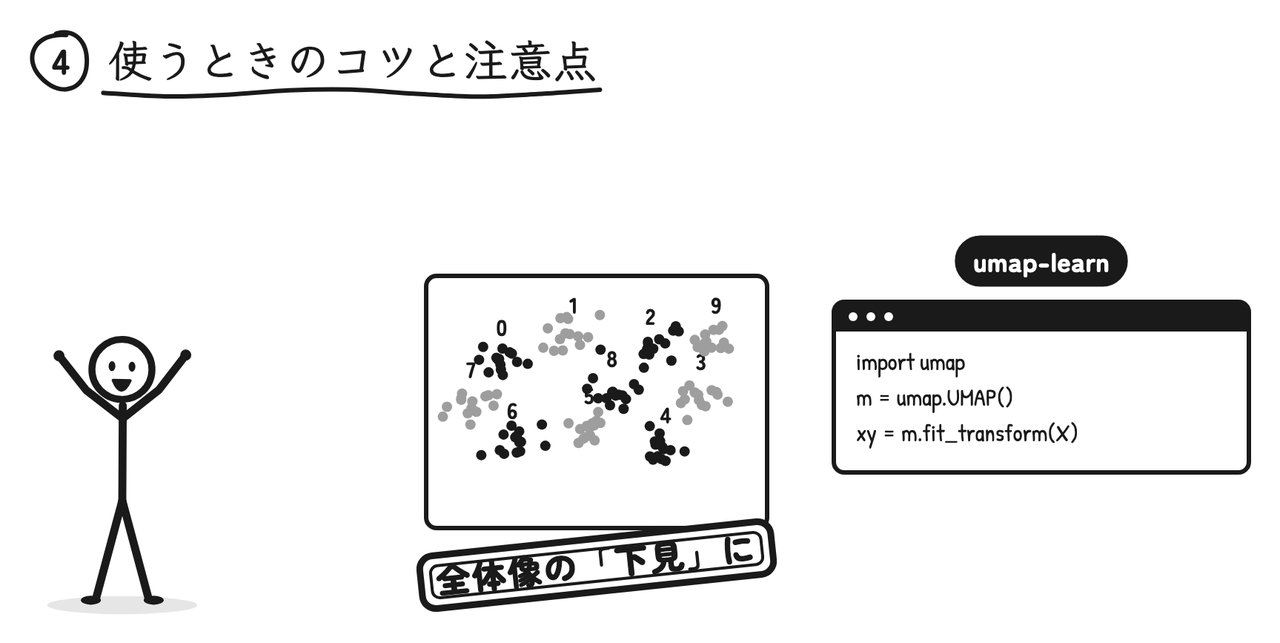
インストールは次のとおりです。
```bash
pip install umap-learn
```
:::warn
`pip install umap` だと、名前の似た別のライブラリが入ってしまいます。インストールするときは `umap-learn`、使うときは `import umap` です。
:::
scikit-learnに入っている手書き数字のデータ(8×8ピクセル=64次元、1,797枚)を、2次元の地図にしてみましょう。
```python
import umap
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits
# 8×8ピクセル(64次元)の手書き数字の画像 1,797枚
digits = load_digits()
X, y = digits.data, digits.target
# UMAPで2次元に縮める
reducer = umap.UMAP(n_neighbors=15, min_dist=0.1, random_state=42)
embedding = reducer.fit_transform(X) # 形は (1797, 2)
# 数字ごとに色を分けて描く
plt.scatter(embedding[:, 0], embedding[:, 1], c=y, cmap="tab10", s=5)
plt.colorbar()
plt.show()
```
実行すると、0〜9の数字ごとに、色の分かれた島が並んだ地図が描かれます。
ここで `y`(正解の数字)は、色をつけるためだけに使っていて、UMAPには渡していません。
それでも数字ごとにまとまるのは、似た画像どうしが近くに並べられているからなんです!
`random_state` を決めておくと、何度実行しても同じ地図になります(そのかわり、並列での計算が使われなくなるので、少し遅くなります)。
また、一度作った地図に新しいデータを当てはめるときは、`transform` を使います。
```python
# 1,500枚で地図を作り、残りの297枚をあとから当てはめる
X_train, X_new = X[:1500], X[1500:]
reducer = umap.UMAP(random_state=42).fit(X_train)
new_embedding = reducer.transform(X_new) # 形は (297, 2)
```
なお、身長(cm)と体重(kg)のように、項目ごとに単位や大きさがばらばらなデータでは、先に標準化(scikit-learnの `StandardScaler` など)をしておくと、距離がかたよらずにすみます。
## UMAPのまとめ
最後に、今回のポイントをおさらいしましょう!
:::point
**・UMAPは、たくさんの次元を持つデータを、2次元や3次元の地図にする次元削減の手法**\
**・元のデータの「近所づきあい」を調べて、そのつながりを保つように並べ直す**\
**・t-SNEと比べて速く、全体の形も残しやすく、あとから来たデータも当てはめられる**\
**・ただし、島の大きさや距離の読みすぎには注意**
:::
:::talk{who="umatan"}
要は、UMAPは、大きなデータの全体像を、すばやく見渡せる「地図づくり」の道具なんです!ぜひ、手元のデータで試してみてください!
:::
UMAPのような次元削減や機械学習、データサイエンスを体系的に学びたいのであれば、当メディアが運営するスクール「**[スタアカ](https://toukei-lab.com/achademy/)**」がオススメです!
:::box
**[業界最安級のAIデータサイエンス特化スクール「スタアカ」](https://toukei-lab.com/achademy/)**
:::