開催中AUC・大きいほど良い
株価の上がり下がり予測チャレンジ(架空の銘柄)
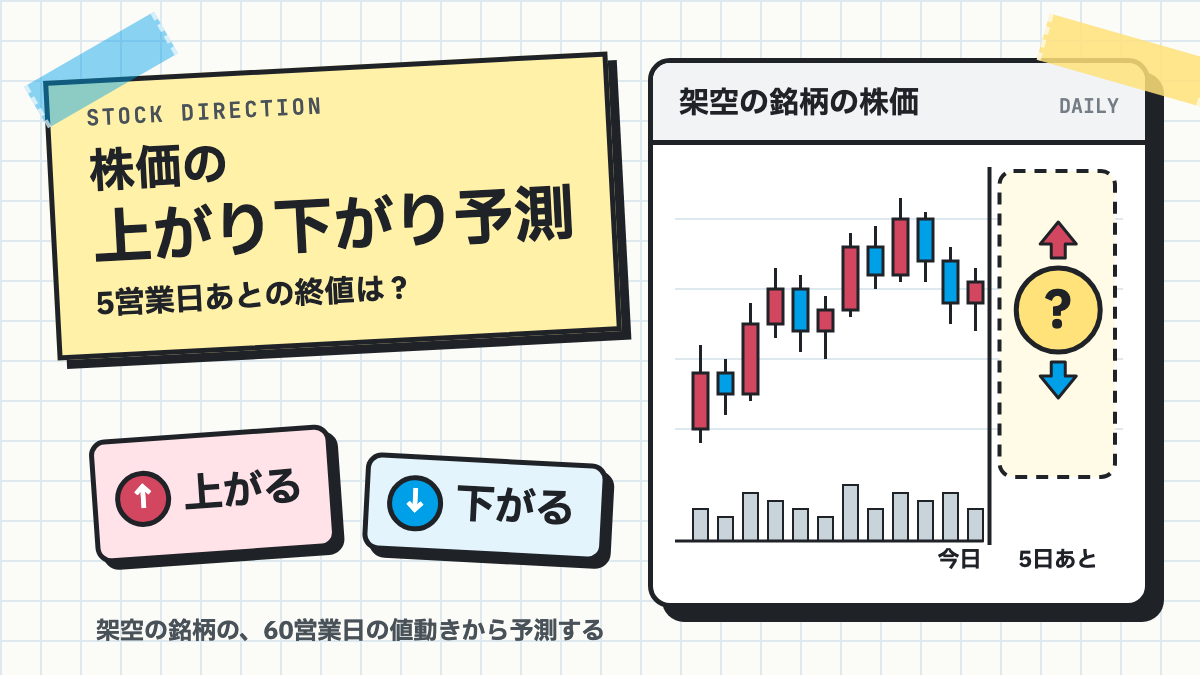
架空の銘柄の株価から、5営業日あとの終値が今日より上がるかを予測するコンペです。移動平均線や RSI などのテクニカル指標を、60営業日の値動きから作るのがポイントです。
- 期間:2026年11月14日から(終わりの日は決まっていません)
- 提出:1日5回まで(日本時間の0時に戻ります)
- 参加者:—人
- ベースライン:0.54717(直近5日の逆張り(5日前より下がっているほど上がるとみる)で予測したときのスコア)
読み込んでいます…
無料の登録をして参加する
メールアドレスか Google で、無料で登録できます。登録すると、データを落として、提出できるようになります。
または
すでにスタアカのアカウントがある方は、ログインしてください。登録すると、利用規約とプライバシーポリシーに同意したものとします。
コンペに参加する
順位表に出す名前を決めて、ルールに同意してください。名前は空でもかまいません(「参加者」と4けたの数になります)。メールアドレスや本名は、順位表には出ません。
データ
- train_prices.csv学習用の株価(架空の200銘柄の、2023〜2025年の734営業日の四本値と出来高・146,800行・約6.2MB)
- stocks.csv学習用の200銘柄の業種
- train.csv学習用の答え(銘柄と日付ごとに、5営業日あとに上がったか・145,800行・約2.6MB)
- test_windows.csvテスト用の株価(3,000個の窓。1つの窓は、ある架空の銘柄の60営業日・180,000行・約6.4MB)
- test.csvテスト用の窓の ID と業種(予測する3,000行)
- sample_submission.csv提出の見本(この形で提出します)
- data_explanation.csv列の説明
提出する
順位表に出す名前:(変える)
読み込めませんでした。時間をおいて、もう一度開いてください。
順位表
1人1行で、いちばん良いスコアが載ります。
| 順位 | 名前 | スコア | 提出 | 最後の提出 |
|---|---|---|---|---|
| 読み込んでいます… | ||||
自分の提出
| 日時 | ファイル | 結果 |
|---|
背景と目的
株価が5営業日あとに上がるか下がるかを、予測してみましょう。
株価は、たくさんの人が「上がりそう」「下がりそう」と考えて売り買いした結果で決まります。だれでも気づくような上がる理由は、気づいた人がすぐに買うので、あっという間に値段に入ってしまいます。そのため、明日や来週の上がり下がりを当てるのは、プロでもとても難しい仕事です。当たる割合が五分五分から少し良くなるだけでも、大きな意味があります。
本物の株価のデータは、取引所やデータの会社の決まりで、自由に配ることができません。そこでこのコンペでは、スタアカが作った架空の銘柄の株価を使います。本物の株価によく似た動き(値動きの大きい時期と小さい時期がしばらく続く・ときどき大きく跳ねる・市場全体や同じ業種の銘柄と一緒に動く・値動きの大きい日は出来高も多い)をするように作りました。銘柄も会社も実在しません。この中に、テクニカル指標で見つけられる「弱い流れ」が少しだけ入っています。
このコンペでは、ある日(日 = 0)までの60営業日の株価から、5営業日あとの終値が、日 = 0 の終値より上がるかを予測するモデルを作ってください。
スコアを伸ばすカギは、60営業日の値動きと出来高から、良い特徴量を作れるかです。コース13「株価データ分析」の 株データを取得してみよう! と Plotlyでローソク足チャートの作成(どちらも無料で見られます)のあと、会員向けのレッスンで 移動平均線・MACD・ボリンジャーバンド・モメンタム・RSI の求め方を学べます。時系列のデータの検証のしかたと、未来の情報が混ざる「リーク」の防ぎ方は、コース07「機械学習実装」の データ準備・特徴量エンジニアリング②:日付と時系列・モデル構築(会員向け)が役に立ちます。
データ
| ファイル | 中身 |
|---|---|
train_prices.csv | 学習用の株価。架空の200銘柄の、2023年1月4日〜2025年12月30日(734営業日)の四本値と出来高(146,800行) |
stocks.csv | 学習用の200銘柄の業種 |
train.csv | 学習用の答え。銘柄と日付ごとの 上がる(145,800行)。train_prices.csv の終値から作ったもので、自分で作り直すこともできます |
test_windows.csv | テスト用の株価。3,000個の窓で、1つの窓は、ある架空の銘柄の60営業日(180,000行) |
test.csv | テスト用の窓の ID と業種(3,000行。この行を予測します) |
sample_submission.csv | 提出の見本 |
data_explanation.csv | 列の説明(下の表と同じ) |
予測するのは 上がる です。日 = 0 の終値より、5営業日あと(その銘柄の行で5つ先)の終値が高ければ 1、同じか安ければ 0 です。学習用のデータでは、約53%が 1 です(学習用の3年間は、市場全体が上がった時期でした)。
テスト用の窓は、学習用のデータと次の点が違います
- 日付がありません。
日は、予測する日を 0 として、-1 が1営業日前、…、-59 がいちばん古い日です - 3,000個の窓は、1つずつ別々に作った架空の市場から取りました。窓どうしは、日付も市場全体の動きもつながっていません。学習用の期間ともつながっていません
- 日 = 0 より先の株価は、どこにも配っていません
こうしているのは、答えを隠すためです。学習用のように続いた株価を配ると、テストの日の5営業日あとの値段もファイルに入ってしまい、答えが見えてしまいます。
そのため、特徴量は「その銘柄の、日 = 0 までの60営業日」だけから作れるものにしてください。学習用のデータからも、銘柄ごとに同じ60営業日の窓を切り出して学習すると、テストと同じ条件になります。同じ日のほかの銘柄の動き(市場全体の平均など)・日付・曜日・銘柄コードは、テストでは使えません。また、検証は時間で分けましょう(たとえば、2024年までで学習して2025年で確かめる)。行をばらばらに分けると、隣どうしの日は5日間のうち4日が重なるので、スコアが良く見えすぎます。
株価(train_prices.csv・test_windows.csv) 1行が、1つの銘柄の1営業日です。
| 列 | 中身 |
|---|---|
銘柄コード | 架空の銘柄の番号(S001〜S200)。本物の銘柄コードとは関係ありません(train_prices.csv だけ) |
日付 | 取引のあった日。土日・祝日・年末年始(12/31〜1/3)はありません(train_prices.csv だけ) |
ID | テスト用の窓の番号(test_windows.csv だけ)。1つの ID に60行あります |
日 | 何営業日目か。0 が予測する日、-59 がいちばん古い日(test_windows.csv だけ) |
始値 | その日の最初の値段(円) |
高値 | その日のいちばん高い値段(円) |
安値 | その日のいちばん安い値段(円) |
終値 | その日の最後の値段(円) |
出来高 | その日に売り買いされた株の数(100株単位) |
そのほか
| ファイル | 列 | 中身 |
|---|---|---|
stocks.csv | 銘柄コード・業種 | 学習用の銘柄の業種(10種類・20銘柄ずつ) |
test.csv | ID・業種 | テスト用の窓の業種(同じ10種類) |
train.csv | 銘柄コード・日付・上がる | 学習用の答え。各銘柄の最後の5営業日は、5営業日あとがないので入っていません |
評価指標
AUC(ROC曲線の下の面積)。上がった窓ほど、大きい予測の値をつけられているかを測ります。上がった窓と上がらなかった窓を1つずつ選んだとき、上がった窓のほうに大きい値をつけられている割合と同じです。大きいほど上位です。
- 1.0 なら、上がった窓の全部に、上がらなかった窓のどれよりも大きい値をつけられています
- 0.5 は、でたらめに予測したのと同じです(全部に同じ値をつけても 0.5 になります)
- 値の大きさそのものではなく、並び順だけで決まります。同じ値の組は、半分当たったと数えます。提出には、上がる確率(0〜1)を入れるのがふつうです
このコンペのスコアの目安 株価の上がり下がりには、たまたまの動きがとても大きいので、どんなに良いモデルでも 1.0 には遠く届きません。0.55 を超えれば手がかりをつかめていて、0.6 前後なら、かなり良いスコアです。テストは3,000個なので、スコアには ±0.01 くらいの運のぶれもあります。
なぜ AUC なのか 上がる・上がらないはほぼ半々で、良いモデルでも、予測の確率は 0.5 から少ししか離れません。0.5 で区切って正解率を出すと、この小さな差が見えにくくなります。AUC は「上がりそうな順に並べられたか」を見るので、小さな手がかりの差もスコアに出ます。
ルール
提出
- 1日に5回まで提出できます。日本時間の0時に回数が戻ります
sample_submission.csvと同じ形(1行目はID,上がる、test.csv の3,000個の ID が1行ずつ)の CSV を提出します。ID の列で正解と結びつけて採点するので、行の並びは自由です- 採点できなかった提出(列の名前が違う・ID が足りない・予測が空など)はエラーになり、回数には数えません
順位表
- 1人1行で、いちばん良いスコアが載ります。名前は、参加するときに決めた名前です(メールアドレスや本名は出ません)
- このコンペは終わりの日を決めていないので、順位表はいつでも今の順位です
- 運営が作った予測(ベンチマーク)のスコアも、「運営」の印つきで並びます。まずは「直近5日の逆張り」を超えるのが目標です
禁止すること
- テストデータの正解を、ほかから手に入れること
- 1人で複数のアカウントを使うこと
- ほかの参加者と、提出のファイルや結果を共有すること(コードや手法の共有はかまいません)
不正が分かったときは、提出やスコアを取り消すことがあります。
データについて このコンペのデータは、スタアカが乱数で作った作り物です。銘柄・会社・値段は実在しません。練習のために、テクニカル指標で見つけられる弱い流れを入れてあるので、本物の株価で同じやり方がうまくいくとは限りません。このコンペは、データ分析を学ぶためのもので、投資をすすめたり助言したりするものではありません。本物の株の売り買いの判断には使わないでください。