交差エントロピーとは?AIの「間違い度合い」を測る公式と計算例を分かりやすく解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では、AIの世界でとても大事な「交差エントロピー(クロスエントロピー)」について分かりやすく解説していきます!意味と公式から、計算例、なぜ分類問題で使われるのかまで見ていきましょう!
こんにちは!ウマたんです!
AIはすごく賢そうに見えますが、実は学び始めのころは、よく間違えます。
たとえば、画像を見て「これは犬?猫?」と聞かれたAIが、「90%の確率で猫だと思う」と答えたとします。
でも、実はその画像が犬だったら、AIの答えは正しくありませんよね。
このとき、AIが「どれくらい間違えているか」を数字で表す方法が必要になります。
その方法のひとつが、今回のテーマ「交差エントロピー」です。

ディープラーニングの本で「損失関数は交差エントロピー」ってよく見るけど、何を計算しているの?

エントロピーって名前が難しそう…。式の意味が知りたい!
本記事では、次の5つを順番に解説していきます。
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!

交差エントロピーとは?
交差エントロピーとは、AIの予測がどれだけ間違っているかを測るための「ものさし」のことです。
英語では「cross entropy(クロスエントロピー)」と呼ばれます。
AIは学習するときに、この交差エントロピーをできるだけ小さくしようと頑張ります。
そうすることで、少しずつ予測の精度を上げていくんです。
なるべく正確な予測ができるように調整していくための「点数」として、交差エントロピーが使われているわけですね。
このように、AIが学習で小さくしようとする「間違いの大きさ」を表す関数は、「損失関数」と呼ばれます。交差エントロピーは、分類問題でもっともよく使われる損失関数です。
 損失関数とは?機械学習で精度の高いモデルを作れるようになろう!当サイト【スタビジ】の本記事では、損失関数について解説していきます!機械学習手法を学ぶ上で非常に重要な考え方なので、ぜひ押さえておきましょう!
当たっているほど小さく、外れているほど大きくなる
猫と犬を分類する問題で、正しい答えが「猫」のときを考えてみましょう。
| AIの予測 | 予測の良さ | 交差エントロピー |
|---|---|---|
| 猫 0.9、犬 0.1 | 正解の猫に高い確率をつけている(良い予測) | 約0.11(小さい) |
| 猫 0.5、犬 0.5 | どちらとも言えない | 約0.69 |
| 猫 0.2、犬 0.8 | 正解の猫に低い確率しかつけていない(悪い予測) | 約1.61(大きい) |
猫に0.9をつけた予測は、交差エントロピーが小さくなり、比較的良い予測ということになります。
一方で、猫に0.2しかつけなかった予測は、交差エントロピーが大きくなり、悪い予測となります。
交差エントロピーは、小さければ小さいほど精度が良い、ということを覚えておきましょう!
交差エントロピーの公式と計算例
では、具体的な公式はどのようになるのでしょうか?
2クラス分類の公式
「1か0か」を当てる問題(2クラス分類)で考えます。
正解ラベルを (1か0)、モデルが出した「1である確率」を とすると、交差エントロピー は次のように書けます。
ここで は、ふつう自然対数(底が の対数)を使います。
式は少しややこしく見えますが、 に1か0を入れてみると、とてもシンプルになります。
| 正解 | 式に入れると | 意味 |
|---|---|---|
| のとき | 「1」につけた確率 だけを見る | |
| のとき | 「0」につけた確率 だけを見る |
つまり、「正解のクラスに、どれだけ高い確率をつけられたか」だけを見ているんです!
計算してみよう
実際に計算してみましょう。
まず、正解ラベル が1で、予測 が0.9の場合です。モデルが「1である確率が高い」と予測していて、それが当たっている状況ですね。
交差エントロピーは約0.1。比較的小さくなりました。
一方で、正解ラベル が1なのに、予測 が0.01の場合。予測がかなり外れてしまっている状況です。
交差エントロピーは約4.6。先ほどと比べて、非常に大きくなったのが分かりますね!
正解のクラスにつけた確率 と、交差エントロピー()の関係をグラフにすると、次のようになります。
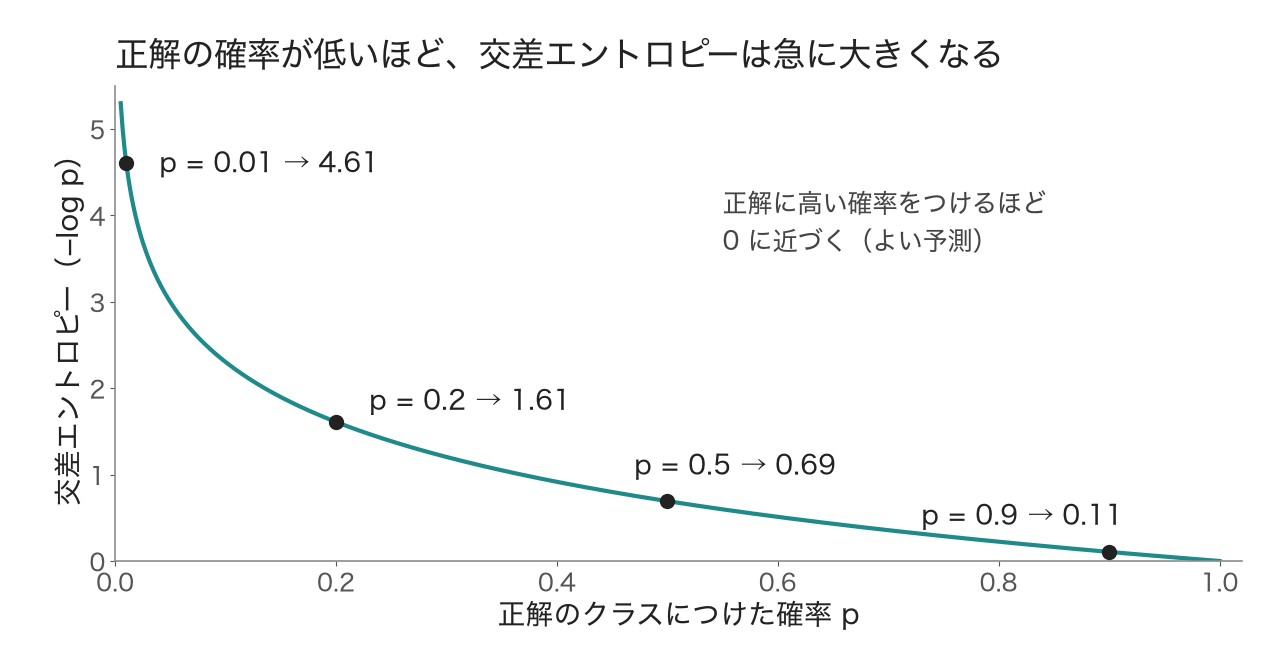
正解に確率1をつけた完璧な予測なら、交差エントロピーは0。
そこから確率が下がるにつれて大きくなり、0に近づくと一気に跳ね上がります。
3クラス以上のときの公式
犬・猫・鳥のように、3つ以上のクラスに分ける問題(多クラス分類)では、次の式を使います。
は、クラス が正解なら1、そうでなければ0。 は、モデルがクラス につけた確率です。
正解のクラスだけ になるので、結局は2クラスのときと同じく、「正解のクラスにつけた確率 の 」を計算していることになります。
| 犬 | 猫 | 鳥 | |
|---|---|---|---|
| 正解() | 0 | 1 | 0 |
| AIの予測() | 0.2 | 0.7 | 0.1 |
この例なら、 です。
ニューラルネットワークでは、最後に「ソフトマックス関数」を通して、各クラスの確率(合計が1)を出すのが定番です。その確率を、この交差エントロピーで評価するわけですね。
 ニューラルネットワークのソフトマックス(softmax)関数についてわかりやすく解説!当サイト【スタビジ】の本記事では、ソフトマックス関数について解説してきます。ソフトマックス関数とは「n個のデータの合計を1にする関数」と定義されています。この関数の使い道としてディープラーニングの活性化関数が挙げられます!今回はソフトマックス関数と活性化関数のつながりについて解説します!
なお、データがたくさんあるときは、1件ずつ計算した交差エントロピーを平均したものを使います。
交差エントロピーが分類問題で使われる理由
実は、AIがどれだけ間違えているかを測る指標は、ほかにも存在します。
その中でも、なぜ分類問題では交差エントロピーが使われるのでしょうか?
自信満々の間違いを、強く罰する
ひとつ目の理由は、「自信満々に間違えたとき」に、とても大きなペナルティを与えられることです。
たとえば、確率の予測を「2乗誤差」で評価した場合とくらべてみましょう。正解が1のとき、2乗誤差は です。
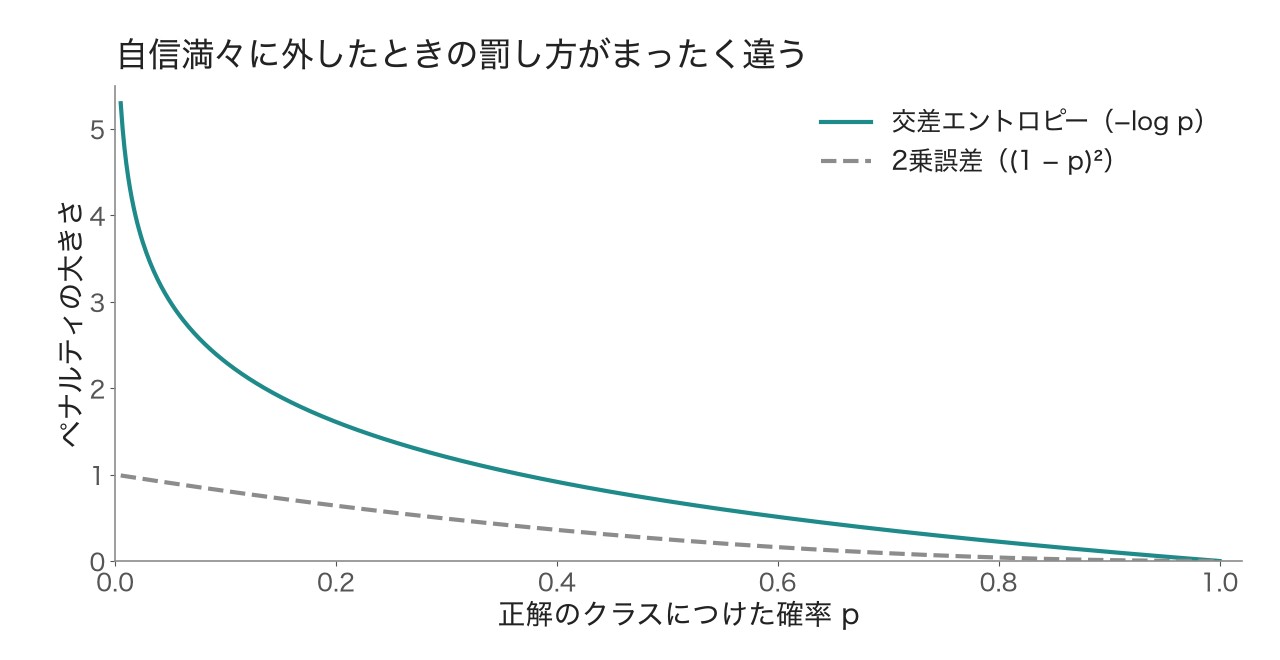
2乗誤差は、正解に確率0をつけるような大外れでも、最大で1にしかなりません。
一方、交差エントロピーは、正解の確率が0に近づくほど、どこまでも大きくなります。
| 正解につけた確率 | 2乗誤差 | 交差エントロピー |
|---|---|---|
| 0.9 | 0.01 | 0.11 |
| 0.5 | 0.25 | 0.69 |
| 0.1 | 0.81 | 2.30 |
| 0.01 | 0.98 | 4.61 |
だからこそ、交差エントロピーで学習したAIは、「とんでもない外し方」をしないように、強く矯正されていくんです。
また、ソフトマックス関数やシグモイド関数と組み合わせると、学習で使う傾き(勾配)が「予測の確率 − 正解」というシンプルな形になり、学習が進みやすいことも知られています。
「最尤法」と同じことをしている
ふたつ目の理由は、統計学の「最尤法(さいゆうほう)」とつながっていることです。
最尤法は、「手元のデータが一番起こりやすくなるように、モデルのパラメータを決める」方法です。
実は、2クラス分類で交差エントロピーを小さくすることは、この最尤法で「尤度(もっともらしさ)」を大きくすることと、数学的に同じなんです。
交差エントロピーを使うのは、統計学的にも筋の通ったやり方というわけですね。
 【例あり】最尤法(最尤推定)についてわかりやすく解説!当サイト【スタビジ】の本記事では最尤法について解説してきます。最尤法とは、観測されたデータからデータから尤度が最大となるパラメータを決定する方法です。最尤法によってパラメータが不明な確率分布に従うデータから、データを尤もよく表せるパラメータを適切に推定することができます。今回は最尤法を例を交えつつ解説していきます。
名前の「エントロピー」と「交差」の意味
ちなみに、「エントロピー」はもともと情報理論の言葉で、「どれくらい予測がつかないか(不確かさ)」を表す量です。
交差エントロピーは、「正解の分布」と「AIの予測の分布」という2つの分布を交差させて、そのずれを測っています。
正解の分布と予測の分布がぴったり一致したときに、交差エントロピーは一番小さくなります。
名前は難しそうですが、やっていることは「正解にどれだけ高い確率をつけられたか」の採点、と覚えておけば大丈夫です!
分類と回帰で使う指標のちがい
交差エントロピーは、犬・猫を判別するようなクラス分類の問題で使う指標だと覚えておきましょう。
逆に、売上の予測のように数値を当てる回帰の問題では、平均2乗誤差(MSE)や平均絶対誤差(MAE)などが使われます。
| 問題の種類 | 例 | よく使われる指標 |
|---|---|---|
| 分類 | 犬か猫か、スパムかどうか、病気かどうか | 交差エントロピー(ログロス) |
| 回帰 | 売上、気温、家の価格 | 平均2乗誤差(MSE)、平均絶対誤差(MAE) |
正解率だけでは見えないものが見える
分類の問題では、「正解率(何%当たったか)」もよく使いますよね。
でも、正解率は「当たったか、外れたか」しか見ていません。
たとえば、正解が猫の画像に対して、猫0.51と予測しても、猫0.99と予測しても、どちらも「当たり」です。
交差エントロピーなら、前者は約0.67、後者は約0.01と、予測の自信の度合いまで含めて評価できるんです。
だからこそ、AIの学習では、細かな改善が数字に表れる交差エントロピーを使い、人が結果を確かめるときには正解率なども合わせて見る、という使い分けがよくされます。
分類・回帰で使われる評価指標については、以下の記事でまとめています。
 機械学習の分類・予測精度における評価指標を徹底解説!当サイト【スタビジ】の本記事では、機械学習を実装する上での評価指標について徹底的にまとめていきます!回帰タスクや分類タスクにおける評価指標について見ていきましょう。評価フェーズや評価における注意点についても解説していきます。
Pythonで交差エントロピーを計算してみよう
それでは最後に、Pythonで交差エントロピーを計算してみましょう!
公式どおりに計算する
まずは、2クラス分類の公式をそのまま関数にしてみます。
import numpy as np

def cross_entropy(y, p):
    """2クラス分類の交差エントロピー(y:正解ラベル0か1、p:1である確率)"""
    return -(y * np.log(p) + (1 - y) * np.log(1 - p))

print(cross_entropy(1, 0.9))   # 正解1に0.9をつけた(よく当たっている)
print(cross_entropy(1, 0.01))  # 正解1に0.01しかつけなかった(大外れ)
0.10536051565782628
4.605170185988091先ほど手で計算した、約0.1と約4.6になりましたね!
scikit-learnで計算する
scikit-learnでは、log_loss という名前で用意されています。交差エントロピーは「ログロス」とも呼ばれるんです。
from sklearn.metrics import log_loss

y_true = [1, 1, 0, 0]          # 正解ラベル
y_prob = [0.9, 0.6, 0.2, 0.4]  # モデルが出した「1である確率」

print(log_loss(y_true, y_prob)) # 4件の交差エントロピーの平均0.33753882862600444件それぞれの交差エントロピー(約0.11・0.51・0.22・0.51)を平均した値が出てきます。
ディープラーニングのライブラリでも、交差エントロピーは損失関数の定番として、最初から用意されています。
交差エントロピーのまとめ
最後に、今回のポイントをおさらいしましょう!
ウマたん要は、交差エントロピーとは「正解にどれだけ自信を持って答えられたか」の採点表なんです!損失関数として見かけたら、「正解の確率の −log をとっているんだな」と思い出してください!
機械学習やディープラーニングを体系的に学びたいのであれば、当メディアが運営するスクール「スタアカ」がオススメです!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる