カテゴリ · 30本
多変量解析
多変量解析の記事の一覧です。回帰分析・主成分分析・因子分析・クラスター分析などの基本の手法から、時系列分析、異常検知、レコメンドまで、RとPythonの実装と一緒に解説しています。
まず読む記事
すべての記事
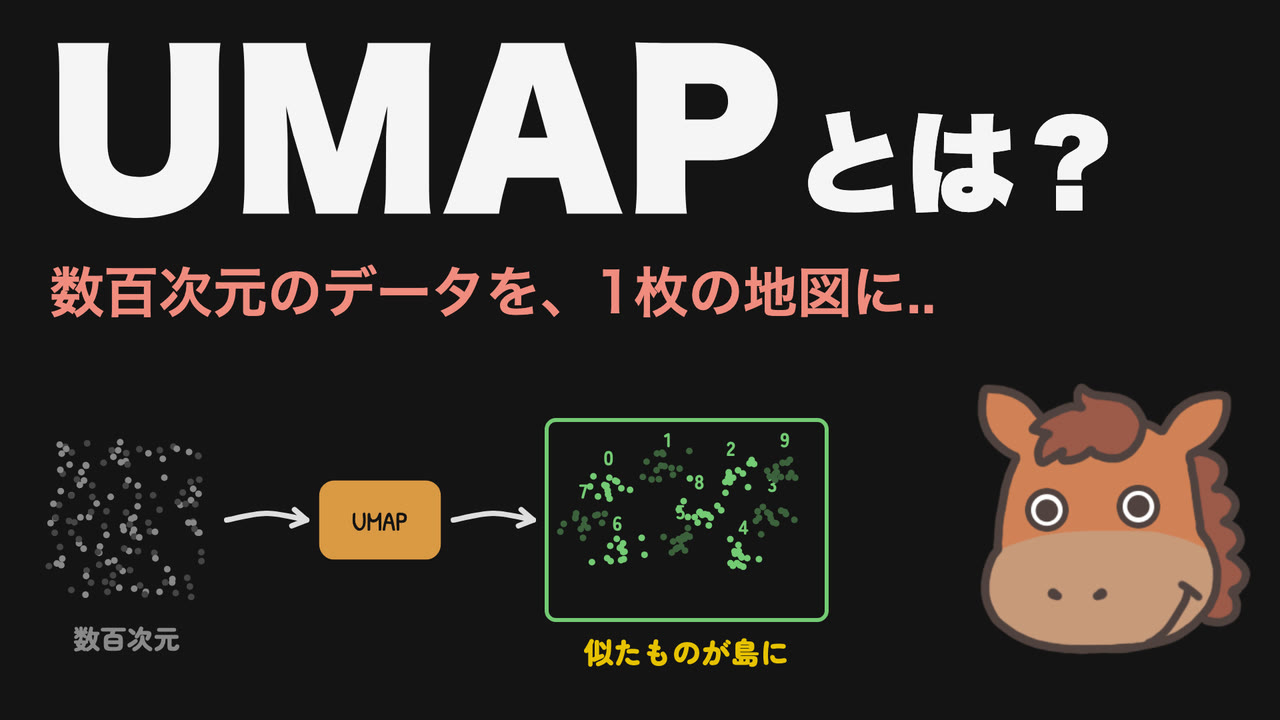
UMAPとは?次元削減の仕組みとt-SNEとの違い、Pythonでの使い方を分かりやすく解説!
UMAPとは、たくさんの次元を持つデータを2次元や3次元の地図にして眺める次元削減の手法です。本記事では、意味や仕組み(近所づきあいを保って並べ直す)、t-SNEとの違い、n_neighbors・min_distの設定のコツと注意点、Python(umap-learn)での使い方を図解で解説します!
次元削減とは?必要な理由と主な手法(主成分分析・t-SNE)のちがいを分かりやすく解説!
次元削減とは、たくさんある特徴量を、できるだけ情報を保ちながら少ない特徴量に圧縮する技術です。本記事では、次元の意味、次元削減が必要な理由、特徴選択と特徴抽出のちがい、主成分分析(PCA)とt-SNEなど主な手法の比較、使われる場面とPythonでの試し方を図解で解説します!

線形計画法についてわかりやすく解説!Pythonでの実装方法も紹介!
当サイト【スタビジ】の本記事では、線形計画法とは何かについて具体例や応用例、さらにはPythonでの実装方法も交えて分かりやすく解説しています!

一般化線形モデルのポアソン回帰をわかりやすく解説しPythonで回帰モデル実装!
当サイト【スタビジ】の本記事では、一般化線型モデルの一種であるポアソン回帰について解説していきます!考え方や活用例を説明した後、Pythonで実装していきます!

異常検知の様々な手法(古典的・機械学習)を紹介しオートエンコーダをPythonで実装していく!
当サイト【スタビジ】の本記事では、異常検知の様々な手法を古典的なものから機械学習領域のものまでいくつか紹介していきます。またその中からオートエンコーダというディープラーニングのアーキテクチャを使った異常検知をPythonで実装していきます!

判別分析についてわかりやすく解説!Pythonで実装してみよう!
当サイト【スタビジ】の本記事では、多変量解析の一種である判別分析について解説していきます!考え方や事例を説明した後、Pythonで実装していきます!

共分散構造分析をわかりやすく解説!Pythonでパス図を出力してみよう!
当サイト【スタビジ】の本記事では、多変量解析の一種である共分散構造分析について解説していきます!考え方や事例を説明した後、Pythonで実装していきます!

因子分析をわかりやすく解説!主成分分析との違いやPythonでの実装方法!
当サイト【スタビジ】の本記事では、多変量解析の一種である因子分析について解説していきます!考え方や主成分分析との違いを説明した後、Pythonで実装していきます!
Box-cox変換を用いて正規分布に従わないデータを解析してみよう!
当サイト【スタビジ】の本記事では、正規分布に従っていないデータの変換に非常に便利なBox-cox変換について見ていきます。パラメトリック手法による解析を行う上ではBox-coxなどデータ構造を変化させるのは有用なのでぜひ学んでおきましょう!
レコメンドに用いられる協調フィルタリングの利点と欠点とは?
当サイト【スタビジ】の本記事では、レコメンドロジックとして様々なところで用いられる協調フィルタリングの仕組みを見ていきたいと思います。そして協調フィルタリングの利点・欠点についてもまとめていきますよ!
コンジョイント分析とは?特徴とRでのやり方を見ていこう!
当サイト【スタビジ】の本記事では、マーケティングにおける消費者調査の分析に使われるコンジョイント分析をカンタンに解説していきます。Rでの実装も合わせておこなっていくので、ぜひ自分の手を動かして実装してみてくださいね!

コレスポンデンス分析とは?Rでのやり方を見ていこう!
当サイト【スタビジ】の本記事では、マーケティングで用いられることの多い統計的手法「コレスポンデンス分析」について簡単に解説していきたいと思います。Rを使えば簡単に実装できるので合わせて実装方法も見ていきますよー!
【5分でわかりやすく解説】k-means法とは?RとPythonで実装してみよう!
当サイト【スタビジ】の本記事では、非階層クラスター分析のk-means法について徹底的に解説していきます。メリットとデメリットがあるので使う際は注意しましょう!x-means法という改良手法も合わせて一緒に見ていきますよー!

教師あり学習と教師なし学習の違いとは?【データサイエンティストが解説】
当サイト【スタビジ】の本記事では、機械学習の基本である教師あり学習と教師なし学習の違いを、回帰・分類・クラスタリングなどの具体例とともにわかりやすく解説します。どちらにも当てはまらない強化学習についても紹介しますよ!
機械学習と統計学/多変量解析の違いについてデータサイエンティストがモノ申す!!
当サイト【スタビジ】の本記事では、データサイエンスの領域の機械学習と統計学の違いについて考察していきます。定義と境界が曖昧な2つの領域ですが、目的の違いを理解しておくことが大事。機械学習は予測精度を上げることを目的とし統計学はデータ構造の把握をすることを目的とします。

欠損値の埋め方を確認して実際にPandasで欠損値補完してみよう!
当サイト【スタビジ】の本記事では、欠損があるデータの解析方法について説明していきます。欠損データ解析は非常に重要ですが知っておくべきことが多いので、まずは全体の概要と方法について理解してもらえたら嬉しいです。最後のパートではPandasで欠損値の補完をしていきますよ!

多変量解析の基礎をRで実装しながら学んでいこう!
当サイト【スタビジ】の本記事では、データの構造把握に役立つ多変量解析について見ていきます。多変量解析とは予測的な観点ではなくあくまで現状データの構造把握に端を発していることが特徴です。Rでの実装も同時に行いながら理解を深めていきましょう!
主成分分析とは?簡単な説明とPythonでの実装!
当サイト【スタビジ】の本記事では、実務の基礎分析にて使われることの多い主成分分析について詳しく見ていきます。最後にはカンタンなPythonでの実装も載せていますのでぜひ参考にしてみてください!

レコメンドで使われる4つのアルゴリズムを簡単に紐解く!
当サイト【スタビジ】の本記事では、レコメンドに用いられる4つのアルゴリズムについて数式は使わずに簡単に解説していきます。レコメンドはどこに向かうのかみたいな議論もしていきたいと思います。果たして完璧なレコメンドはあり得るのでしょうか?

統計モデリングとは何か?線形モデルから階層ベイズまでをわかりやすく解説
当サイト【スタビジ】の本記事では、データを分析する上で非常に重要な統計モデリングという考え方についてまとめていきます。機械学習手法を使えばノンパラメトリックに解析できますが、もし背後に存在する分布を統計モデリングにより正しく推定できたなら爆発的な威力があるんです。