ニューラルネットワークのソフトマックス(softmax)関数についてわかりやすく解説!

目次
 ウマたん
当サイト【スタビジ】の本記事では、ソフトマックス関数について解説してきます。ソフトマックス関数とは「n個のデータの合計を1にする関数」と定義されています。この関数の使い道としてディープラーニングの活性化関数が挙げられます!今回はソフトマックス関数と活性化関数のつながりについて解説します!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
今回はソフトマックス関数について解説していきます!
ソフトマックス関数とは「n個のデータの合計を1にする関数」と定義されています。
ソフトマックス関数はディープラーニングの活性化関数として用いられることが多く、出力値の合計が1なので、出力値はそのまま確率として用いることができる利点があります!
ウマたんソフトマックス関数は非常に重要な概念なので、この記事でしっかり理解していこう!
この記事では、活性化関数とソフトマックス関数の定義、そしてそのつながりについて解説していきます!
以下のYoutube動画でも解説していますのであわせてチェックしてみてください!

活性化関数について解説!
初めにディープラーニングについてあまり知らない方向けに、活性化関数について解説していきます!
活性化関数とは「ニューラルネットワークのニューロンからの入力・出力の合計から、出力を決定する関数」と定義されています。
ニューラルネットワークの基本形として、複数の入力層からの重みづけ総和を活性化関数に通して出力を決定するモデルがよく使われています!
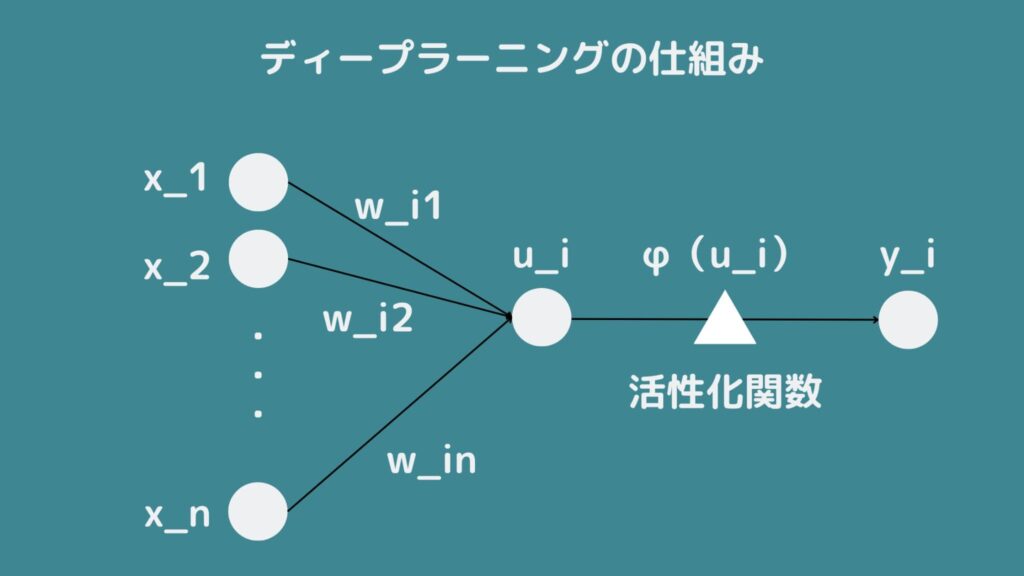
この仕組みを数式化しましょう!まず変数の重み付き線形和がなので、以下のような式が成り立ちます。
そしてに活性化関数を適用させて予想したクラスをとすると…
このような式が成立します。つまりディープラーニングはデータの線形和を活性化関数に適用させたものが予測値となることが分かりましたね!
ディープラーニングでは回帰や分類など様々な問題に適用できますが、活性化関数はそれらの問題に適合するよう選択する必要があります。
特にソフトマックス関数を選んだ場合、多クラス分類問題で用いられることがほとんどであることを覚えておきましょう!
理由として、クラスを予想するために「そのクラスに所属する確率」を用いるため、ソフトマックス関数の性質は非常に都合がよいことが挙げられます!
ニューラルネットワークや活性化関数の仕組みに関しては以下のUdemy講座で詳しく解説しているのでぜひチェックしてみてください!
ソフトマックス関数について解説!
次にソフトマックス関数について解説していきます!ソフトマックス関数は以下の式で表すことができます。
ソフトマックス関数のイメージはこのようになります。
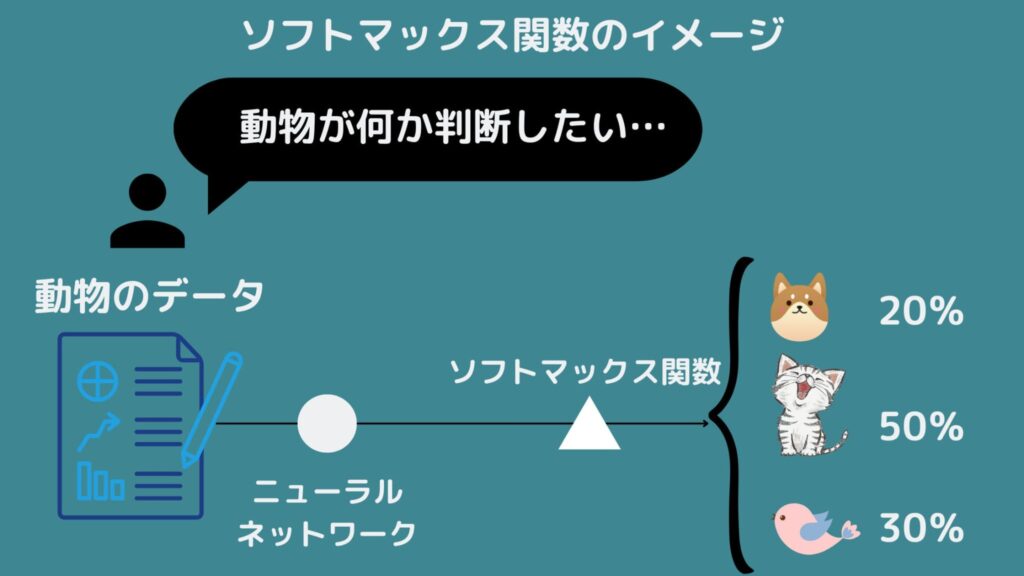
動物が犬・猫・鳥のどれかに判別したい場合、この図を見ると猫である確率が最も高いため、このデータは猫を示している可能性が高いことが分かりますね!
しかし実際にpythonなどでソフトマックス関数を実装すると、オーバフローを起こす可能性があります。
オーバーフローとはメモリの限度を超えて無限と表示してしまう現象を指します。メモリは桁を無限に持つことができない、かつ指数関数は値が大きくなりやすい性質があるため、オーバフローしやすいです。
したがって実装する際はデータの最大値Cを用いることでオーバーフローをできます!
ウマたんもし1からソフトマックス関数を実装するなら、こういったオーバフローに注意して実装しましょう!
ソフトマックス関数を使ったディープラーニングのモデル構築をしてみよう!
ここまでソフトマックス関数について解説してきましたが、最後にソフトマックス関数を活性化関数に使用したディープラーニングのモデルを構築していきましょう!
今回は定番のMnistという手書き文字のデータセットを用いて、Kerasというライブラリを使用して画像認識問題を解いていきます!
Mnistは「Gradient-based learning applied to document recognition」で用いられたデータセットであり、現在でも多くの論文で用いられています。
Modified National Institute of Standards and Technologyの略であり、0~9の数字が手書き文字として格納されているデータセットです。
学習用に60000枚、検証用に10000枚のデータセットが格納されています。
コードは以下のようになります!
import numpy as np
from sklearn.model_selection import train_test_split
import tensorflow as tf
from tensorflow.keras.datasets import mnist
from tensorflow import keras
from tensorflow.keras.layers import Dense, Activation
from tensorflow.keras.models import Sequential
from tensorflow.keras.utils import to_categorical


# Kerasに付属の手書き数字画像データをダウンロード
np.random.seed(0)
(X_train_base, labels_train_base), (X_test, labels_test) = mnist.load_data()

# Training set を学習データ(X_train, labels_train)と検証データ(X_validation, labels_validation)に8:2で分割する
X_train,X_validation,labels_train,labels_validation = train_test_split(X_train_base,labels_train_base,test_size = 0.2)

# 各画像は行列なので1次元に変換→X_train,X_validation,X_testを上書き
X_train = X_train.reshape(-1,784)
X_validation = X_validation.reshape(-1,784)
X_test = X_test.reshape(-1,784)

#正規化
X_train = X_train.astype('float32')
X_validation = X_validation.astype('float32')
X_test = X_test.astype('float32')
X_train /= 255
X_validation /= 255
X_test /= 255

# labels_train, labels_validation, labels_test をダミー変数化して y_train, y_validation, y_test に格納する
y_train = to_categorical(labels_train)
y_validation = to_categorical(labels_validation)
y_test = to_categorical(labels_test)

# パラメータの設定
n_features = 784
n_hidden   = 100
bias_init = 0.1

# 学習率
rate       = 0.01

# Sequentialクラスを使ってモデルを準備する
model = Sequential()

# 隠れ層を追加
model.add(Dense(n_hidden,activation='relu',input_shape=(n_features,)))
model.add(Dense(n_hidden,activation='relu'))
model.add(Dense(n_hidden,activation='relu'))

# 出力層を追加
model.add(Dense(10,activation='softmax'))

# TensorFlowのモデルを構築
model.compile(optimizer=tf.optimizers.Adam(rate),
              loss='categorical_crossentropy', metrics=['mae', 'accuracy'])

# Early stoppingを適用してフィッティング
log = model.fit(X_train, y_train, epochs=3000, batch_size=100, verbose=True,
                callbacks=[keras.callbacks.EarlyStopping(monitor='val_loss',
                                                     min_delta=0, patience=10,
                                                         verbose=1)],
                validation_data=(X_validation, y_validation))

# Test dataで予測を実行。
pred_test = model.predict_classes(X_test)

validation = (pred_test == labels_test)
size       = validation.size
size
correct    = np.count_nonzero(validation)
print(f"{correct}/{size} correct ({correct*100/size:.3f}%)")
以下の部分でモデルを定義していて最終的な出力層の活性化関数としてソフトマックス関数(softmax)が使用されていることが分かりますね!
# Sequentialクラスを使ってモデルを準備する
model = Sequential()

# 隠れ層を追加
model.add(Dense(n_hidden,activation='relu',input_shape=(n_features,)))
model.add(Dense(n_hidden,activation='relu'))
model.add(Dense(n_hidden,activation='relu'))

# 出力層を追加
model.add(Dense(10,activation='softmax'))ちなみに途中の隠れ層ではRelu関数という関数が使用されています。
ソフトマックス関数 まとめ
本記事ではソフトマックス関数についてまとめました!
ディープラーニングについて詳しく知りたい方は、以下の記事をチェックしてみてください!
 機械学習とディープラーニングの違いを分かりやすく解説!当サイト【スタビジ】の本記事では、曖昧に認識されがちな機械学習とディープラーニングの違いについて解説していきます。AI/機械学習/ディープラーニングは色々と混同されがちなのですが、違いと共通点についてここでしっかり理解しておきましょう!
 【初心者向け】ディープラーニングの勉強ロードマップまとめ!当サイト【スタビジ】本記事では、ディープラーニングの学習方法について詳しくまとめていきます!ディープラーニングは難しいと思われがちですが、アルゴリズムは意外とシンプルで実装自体も非常に簡単なんです!Pythonでの実装もおこなっていきますよー!
 ディープラーニングでできることとできないこと!Pythonでの実装例とともに見ていこう!当サイト【スタビジ】の本記事では、ディープラーニングができることとできないことについて適宜Pythonでの実装例をはさみながら解説していきます。何でも出来ると思われがちなディープラーニングについてちゃんと理解しておきましょう!
 【入門】ディープラーニング(深層学習)の仕組みとPython実装のやり方!当サイト【スタビジ】の本記事では、ディープラーニングの仕組みやPythonでの実装方法について解説していきます。ディープラーニングってなんとなくブラックボックスなイメージがあるかもしれませんが、実はシンプルなアルゴリズムなんですよー!
このようなデータサイエンスの力を身に付けるためにはスタビジの記事やスクールを活用すると良いでしょう。
そして僕の経験を詰め込んだデータサイエンス特化のスクール「スタアカ(スタビジアカデミー)」を運営していますので,興味のある方はぜひチェックしてみてください!
AIデータサイエンス特化スクール「スタアカ」
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
データサイエンティストとしての自分の経験をふまえてエッセンスを詰め込んだのがこちらのスタビジアカデミー、略して「スタアカ」!!
当メディアが運営するスクールです。
月額1,280円のライトプランで、統計学から機械学習・生成AIまで全コースが受講し放題です!
プレミアムプランでは、24時間以内の質問対応と現役データサイエンティストとの1on1(30分×4回)を実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
他のスクールのカリキュラムはPythonでの機械学習実装だけに焦点が当たっているものが多く、実務に即した内容になっていないものが多いです。
そんな課題感に対して、実務で使うことの多いSQLや機械学習のビジネス導入プロセスの理解なども合わせて学べるボリューム満点のコースになっています!
Pythonが初めての人でも学べるようなカリキュラムにしておりますので是非チェックしてみてください!
ウォルマートのデータを使って商品の予測分析をしたり、実務で使うことの多いGoogleプロダクトのBigQueryを使って投球分析をしたり、データサイエンティストに必要なビジネス・マーケティングの基礎を学んでマーケティングプランを作ってもらったりする盛りだくさんの内容になってます!
データサイエンスに関する記事はこちら!
 【初心者必見】統計学入門に必要な知識と独学勉強方法を簡単に学ぼう!当ブログ【スタビジ】の本記事では、統計学入門に必要な知識をカンタンにまとめ、それらをどのように効率的に独学で勉強していけばよいかをお話ししていきます。統計学は難しいイメージが少しありますが、学び方をしっかり考えれば大丈夫!
 【データサイエンティスト厳選18冊】データサイエンスを学ぶ上でオススメな本・教材!当ブログ【スタビジ】の本記事では、データサイエンスを学ぶ上でオススメできる本を厳選して紹介していきます。ここではデータサイエンティストになるために習得するスキルをデータサイエンスと称しております。いくつかの観点に切り分けて見ていきます。
データサイエンスを勉強できるスクールやサイトは、ぜひこちらを参考にしてみてください!
 【徹底比較】データサイエンティストになるための学習ができるスクール9選!当サイト【スタビジ】の本記事では、データサイエンティストへの学習ができるスクールを紹介していきます。スクールに通ったからと言ってデータサイエンティストになれるわけではありませんが、データサイエンティストへの基本を着実に固めることは可能です…
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「ディープラーニング」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。