【入門】PySparkとは?使い方を分かりやすく解説!

目次
 ウマたん
当サイト【スタビジ】の本記事では、Pythonで分散処理を行うライブラリ”PySpark”を解説します!ビッグデータや機械学習など大量の演算処理をする時に欠かせない”PySpark”!サンプルコードを見ながら、使い方を学んでいきましょう!
こんにちは!スタビジ編集部です!
AIやデータ分析、自動化などを実現するため、”Python“を使ってWebアプリやサービスを開発する人が増えています。
特にビッグデータの分析や機械学習といった分野で、Pythonを利用する方は多いと思います。
一方でこんな悩みもあると思います。

Pythonで大量のデータを分析すると時間がかかる。。。

プログラムの実行時間を減らして、効率よく機械学習モデルを作成したい!
これらの悩みを解決するのがPythonで分散処理が出来るフレームワーク”PySpark“!
今回はそんな”PySpark“について解説していきます。
ウマたんPySparkの使い方を学んで、効率的なデータ処理を実践していこう!
Pythonについて基礎から体系的に学びたい人は当メディアが運営する「スタアカ」の以下のコースをチェックしてみて下さい。
PySparkについて
まずは”PySpark“について概要をおさえていきましょう
PySparkとは
“PySpark“とは、Apache SparkをPythonで実行できるライブラリで、分散環境でリアルタイムの大規模データ処理が出来ます。
ここで出てくる”Apache Spark“とは「大規模なデータを高速に処理できる分散処理フレームワーク」の一つです。
Apache Sparkの概要図は以下のようになります。
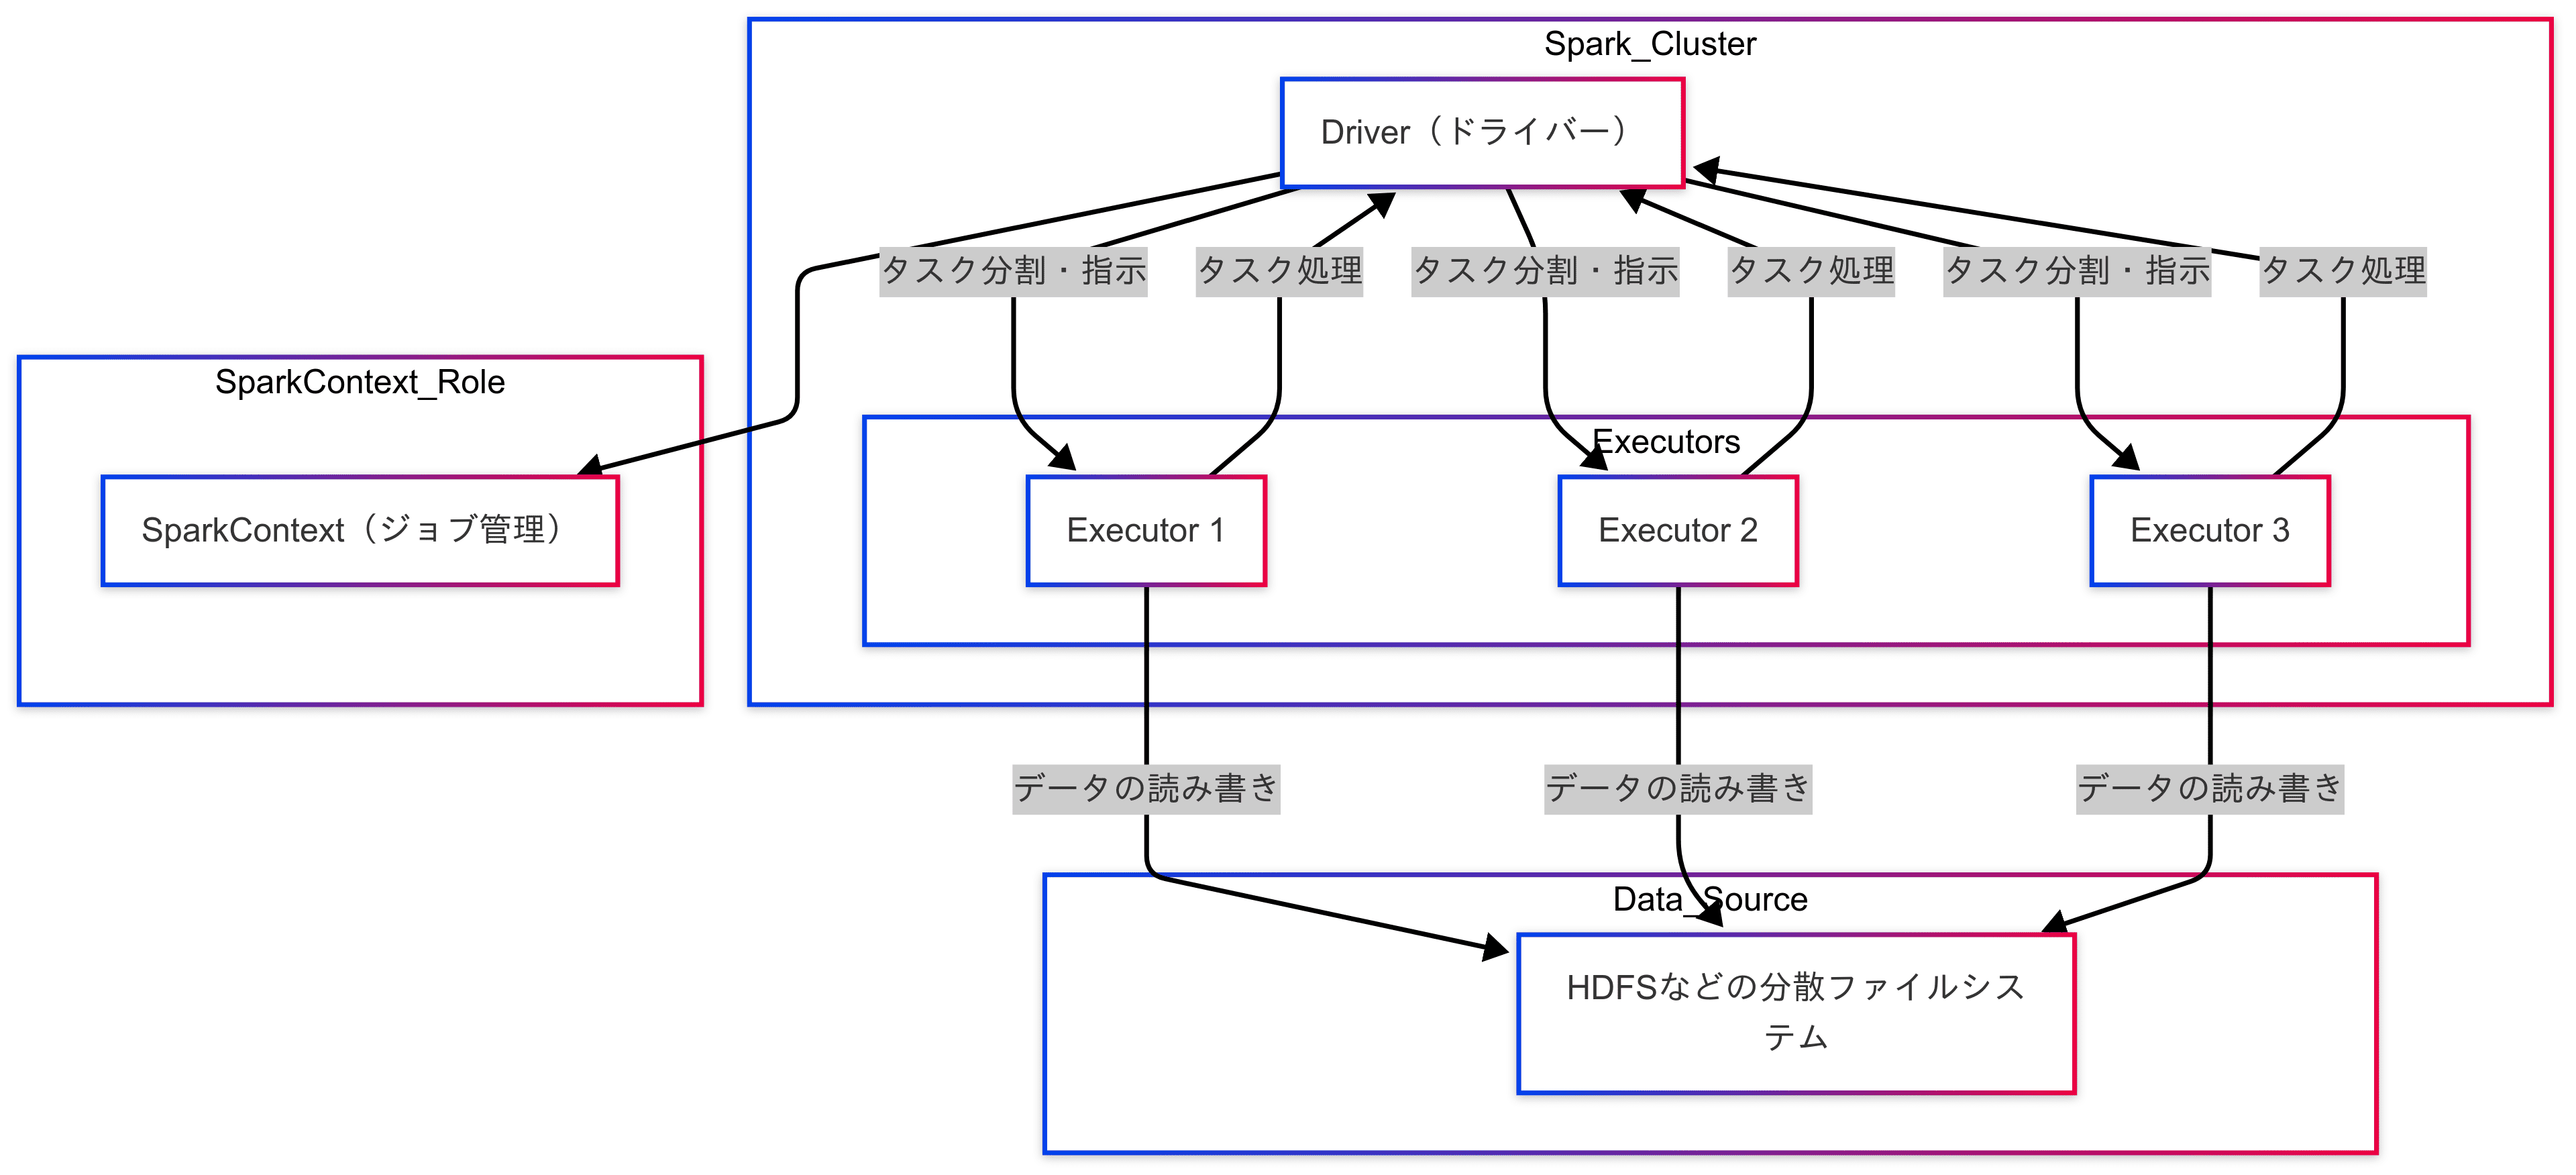
Apache Sparkでは上記のように処理したい大量のデータを分割して、それぞれのノードで並行して処理することで、高速化を実現しています。
このような実行方法を”Spark処理“と呼ばれます。
ウマたんPySparkはこのSpark処理をPython言語で処理できるようにしたライブラリ!
Pythonの高速化テクニックについては以下の記事でまとめているので、参考にしてみて下さい。
 Pythonの高速化テクニックを簡単に学んでいこう!当サイト【スタビジ】の本記事では、Pythonの高速化テクニックについて紹介していきます。Pythonでコーディングをすると処理時間の長さに悩まされることがあります。本記事を読んで、効率よくPythonを実行するスキルを学んでいきましょう!
PySparkの特徴
「PySpark(Spark処理)の特徴」は以下です。
- データを複数のコンピュータ(クラスター)に分散させて処理する
- データをメモリ上に一時的に保管しながら処理を行うため高速
- 数百万〜数億行などの大規模データでも処理可能
- さまざまなデータフォーマット(テキスト、CSV、JSONなど)に対応
Sparkの持つ強力な並列分散処理機能をPythonのシンプルな記述で利用できるため、ビッグデータ分析や機械学習など、データ処理が必要な様々なシーンで広く利用されています
ウマたんPySparkを使うことで大量のデータを高速に処理できるんだね!
PySparkでデータ集計をやってみよう!
ここからは実際にPySparkを使った処理を実装していきます。
今回はPySparkで以下の操作を確認していきます。
本記事でのPythonの作業は「Jupyter Notebook」で行っています。
Jupyter NotebookはWebブラウザ上でPythonプログラムを書いて・実行出来る環境です。
プログラムの実行結果を毎回確認できるので初心者におすすめのツールになります。
Jupyter Notebookについて以下の記事で解説しているので、参考にしてみて下さい。
 【5分で分かる】Jupyter notebookの使い方!インストール方法からPython基礎構文当サイト【スタビジ】の本記事では、本記事では、PythonそしてPythonを簡易的に実行できる環境であるJupyter notebookの使い方について簡単に解説していきます。Pythonを使えると作業を自動化できたり高度なデータ分析が出来たり幅が広がります!ぜひPythonをマスターしましょう!
事前準備
PySparkを使うための事前準備について見ていきましょう。
PySparkではJava環境(JDK)が必要になります。
PySparkの元のApache Sparkが動くJavaのバージョンは、2025年4月時点では”8″、”11″、”17″が対象になります。
詳細は”Apache Spark“のページで対象のJavaのバージョンを確認しましょう。
続いて、PySparkをインストールします。
!pip install pyspark無事インストールされたら以下のコードを実行してみてください
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("DataLoadExample").getOrCreate()ここではPySparkライブラリの読み込みと”SparkSession“の作成を行っています。
“SparkSession“とはPySparkを使ってデータを処理するときに必要な機能にアクセスできるエントリーポイントになります。
先ほどの概要図の”Driver(ドライバー)”に所属するオブジェクトにあたり、SparkSessionを作成することでPython上でSpark機能が利用できるようになります。
ウマたんSparkSessionを作成することで、PySparkを使ったデータ処理を実行する準備出来るってことだね!
データの読み込み・表示
まずはPySparkを使った「データの読み込み・表示」をやってみましょう。
下記コードを実行します。
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName("DataLoadExample").getOrCreate()

# CSVを読み込み
df = spark.read.csv("sample.csv", header=True, inferSchema=True)

# 読み込んだデータを表示
df.show(5)

spark.stop()
csvファイルを読み込んでSparkのDataFrame型として扱います。
パラメータは下記の意味になります。
- spark.read.csv():CSVファイルを読み込む
- header=True:1行目をカラム名として扱う
- inferShema=True:自動的にカラムのデータ型(文字列、整数、など)を推測
上記のコードを見るとPandasの”read_csv()”に似ていますが、Sparkの方は複数コアに処理を分けて(分散処理)いるのが特徴です。
sample.csvファイルの中身と実行結果はこちらになります。
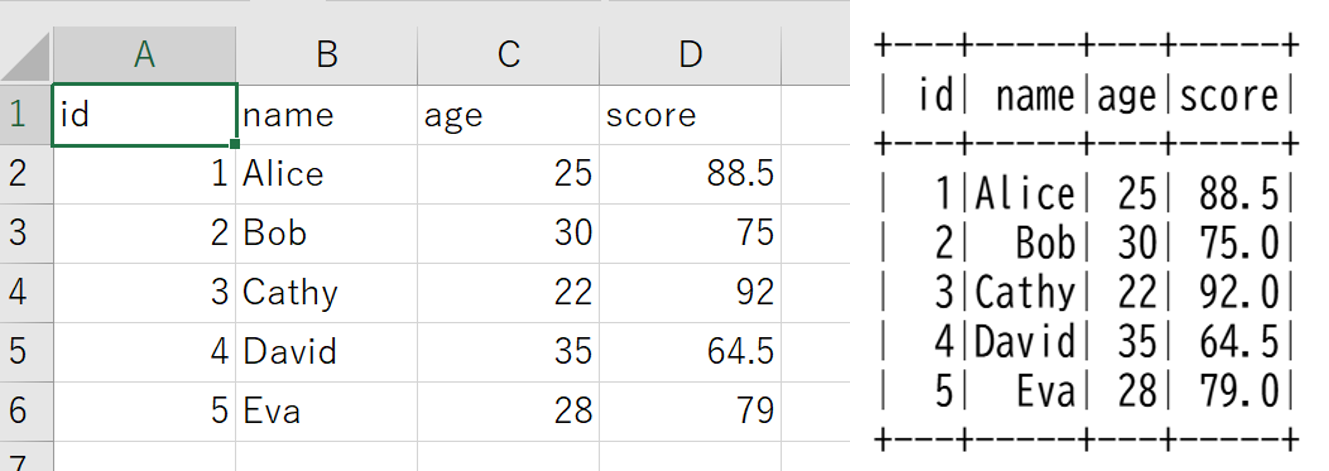
csvファイルの中身のデータを読み込めていますね
また、コードの最後”spark.stop()”でSparkSessionを停止していますが、こちらをコメントアウトして実行してみます。
その後ブラウザで「http://localhost:4040/」を入力して実行すると、”Spark UI“にアクセスできます。
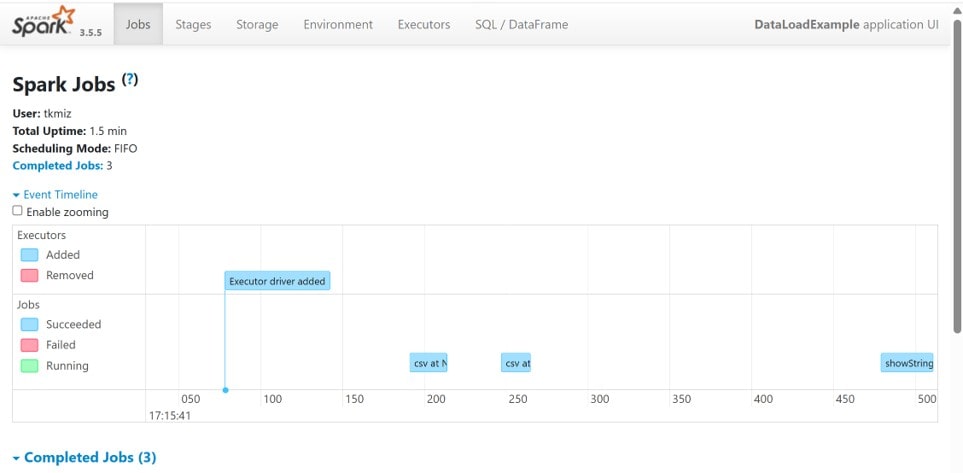
“Spark UI”では以下のことを確認できます。
ここで実際の処理状況を確認できます。
デフォルトでは1スレッドで実行されますが、下記のように”.master()“で実行するスレッド数を指定することも出来ます。
spark = SparkSession.builder.appName("DataLoadExample").master("local[8]").getOrCreate()上記は8スレッドを指定した例になります。
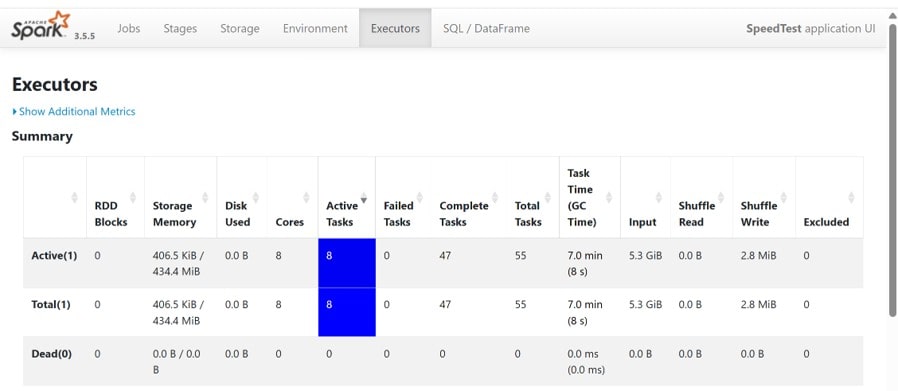
“Executors”を見てみると1つのノードで8タスクが並行して処理されているのがわかります。
他にも「.master(“local[*]”)」とすべてのコアで実行するように指定できるので、PCのスペックに応じて並行処理を試してみて下さい。
確認が終わったら”spark.stop()”でSparkSessionを停止すると良いです。
ウマたんPySparkでもPandasのようにDataFrame型でデータを取得できる!Spark UIでSpark処理の概要を確認できるよ!
Pandasについては以下の記事で詳しく解説しているので参考にしてみて下さい。
 【入門者向け】PythonのPandasの使い方・基本操作について簡単にまとめておく!当サイト【スタビジ】の本記事では、Pythonで頻繁に使われるPandasについて簡単にまとめておきたいと思います!データの読み込みや前処理や集計、可視化などによくつかわれるPandasについてしっかりおさえておきましょう!また最後にはPandasを含めたPythonの基礎文法の勉強方法についてまとめておきますよ!
データの操作
PySparkでは収集した「データの操作」も実行できます。
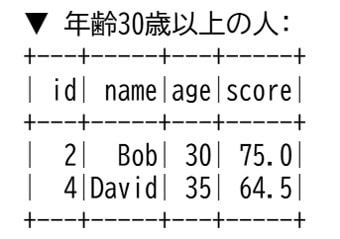
まずは年齢が30歳以上の人をフィルタリングして表示してみます。
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, when

# SparkSessionの作成
spark = SparkSession.builder.appName("AllBasicOperations").getOrCreate()

# CSVファイルの読み込み
df = spark.read.csv("sample.csv", header=True, inferSchema=True)

# ① 年齢が30歳以上の人だけを抽出(フィルタリング)
df_filtered = df.filter(col("age") >= 30)
print("▼ 年齢30歳以上の人:")
df_filtered.show()“pyspark.sql.functions“はPySparkで使える関数を集めたモジュールになり、必要な関数はあらかじめインポートします。
よく使われる関数は以下です。
- col():列(カラム)を指定
- when():条件分岐
- avg():平均
- count():カウント
- concat():複数列を連結
- isnull():欠損値の判定
PySparkのDataFrameでは独自のメソッドを使ってデータを操作します。
“filter“メソッドでは条件に一致する行を抽出できます。
PySparkでよく利用されるDataFrameメソッドは以下になります。
| カテゴリ | メソッド | 説明 |
|---|---|---|
| 基本操作・表示 | show(n) | データの先頭n行を表示 |
| printSchema() | スキーマ(列の型情報)を表示 | |
| columns | 列名一覧を取得 | |
| dtypes | 各列のデータ型を確認 | |
| count() | 行数を取得 | |
| フィルタリング | filter() | 条件に一致する行を抽出 |
| distinct() | 重複行を削除 | |
| 列操作 | select() | 特定の列だけを選択 |
| withColumn() | 新しい列を追加/既存列を更新 | |
| drop() | 列を削除 | |
| 集計・グループ化 | groupBy() | 指定列でグループ化 |
| .agg() | 集計処理 | |
| avg() | 平均 |
また、filterメソッドの中にある”col“関数を使ってで特定の列を指定しています。
これらの記法を活用して、今回は「年齢が30歳以上」を指定してフィルタリングしてみました。
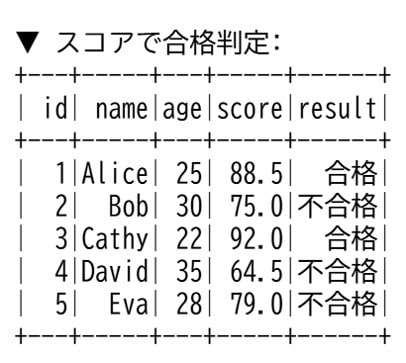
次にデータを追加する操作として、合否の列を追加しスコアが80以上の人を合格、80未満を不合格に分類してみます。
# ② スコアに応じて「合格/不合格」列を追加
df_with_result = df.withColumn(
    "result",
    when(col("score") >= 80, "合格").otherwise("不合格")
)
print("▼ スコアで合格判定:")
df_with_result.show()“when“関数を使うと条件分岐をして”withColumn“メソッドで列を追加します。
実行結果を見ると合格判定の結果が列に追加されているのが確認できます。
ウマたんPySparkでは独自のメソッドや関数を使ってデータ操作が出来る!
SQLクエリの実行
PySparkでは「SQLクエリの実行」してデータをSQL的に扱うことも出来ます。
SQLに慣れている人にはSQLクエリの方が直感的で、複雑な集計や条件処理が簡単に書けるのが魅力があります。
SQLについては下記記事で解説しているので参考にしてみて下さい。
 SQLで覚えるべき書き方はSELECT文だけ!SELECT文とWHERE句・集計関数をマスターしよう!当サイト【スタビジ】の本記事では、SQLでマスターしておきたい基本的な構文SELECT文について見ていきます!SQLでは、基本SELECT文ができて後はそれにWHERE句や集計関数そして他テーブルのJOINなどが出来れば不自由しません!
実際にコードを書いて結果を見てみましょう。
from pyspark.sql import SparkSession

# SparkSessionの作成
spark = SparkSession.builder.appName("SQLWithSampleData").getOrCreate()

# データの読み込み
df = spark.read.csv("sample.csv", header=True, inferSchema=True)

# 一時テーブルとして登録
df.createOrReplaceTempView("students")「createOrReplaceTempView」メソッドで、取得したデータを仮想的な「SQLのテーブル」として登録することが出来ます。
これにより今回のDataFrameを”students”テーブルとしてSQL的に扱えるようにしています。
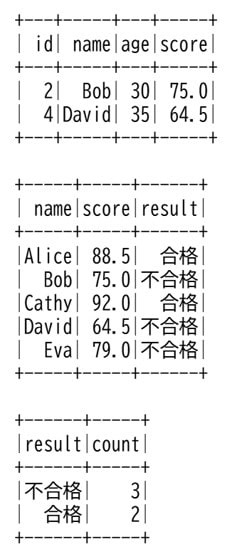
では実際にSQLクエリを実行してみます。
# ① 年齢が30歳以上の人だけを抽出
result = spark.sql("""
    SELECT id, name, age, score
    FROM students
    WHERE age >= 30
""")
result.show()

# ② スコアによって「合格/不合格」を表示
result = spark.sql("""
    SELECT name, score,
           CASE
               WHEN score >= 80 THEN '合格'
               ELSE '不合格'
           END AS result
    FROM students
""")
result.show()

# ③ 合格・不合格ごとの人数を集計
result = spark.sql("""
    SELECT result, COUNT(*) AS count
    FROM (
        SELECT CASE
                   WHEN score >= 80 THEN '合格'
                   ELSE '不合格'
               END AS result
        FROM students
    )
    GROUP BY result
""")
result.show()PySparkでは”spark.sql()“というメソッドでSQLクエリをそのまま実行することが出来ます。
実行結果は下記になります、SQLクエリで意図したデータを抽出出来ていることが確認出来ました。
ウマたんPySparkではSQLクエリを実行することも出来る!条件分岐が多い複雑な処理とかはSQLクエリで書いた方がわかりやすいときがあるから便利!
PySpark まとめ
今回は「PySpark」について見ていきました。
最後にPySparkの特徴をおさらいします。
- データを複数のコンピュータ(クラスター)に分散させて処理する
- データをメモリ上に一時的に保管しながら処理を行うため高速
- 数百万〜数億行などの大規模データでも処理可能
- さまざまなデータフォーマット(テキスト、CSV、JSONなど)に対応
ウマたんPySparkで大量のデータも高速に処理していこう!
また、Pythonを使ってデータ分析をもっと学びたい方は当メディアが運営する教育サービス「スタアカ(スタビジアカデミー)」を以下の講座チェックしてみてください。
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
データサイエンティストとしての自分の経験をふまえてエッセンスを詰め込んだのがこちらのスタビジアカデミー、略して「スタアカ」!!
月額1,280円のライトプランで、統計学から機械学習・生成AIまで全コースが受講し放題です!
プレミアムプランでは、24時間以内の質問対応と現役データサイエンティストとの1on1(30分×4回)を実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
他のスクールのカリキュラムはPythonでの機械学習実装だけに焦点が当たっているものが多く、実務に即した内容になっていないものが多いです。
そんな課題感に対して、実務で使うことの多いSQLや機械学習のビジネス導入プロセスの理解なども合わせて学べるボリューム満点のコースになっています!
Pythonが初めての人でも学べるようなカリキュラムですので是非チェックしてみてください!
ウォルマートのデータを使って商品の予測分析をしたり、実務で使うことの多いGoogleプロダクトのBigQueryを使って投球分析をしたり、データサイエンティストに必要なビジネス・マーケティングの基礎を学んでマーケティングプランを作ってもらったりする盛りだくさんの内容になってます!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「Python基礎」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。