基盤モデル(Foundation Model)とは?LLMとの違いや仕組み、使い方を分かりやすく解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では、今のAIブームを支える「基盤モデル」について分かりやすく解説していきます!LLMとの違いから、仕組み、使い方、注意点まで見ていきましょう!
こんにちは!ウマたんです!
ChatGPTに翻訳をお願いしたり、メールの文章を書いてもらったり、長い資料を要約してもらったり。
1つのAIで、いろんな仕事をこなせるのが当たり前になってきましたよね。
でも少し前までは、翻訳には翻訳用のAI、要約には要約用のAIと、仕事ごとに別々のAIを作るのがふつうだったんです。
この「1つのAIで、いろんな仕事をこなせる」を支えているのが「基盤モデル」です。

基盤モデルとLLMって、同じものじゃないの?

1つのAIで、どうしていろんな仕事ができるのか知りたい!
本記事では、次の4つを順番に解説していきます。
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!

基盤モデルとは?
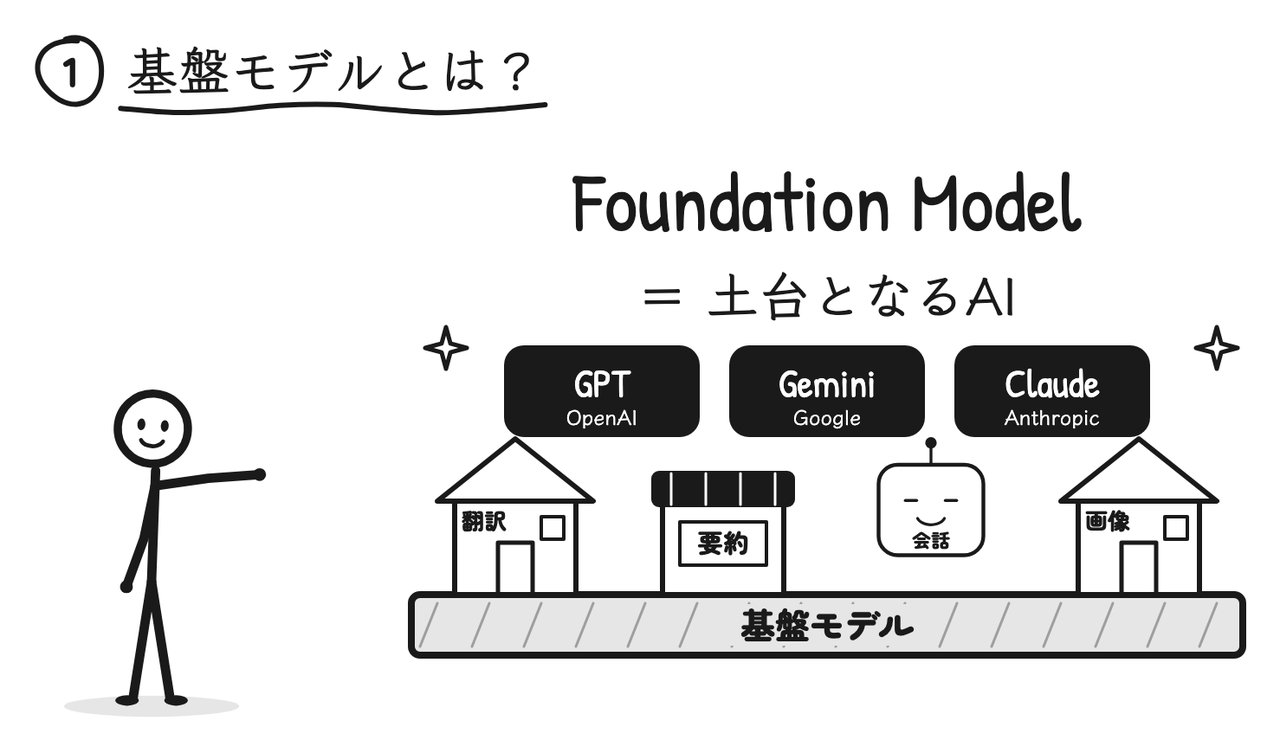
基盤モデルとは、ものすごく大量のデータで学習して、あとからいろいろな仕事に応用できる、土台となるAIのことです。
英語では「Foundation Model(ファウンデーション・モデル)」と呼ばれます。
たとえば、ChatGPTの中にあるGPTや、GoogleのGemini。AnthropicのClaudeなども、まさにその代表なんです!
| 基盤モデル | 開発元 | 使えるサービスの例 |
|---|---|---|
| GPT | OpenAI | ChatGPT |
| Gemini | Geminiのアプリ、Googleのサービス | |
| Claude | Anthropic | Claudeのアプリ |
どれも、1つのモデルで、翻訳・要約・会話・プログラミングなど、いろんな仕事をこなしてくれますよね。
「土台」と呼ばれる理由
では、なぜ「土台」と呼ばれるのでしょうか?
これまでのAIは、翻訳なら翻訳用、要約なら要約用と、仕事ごとに一から作ることが多くありました。
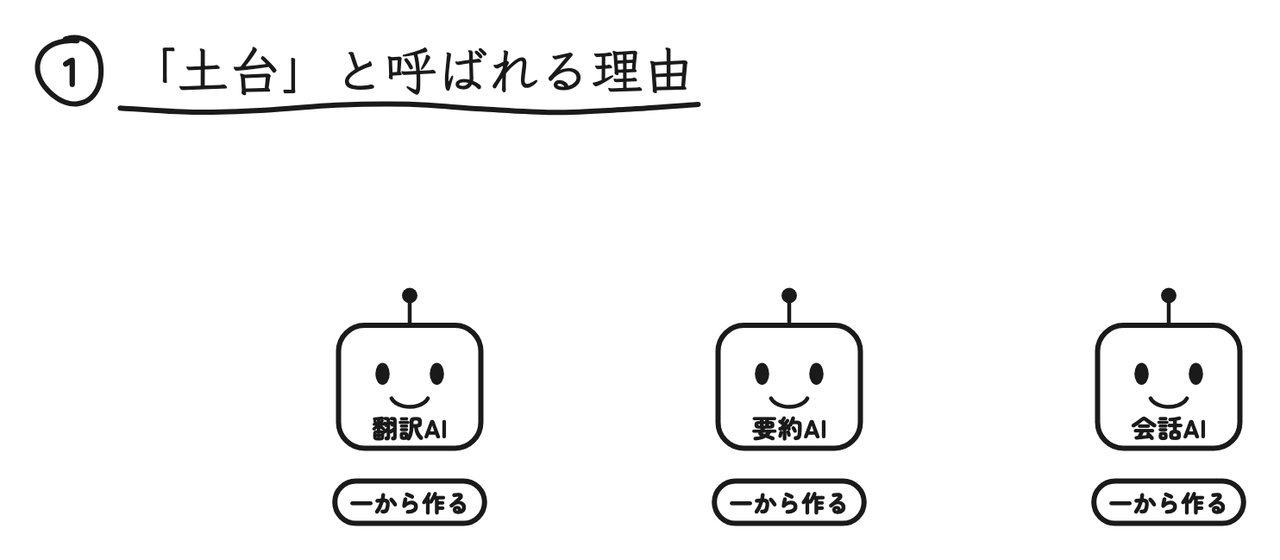
仕事ごとに、正解つきのデータを大量に集めて、一から学習させる。新しい仕事が出てきたら、また一から作り直す。これでは、時間もお金もかかってしまいます。
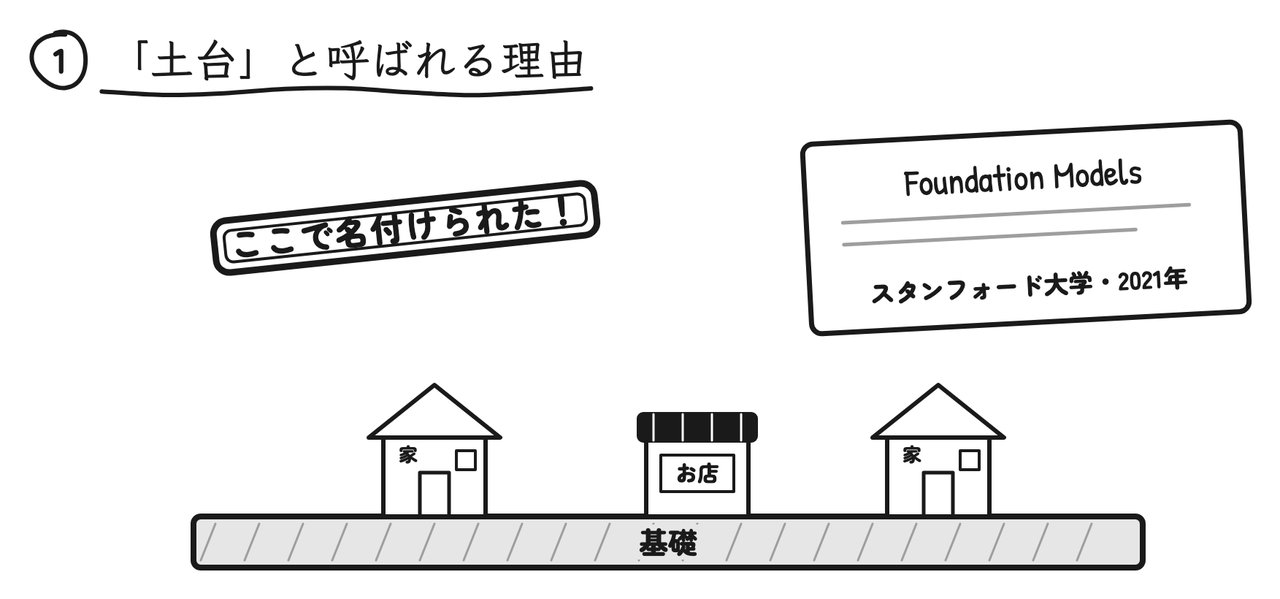
基盤モデルはその逆で、まず何でもこなせる大きな土台を1つ作り、その上にいろいろな仕事を乗せていきます。
たとえるなら、家の基礎工事。
しっかりした基礎が1つあれば、その上にお店も、家も、建てられますよね。
| これまでのAI | 基盤モデル | |
|---|---|---|
| 作り方 | 仕事ごとに一から作る | 大きな土台を1つ作って、いろんな仕事に使い回す |
| 必要なデータ | 仕事ごとに、正解つきのデータを大量に | 土台は正解なしの大量のデータで学び、仕事ごとには少しのデータで済む |
| 新しい仕事への対応 | また一から作る | 指示を変えたり、追加で学習させたりして対応する |
この「基盤モデル」という呼び名は、2021年に、スタンフォード大学の研究者たちが論文の中で名付けたものなんです!
論文のタイトルは「On the Opportunities and Risks of Foundation Models(基盤モデルの可能性とリスクについて)」。100人以上の研究者が名を連ねた、とても長い論文です。
タイトルのとおり、便利さ(可能性)だけでなく、リスクについても最初から論じられていたのがポイントです。このリスクの話は、後半の注意点で出てきます。
基盤モデルとLLMの違い
それでは、LLMとの違いを見ていきましょう!
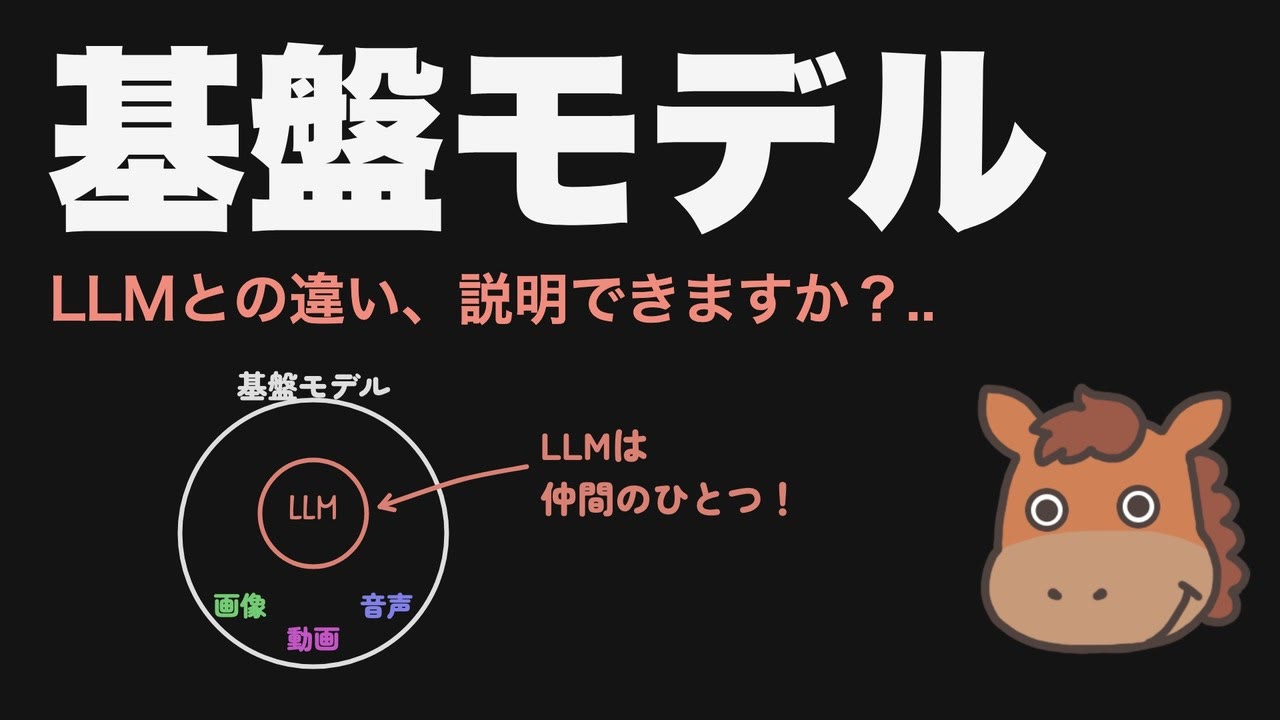
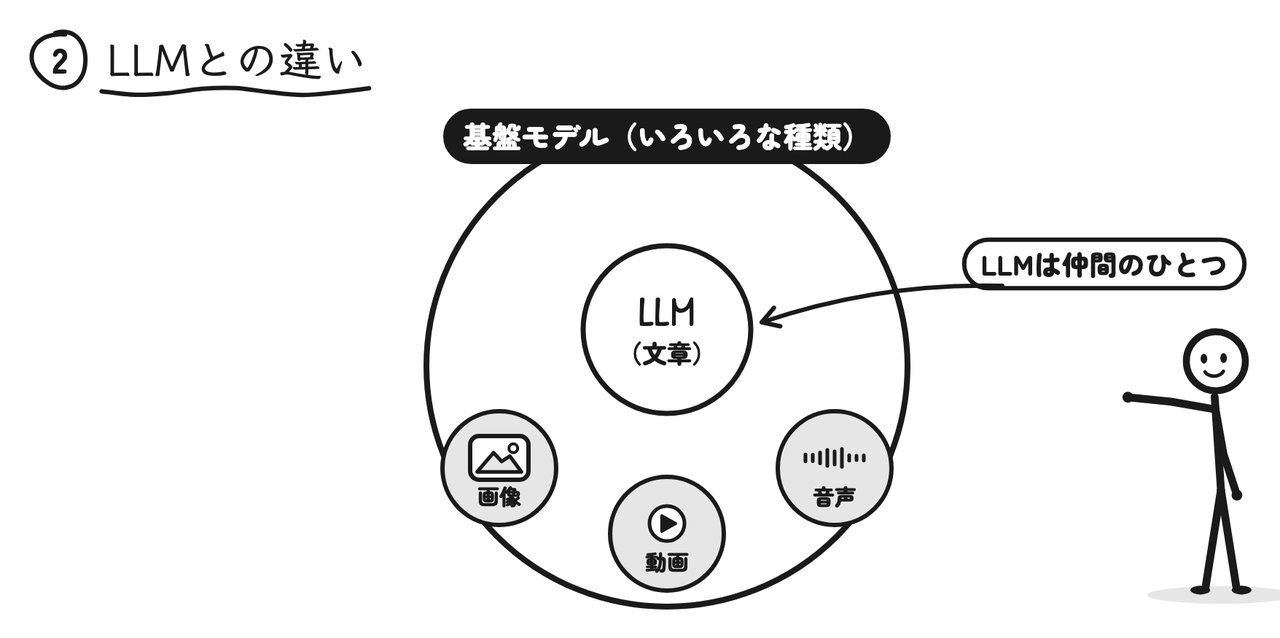
LLM、つまり大規模言語モデルは、文章を扱うことに特化したAIです。
一方で基盤モデルは、文章だけでなく、画像や音声、動画なども含めた、もっと広いくくり。
つまり、LLMは、基盤モデルの仲間のひとつ、ということなんです!
| 基盤モデル | LLM(大規模言語モデル) | |
|---|---|---|
| 扱う情報 | 文章・画像・音声・動画など | 文章 |
| くくりの大きさ | 広いくくり | 基盤モデルの仲間のひとつ |
| 例 | 文章のモデル、画像を作るモデル、音声を文字にするモデルなど | 文章を読んだり書いたりするモデル |
冒頭の「基盤モデルとLLMって、同じものじゃないの?」の答えは、「LLMは基盤モデルの一種」ということになります。
LLMの仕組みや種類については、以下の記事で詳しく解説しています。
 大規模言語モデル(LLM)の仕組みや種類について分かりやすく解説!当サイト【スタビジ】の本記事では、大規模言語モデル(LLM)の仕組みや種類について分かりやすく解説していきます。ChatGPTなどの大規模言語モデルの基本を理解してこのAI時代の流れに乗り遅れないようにしましょう!
ちなみに、最近のGPTやGeminiは、文章だけでなく、画像や音声もまとめて扱えるようになっています。こうしたAIは「マルチモーダルAI」と呼ばれます。
 マルチモーダルAIとは?文字・画像・音声をまとめて理解する仕組みを分かりやすく解説!マルチモーダルAIとは、テキスト・画像・音声・動画など複数の種類の情報をまとめて扱えるAIのことです。本記事では、意味や仕組み(ベクトル・ネイティブマルチモーダル)、できること・ビジネスでの活用例、使うときの注意点を図解で分かりやすく解説します!
生成AIとの違い
もうひとつ、よく似た言葉に「生成AI」があります。
生成AIは、文章や画像、音声などを「作る」AIのこと。作るものに注目した呼び方です。
一方で基盤モデルは、いろんな仕事の「土台になる」AIのこと。使われ方に注目した呼び方です。
ChatGPTのような生成AIのサービスの多くは、基盤モデルの上に作られています。ただし、基盤モデルの中には、写真の中のものを切り分けるモデルのように、何かを作るわけではないものもあります。
| 言葉 | 注目しているところ | 例 |
|---|---|---|
| 基盤モデル | いろんな仕事の土台になること | GPT、Gemini、Claude、写真を切り分けるモデル |
| LLM | 文章を扱うこと | GPT、Claude など |
| 生成AI | 文章や画像などを作ること | ChatGPT、画像を作るAI |
呼び方の切り口がちがうだけで、同じAIが3つすべてに当てはまることもよくあります。
いろいろな基盤モデル
実際、基盤モデルにはいろいろな種類があります。
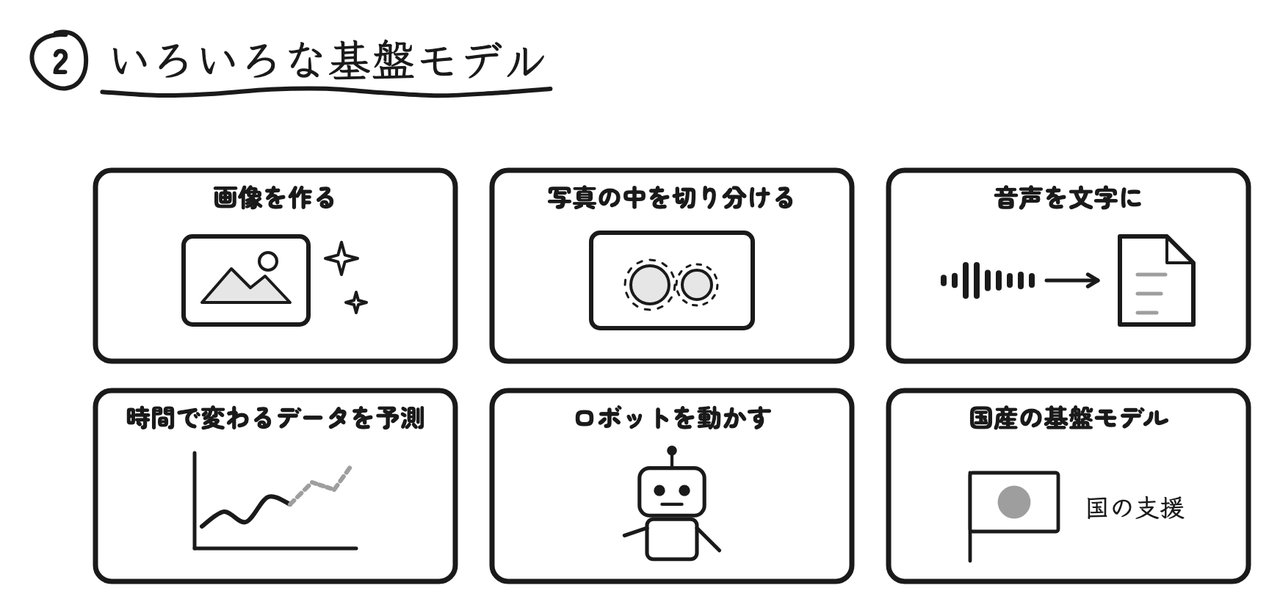
画像を作るモデルや、写真の中のものを切り分けるモデル。
音声を文字にするモデルや、売上や天気のように、時間で変わるデータを予測するモデル。
さらに最近は、ロボットを動かすための基盤モデルの開発も進んでいます。
| 種類 | 何をする? | 代表的な例 |
|---|---|---|
| 画像を作る | 文章から画像を作る | Stable Diffusion など |
| 写真の中を切り分ける | 写真に写ったものを、ものごとに切り分ける | MetaのSAM(Segment Anything Model) |
| 音声を文字にする | 話した声を文字に起こす | OpenAIのWhisper |
| 時間で変わるデータを予測する | 売上や天気などの先の動きを予測する | GoogleのTimesFM |
| ロボットを動かす | カメラの映像や人の指示から、ロボットの動きを決める | Google DeepMindのRT-2 など |
どれも、大量のデータで学んだ土台を、いろんな場面に使い回せるのが共通点です。
そして日本でも、国の支援のもとで、国産の基盤モデルづくりが進められているんです!
経済産業省とNEDOが進める「GENIAC」という取り組みでは、国内の企業や研究機関が基盤モデルを開発するのを支援しています。日本語や日本の事情に強いモデルを、自分たちの手で作れるようにするためです。
基盤モデルの仕組みと使い方
続いて、基盤モデルの仕組みと使い方を見ていきましょう!
大量のデータで「下地」をつくる
基盤モデルは、まずネット上の文章や画像など、膨大なデータを読み込みます。
このとき、人が一つずつ正解をつけるのではなく、データ自身から問題を作って学ぶのがポイント。
たとえば、文章の一部を隠して「ここに入る言葉は何?」と当てる練習を、数えきれないほどくり返すんです。
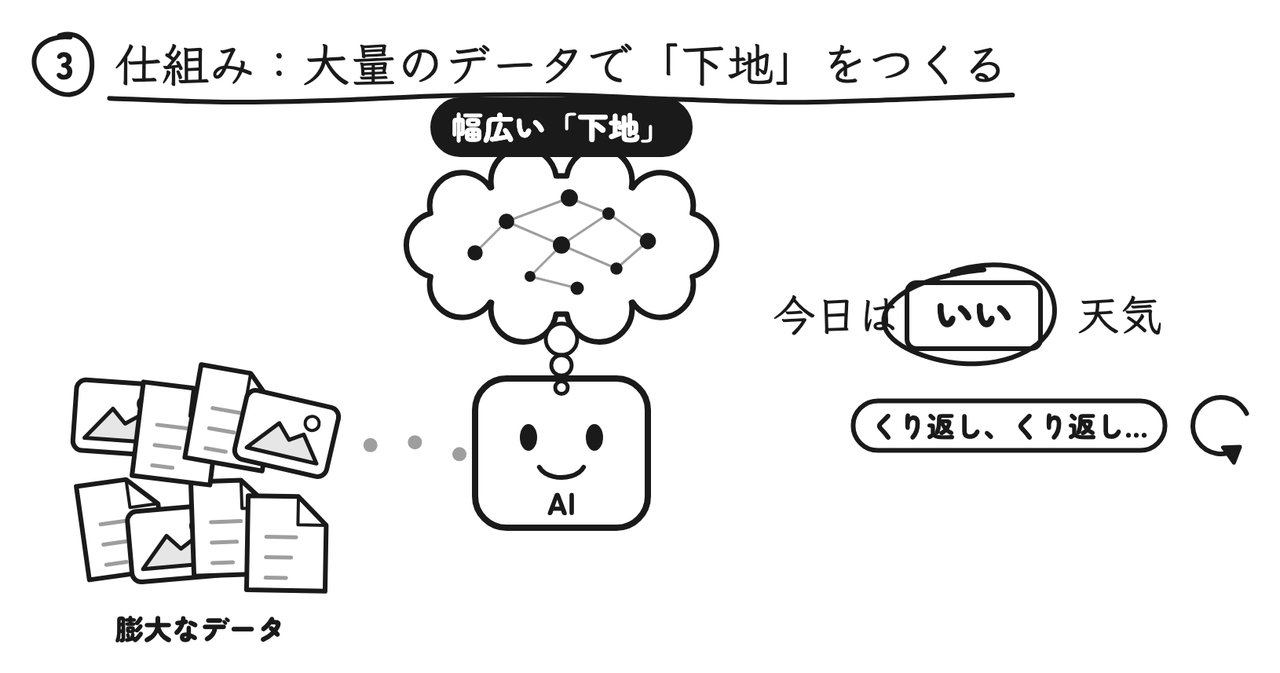
「今日は__天気」の__に入るのは、「いい」かもしれないし、「悪い」かもしれない。
前後の文章がヒントになるので、うまく当てるには、言葉のつながり方や、世の中の物ごとについての知識が必要になります。
こうした穴埋めをくり返すことで、言葉や物ごとについての、幅広い「下地」が身につくんです!
このように、データ自身から問題を作って学ぶ方法は「自己教師あり学習」と呼ばれます。人が正解をつけなくていいので、ネット上の膨大なデータをそのまま学びに使えるわけです。
また、この最初の大がかりな学習のことを「事前学習」と呼びます。
| 練習のしかた | 例 | 代表的なモデル |
|---|---|---|
| 穴埋め | 「今日は__天気」の__を当てる | BERT |
| 次の言葉を当てる | 「今日はいい」の次に来る言葉を当てる | GPT |
ChatGPTのもとになっているGPTは、「次に来る言葉を当てる」練習をくり返して学んでいます。どちらも、正解をデータの中から自分で作れるのが共通点です。
大きくするほど賢くなる
基盤モデルが一気に広がった背景には、「大きくするほど賢くなる」ことが分かってきた、という流れがあります。
2017年に、Googleの研究者たちが「Transformer」という仕組みを発表しました。大量のデータを、たくさんのコンピューターで並べて一度に学習させやすい仕組みです。
さらに2020年ごろには、学習に使うデータの量、モデルの大きさ、計算の量を増やすほど、性能が上がりやすいことが研究で示されました。これは「スケーリング則」と呼ばれています。
そこで、とにかく大量のデータで、とにかく大きなモデルを学習させる流れが生まれました。こうしてできた大きなモデルが、いろんな仕事の土台として使えることが分かってきたわけです。
土台を仕事に合わせる3つの方法
この土台を、それぞれの仕事に合わせて使います。
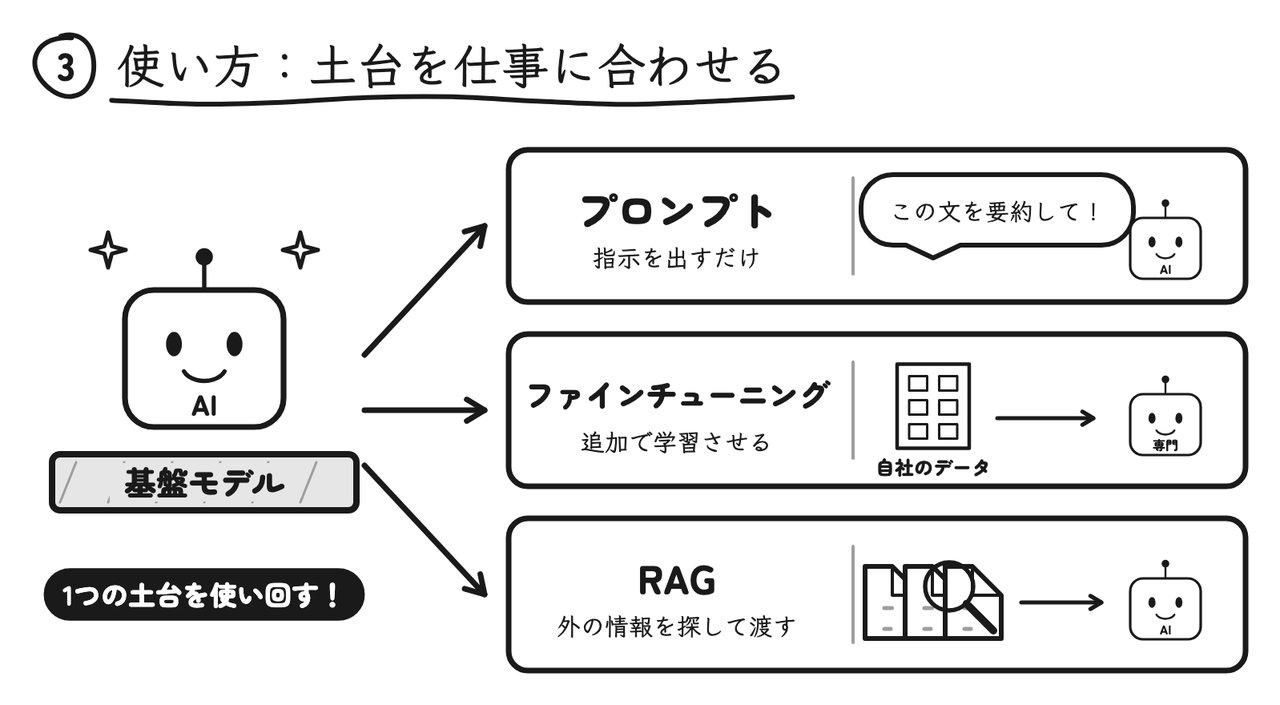
1つ目は、指示を出すだけで使う方法。チャットで頼むように、プロンプトで仕事をお願いします。指示と一緒に「こういう入力には、こう答えてね」という例をいくつか見せると、答えの形をそろえやすくなります。
2つ目は、追加で学習させる方法。ファインチューニングと呼ばれ、自社のデータで、専門の仕事に強くできます。
3つ目は、外の情報を探して渡す方法。RAG(検索拡張生成)と呼ばれ、社内の資料などをもとに答えさせることができます。
| 方法 | やること | 向いている場面 | 手間 |
|---|---|---|---|
| プロンプト | 指示を出すだけ | まず試したいとき、ふだんの仕事 | 小さい |
| ファインチューニング | 自社のデータで追加学習させる | 専門の言い回しや、決まった形式に強くしたいとき | 大きい(データと計算が必要) |
| RAG | 社内の資料などを探して渡し、それをもとに答えさせる | 最新の情報や、社内だけの情報をもとに答えさせたいとき | 中くらい(探す仕組みを用意する) |
たとえば、社内の問い合わせに答えるAIを作るなら、次のように使い分けられます。
1つの土台を、いろんな仕事に使い回せる。これが基盤モデルの最大の強みなんです!
ファインチューニングとRAGは、以下の記事でPythonでの実装と一緒に解説しています。
 ファインチューニングと転移学習の違いやChatGPTをPythonでファインチューニングする方法!当サイト【スタビジ】の本記事では、話題のAIで重要なファインチューニングについて解説していきます。ファインチューニングと同じく色々なところで聞かれる転移学習と混同されていることが多いのでそちらについても言及していきます!またPythonを使って実際にChatGPTのファインチューニングも行います。
 生成AI・LLM時代必須のRAG(検索拡張生成)について解説!Pythonで実装してみよう!当サイト【スタビジ】の本記事では、生成系AI・LLM時代におさえておきたいRAGについて解説していきます!社内用チャットボットなどを作る際によく利用されるアプローチです。どんなアプローチなのか理解した後は実際にPythonで簡単な実装をしていきます!
基盤モデルのメリットと注意点
最後に、基盤モデルのメリットと注意点です。
メリット:少ないデータと手間で、いろんなAIをすぐに作れる
メリットは、少ないデータと手間で、いろいろなAIをすぐに作れることです。
たとえば以前は、問い合わせを種類ごとに分けるAIを作るだけでも、正解つきのデータを大量に用意して、一から学習させる必要がありました。
今は、基盤モデルに「この問い合わせを、請求・不具合・その他に分けて」と指示を出すだけで、ある程度の分類ができてしまいます。
土台がしっかりしているので、その上に新しい家を建てるのは、あっという間なんです。
注意点①:土台の弱点やかたよりが、上のAIすべてに受けつがれる
一方で、注意点もあります。
まず、土台に弱点やかたよりがあると、その上に作ったAIすべてに、同じ問題が受けつがれてしまうことです。
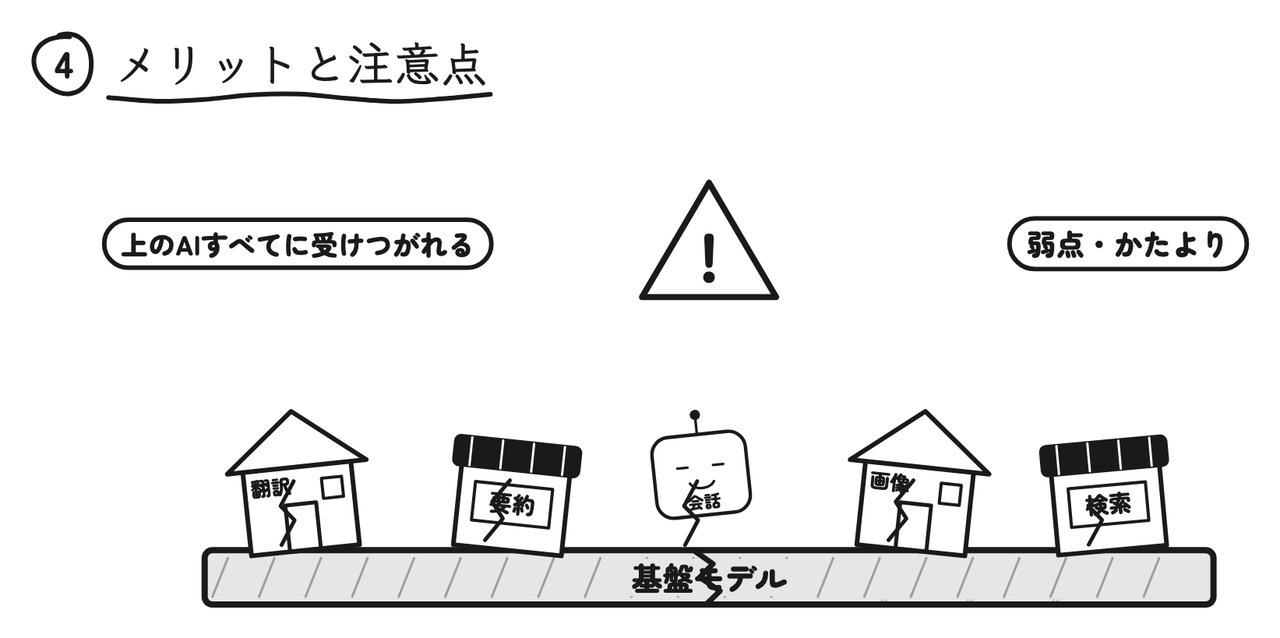
たとえば、学習データの中に、特定の性別や国についての思い込みがかたよって含まれていると、それが答えにも出てしまうことがあります。
もっともらしいウソをつく「ハルシネーション」のような弱点も、土台が持っていれば、その上に作ったAIでも起こります。
便利な土台を多くのAIが共有しているからこそ、土台にひびが入ると、影響が一気に広がるんです。さきほどのスタンフォード大学の論文でも、このように多くのAIが同じ土台にそろっていくことを「均質化(homogenization)」と呼び、リスクのひとつとして取り上げています。
注意点②:作るのにばく大な計算とお金がかかる
それに、基盤モデルを一から作るには、ばく大な計算とお金がかかります。
大量の高性能なコンピューターを長い時間動かす必要があるので、作れる会社が限られてしまうことも課題なんです。
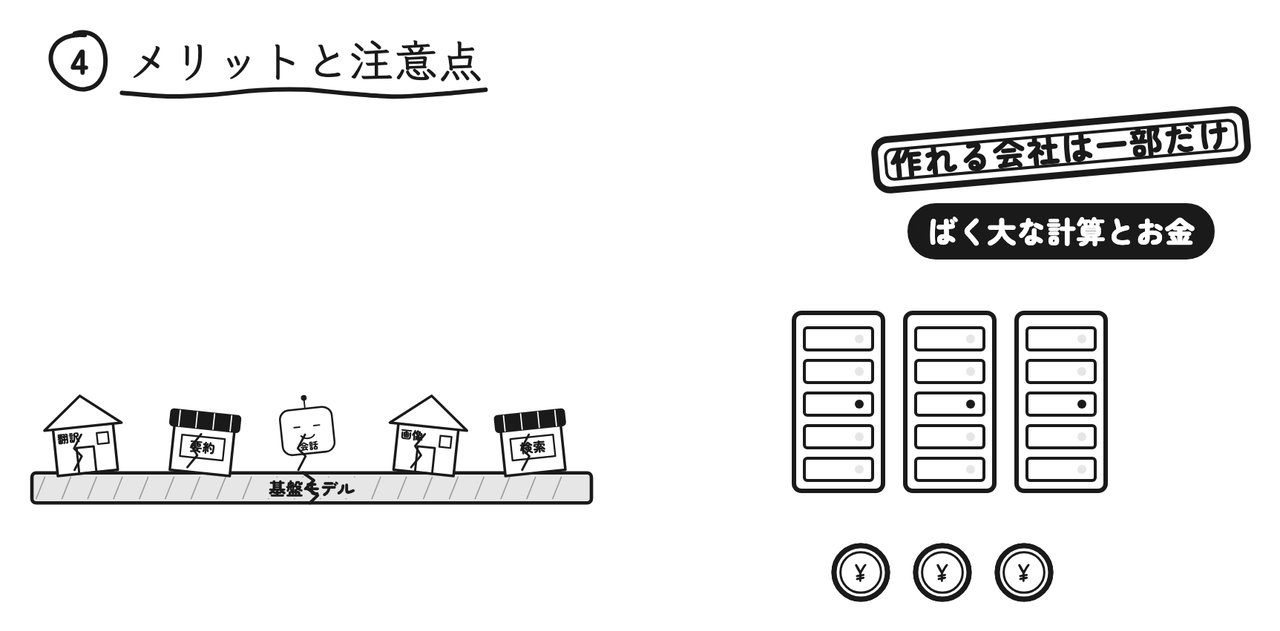
そのため多くの会社は、基盤モデルを一から作るのではなく、できあがった基盤モデルをAPIで借りたり、公開されているモデルを使ったりして、その上に自分たちのAIを作っています。
日本で国産の基盤モデルづくりを支援しているのも、土台を一部の海外の会社だけに頼らないようにするためです。
| 内容 | |
|---|---|
| メリット | 少ないデータと手間で、いろいろなAIをすぐに作れる |
| 注意点① | 土台の弱点やかたよりが、その上に作ったAIすべてに受けつがれる |
| 注意点② | 一から作るにはばく大な計算とお金がかかり、作れる会社が限られる |
基盤モデルのまとめ
最後に、今回のポイントをおさらいしましょう!
ウマたん要は、基盤モデルは、今のAIブームを支える「土台そのもの」なんです!ぜひ、普段使っているAIの裏側にある基盤モデルにも、注目してみてください!
生成AIやデータサイエンスを体系的に学びたいのであれば、当メディアが運営するスクール「スタアカ」がオススメです!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる