大規模言語モデル(LLM)の仕組みや種類について分かりやすく解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では、大規模言語モデル(LLM)の仕組みや種類について分かりやすく解説していきます。ChatGPTなどの大規模言語モデルの基本を理解してこのAI時代の流れに乗り遅れないようにしましょう!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
テキスト生成系のAIのChatGPTや画像生成系AIのStable Diffusionをはじめとする様々な生成系AIの登場でAIブームが訪れました。
その中でもChatGPTなどの大規模なテキストを学習した生成系AIモデルを大規模言語モデル(LLM)と呼び注目を集めています。
この記事では、そんな大規模言語モデル(LLM)について分かりやすく解説していきたいと思います!
Youtube動画でも分かりやすくまとめているので是非チェックしてみてください!

RAGについて、こちらの記事も合わせてご活用ください!
 生成AI・LLM時代必須のRAG(検索拡張生成)について解説!Pythonで実装してみよう!当サイト【スタビジ】の本記事では、生成系AI・LLM時代におさえておきたいRAGについて解説していきます!社内用チャットボットなどを作る際によく利用されるアプローチです。どんなアプローチなのか理解した後は実際にPythonで簡単な実装をしていきます!
大規模言語モデル(LLM)とは?仕組みは?
まずは大規模言語モデル(LLM:Large Language Model)がどんなモデルなのか?どんな仕組みなのか見ていきましょう!
大規模言語モデル(LLM)は最近になってよく聞くようになりましたが、それ自体は古くから存在する自然言語処理分野の派生でしかありません。
 ロボたん
昔からある分野の延長線上なんだね!
ウマたんそうなんだよー!ここ数年で大きなブレイクスルーがあったんだけどね!
昔から人間の言葉をどのように機械に理解させて翻訳や言語生成など様々なタスクに応用させるかは盛んに研究されてきました。
そんな中、2017年にTransformerというモデルの登場によるブレークスルーと計算機のマシンパワー向上により多くのデータをモデルに学習させて著しく精度を上げることができるようになったことで大規模言語モデル(LLM)が生まれました。
話題になったChatGPTのGPTとはGenerative Pretrained Transformerの略であり、Transformerに事前に大量のテキストデータを学習させたモデルを表しています。
これを起点に大規模言語モデルの戦国時代の幕開けとなったのです。
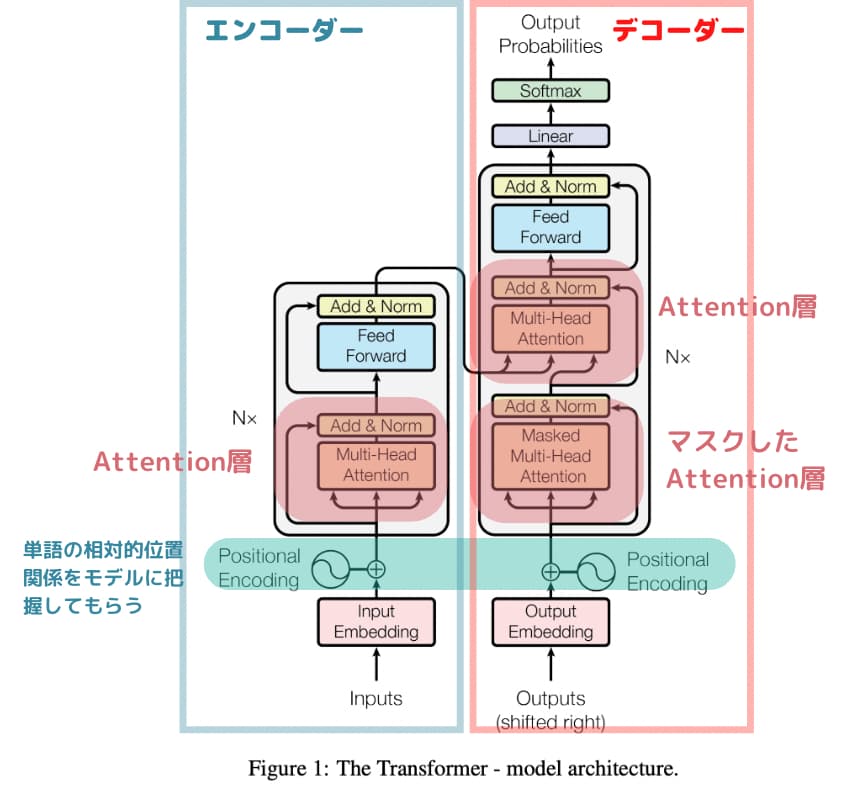
大規模言語モデル(LLM)のアーキテクチャは基本的にTransformerのアーキテクチャを踏襲しています。
例えばテキストデータは、
的な文章を入れてあげて、
単語分割した後にそれぞれの単語をマスクして
みたいなことをやって学習してくれるので人間がわざわざラベル付けをする必要がなく大量のテキストデータを与えてあげることで文脈や言葉の意味が学習してくれるのです。
そして学習した結果から、AIが特定の言葉の後に確率的に続きそうな言葉を並べているのが大規模言語モデル(LLM)なのです。
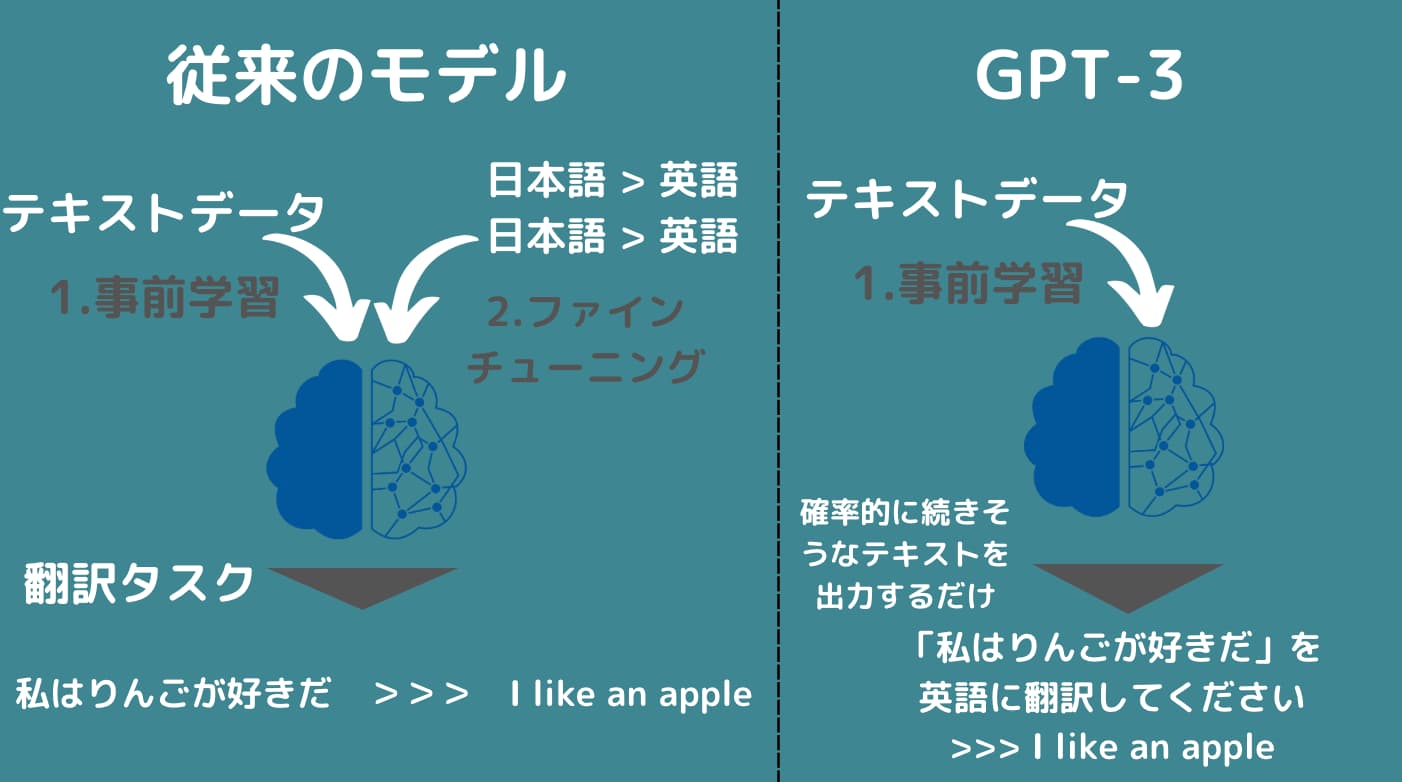
そして、昨今の大規模言語モデルのすごいところは特定タスクに対してチューニング(ファインチューニング)をする必要なく、テキスト(プロンプト)による指示のみで翻訳や要約などのタスクを行えるところです。
今までだと
などのように各タスクに分かれているのが一般的だったのですが、昨今の大規模言語モデル(LLM)では、プロンプトで「翻訳してー!」「要約してー!」と言うだけでそれぞれのタスクに対応した答えが返ってくるようになっています。
LLMのように、大量のデータで学んで色々な用途に使える土台のAIは「基盤モデル」と呼ばれます。くわしくは以下の記事で解説しています。
 基盤モデル(Foundation Model)とは?LLMとの違いや仕組み、使い方を分かりやすく解説!基盤モデル(Foundation Model)とは、大量のデータで学習し、いろいろな仕事に応用できる土台となるAIのことです。本記事では、LLMとの違い、いろいろな種類、仕組みと使い方(プロンプト・ファインチューニング・RAG)、メリットと注意点を図解で解説します!
大規模言語モデル(LLM)の種類一覧
さて、それではそんな大規模言語モデル(LLM)にはどんな種類があるのでしょうか?見ていきましょう!
Transformer
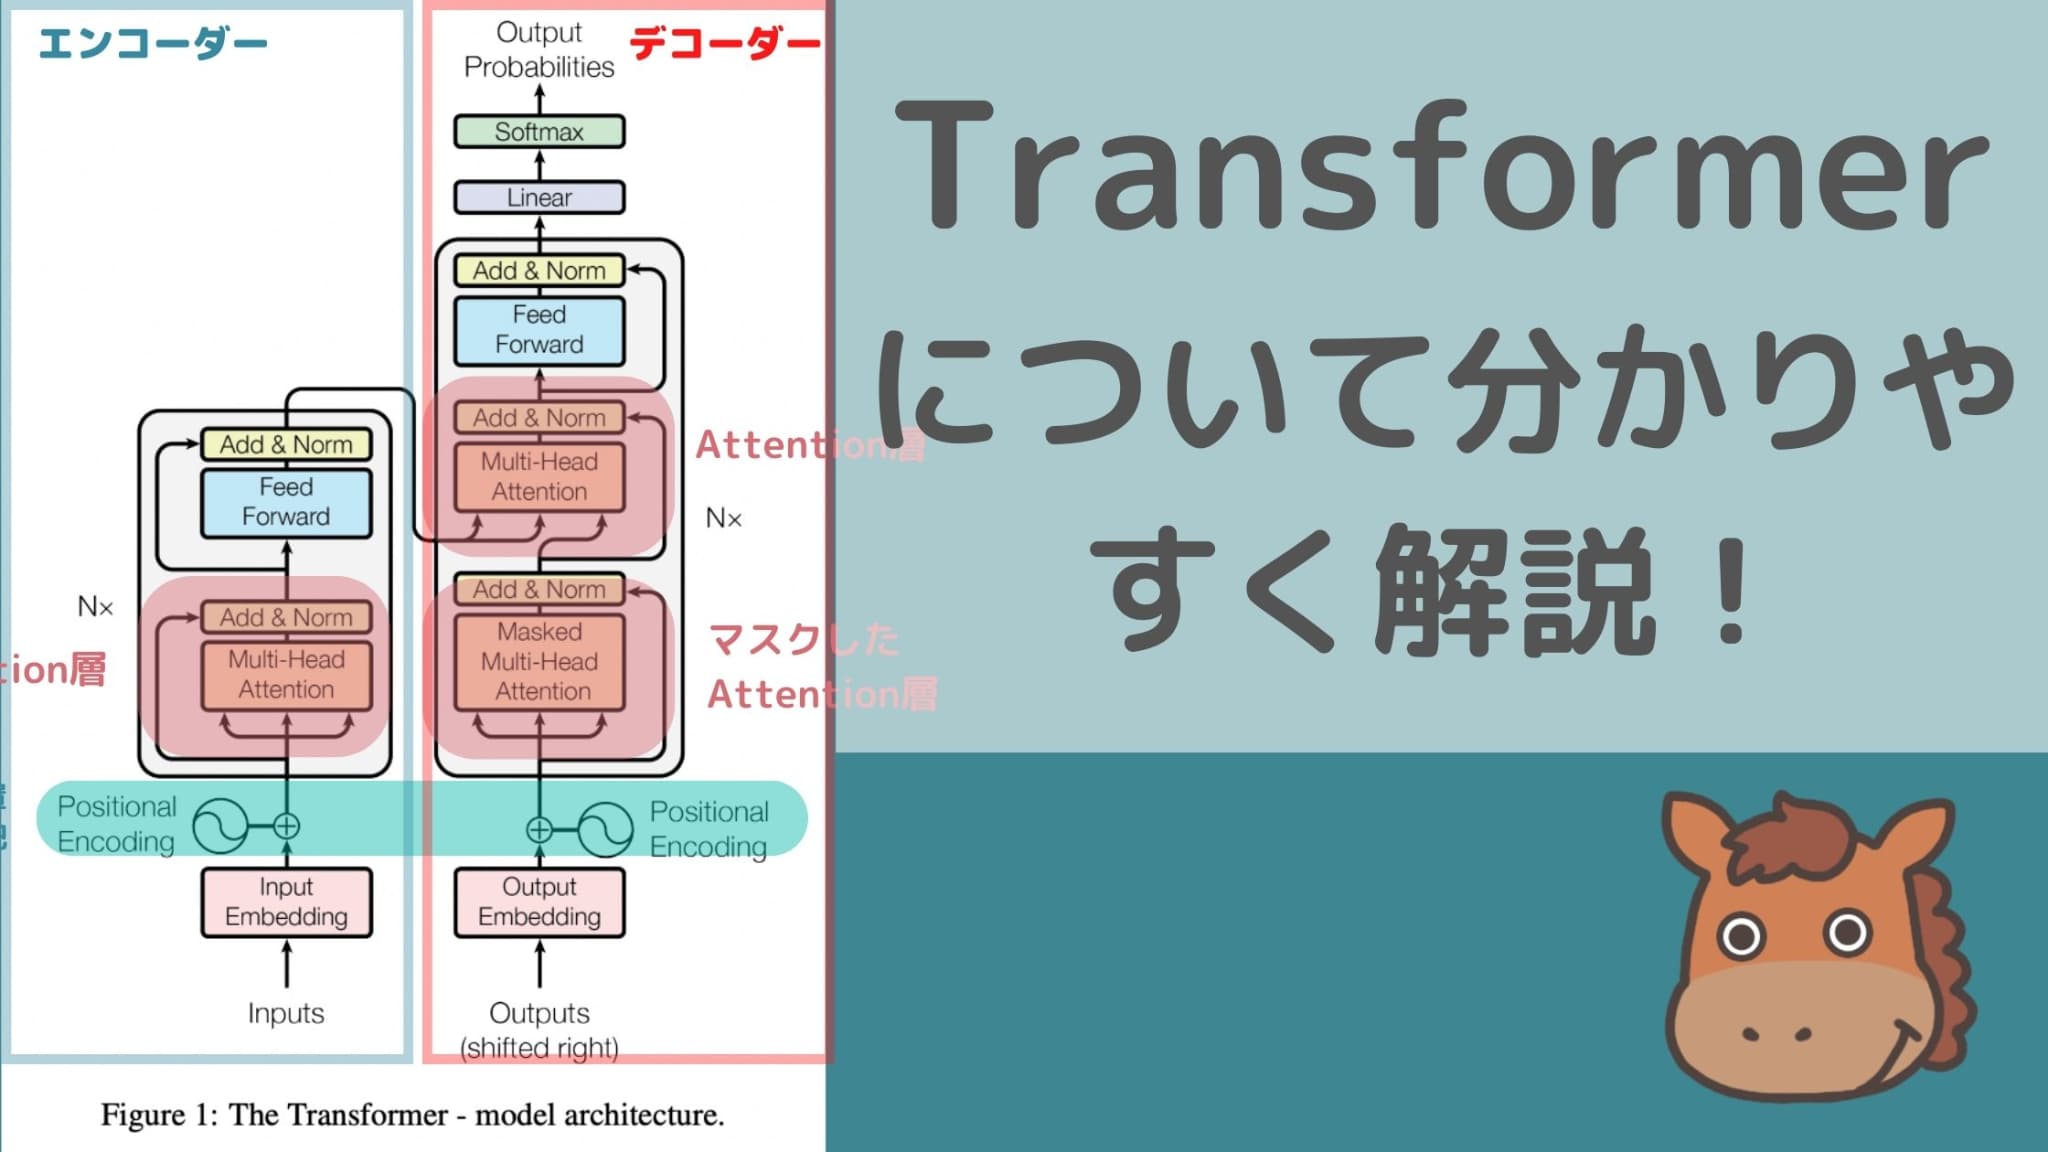
Transformerは大規模言語モデル(LLM)につながるきっかけになったニューラルネットワークアーキテクチャです。
Transformerとは、「Attention Is All You Need」という論文で2017年に発表されたディープラーニングのモデルです。
以下、「Attention Is All You Need」の引用になります。
The dominant sequence transduction models are based on complex recurrent or convolutional neural networks that include an encoder and a decoder. The best performing models also connect the encoder and decoder through an attention mechanism. We propose a new simple network architecture, the Transformer, based solely on attention mechanisms, dispensing with recurrence and convolutions entirely.
引用元:Google- “Attention Is All You Need”
どんなことを言っているかというと従来のリカレントニューラルネットワークや畳込みニューラルネットワークで利用されていたリカレント層や畳み込み層を使わずにAttention層だけを使うようにしたらなんか精度がめっちゃ良くなったよ!ということです。
「Attention Is All You Need」とは、その言葉通りAttention層だけでいいんだよ!ってことです。
そう、Transformerのすごいところは、今までのRNNやCNNなどの従来のディープラーニングで当たり前に考えられていたReccurent層や畳み込み層を使わずにAttention層だけを使うようにしたということなんです!
そこからBERTやGPTなどの新しい手法の登場につながっています。
Transformerに関しては以下の記事に詳しく解説していますので是非チェックしてみてください!
Transformer(トランスフォーマー)をAI進化の流れと共にわかりやすく解説!Attention層に至るまで当サイト【スタビジ】の本記事では、昨今のAIブームのベースとなっているTransformer(トランスフォーマー)について簡単に解説していきたいと思います!Transformerはディープラーニングの進化をブレークスルーさせた技術なんです
BERT
BERTは2018年10月にGoogleからリリースされたモデルで、論文にはこのように記載されています。
BERT is conceptually simple and empirically powerful. It obtains new state-of-the-art results on eleven natural language processing tasks
(引用元:Google-“BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding”)
BERTはシンプルでありながら非常に強力で一般的な11つの言語処理指標において優位な結果を収めたと・・
実はBERTは事前学習モデルであり他の既存モデルと組み合わせることで効果を発揮するものなんです。
BERTとは「Bidirectional Encoder Representations from Transformers」
BERTは、双方向から文脈を学習できるようになったのです。
BERTに関しては以下の記事に詳しく解説していますので是非チェックしてみてください!
 【Pythonで実装】BERTの使い方を解説!日本語モデルを使って予測をしてみようー!当サイト【スタビジ】の本記事では、Googleが新たにリリースしたBERTについてSEO的観点とデータサイエンス的観点で解説し、日本語モデルを使って実際に文章の予測を行っていきます!BERTはPythonで簡単に実装できるんですよー!ぜひ試してみてくださいね!
GPTシリーズ
続いてChatGPTで有名になったGPTモデル!
GPTモデルとはどのようなアルゴリズムになっているのでしょうか?
簡単に見ていきましょう。
GPTの論文はOpenAIから2018年に発表されました。
we explore a semi-supervised approach for language understanding tasks using a combination of unsupervised pre-training and supervised fine-tuning. Our goal is to learn a universal representation that transfers with little adaptation to a wide range of tasks.
引用元:“Improving Language Understanding by Generative Pre-Training”
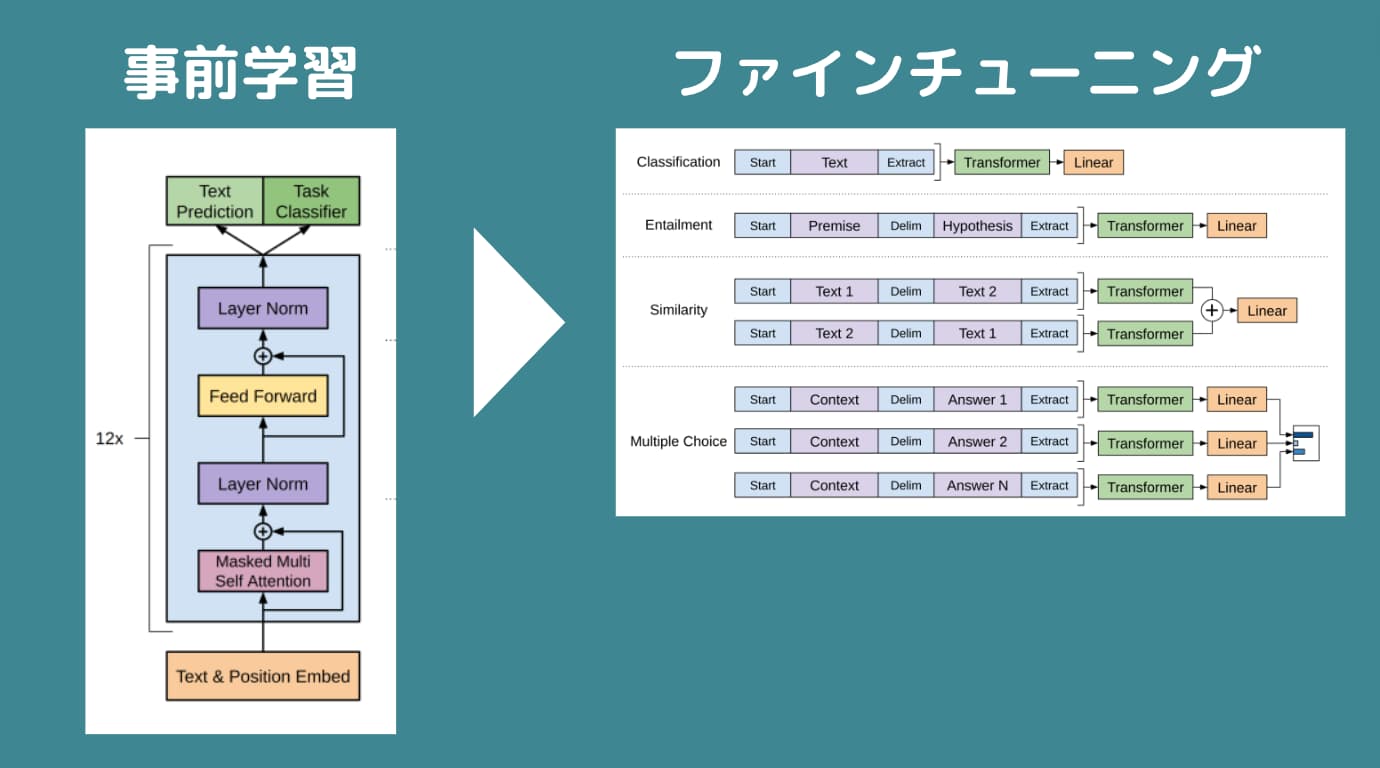
GPTは、大規模なテキストデータを事前学習した後にファインチューニングと呼ばれる各タスクに適した学習をしていく2段階のモデルです。
まず最初の事前学習の構成は以下になります。
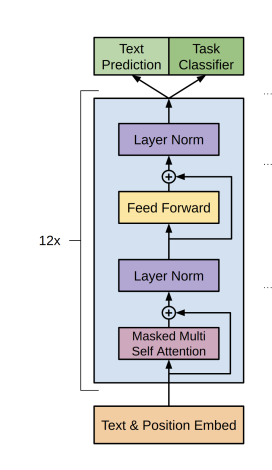
デコーダーによる事前学習をした後に2段階目である各タスクに合わせたファインチューニングを行います。
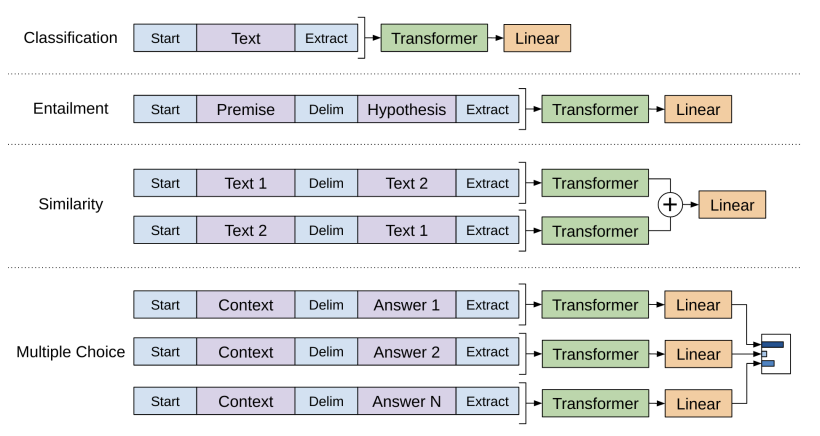
これが教師あり学習にあたります。
つまり、従来のモデルでは入力に対して出力ラベルがついた教師データを大量に用意してそれをエンコーダー・デコーダーモデルにインプットする必要があったのですが、GPTではまず事前学習モデルでラベル付与なく教師なし学習をして、その後に特定タスクにあわせてファインチューニングすることで大規模データの学習を可能にしたのです。
GPTシリーズに関しては以下の記事に詳しく解説していますので是非チェックしてみてください!
 GPT-1→GPT-2→GPT-3→GPT-3.5→ChatGPT→GPT-4までの進化の軌跡と違いをまとめてみた当サイト【スタビジ】の本記事では、昨今のAIの進化のきっかけになっているGPTシリーズについてまとめていきたいと思います。GPT-1から始まりGPT-2、GPT-3、そしてChatGPTであるGPT-3.5、GPT-4と進化してきました。この進化の軌跡と違いについて解説していきます。
PaLM
PaLMは2022年にGoogleから発表されたモデルで「Pathways Language Model」の略です。
論文は以下になります。
論文はなんと87ページにも及ぶ超大作なのですが、正直特別革新的なアーキテクチャが登場するわけではなく、ベースとなるのはやはり2017年に同じくGoogleが発表したTransformerというアーキテクチャです。
PaLMでは端的に言うと、「とにかく大量のパラメータを持ったモデルで大量のデータを最強のマシン構成で学習させたようなモデル」なのです!
パラメータの数が5400億個もあります。
PaLMよりも前に発表されたOpenAIのGPT-3のパラメータが1700億個。
そしてMicrosoftから発表されたMegatron-Turing NLGのパラメータが5300億個。
Megatron-Turing NLGも絶妙に100億個パラメータが多いところがGoogleの意地を感じます。
ちゃんと論文には、ご丁寧に他の大規模言語モデル(LLM)と比較してどれだけPaLMがどれだけスゴイのかが記載されています。
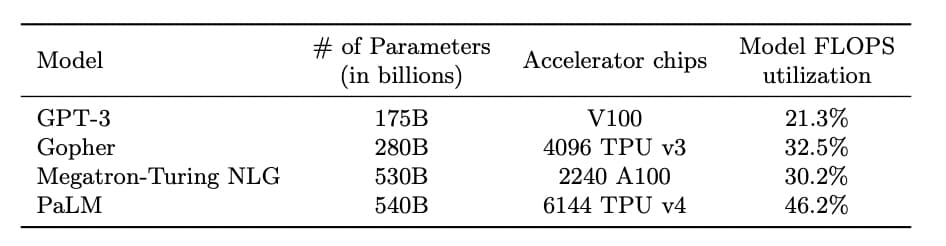 (出典:「Scaling Language Modeling with Pathways」)
PaLM2が2023年5月に発表され、多くのGoogleプロダクトに適用されることが決まりました。
PaLMについて詳しく知りたい方は以下の記事をチェックしてみてください!
 Google開発のLLMであるPaLMについて解説!PaLM2が生成AIのBardに搭載!当サイト【スタビジ】の本記事では、Googleの開発する大規模言語モデル(LLM)であるPaLMについて解説していきます!MicrosoftとOpenAIの連合軍に対してAI戦争で負けるわけにはいかないGoogleの最新兵器PaLMとはどんなものなのか?生成AIのBardにも搭載されたPaLM2とは!?見ていきましょう!
LLaMA
LLaMAは(Large Language Model Meta AI)の略であり、Metaが2023年2月に発表した大規模言語モデルです。
以下がLLaMAの論文になります。
LLaMAは、OpenAIに開発するGPTモデルや、Googleの開発するPaLMなどと比較すると圧倒的に少ないパラメータ数のモデルになっています。
LLaMAは、パラメータ数をおさえながら高精度を実現しているため、世界中の研究者がLLaMAをベースに様々な大規模言語モデルの可能性を探ることが可能になっているんです。
ウマたん従来のモデルはパラメータ数が多すぎて学習に莫大な計算リソースが必要になってたんだよね・・・
LLaMAのコードはGithubに上がっておりオープンソースとして公開されています。
LLaMAの特徴は少ないパラメータ数です。
各モデルのパラメータ数は以下のようになっています。
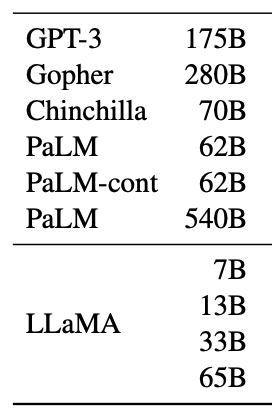
(出典:LLaMA: Open and Efficient Foundation Language Models)
LLaMAにはそれぞれ、
のパラメータ数のモデルが存在しています。
これでも十分パラメータ数は多い気がしますが、GPT-3の1700億個やGoogleのPaLMの5400億個などに比べると圧倒的に少ないのが分かるでしょう!
少ないパラメータでも他のモデルに匹敵する精度を出力しているのがLLaMAのすごいところです。
詳しいアーキテクチャについては以下の記事で解説していますので参考にしてみてください!
 【大量の学習データ!】Meta開発のLLMであるLLaMA、LLaMA2、派生モデルAlpacaについて解説!当サイト【スタビジ】の本記事では、Meta社の開発する大規模言語モデル(LLM)であるLLaMAについて解説していきます!LLaMAはパラメータの少ない軽量モデルでありながら他のLLMに匹敵する精度を誇るモデルでオープンソース化されています。LLaMA次世代のLLaMA2やLLaMAをベースに開発されたAlpacaについても見ていきましょう!
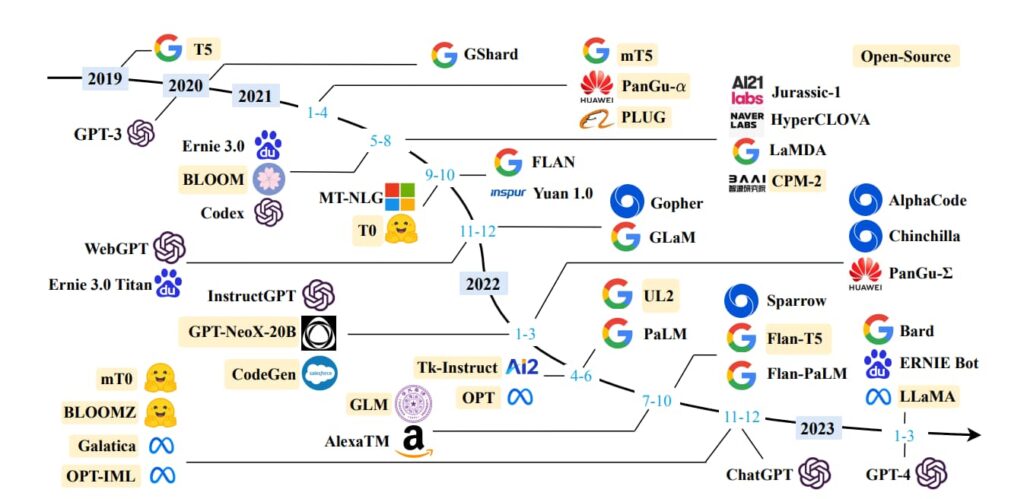
他にもたくさんの大規模言語モデル(LLM)があり、軌跡が以下の論文に詳しくまとまっています!
このほかにも、中国の「DeepSeek」のように少ない費用で作られた高性能なモデルや、スマホやパソコンでも動く「小規模言語モデル(SLM)」も次々に登場しています。
大規模言語モデル(LLM)の課題
ただ、そんな大規模言語モデルですがいくつかの課題が残っているんです。
学習データのバイアスによる偏見や差別
学習データのバイアスによる偏見や差別が生じ問題に発展する可能性があります。
AIは世の中の一般的な情報を大量に吸い上げて学習しているので、LLMにお願いしてテキストを生成した時にアウトプットに「看護師と言えば女性だし、お金持ちと言えば男性」みたいな偏見や差別が勝手に入り込む可能性があります。
ロボたんちゃんとバイアスが存在することを理解した上で使わないといけないね
AIを人の意図や価値観に沿って動くように調整する「AIアラインメント」については、以下の記事で解説しています。
 AIアラインメントとは?ペーパークリップ問題やChatGPTでの使われ方を分かりやすく解説!AIアラインメントとは、AIの行動を人間の価値観や意図と一致させるための研究です。本記事では、有名な思考実験「ペーパークリップ問題」、AIと人間のずれが起きる仕組み、ChatGPTにも使われているRLHFなどの技術、これからの課題を分かりやすく解説します!
個人情報・プライバシーの問題
また各種LLMを使う際に個人情報データや機密情報データをインプットすると、それを勝手に学習されてしまうという恐れがあります。
そのため企業によっては社員がChatGPTなどのLLMツールを利用するのを禁止しているケースもありますし、国自体が国民に使用を禁止しているケースもあります。
明確に学習に使わないと断言している場合もありますが、使用する際はくれぐれも注意しましょう!
正確性の問題
そもそも大規模言語モデル(LLM)は確率的に高いテキストを並べているだけなので、必ずしも正確な答えをアウトプットするとは限りません。
割と普通に嘘をつきます。
この正確性の問題は今後ある程度解決していくかとは思いますが、人間も完璧に正確なことを言うとは限らないので、そういうものだと思って付き合っていくしかないでしょう!
ウマたんそもそも確率的に高い答えを出しているだけなので大規模言語モデル(LLM)に悪気はないんだ!優しく見守ってあげてね!
インプットする言語による精度差
大規模言語モデル(LLM)では、学習データであるテキストデータに様々な言語が混ざっているため、言語によってモデルの精度に差が生じます。
英語が一番精度が高く、日本語も比較的精度が高めです。
そのためより高い精度のアウトプットを求めるなら英語を使った方がよいでしょう!
以下はGPT-4の言語別の精度差になります。
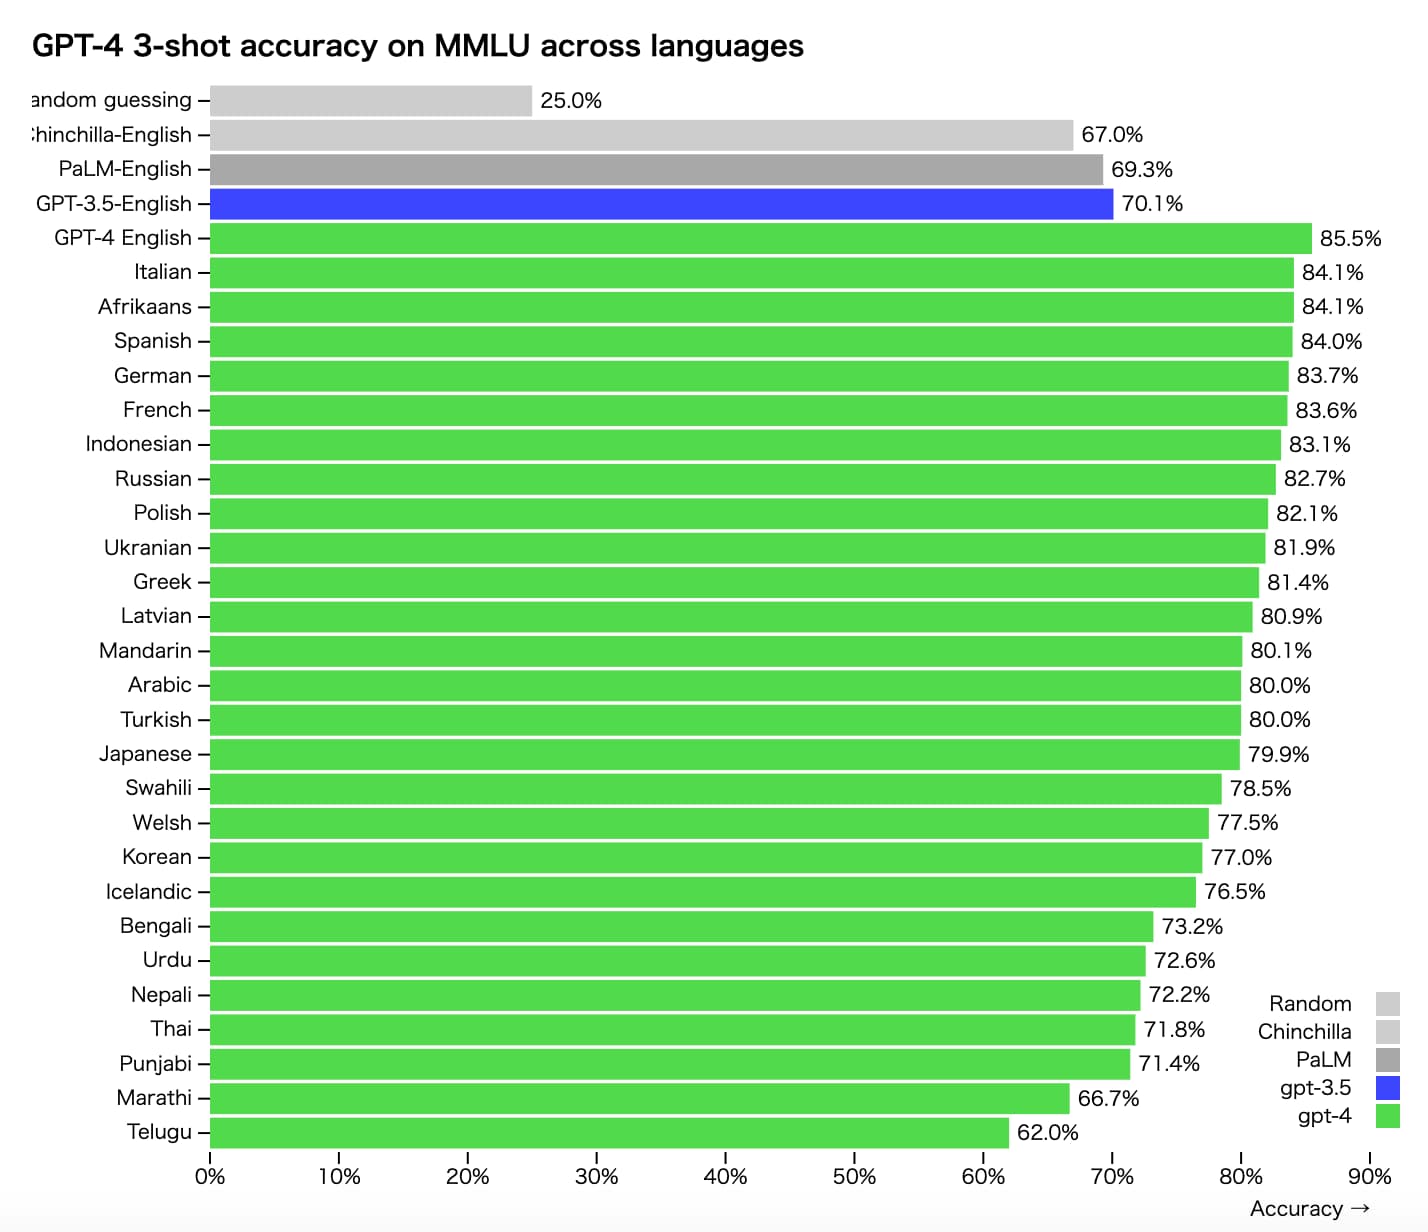 (出典:https://openai.com/research/gpt-4)
圧倒的な計算量によるコスト
また、圧倒的な計算量によるコストも課題です。
ChatGPTを開発するOpenAIは2022年に赤字5億4000万ドル(約730億円)を計上しており、高精度の大規模言語モデル(LLM)を開発するためには莫大なコストがかかることが伺えます。
計算量を抑える工夫として、質問ごとに一部の「専門家」だけを動かす「MoE(Mixture of Experts)」や、少しのパラメータだけを追加で学習する「LoRA」といった技術も使われています。
大規模言語モデル(LLM)まとめ
ここまでご覧いただきありがとうございました!
本記事では、大規模言語モデル(LLM)について簡単にまとめてきました!
ここまでは、大規模言語モデル(LLM)がどんなものなのかザックリ見てきましたが、ある程度理解した後はGPTシリーズなどの各種モデルを具体的に手を動かしながら実装してみることが大事です。
ウマたん頭の良い人たちが研究開発した知識をガンガン社会実装していこう!
各種大規模言語モデル(LLM)をPythonで利用する方法を知りたい方は以下のUdemy講座でまとめていますので是非チェックしてみてください!
また、当メディアが運営するスタアカの以下のコースでも大規模言語モデル(LLM)について詳しく解説していますので是非チェックしてみてください!
スタアカは業界最安級のAIデータサイエンススクールです。
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
AIデータサイエンスを学んで市場価値の高い人材になりましょう!
データサイエンスやAIの勉強方法は以下の記事でまとめています。
 【5分で分かる】データサイエンティストに必要なスキルと独学勉強ロードマップ!当サイト【スタビジ】の本記事では、データサイエンティストに求められるスキルとそれを身に付けるための勉強法について徹底的にまとめていきます!入門者でも、しっかりデータサイエンティストについて理解しある程度独学で駆け出しの状態までいけることを目指します。
 【これだけ!】AI(人工知能)の勉強ロードマップを徹底的に解説!当サイト【スタビジ】の本記事では、AIを勉強するロードマップについて徹底的に解説していきます。まずは、AIの概要について理解して統計学の基本知識・機械学習の基本知識・Pythonでの実装・インフラ周りの知識などを包括的に理解していきましょう!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「大規模言語モデル(LLM)・生成系AI」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。
あわせて読みたい
生成AIの記事をもっと見る →GPT-1→GPT-2→GPT-3→GPT-3.5→ChatGPT→GPT-4までの進化の軌跡と違いをまとめてみた
Transformer(トランスフォーマー)をAI進化の流れと共にわかりやすく解説!Attention層に至るまで
【大量の学習データ!】Meta開発のLLMであるLLaMA、LLaMA2、派生モデルAlpacaについて解説!
基盤モデル(Foundation Model)とは?LLMとの違いや仕組み、使い方を分かりやすく解説!
【原理は?】Stable Diffusionの使い方や仕組み・特徴について分かりやすく解説!

ファインチューニングと転移学習の違いやChatGPTをPythonでファインチューニングする方法!