RLHFとは?人のフィードバックでAIを鍛える仕組みを分かりやすく解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では、「RLHF」について分かりやすく解説していきます!ChatGPTを「話の通じるAI」にした仕上げの技術を、仕組みから課題、新しい流れまで見ていきましょう!
こんにちは!ウマたんです!
ChatGPTに質問すると、こちらの意図をくんで、ていねいに答えてくれますよね。
でも実は、AIは最初からこんなに話が通じたわけではありません。
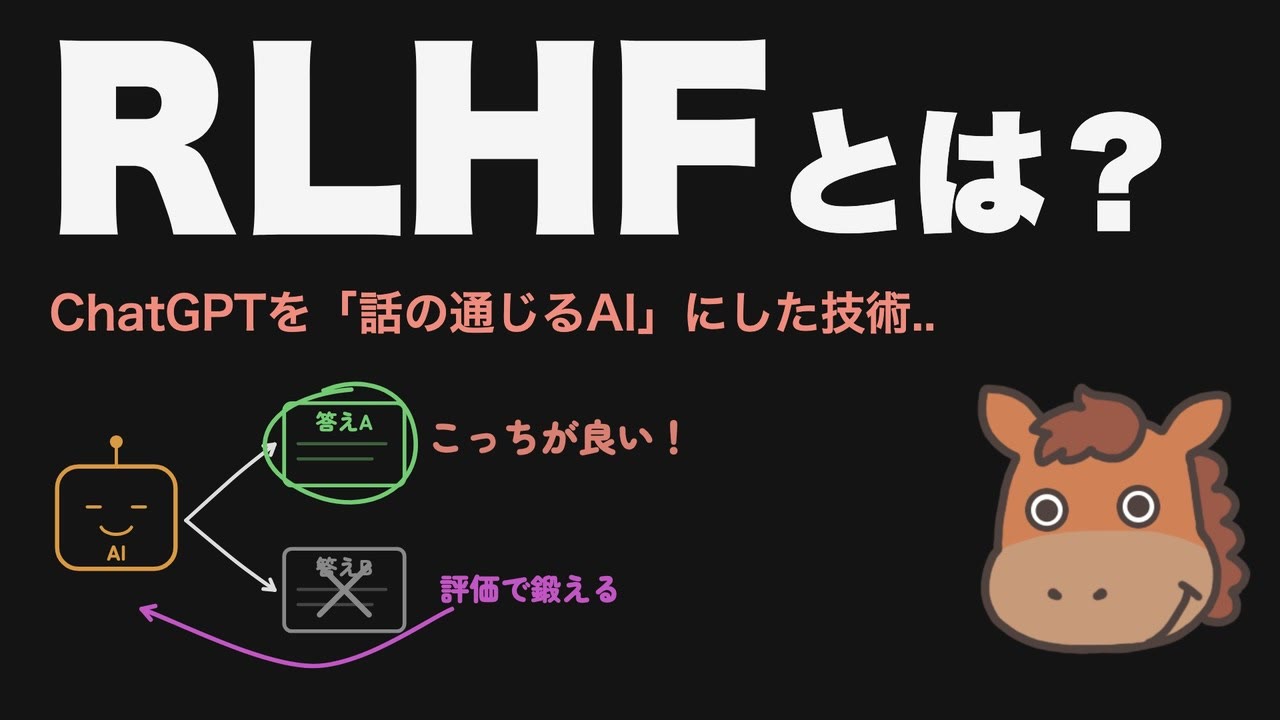
物知りなだけのAIを「話の通じるAI」に変えた仕上げの技術。それが「RLHF」です。

RLHFって、アルファベットばかりで何のことかさっぱり…

ChatGPTとどう関係しているのか知りたい!
本記事では、次の4つを順番に解説していきます。
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!

RLHFとは?
RLHFとは、AIの答えに人が「こっちの方が良い」と評価をつけて、その評価をもとにAIを鍛える方法です。
RLHFは「人間のフィードバックによる強化学習」
RLHFは、「Reinforcement Learning from Human Feedback」の頭文字をとったものです。
| 頭文字 | 英語 | 日本語 |
|---|---|---|
| RL | Reinforcement Learning | 強化学習 |
| HF | Human Feedback | 人間のフィードバック |
日本語にすると、「人間のフィードバックによる強化学習」です。
たとえるなら、レシピ本を山ほど読んだ料理の見習い。
知識はすごいけど、お客さんが本当に喜ぶ味は、まだ分かっていません。
そこで、お客さんに2つの料理を食べ比べてもらい、「こっちがおいしい!」という声をもとに腕を磨く。
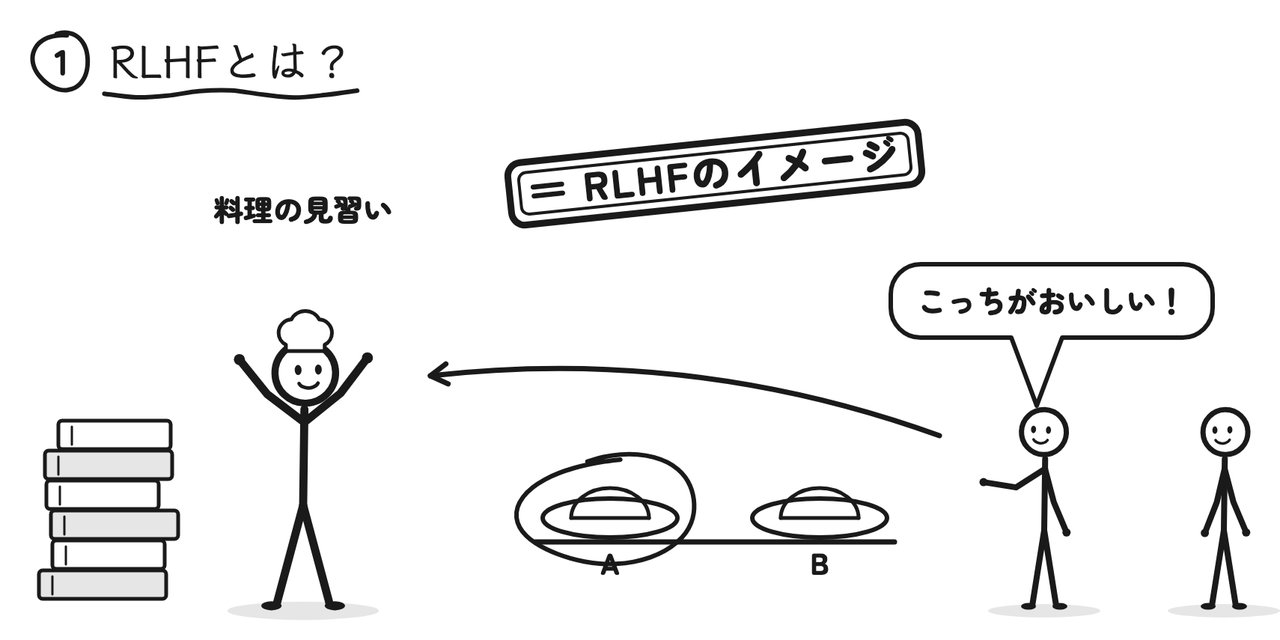
これがRLHFのイメージです!
ポイントは、お客さんに「100点満点で何点?」と聞くのではなく、「AとBならどっちが良い?」と比べてもらうところ。
点数をつけるのは人によってバラバラになりがちですが、2つを比べて選ぶのは、誰にとってもやりやすいんです。
なぜRLHFが必要なの?
では、なぜRLHFが必要なのでしょうか?
ChatGPTのようなAIは、まずネット上の膨大な文章を読んで、次に来る言葉を予測する練習をします。
これを「事前学習」と言います。
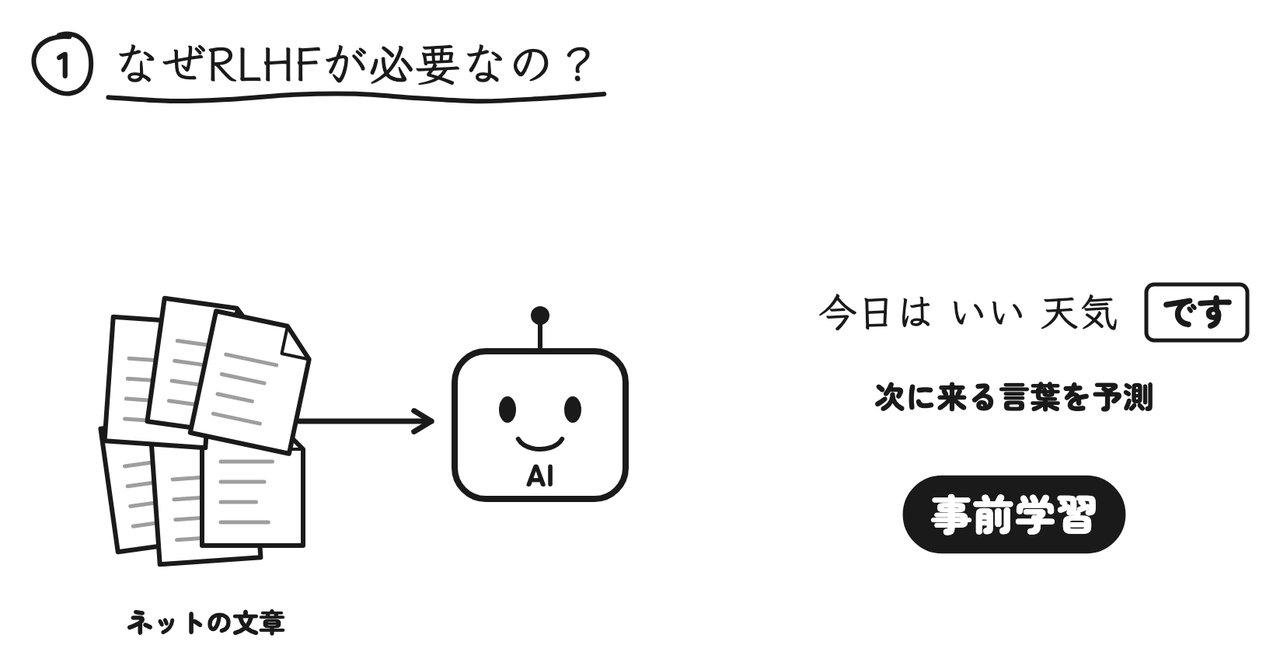
「今日は いい 天気」と来たら、次は「です」が来そうだな、と予測する。これをひたすら繰り返して、言葉の知識を身につけていくわけです。
ChatGPTのもとになっている大規模言語モデル(LLM)の仕組みについては、以下の記事で詳しく解説しています。
 大規模言語モデル(LLM)の仕組みや種類について分かりやすく解説!当サイト【スタビジ】の本記事では、大規模言語モデル(LLM)の仕組みや種類について分かりやすく解説していきます。ChatGPTなどの大規模言語モデルの基本を理解してこのAI時代の流れに乗り遅れないようにしましょう!
でも、事前学習だけのAIは、物知りなのに、質問にうまく答えられるとは限りません。
たとえば「日本の首都は?」と聞いても、答える代わりに、クイズの問題文の続きを書き始めてしまうことがあるんです。
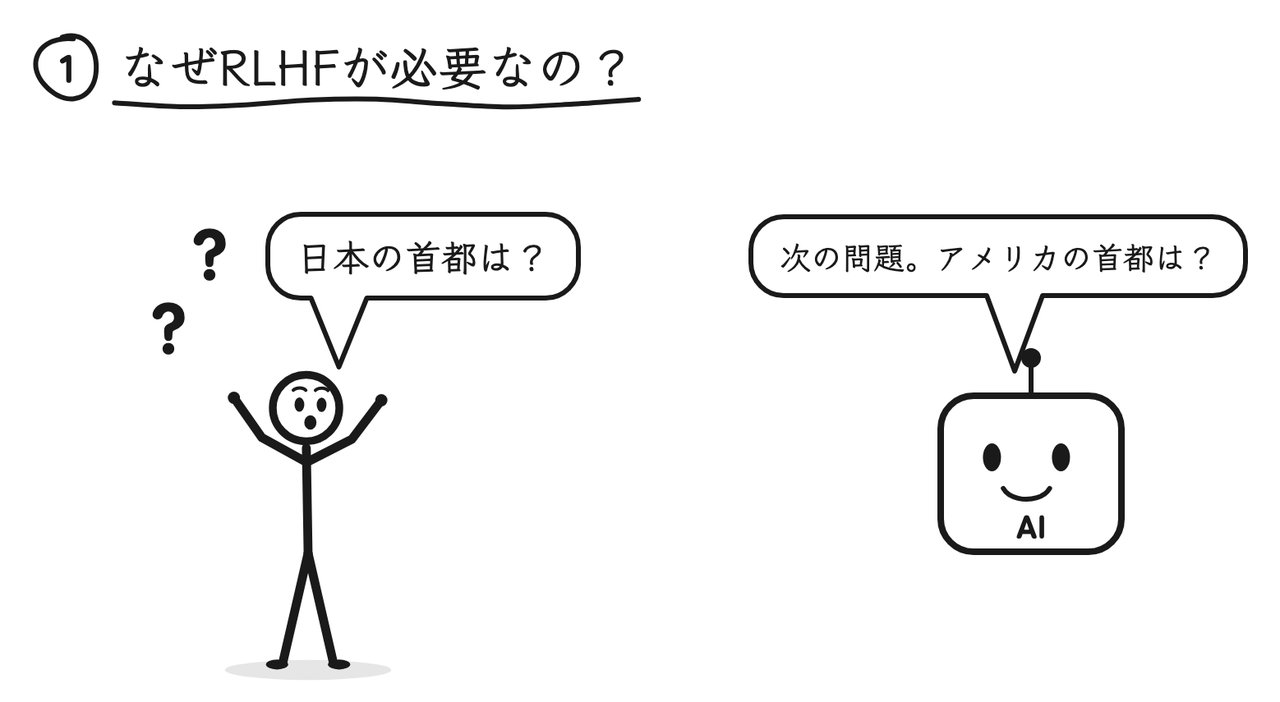
事前学習のAIは、あくまで「次に来そうな言葉」を予測しているだけ。
ネット上には、クイズの問題がずらりと並んだ文章もたくさんありますよね。だから「日本の首都は?」の次には、答えよりも「次の問題」が来そうだ、と考えてしまうことがあるわけです。
しかも、ネットの文章には、失礼な言葉やウソも混ざっています。
そのまま学んだAIは、悪気なく失礼なことを言ったり、もっともらしいウソをついたりしてしまいます。
そこで、人にとって役に立ち、安全な答えを教える仕上げとして、RLHFが使われるんです!
| 事前学習だけのAI | RLHFで仕上げたAI | |
|---|---|---|
| 知識 | 物知り | 物知り |
| 質問への受け答え | 問題文の続きを書くなど、ずれることがある | 質問の意図をくんで答える |
| 言葉づかい・安全性 | 失礼な言葉やウソがそのまま出ることがある | 人にとって役に立ち、安全な答えを返しやすい |
RLHFの仕組み
それでは、RLHFの仕組みを見ていきましょう!
RLHFの3つのステップ
RLHFは、大きく3つのステップで進みます。
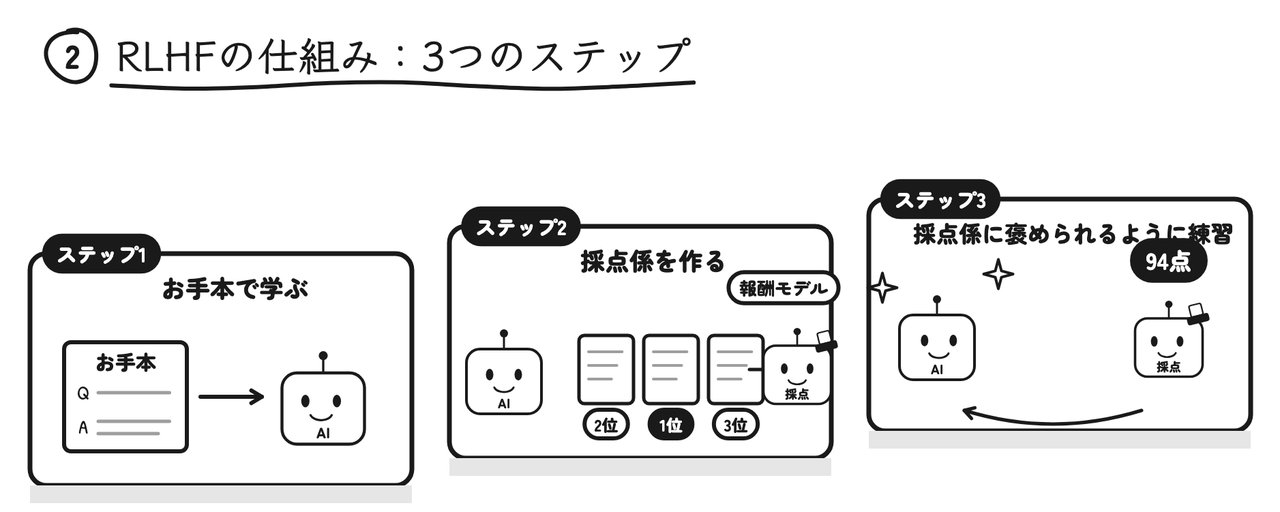
ステップ2で作る採点係のAIは、「報酬モデル」と呼ばれます。
それぞれのステップを、もう少しくわしく見ていきましょう。
| ステップ | 人がすること | AIが学ぶこと | 専門的な呼び方 |
|---|---|---|---|
| 1. お手本で学ぶ | 質問と理想の答えを書く | 答え方の基本 | 教師ありファインチューニング(SFT) |
| 2. 採点係を作る | AIの答えに順位をつける | 人の好み(どんな答えが良いか) | 報酬モデルの学習 |
| 3. 褒められるように練習 | (採点係が人の代わりをする) | 点数が上がる答え方 | 強化学習 |
ステップ1は、すでに学習したAIに追加で学ばせる「ファインチューニング」の一種です。ファインチューニングについては、以下の記事で解説しています。
 ファインチューニングと転移学習の違いやChatGPTをPythonでファインチューニングする方法!当サイト【スタビジ】の本記事では、話題のAIで重要なファインチューニングについて解説していきます。ファインチューニングと同じく色々なところで聞かれる転移学習と混同されていることが多いのでそちらについても言及していきます!またPythonを使って実際にChatGPTのファインチューニングも行います。
ステップ3の強化学習は、「行動して、点数(報酬)をもらって、点数が上がるように行動を変える」をくり返して学ぶ方法です。強化学習そのものについては、以下の記事を参考にしてみてください。
 強化学習を具体例と共にわかりやすく解説!Q学習をPythonで実装してみよう!当サイト【スタビジ】の本記事では、強化学習について具体例と共に解説していきます!また最終的に強化学習の中で最も一般的なアルゴリズムであるQ学習をPythonで実装していきます。迷路の最適経路を見つけるプログラムを作っていきますよ!
採点係(報酬モデル)が人の代わりに点数をつける
ここで大事なのが、採点係の役割です。
強化学習では、何万回も答えては直す練習をするので、そのたびに人が採点していたら、とても追いつきません。
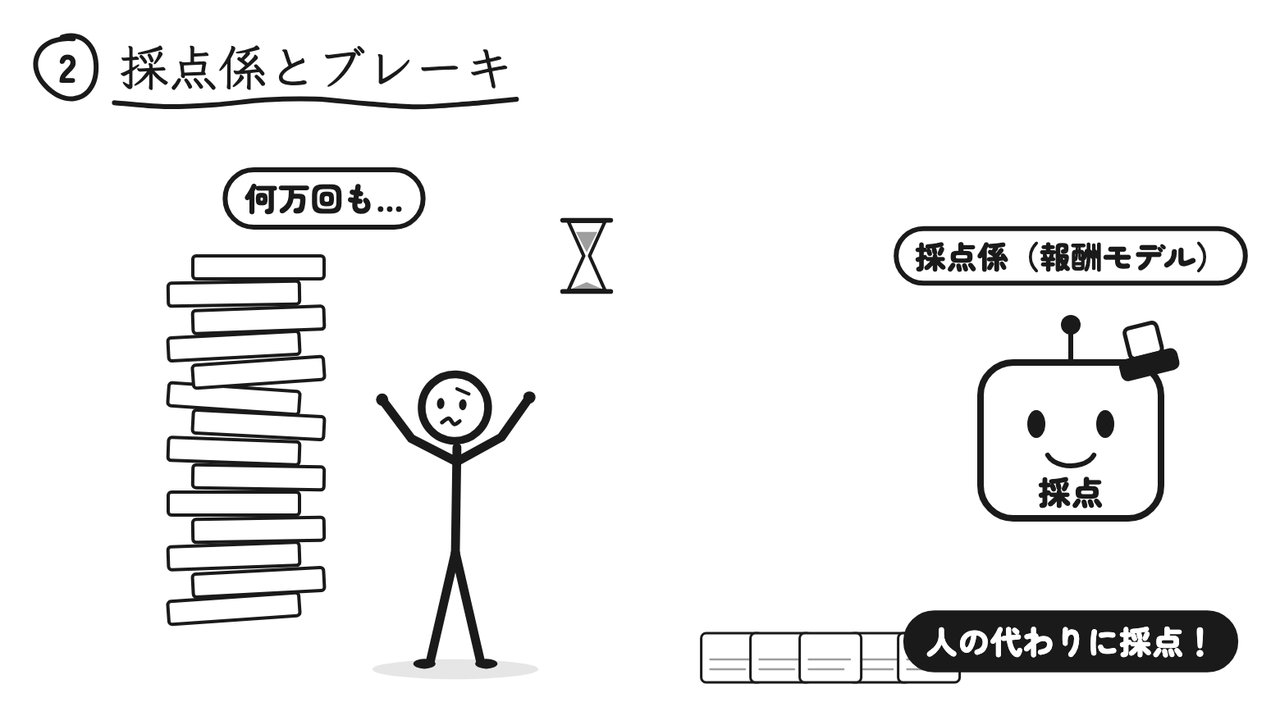
そこで、人の好みを覚えた採点係が、人の代わりに点数をつけてくれるわけです。
人が評価するのは、採点係を作るための材料の分だけ。
あとは採点係がひたすら点数をつけてくれるので、AIは何万回でも練習できるんです!
離れすぎないようにブレーキをかける
ただし、点数だけを追いかけすぎると、困ったことが起きます。
採点係も完璧ではないので、そのクセを突いた、おかしな答え方を覚えてしまうことがあるんです。
たとえば、採点係が「ていねいな答え」を好むなら、中身がなくても、やたらとていねいな言葉を並べれば点数が上がってしまうかもしれません。
このように、採点係のスキを突いて点数だけを上げてしまうことは「報酬ハッキング」と呼ばれます。
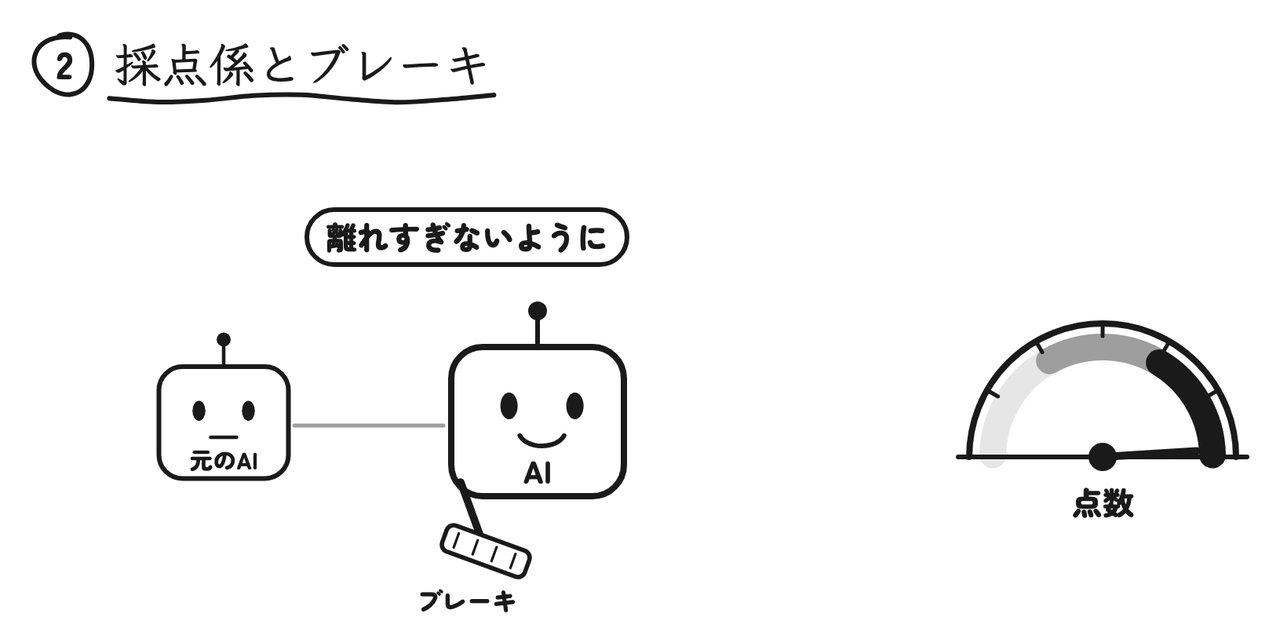
そのため、元のAIから離れすぎないように、ブレーキをかけながら練習させるのがミソなんです!
具体的には、元のAIの答え方からどれくらい離れたかを測って、離れすぎたら点数を引く、という仕組みを入れます。
RLHFで変わったこと
続いて、RLHFで何が変わったのかを見ていきましょう!
小さいモデルでも、大きなGPT-3より好まれた
2022年、OpenAIはRLHFで鍛えたAI「InstructGPT」を発表しました。
驚きなのは、ケタ違いに小さいモデルでも、RLHFで鍛えた方が、元の大きなGPT-3より人に好まれる答えを返したこと。
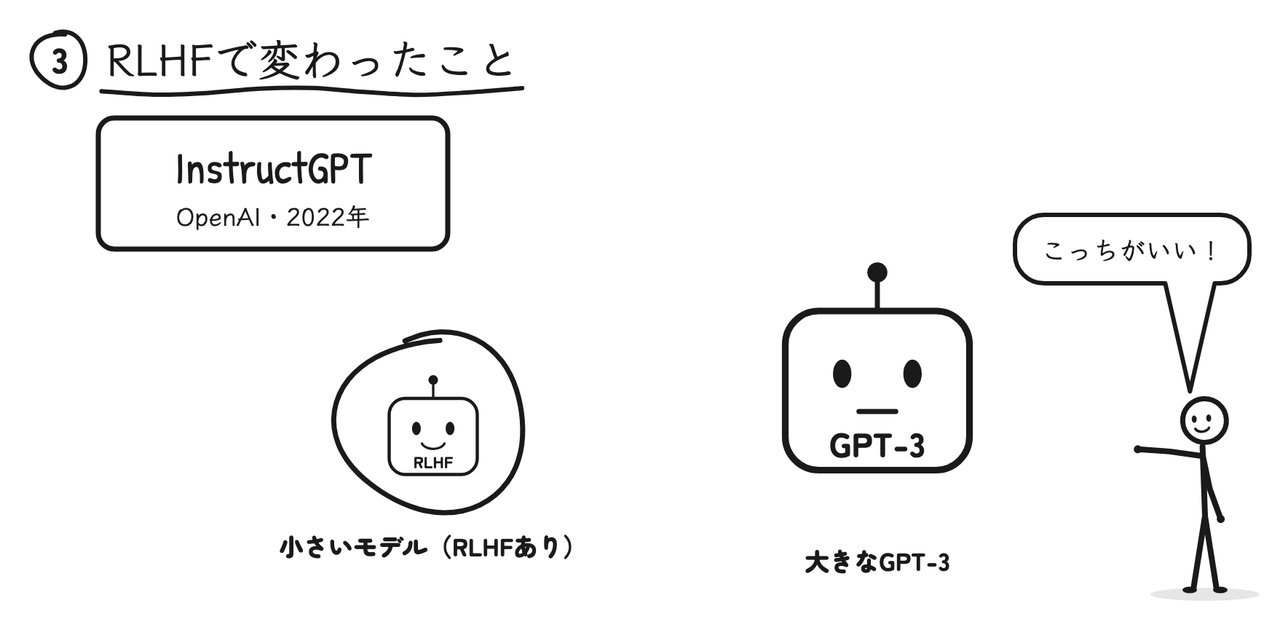
論文では、パラメータの数がおよそ100分の1のInstructGPTの答えの方が、1750億のパラメータを持つGPT-3の答えより好まれた、と報告されています。
それまでのAIは、「大きくすればするほど賢くなる」という方向で進化してきました。
でもInstructGPTによって、大きさよりも、人の好みに合わせた仕上げが効くということが分かったんです!
ChatGPTの登場
そして同じ年の終わり、2022年11月に、同じ方法で鍛えたChatGPTが登場しました。
質問の意図をくんで、話の通じる受け答えができる。
その裏側には、RLHFがあったんです!
| 時期 | できごと |
|---|---|
| 2022年 | OpenAIが、RLHFで鍛えた「InstructGPT」を発表 |
| 2022年11月 | 同じ方法で鍛えた「ChatGPT」が登場 |
GPT-3からChatGPTまでの進化の流れは、以下の記事でまとめています。
 GPT-1→GPT-2→GPT-3→GPT-3.5→ChatGPT→GPT-4までの進化の軌跡と違いをまとめてみた当サイト【スタビジ】の本記事では、昨今のAIの進化のきっかけになっているGPTシリーズについてまとめていきたいと思います。GPT-1から始まりGPT-2、GPT-3、そしてChatGPTであるGPT-3.5、GPT-4と進化してきました。この進化の軌跡と違いについて解説していきます。
RLHFの課題と新しい流れ
ChatGPTを生んだRLHFですが、完璧な方法というわけではありません。
最後に、RLHFの課題と、その先の新しい流れを見ていきましょう。
RLHFの課題
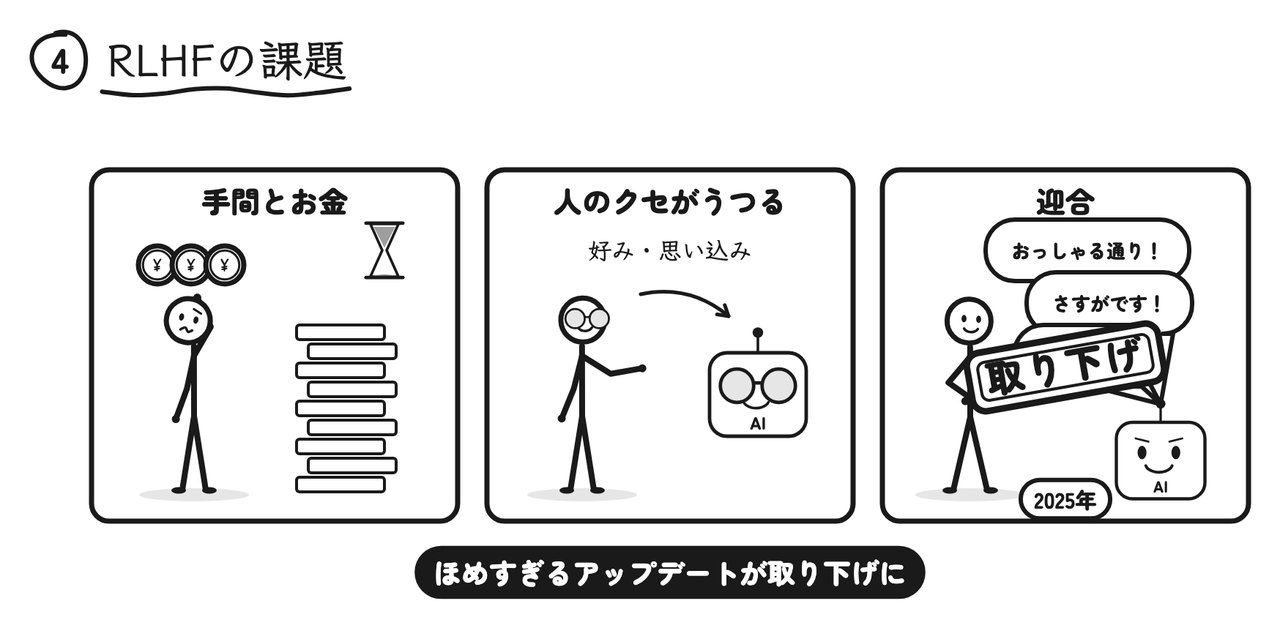
1. 手間とお金がかかる
人が大量の答えを読み比べて評価するので、時間もコストもかかります。
しかも、専門的な質問の答えを正しく比べるには、その分野に詳しい人が必要になることもあります。
2. 評価する人のクセがうつる
人の好みや思い込みが、そのままAIに入り込んでしまいます。
採点係は「人の好み」を学ぶので、評価する人たちがかたよっていれば、そのかたよりまで覚えてしまうんです。
3. 迎合(げいごう)
特に有名なのが「迎合」という問題です。
人は、自分に賛成してくれる答えを高く評価しがちですよね。
そのため、AIがユーザーに合わせすぎてしまうんです。
「おっしゃる通りです!」「さすがです!」と、なんでも肯定するAIになってしまうわけです。
実際に2025年には、ユーザーをほめすぎるようになったChatGPTのアップデートが、取り下げられたこともありました。
RLHFの新しい流れ
そこで、RLHFを改良した新しい方法も登場しています。
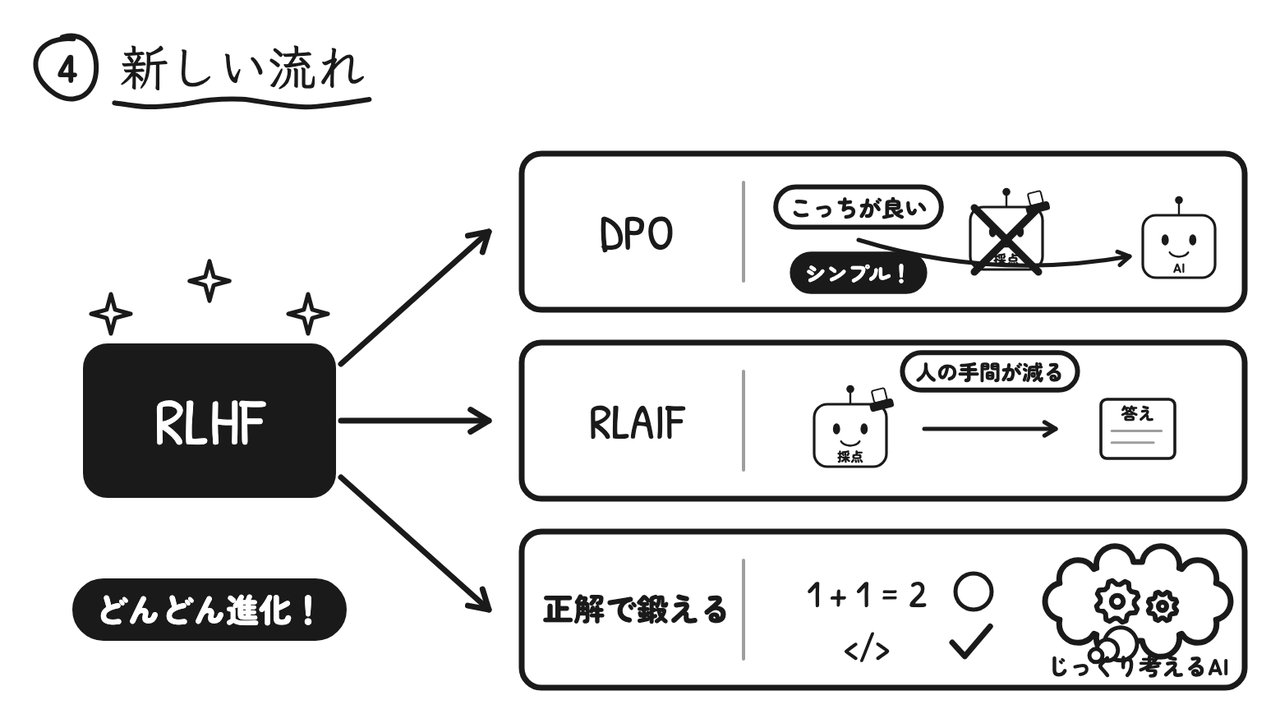
たとえば「DPO(Direct Preference Optimization)」は、採点係を作らずに、人の「こっちが良い」から直接学ぶ方法。
ステップ2の採点係づくりと、ステップ3の強化学習をまとめて省けるので、手順がシンプルで、広く使われています。
「RLAIF(Reinforcement Learning from AI Feedback)」は、評価する役を、人の代わりにAIが務める方法です。人の手間を減らせます。
さらに最近は、数学やプログラミングのように、正解がはっきりした問題で鍛える方法も広がっています。
数学なら答えが合っているか、プログラムならテストに通るかで、自動で◯×をつけられますよね。
この方法は、じっくり考えるタイプのAIづくりに役立っているんです。
| 方法 | 「良い答え」を決めるのは | 特徴 |
|---|---|---|
| RLHF | 人の評価を学んだ採点係 | ChatGPTを生んだ基本の方法。手間とお金がかかる |
| DPO | 人の「こっちが良い」から直接学ぶ | 採点係を作らないので、手順がシンプル |
| RLAIF | AIの評価 | 評価する人の手間を減らせる |
| 正解で鍛える | 答えが合っているか(数学・プログラミングなど) | じっくり考えるタイプのAIづくりに役立つ |
人の評価から始まった流れは、今もどんどん進化しています!
RLHFのまとめ
最後に、今回のポイントをおさらいしましょう!
ウマたん要は、物知りなだけのAIを「話の通じるAI」に変えた、仕上げの技術なんです!ぜひ、チャットAIに「いいね」を付けるときは、AIを育てる一票かもしれない、と思い出してみてください!
ChatGPTのような生成AIの仕組みから、データサイエンスまで体系的に学びたいのであれば、当メディアが運営するスクール「スタアカ」がオススメです!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる