AIの「学習」と「推論」とは?違いをテスト勉強とテスト本番のたとえで分かりやすく解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では、AIの「学習」と「推論」について分かりやすく解説していきます!AIが使えるようになるまでの2つの段階の違いから、AIが最新の情報を知らない理由、具体例まで見ていきましょう!
こんにちは!ウマたんです!
ChatGPTに質問したり、スマホの写真アプリで「猫」と検索したり。
AIは、もうすっかり生活の一部になっていますよね。
でも、そのAIが使えるようになるまでに、裏側でどんなことが起きているのかは、意外と知られていません。
実はAIには、大きく分けて「学習」と「推論」という2つの段階があるんです。

ニュースで「AIの学習に〇〇億円」とか「推論のコスト」とか聞くけど、何が違うの?

AIが最新のことを知らないことがあるのはなんで?
本記事では、次の4つを順番に解説していきます。
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!

AIの「学習」と「推論」とは?
まずは結論からいきましょう!
学習とは、AIが大量のデータを使って、パターンを覚える段階です。
推論とは、覚えたパターンを使って、実際に答えを出す段階です。
英語では、学習を「training(トレーニング)」、推論を「inference(インファレンス)」と呼びます。
テスト勉強とテスト本番のたとえ
人間にたとえると、学習はテスト勉強、推論はテスト本番で問題を解くことに近いイメージです。
| 学習 | 推論 | |
|---|---|---|
| 人間にたとえると | テスト勉強 | テスト本番で問題を解く |
| やること | 大量のデータからパターンを覚える | 覚えたことを使って答えを出す |
| AIの中身(パラメータ) | 少しずつ書きかえていく | 変えずにそのまま使う |
| 英語 | training | inference |
テスト勉強では、たくさんの問題を解いて、答え合わせをして、間違えたところを直して……と、時間をかけて力をつけていきますよね。
一方テスト本番では、新しく勉強するのではなく、それまでに身につけた力を使って、目の前の問題をサッと解きます。
AIも、まったく同じなんです!
学習:AIがパターンを覚える段階
まずは、AIがどうやって学習するのかを見ていきましょう。
猫の写真を見分けるAIの例
AIの学習では、大量のデータを使って、AIに経験を積ませます。
たとえば、写真に写っているのが猫かどうかを見分けるAIを作りたいとします。
最初のAIは、でたらめに答えるだけです。
でも、答え合わせと修正をくり返すうちに、「とがった耳」「ひげ」「目の形」といった猫らしい特徴を、少しずつつかんでいきます。
この猫の例のように、人が正解をつけたデータで学ぶ方法は「教師あり学習」と呼ばれます。
ちなみに、ChatGPTのような大規模言語モデルの最初の学習では、文章の続きを当てる練習をくり返します。「今日は天気が」の次に来る言葉を予測して、実際の文章と答え合わせをするんです。
これなら、文章そのものが正解になるので、人が一つひとつ正解をつけなくても、インターネット上の大量の文章で学習できます。学習の方法はいろいろありますが、答え合わせをしながらパラメータを直していくという基本は同じなんです。
中で起きているのは「パラメータの調整」
AIの中には、「パラメータ」と呼ばれるばく大な数の数値が入っています。
学習とは、ひとことで言うと、このパラメータを、正解に近い答えが出るように少しずつ調整していくことです。
どれだけ正解とずれているかを数値で表し、そのずれが小さくなる方向へ、パラメータをちょっとずつ動かしていきます。この「ずれが小さくなる方向へ少しずつ進む」方法は、最急降下法(勾配降下法)と呼ばれます。
 最急降下法のアルゴリズム・Pythonでの実装方法を分かりやすく解説!本記事では、関数の最小値を求めるための最適化アルゴリズムの一つである最急降下法について解説していきます!実際にPythonで実装して、理解を深めていきましょう!
学習には大量のデータと計算が必要
学習のポイントは、大量のデータと、ものすごい計算の力が必要になることです。
その計算をこなすために、たくさんのGPU(画像処理用に生まれた、大量の計算を同時にこなすのが得意な半導体)と、ばく大な電力が使われます。
ChatGPTのもとになっているOpenAIのGPTシリーズのような大規模なモデルは、まさにこの巨大な学習を経て作られています。大規模なモデルでは、数千〜数万個のGPUを使って、数週間から数か月かけて学習することもあるんです。
大規模言語モデルの学習は何段階かある
ChatGPTのような大規模言語モデル(LLM)の場合、学習はいくつかの段階に分かれています。
| 段階 | やること |
|---|---|
| 事前学習 | インターネット上などの大量の文章で、言葉や知識を幅広く身につける |
| 追加の学習 | 質問への答え方や、人にとって役立つ・安全な答え方を身につける |
追加の学習でよく使われる、人の評価をもとにAIを鍛える「RLHF」という方法については、以下の記事で解説しています。
 RLHFとは?人のフィードバックでAIを鍛える仕組みを分かりやすく解説!RLHF(人間のフィードバックによる強化学習)とは、人の「こっちが良い」という評価をもとにAIを鍛える方法です。本記事では、必要な理由、3つのステップの仕組み、ChatGPTが生まれた背景、課題と新しい流れを図解で分かりやすく解説します!
推論:覚えたことを使って答える段階
では、推論は学習とどう違うのでしょうか?
推論は、学習ずみのAIが実際に答えること
推論は、学習を終えたAIが、実際に問題へ答えるときのプロセスです。
学習で手に入れた知識を使って、さまざまな頼みごとに答えます。
たとえば、あなたがChatGPTに何か質問を投げかけたとき、裏側で行われているのは、すべて推論なんです!
推論の特徴
推論には、次のような特徴があります。
テスト本番で、1問ごとに教科書を一から読み直したりはしませんよね。身につけた力でサッと解くから、速いんです。
最近のスマホやパソコンには、AIの推論を速く動かすための専用の部品(NPUなど)が入っているものも増えています。
推論のときには、AIの中身は変わらない
ここで大事なポイントがあります。
推論のときには、AIの中身(パラメータ)は変わりません。
ChatGPTとたくさん会話しても、その場でAIのパラメータが書きかわって、どんどん賢くなっていくわけではないんです。
学習と推論の違い
それでは、学習と推論の違いを整理してみましょう!
学習は1度だけ、推論は毎回
すごい計算と時間がかかる学習は、1度だけ、もしくは定期的に行われます。
一方、推論は、AIが使われるたびに毎回行われます。
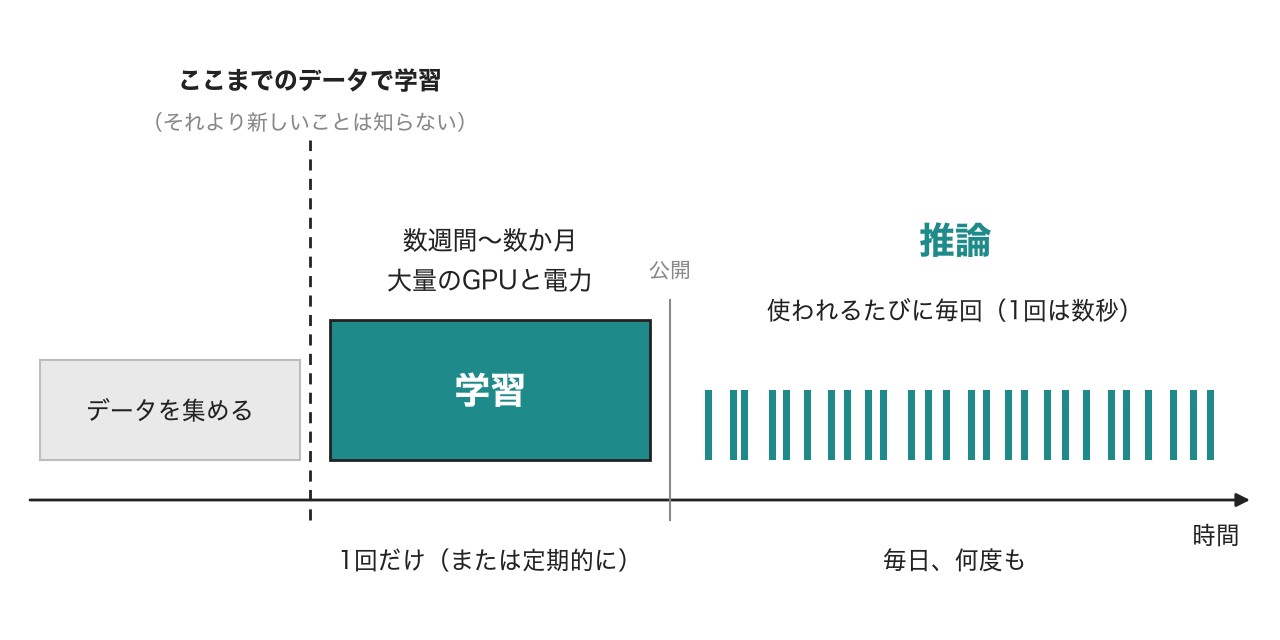
| 学習 | 推論 | |
|---|---|---|
| 行うタイミング | 1度だけ、または定期的に | 使われるたびに毎回 |
| 1回にかかる時間 | 数時間〜数か月(モデルの大きさによる) | 数秒ほど |
| 必要なもの | 大量のデータ、たくさんのGPU、ばく大な電力 | 学習ずみのモデルと、入力されたデータ |
| 動かす場所 | 大きなデータセンター | クラウドのサーバー、スマホやパソコンなど |
| たとえると | テスト勉強 | テスト本番 |
高い精度のAIを作るための学習は、時間もお金もかかりすぎるので、毎日はできないんです。
Pythonで見る、学習と推論
学習と推論の違いは、Pythonで機械学習のコードを書いてみると、とてもよく分かります。
機械学習のライブラリ「scikit-learn」では、学習は fit、推論は predict という命令ではっきり分かれています。
from sklearn.datasets import load_iris
from sklearn.linear_model import LogisticRegression
import joblib

# 学習用のデータ(アヤメの花の大きさと、品種の正解)
X, y = load_iris(return_X_y=True)

# 学習:データからパターンを覚える(重い処理は、ここで1回だけ)
model = LogisticRegression(max_iter=1000)
model.fit(X, y)
joblib.dump(model, "iris_model.joblib")  # 学習ずみのモデルを保存

# 推論:保存したモデルを読み込んで、新しい花の品種を答える(何度でも)
model = joblib.load("iris_model.joblib")
new_flowers = [[5.1, 3.5, 1.4, 0.2], [6.7, 3.0, 5.2, 2.3]]
print(model.predict(new_flowers))実行すると、[0 2] と表示されます。1つ目の花は品種0(セトサ)、2つ目の花は品種2(バージニカ)だと答えたわけです。
学習ずみのモデルをファイルに保存しておけば、あとは読み込んで predict を呼ぶだけ。もう一度学習し直さなくても、新しいデータに何度でも答えられます。
ChatGPTのような巨大なAIも、規模はまったく違いますが、「重い学習を一度やって保存し、そのモデルで何度も推論する」という流れは同じなんです。
AIが最新の情報を知らない理由
ChatGPTなどの生成AIが、ある時期より新しい情報を知らないことがあるのも、この学習の仕組みが理由です。
AIは、ある日付までに集めたデータで学習しています。そして、学習を終えたあとは、パラメータは更新されません。
当たり前ですが、学習に使ったデータより新しいことは、AIは知らないんです。
この「どの時点までのデータで学習したか」は、「知識のカットオフ(締め切り)」と呼ばれます。
 生成AI・LLM時代必須のRAG(検索拡張生成)について解説!Pythonで実装してみよう!当サイト【スタビジ】の本記事では、生成系AI・LLM時代におさえておきたいRAGについて解説していきます!社内用チャットボットなどを作る際によく利用されるアプローチです。どんなアプローチなのか理解した後は実際にPythonで簡単な実装をしていきます!
具体例で見る、学習と推論
最後に、具体的な例で、学習と推論の違いを見てみましょう!
| AIの種類 | 学習の段階 | 推論の段階 |
|---|---|---|
| 画像認識AI | 数百万枚の画像から、「猫とは何か」を学ぶ | 新しい写真を見て、「これは猫です」と判定する |
| チャットAI | 大量の文章を読んで、言葉のパターンを覚える | 質問に、自然な文章で答える |
| レコメンドAI | 数百万人のユーザーの行動データから、好みのパターンを学ぶ | あなたの好みに合う動画や商品を表示する |
このように、AIがふだんの動作として行っているのは推論です。
でも、その裏には、ばく大な学習が存在しているというわけです!
「推論」という言葉の注意点
最後に、「推論」という言葉について、少しだけ注意しておきたいことがあります。
「推論モデル」の推論は、少し意味が違う
最近、「推論モデル」という言葉をよく聞くようになりました。答える前にじっくり考えてから答えるタイプのAIのことです。
この「推論モデル」の推論は、英語では「reasoning(リーズニング)」。筋道を立てて考える、という意味です。
一方、本記事で解説してきた推論は「inference」。学習ずみのAIを動かして答えを出すこと全般を指します。
| 日本語 | 英語 | 意味 |
|---|---|---|
| 推論 | inference | 学習ずみのAIを動かして答えを出すこと |
| 推論(推論モデルなど) | reasoning | 答えを出す前に、筋道を立てて考えること |
日本語ではどちらも「推論」と訳されることが多いので、混ざりやすいんです。
ちなみに、推論モデルは、推論(inference)のときに考える時間を長くとることで、難しい問題に強くなっています。そのぶん、1回の推論にかかる計算も増えます。
推論のコストも、どんどん大事になっている
学習は1回ごとの計算がとても重い一方、推論は1回あたりなら軽い処理です。
でも、世界中の人が毎日AIを使うようになると、推論の回数そのものがばく大になります。さらに、じっくり考える推論モデルが広がったことで、1回の推論にかかる計算も増えてきました。
そのため最近は、「いかに速く・安く推論するか」も、AIの会社にとって大きなテーマになっています。小さくて軽いモデルや、推論専用の半導体が次々に登場しているのも、この流れなんです。
AIの学習と推論のまとめ
最後に、今回のポイントをおさらいしましょう!
ウマたん要は、学習はAIのテスト勉強、推論はテスト本番なんです!AIを使うとき、裏側でどちらが起きているのかを意識すると、AIとの付き合い方がぐっと上手になりますよ!
AIや機械学習の仕組みを基礎から体系的に学びたいのであれば、当メディアが運営するスクール「スタアカ」がオススメです!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる