DeepSeekとは?世界が驚いた中国発AIの安く作れた理由と、使うときの注意点を分かりやすく解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では、中国発の生成AI「DeepSeek」について分かりやすく解説していきます!世界を驚かせた「DeepSeekショック」から、安く作れた理由、最新モデル、使うときの注意点まで見ていきましょう!
こんにちは!ウマたんです!
AIのニュースで、クジラのマークと一緒に「DeepSeek(ディープシーク)」という名前を見かけたことはありませんか?
2025年の1月、この中国のAIが、ほんの数日で世界中の話題をさらいました。
アメリカのApp StoreでChatGPTを抜いて1位になり、AI向けの半導体を作るNVIDIAの株価まで大きく下がったんです。

DeepSeekってよく聞くけど、ChatGPTと何が違うの?

中国のAIって、使っても大丈夫なのか気になる!
本記事では、次の4つを順番に解説していきます。
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!

DeepSeekとは?
DeepSeekとは、中国の杭州にあるAI企業、そしてその会社が作っている生成AIの名前です。
会社の名前とAIの名前が同じなので、ニュースではどちらの意味でも使われています。
投資会社のAI研究チームから生まれた
会社を作ったのは、梁文鋒(リャン・ウェンフォン)氏。
もともと、AIを使って株の売買をする投資会社(High-Flyer)を立ち上げた人物です。
2023年、その投資会社の中のAI研究チームが独立して、DeepSeekが生まれました。
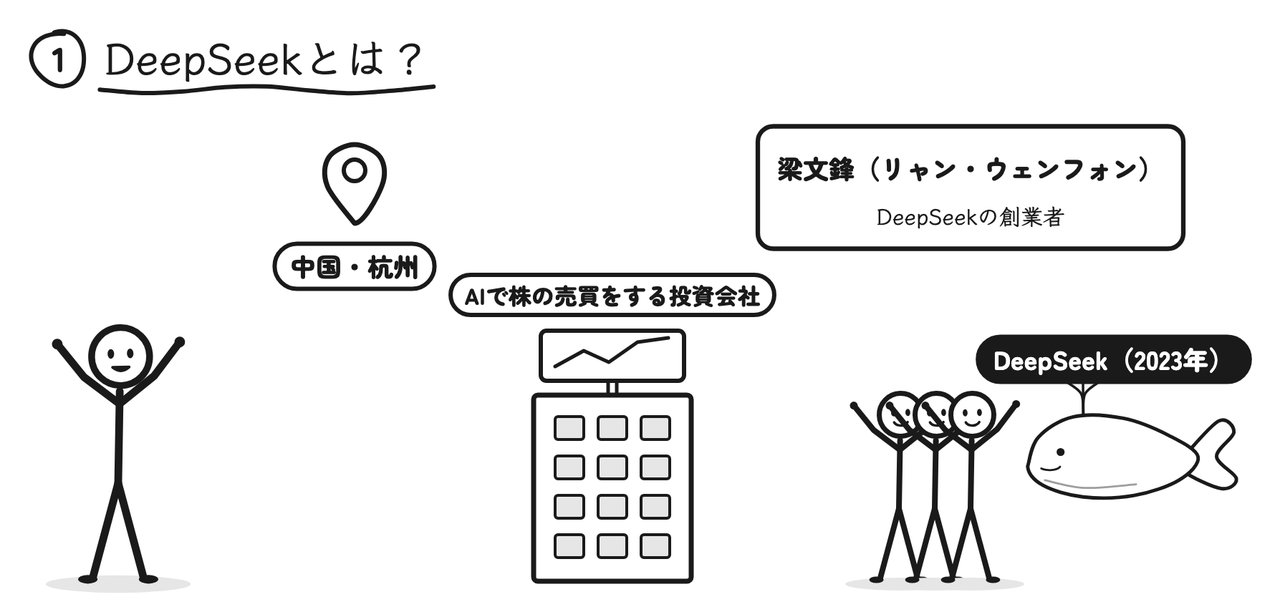
株の売買にAIを使うには、大量のデータと計算が欠かせません。そこで鍛えられたチームが、生成AIづくりに挑んだというわけです。
無料で使えて、AIの中身「重み」も公開
ChatGPTのように、チャットで質問できるアプリやWebサービスもあり、無料で使えます。
そして大きな特徴が、AIの中身である「重み」を公開していること。
誰でもダウンロードして、自分のパソコンやサーバーで動かせるんです!
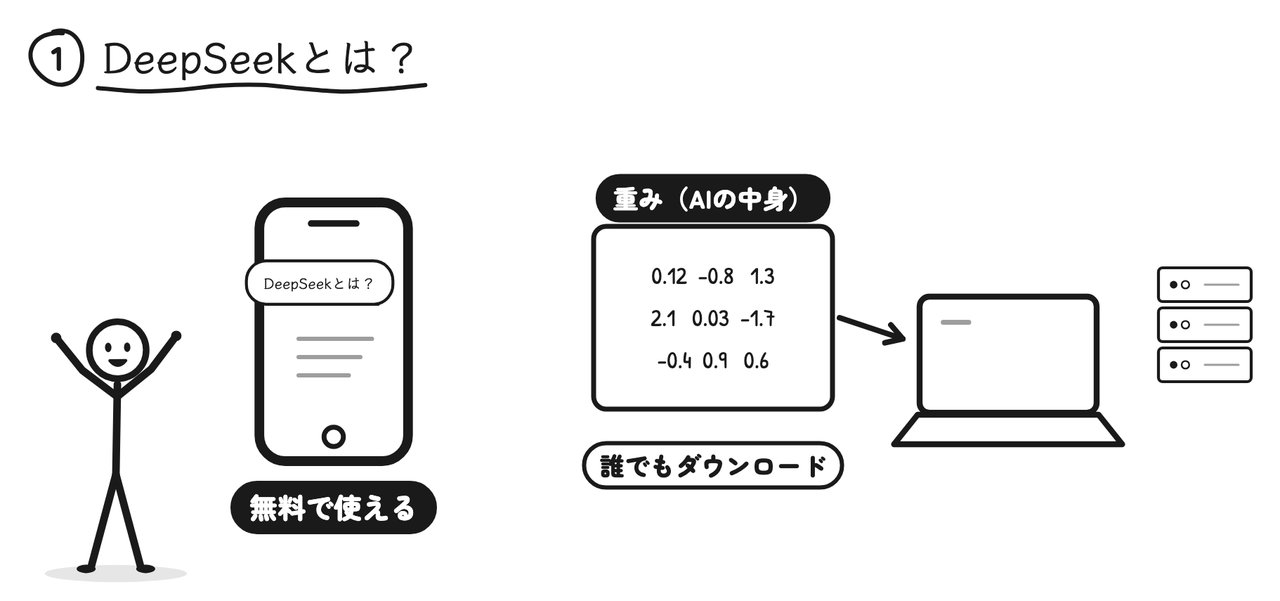
「重み」というのは、AIが学習を通して身につけた知識を表す、大量の数字のかたまりのことです。
この重みさえあれば、AIを自分の手元で動かすことができます。重みを公開しているAIは「オープンウェイト」のモデルとも呼ばれます。
| 重みを公開しているAI | 重みを公開していないAI | |
|---|---|---|
| 例 | DeepSeek、MetaのLlama など | ChatGPTのGPT、Claude、Gemini など |
| 使い方 | ダウンロードして、自分の環境で動かせる | 開発元のアプリやAPIから使う |
| データの行き先 | 自分の環境の中だけで完結できる | 開発元のサーバーに送られる |
| 手間 | 動かすための機械や設定が必要 | すぐに使える |
ChatGPTとの違い
冒頭の「ChatGPTと何が違うの?」にも答えておきましょう。
チャットで質問できる、という使い方はほとんど同じです。ちがいが出るのは、作っている会社と、中身の公開のしかた、そしてデータの行き先です。
| ChatGPT | DeepSeek | |
|---|---|---|
| 開発元 | OpenAI(アメリカ) | DeepSeek(中国・杭州) |
| チャットのアプリ | 無料で使える(有料のプランもある) | 無料で使える |
| AIの中身(重み) | 主力のモデルは公開していない | 公開している |
| 入力した内容の保存先 | OpenAIのサーバー | 中国にあるサーバー |
ChatGPTのもとになっている大規模言語モデル(LLM)の仕組みについては、以下の記事を参考にしてみてください。
 大規模言語モデル(LLM)の仕組みや種類について分かりやすく解説!当サイト【スタビジ】の本記事では、大規模言語モデル(LLM)の仕組みや種類について分かりやすく解説していきます。ChatGPTなどの大規模言語モデルの基本を理解してこのAI時代の流れに乗り遅れないようにしましょう!
DeepSeekショック
それでは、世界が驚いた「DeepSeekショック」を見ていきましょう!
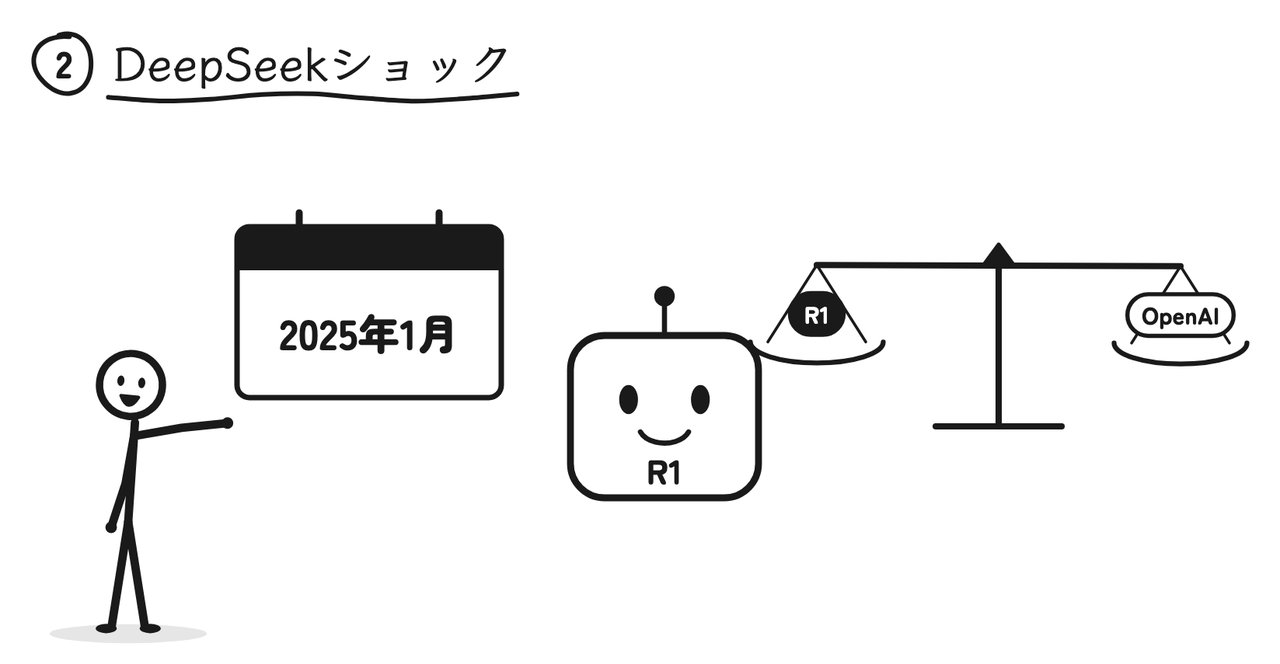
2025年1月、「R1」が登場
2025年の1月、DeepSeekは「R1」という、じっくり考えてから答えるタイプのAIを公開しました。
いきなり答えを書くのではなく、頭の中で考える過程を積み重ねてから答えるので、数学やプログラミングのような、筋道を立てて考える問題に強いタイプです。
このタイプのAIは「推論モデル」とも呼ばれます。
| ふつうのチャットAI | じっくり考えるAI(推論モデル) | |
|---|---|---|
| 答え方 | すぐに答えを書きはじめる | 考える過程を積み重ねてから答える |
| 得意なこと | 会話、文章を書く、要約 | 数学、プログラミング、筋道を立てる問題 |
| 待ち時間 | 短い | 考えるぶん長くなる |
その実力は、当時のOpenAIの最先端モデル(o1)に、肩を並べるほど。
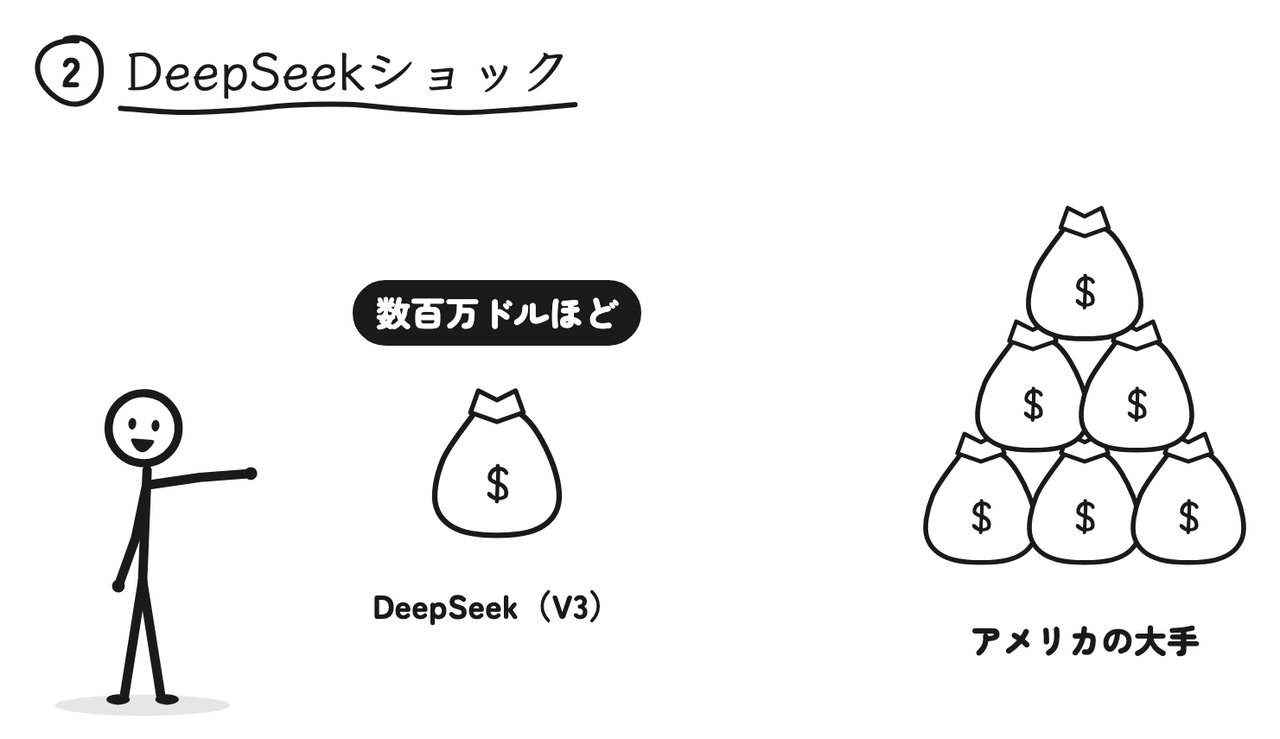
学習にかかった費用は「数百万ドル」
しかも、R1のもとになったモデル「V3」の学習にかかった費用は、数百万ドルほどだったと発表されたんです。
アメリカの大手が、ケタ違いのお金をかけていると言われていた中で、これは衝撃的でした。
App Storeで1位、NVIDIAの株価は急落
それでもアプリは、アメリカのApp Storeで、ChatGPTを抜いて無料アプリの1位になりました。
さらに、AI向けの半導体を作るNVIDIAの株価が、1日で大きく下がる事態になったんです!
「高い半導体を大量に買わなくても、賢いAIが作れるのでは?」という見方が、一気に広がったからです。
| 起きたこと | 何が驚かれたのか |
|---|---|
| R1の公開 | 当時の最先端に肩を並べる実力 |
| V3の学習費用の発表 | 最後の学習1回分とはいえ、数百万ドルほど |
| App Storeで1位 | アメリカでChatGPTを抜いた |
| NVIDIAの株価の急落 | 半導体の需要が減るのでは、という見方が広がった |
DeepSeekショックのその後
DeepSeekショックのあと、AIの世界の流れも変わっていきました。
1つは、じっくり考えてから答える推論モデルが、各社から次々に出てくるようになったこと。
もう1つは、重みを公開したモデルへの注目が高まったことです。それまで主力モデルの重みを公開してこなかったOpenAIも、2025年8月に、重みを公開したモデル「gpt-oss」を出しています。
「最先端のAIは、お金をかけられる一部の大手だけのもの」という思い込みを、DeepSeekが崩したわけですね。
DeepSeekが安く作れた理由
続いて、なぜDeepSeekは安く作れたのでしょうか?
実はDeepSeekは、アメリカの輸出規制で、最新の高性能な半導体を自由に手に入れられない立場にありました。
限られた半導体で、どう賢いAIを作るか。そこで生まれた工夫を、3つ紹介します。
① MoE:専門家の集まり
1つ目は「MoE(Mixture of Experts)」。専門家の集まりのような仕組みです。
モデルの中にたくさんの「専門家」がいて、質問ごとに、必要な専門家だけが呼ばれて働きます。
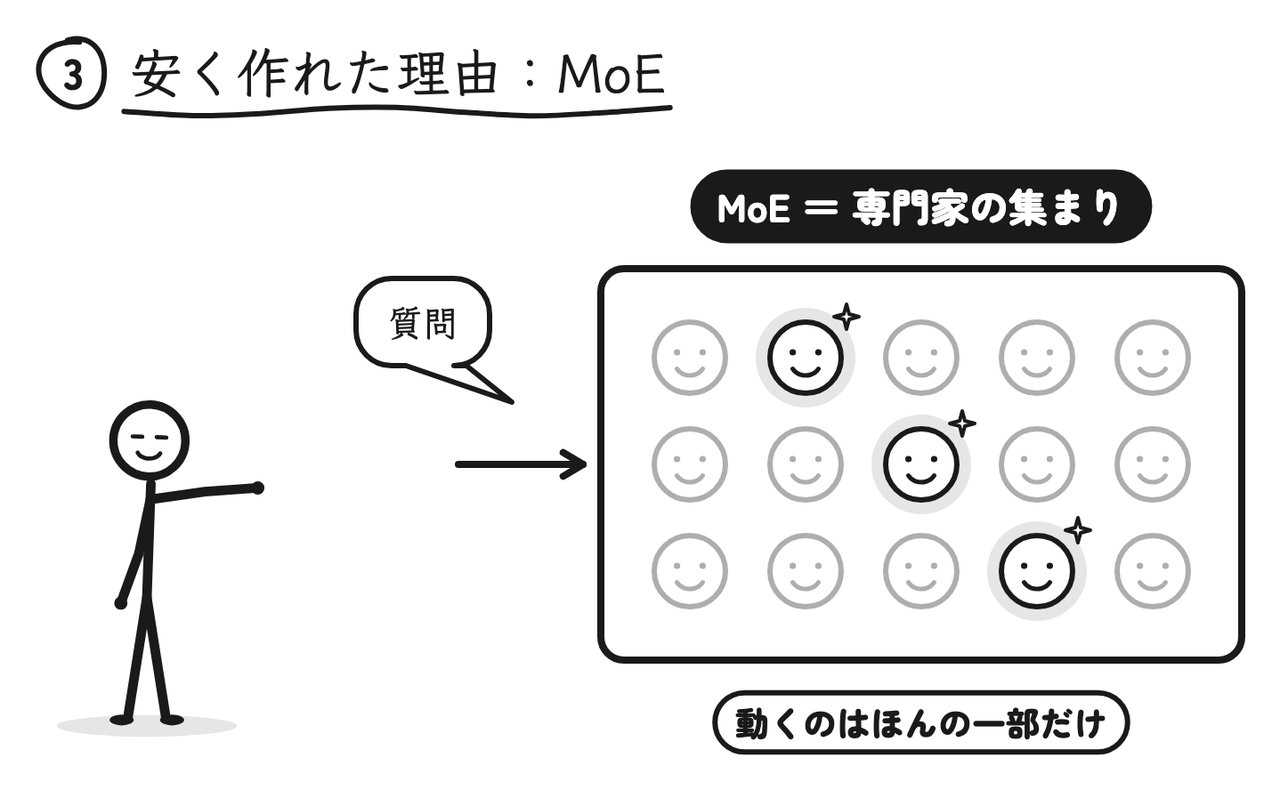
全体はとても大きいのに、1回に動くのはほんの一部だけ。
だから計算をぐっと減らせるんです!
たとえばV3は、全体で約6,710億個のパラメータ(重みの数)を持っていますが、1つの言葉(トークン)を処理するときに動くのは、そのうち約370億個だけです。
大きな総合病院をイメージすると分かりやすいかもしれません。
病院には、いろんな科のお医者さんがたくさんいますよね。でも、患者さんを診るのは、その症状に合った科の先生だけ。全員が毎回集まるわけではありません。
MoEも同じで、知識はたっぷり持ちながら、動かすのは必要な専門家だけにしているわけです。
どの専門家を呼ぶかは、モデルの中にある「ルーター」と呼ばれる小さな仕組みが、言葉ごとに決めています。病院の受付の係が、症状を聞いて担当の科に回しているようなイメージですね。
② 強化学習:「合っていたらほめる」をくり返す
2つ目は、強化学習です。
R1は、人がお手本を大量に用意する代わりに、「答えが合っていたらほめる」をくり返して、考え方を身につけていきました。
数学の問題なら、答えが正しいかどうかは機械的に確かめられますよね。正解なら花丸、不正解ならバツ。これを何度もくり返すんです。
すると、AIが自分で答えを見直したり、考え直したりするようになったんです。
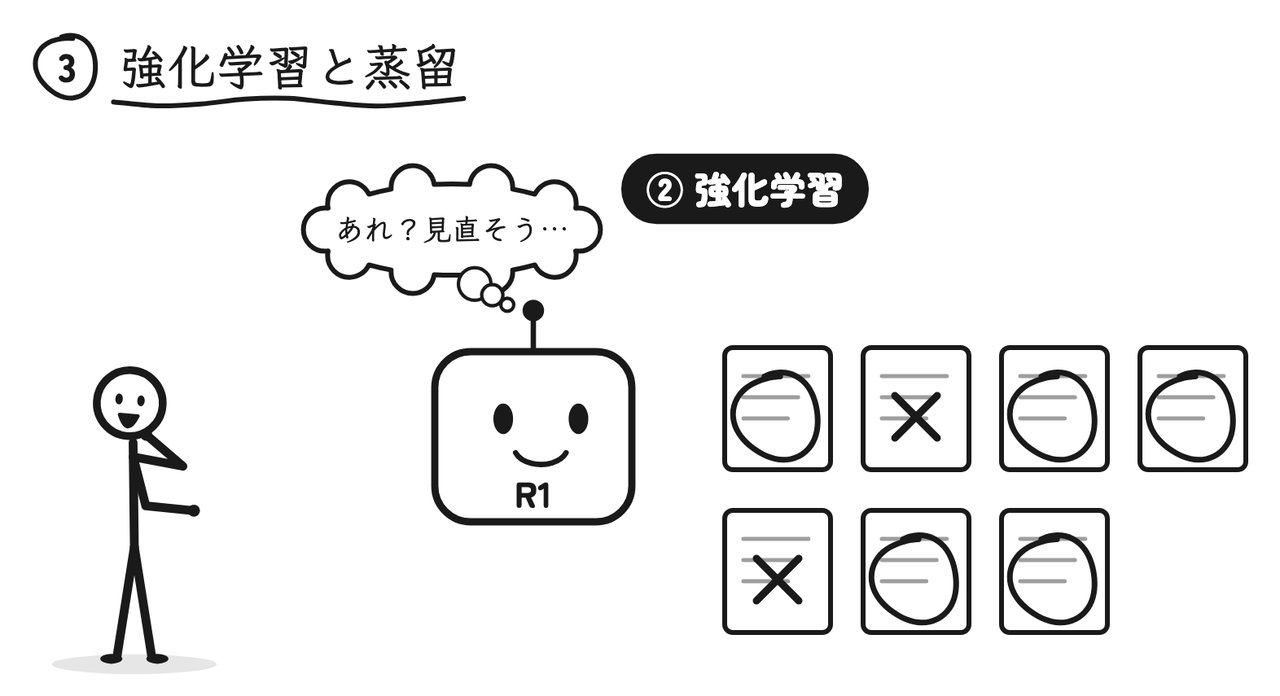
R1の論文では、学習の途中でAIが「待てよ」と自分の考えを見直しはじめた場面を、「aha moment(ひらめきの瞬間)」として紹介しています。
人が考え方を一つひとつ教えなくても、ほめ方を工夫するだけで、考える力が育っていったわけですね。
強化学習の基本については、以下の記事で具体例と一緒に解説しています。
 強化学習を具体例と共にわかりやすく解説!Q学習をPythonで実装してみよう!当サイト【スタビジ】の本記事では、強化学習について具体例と共に解説していきます!また最終的に強化学習の中で最も一般的なアルゴリズムであるQ学習をPythonで実装していきます。迷路の最適経路を見つけるプログラムを作っていきますよ!
③ 蒸留:大きなAIの答え方を小さなAIに教え込む
3つ目は「蒸留」です。
大きなR1の答え方を、小さなモデルに教え込むことで、ふつうのパソコンでも動く、軽くて賢いモデルを作りました。
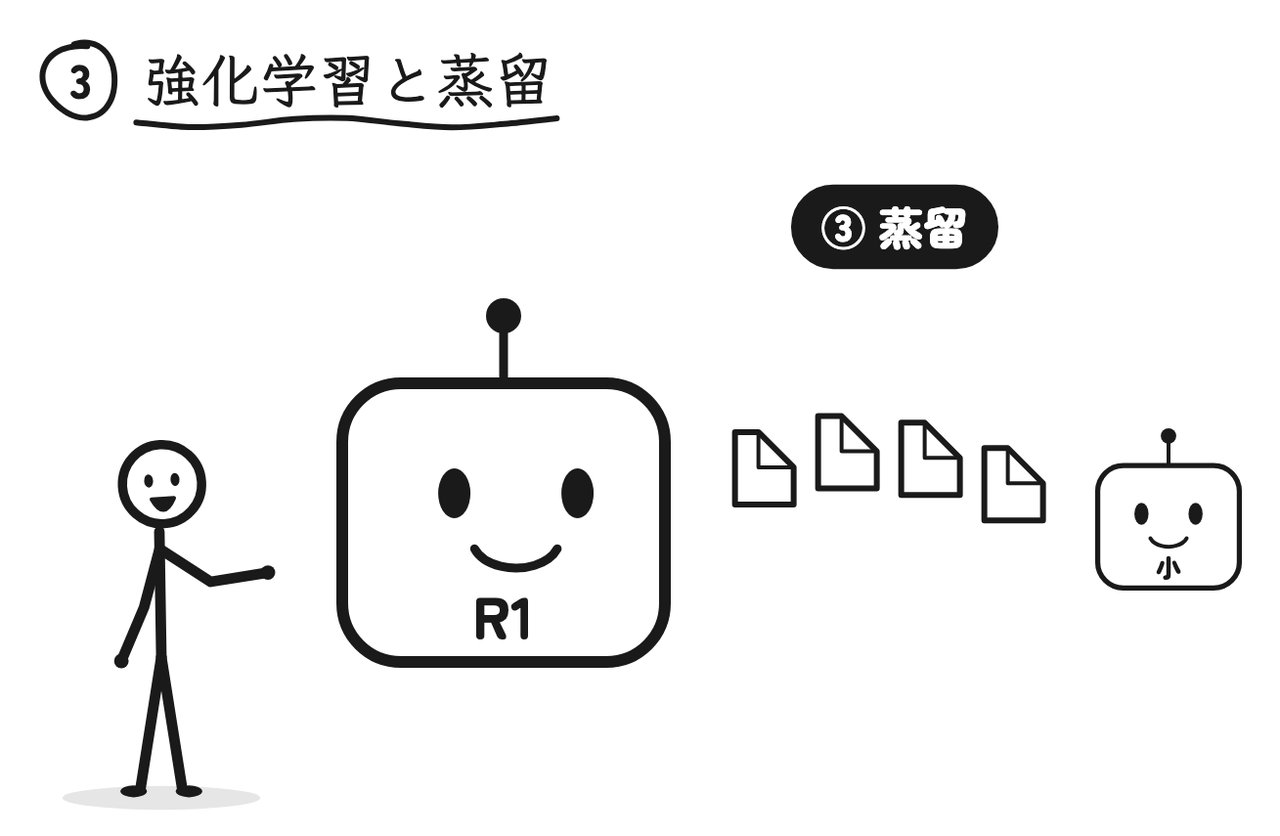
先生(大きなAI)が問題を解いたときの答え方を、生徒(小さなAI)がまねして学ぶ、というイメージです。
DeepSeekは、QwenやLlamaといった公開されているモデルをもとに、R1の答え方を教え込んだ小さなモデルも公開しました。
蒸留そのものは、DeepSeekが生み出した方法ではありません。大きなAIを小さく軽くするために、以前から使われてきた方法です。
DeepSeekは、それを「考える力」の受け渡しにうまく使ったわけです。小さなモデルなら、高い機械がなくても動かせて、動かすお金も少なくて済みます。
3つの工夫のまとめ
| 工夫 | どんな仕組み? | 何が減る? |
|---|---|---|
| MoE | 質問ごとに、必要な専門家だけを動かす | 1回あたりの計算 |
| 強化学習 | 答えが合っていたらほめる、をくり返す | 人が用意するお手本の量 |
| 蒸留 | 大きなAIの答え方を、小さなAIに教え込む | 動かすのに必要な機械 |
お金や半導体が足りない分を、アイデアで補う。
この工夫の積み重ねこそが、DeepSeekの強さなんです!
今のDeepSeek
それでは、今のDeepSeekを見ていきましょう!
V4シリーズの登場
DeepSeekはその後も、新しいモデルを次々と公開しています。
| 時期 | モデル | ポイント |
|---|---|---|
| 2024年12月 | V3 | MoEで計算を減らした大きなモデル |
| 2025年1月 | R1 | じっくり考えてから答える。DeepSeekショックのきっかけ |
| 2025年 | V3.1、V3.2 | V3を改良したモデル |
| 2026年 | V4シリーズ | とても長い文章も、一度に読み込めるように |
| 2026年10月17日 | V4.1-Flashの新しいバージョン | 本記事を書いている2026年10月時点の最新モデル |
2026年には「V4」シリーズが登場し、とても長い文章も、一度に読み込めるようになりました。
AIが一度に読み込める文章の長さは「コンテキスト長」と呼ばれます。これが長いほど、分厚い資料や大きなプログラムをまるごと渡して、質問できるようになります。
中国のファーウェイの半導体でも動かせるようにするなど、アメリカの半導体に頼らない動きも進めているんです!
最新モデル「V4.1-Flash」
そして2026年10月17日、DeepSeekは最新モデル「V4.1-Flash」の、新しいバージョンを公開しました。
前のバージョンより賢くなったうえに、作業を速く終わらせて、答えも短くなり、無駄が減りました。
DeepSeek自身のテストでは、プログラミングやAIエージェントの一部のテストで、ClaudeやGPTの最新モデルを上回ったとしています。
しかも、1つの作業にかかるコストは、ライバルのAIと比べてケタ違いに安いという結果に。
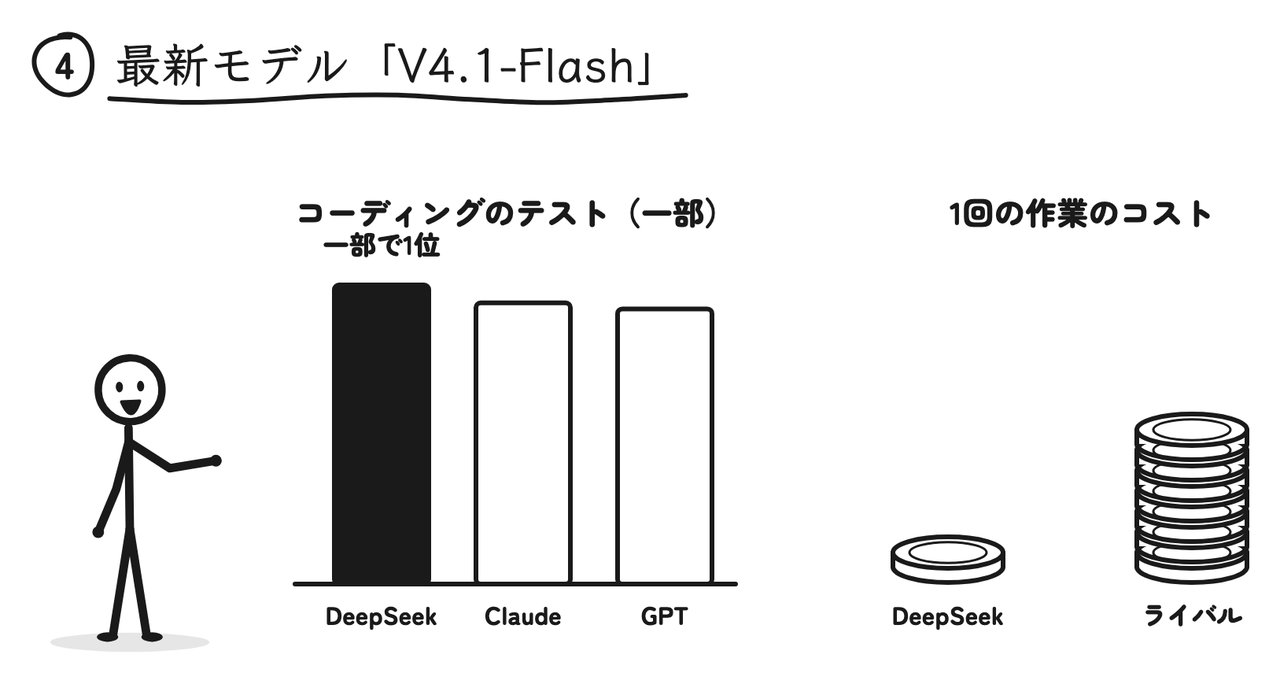
さらに、画像も理解できて、重みも公開。SNSでも大きな話題になっているんです!
答えが短くなって無駄が減ると、そのぶん待ち時間も料金も減ります。たくさんの作業をAIに任せる使い方では、この差が効いてくるわけですね。
DeepSeekを使うときの注意点
ただし、気をつけたいこともあります。
入力した内容は中国のサーバーに保存される
DeepSeekのアプリやWebで入力した内容は、中国にあるサーバーに保存されます。
そのため日本でも、政府の仕事で使うときには注意するよう、デジタル庁が呼びかけました。
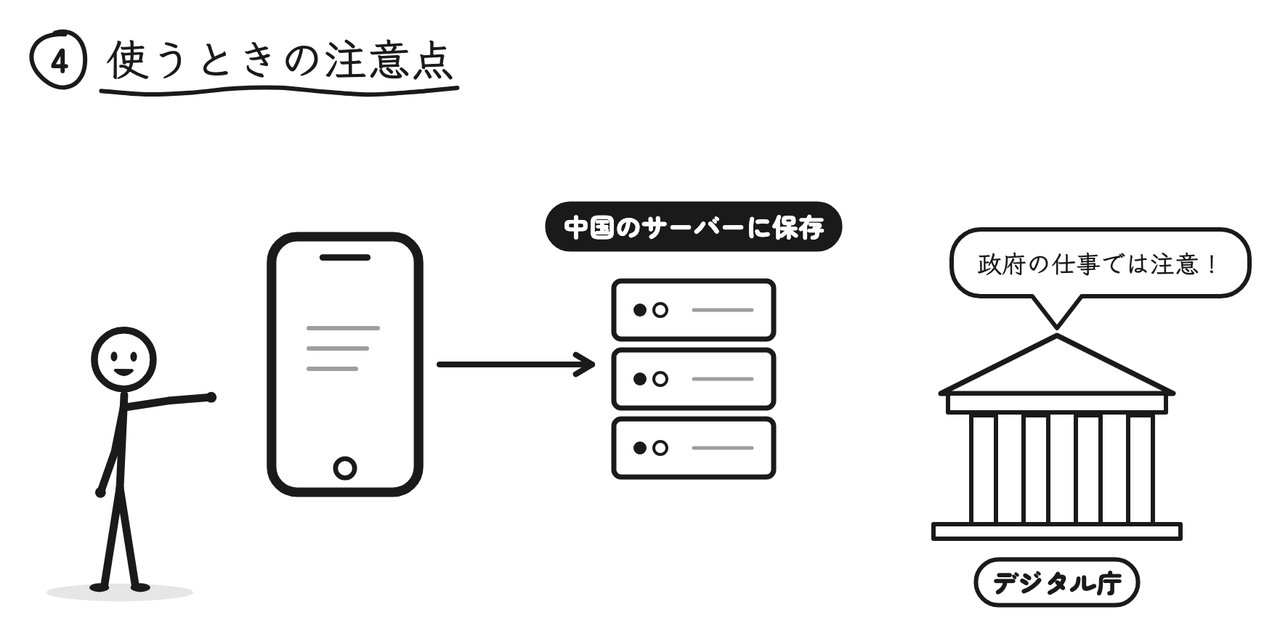
さらに、イタリアや韓国では、アプリのダウンロードが止められたこともあるんです。
答えを避ける話題がある
また、中国政府にとって敏感な話題には、答えを避けることがある、とも言われています。
政治や歴史に関わる質問では、答えがかたよったり、答えてもらえなかったりすることがある、と頭に入れておきましょう。
使い分けのコツ
気をつけたいことと、その対策を表にしておきます。
| 気をつけたいこと | 対策 |
|---|---|
| 入力した内容が中国のサーバーに保存される | 個人情報や仕事の大事な情報は入力しない |
| 会社や役所のルールで使えないことがある | 仕事で使う前に、社内のルールを確かめる |
| 答えを避ける話題がある | 政治や歴史などは、ほかの情報源でも確かめる |
| データを外に出したくない | 公開されている重みを使って、自分の環境で動かす |
大事な情報は入力しない。気になるときは、公開されている重みを使って、自分の環境で動かす。
こうした使い分けが大切なんです!
自分の環境で動かせば、入力した内容が外のサーバーに送られることはありません。
ただし、学習で身についた答え方のくせまでは消えないので、答えを避ける話題があることは、自分の環境で動かすときも頭に入れておきましょう。
AIを自分のパソコンで動かす方法は、以下の記事で解説しています。
 【入門】ローカルLLMって何?概要と使い方を徹底解説!当サイト【スタビジ】の本記事では、クラウドに頼らず自分のPCだけで大規模言語モデルを動かす「ローカル LLM」をわかりやすく解説します!
DeepSeekのまとめ
最後に、今回のポイントをおさらいしましょう!
ウマたん要は、お金の量だけでなく、工夫しだいで最先端のAIは作れる、ということを、DeepSeekは世界に示したんです!ぜひ、AIのニュースを見るときは、今回のポイントを思い出してみてください!
生成AIやLLMを体系的に学びたいのであれば、当メディアが運営するスクール「スタアカ」がオススメです!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる