カーネルとは?機械学習のカーネル法・カーネルトリックからCNN・Linuxまで分かりやすく解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では、「カーネル」という言葉について分かりやすく解説していきます!機械学習のカーネル法やカーネルトリックを中心に、CNNの畳み込みカーネル、Linuxカーネルまで、まとめて整理していきましょう!
こんにちは!ウマたんです!
AIの勉強をしていると、「カーネル法」とか「SVMのカーネルトリック」とか、あるいは「Linuxカーネル」なんて言葉をよく聞きますよね。
でも、「カーネルって何者?」と聞かれると、意外と説明しづらいものです。
しかも、分野によって指しているものが少しずつちがうので、混乱しやすい言葉なんです。
今回は、この「カーネル」という言葉の本質と、機械学習やコンピューターの世界でどう使われているのかを、まとめて見ていきます。

SVMの本を読んでたら「カーネルトリック」が出てきて、急に分からなくなった…

CNNの「カーネル」とSVMの「カーネル」って、同じものなの?
本記事では、次の5つを順番に解説していきます。
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!

カーネルとは?
まずは、そもそも「カーネル」とは何かから見ていきましょう。
英語で「核」や「中心」という意味
カーネル(kernel)という言葉は、英語で「核」や「中心」を意味します。
もともとは、果物の種の中にある、やわらかい中身のことを指す言葉です。
そこから、システムやアルゴリズムの「中心部分」というイメージで使われるようになりました。
分野によって意味が少し変わる
ただし、カーネルは分野によって、指しているものが少しずつ変わってきます。
| 分野 | カーネルが指すもの |
|---|---|
| 機械学習・数学 | データを別の空間に変換して扱いやすくする関数(データどうしの似ている度合いを測る関数) |
| ディープラーニング(CNN) | 画像から特徴を取り出す、小さな数字の表(フィルター) |
| コンピューター(OS) | OSの中核となる部分(Linuxカーネルなど) |
コンピューターの世界では、LinuxカーネルなどOSの中核部分を表します。
一方で、機械学習や数学の世界では、データを別の空間に変換する関数を表します。
今回は、この機械学習におけるカーネルを中心に話していきます!
機械学習のカーネルの役割
機械学習のカーネルの役割を一言で言うと、データを変換して、線形(直線や平面)で扱えるようにすることです。
直線では分けられないデータ
たとえば、あるデータが、円の内側と外側に分かれて散らばっているとします。
この状態では、内側のグループと外側のグループを、1本の直線で分けることはできません。
どこに直線を引いても、どちらかのグループを真っ二つにしてしまいますよね。
次元を1つ足すと、平面で分けられる
ところが、データを高い次元の空間に移してあげると、話が変わります。
たとえば、元の2つの値 に加えて、3つ目の値として「原点からの距離の2乗」 を「高さ」として足してみます。
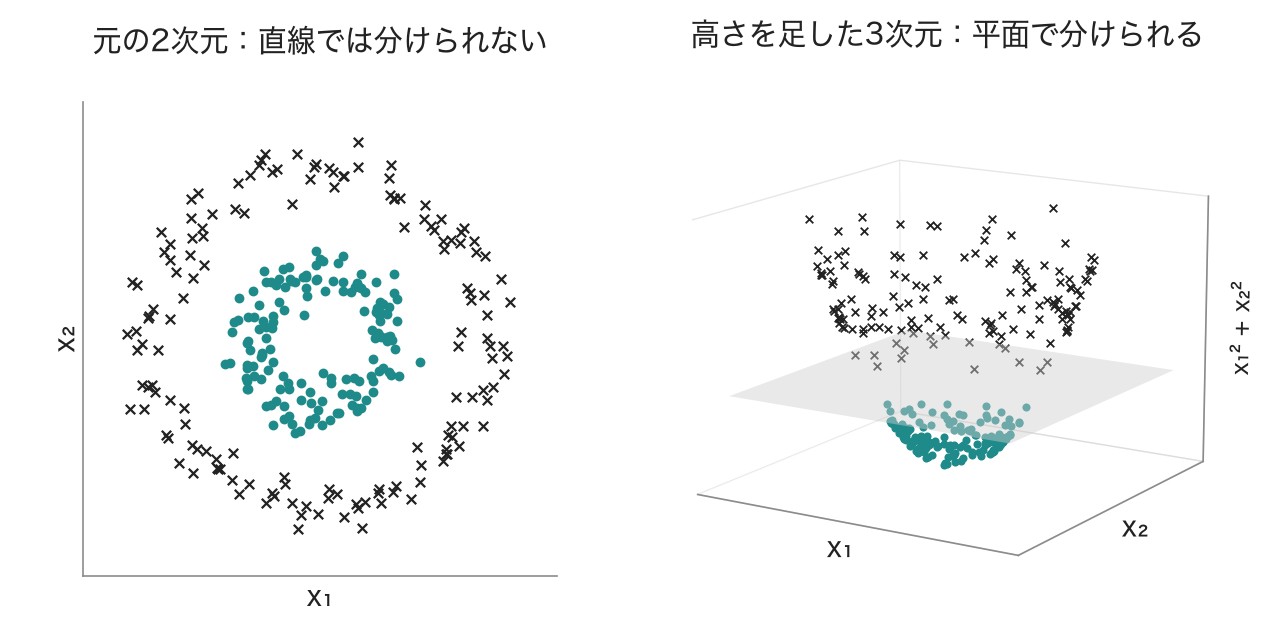
すると、円の内側にあったデータは低いところに、外側にあったデータは高いところに集まります。
こうなれば、1枚の平らな板(平面)を間に差し込むだけで、きれいに分けられるんです!
もともと2次元だと分離できないように見えたデータが、1次元追加して3次元にすることで、平面で分離できるようになったわけですね。
高い次元の空間に変換して、扱いやすくする魔法。これこそがカーネルの本質なんです!
カーネル関数は「似ている度合い」を測る
もう少しだけ正確に言うと、機械学習でいう「カーネル関数」は、2つのデータ と を受け取って、変換した先の空間での「似ている度合い」(内積)を返す関数です。
ここで (ファイ)は、データを高い次元の空間に移す変換です。
よく使われるカーネル関数には、次のようなものがあります。
| カーネル | 式 | 特徴 |
|---|---|---|
| 線形カーネル | 変換しない。直線(平面)で分ける | |
| 多項式カーネル | 特徴量どうしのかけ算の組み合わせまで考える | |
| RBFカーネル(ガウスカーネル) | 近いデータほど似ているとみなす。もっともよく使われる |
特にRBFカーネルは、どんな形の境界線にも柔軟に対応しやすく、まず最初に試されることが多いカーネルです。
SVMとカーネルトリック
では、このカーネルを使った具体例を見ていきましょう。
カーネルの代表的な使い方が、「サポートベクターマシン(SVM)」です。
SVMは「一番広い境界線」を探すモデル
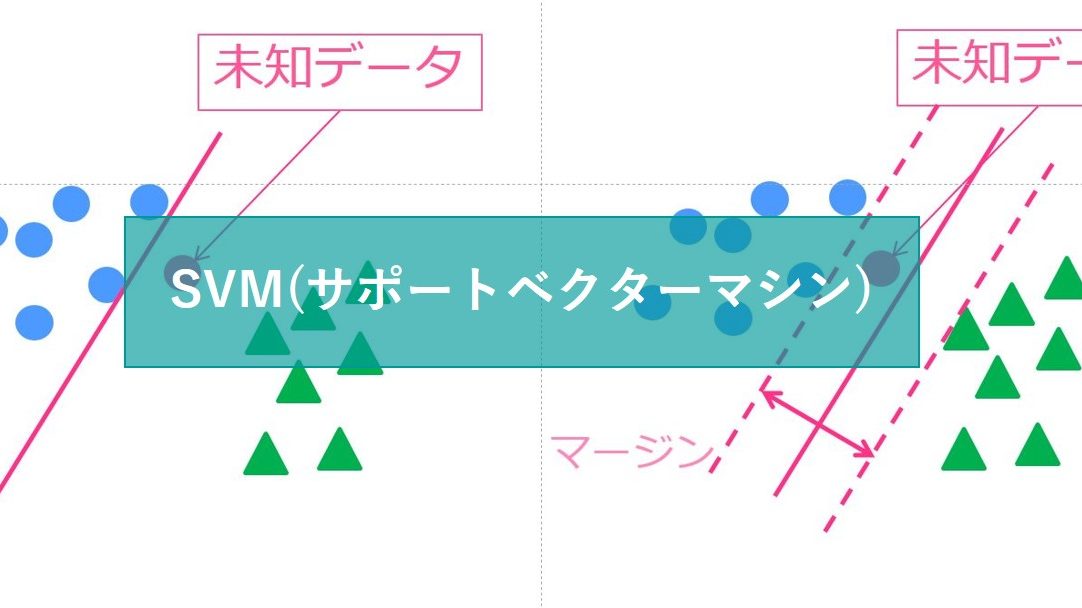
SVMは、データを2つのグループに分けるための、最も広い境界線を見つけるモデルです。
境界線と、そのすぐ近くにあるデータとの間の幅(マージン)ができるだけ広くなるように、線を引くんです。
ただ、SVMはもともと「直線(平面)で分ける」モデルなので、データが線形に分離できないときに困ってしまいます。
SVMの仕組みは、以下の記事で詳しく解説しています。
 SVM(サポートベクターマシン)とは?特徴とRによる実装!当サイト【スタビジ】の本記事では、機械学習手法の中でもアルゴリズムが分かりやすい上に汎化能力が高い優秀な手法SVM(サポートベクターマシン)についてまとめていきます!理論とRでの実装を合わせて見ていきますよー!
高い次元に移さなくても、同じ計算ができる
そこで登場するのが「カーネルトリック」です。
先ほどの例では、データに「高さ」を足して、実際に3次元に移していました。
でも、データの次元がもっと多かったり、もっと複雑な変換が必要だったりすると、実際に変換するのは大変ですよね。
カーネルトリックを使うと、実際に高い次元に変換しなくても、カーネル関数というちょっと特殊な計算だけで、高い次元の空間での「似ている度合い」や距離を求めることができるんです。
つまり、高い次元の空間を、こっそり(暗黙的に)扱えるわけですね。
かんたんな例で確かめてみよう
たとえば、2次元のデータ と に、次のようなカーネルを使うとします。
これを展開すると、次のようになります。
実はこれは、データを という3次元に変換してから、内積をとったものと同じなんです。
| やり方 | 計算の手順 |
|---|---|
| まじめに変換する | 2つのデータをそれぞれ3次元に変換して、内積をとる |
| カーネルトリック | 元の2次元のまま内積をとって、2乗するだけ |
どちらも答えは同じなのに、カーネルトリックなら、3次元の世界に一度も行かずに済みます。
次元が何百、何千と増えても、計算は元の次元のままで済むのが、カーネルトリックのすごいところです。
ちなみにRBFカーネルの場合、変換先の空間を書き出すと、なんと無限次元になります。それでも、カーネル関数を使えば、ふつうに計算できてしまうんです!
Pythonで効果を確かめてみよう
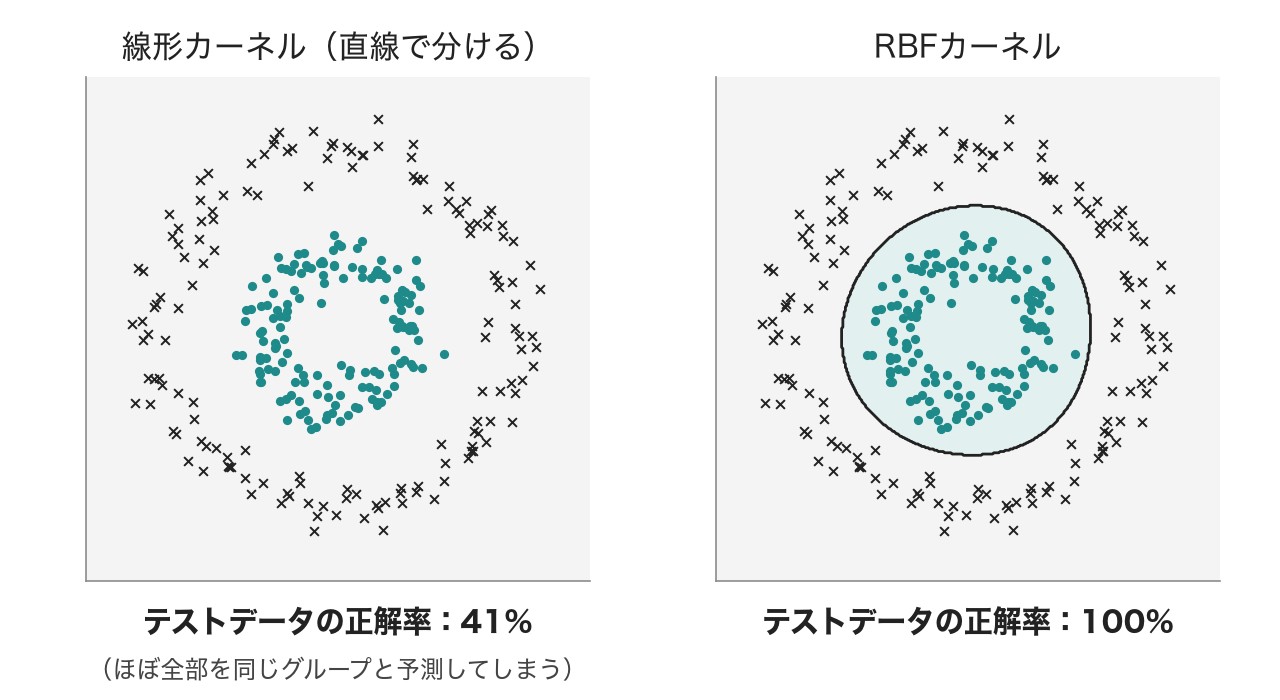
実際に、円の内側と外側に分かれたデータで、SVMのカーネルを変えて試してみましょう。
import numpy as np
from sklearn.datasets import make_circles
from sklearn.model_selection import train_test_split
from sklearn.svm import SVC

# 内側と外側の2つの円に分かれたデータ
X, y = make_circles(n_samples=300, factor=0.4, noise=0.08, random_state=0)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=0)

# ① 線形カーネル(直線で分ける)
linear = SVC(kernel="linear").fit(X_train, y_train)
print("線形カーネル:", linear.score(X_test, y_test))

# ② 自分で「高さ」の特徴量を足して3次元にしてから、直線(平面)で分ける
def add_height(X):
    return np.c_[X, (X ** 2).sum(axis=1)]  # x1, x2, x1²+x2²

lifted = SVC(kernel="linear").fit(add_height(X_train), y_train)
print("3次元にしてから線形:", lifted.score(add_height(X_test), y_test))

# ③ RBFカーネル(カーネルトリックにおまかせ)
rbf = SVC(kernel="rbf").fit(X_train, y_train)
print("RBFカーネル:", rbf.score(X_test, y_test))
線形カーネル: 0.4111111111111111
3次元にしてから線形: 1.0
RBFカーネル: 1.0線形カーネルの正解率は約41%。2つのグループを、ほとんど見分けられていません。
一方、自分で「高さ」を足して3次元にした場合と、RBFカーネルを使った場合は、どちらも正解率100%になりました!
②では「どんな変換をすればいいか」を人が考える必要がありました。
RBFカーネルなら、変換を自分で考えなくても、データに合わせて曲がった境界線を引いてくれるんです。
 過学習とは?ランダムフォレストなどの機械学習における過学習の対策方法をまとめていく!当サイト【スタビジ】の本記事では、データ分析時に気を付けなくてはいけない過学習についてまとめていきます。過学習はどんな時に起こるのか理解した上で、過学習を回避する方法についても詳しく見ていきますよー!データ分析時の参考にしてくださいね!
カーネル法はSVMだけじゃない
カーネルを使って、線形の手法を曲がった関係にも使えるようにする方法をまとめて「カーネル法」と呼びます。
SVMのほかにも、次のような手法があります。
| 手法 | カーネルを使って何ができる? |
|---|---|
| サポートベクターマシン(SVM) | 曲がった境界線で分類できる |
| カーネル主成分分析 | 曲がった構造を持つデータの次元削減ができる |
| カーネルリッジ回帰 | 曲線的な関係を回帰で予測できる |
| ガウス過程回帰 | 予測とあわせて、予測の不確かさも出せる |
最近は、ディープラーニングの広がりとともに、カーネルという言葉を聞く機会が少しずつ減ってきているかもしれません。
でも実は、ディープラーニングの内部でも、カーネル的な考え方は生きているんです。
ディープラーニングの中のカーネル(CNNの畳み込みカーネル)
その1つが、画像認識でおなじみの「畳み込みニューラルネットワーク(CNN)」で使われる「畳み込みカーネル」です。
画像の一部にフィルターをかけて特徴を取り出す
CNNでは、画像の一部に「カーネル(フィルター)」をかけて、特徴を取り出します。
この場合のカーネルは、数学的な変換というよりも、入力データから特徴を取り出すための、小さな数字の表(行列)という意味で使われています。
たとえば、次のような3×3のカーネルを考えてみましょう。
これを画像の上で少しずつずらしながら、重なった部分のピクセルとかけ算して足し合わせていきます。
すると、左が暗くて右が明るい場所、つまり「縦の線(エッジ)」があるところで、大きな値が出てくるんです。
CNNでは、このようなカーネルの数字を人が決めるのではなく、学習によって自動で見つけていきます。
| SVMのカーネル | CNNの畳み込みカーネル | |
|---|---|---|
| 正体 | 2つのデータの似ている度合いを測る関数 | 画像の一部にかける小さな数字の表(フィルター) |
| 役割 | データを高い次元に移して、分けやすくする | 画像から線や模様などの特徴を取り出す |
| どうやって決める? | 使うカーネルを人が選ぶ(RBFなど) | 学習で自動的に決まる |
見た目はかなりちがいますが、データを変換して、本質を浮かび上がらせる装置という点は共通しているんです!
CNNの仕組みについては、以下の記事で解説しています。
 畳み込みニューラルネットワーク(CNN)をわかりやすく解説!Pythonで画像認識を実装してみよう!当サイト【スタビジ】の本記事では、ディープラーニングのド定番である畳み込みニューラルネットワーク(CNN)についてわかりやすく解説します。CNNの仕組みを解説した後にPythonにて画像認識タスクを解いていきますよ!
OSのカーネル(Linuxカーネル)
ちなみに、冒頭でも述べたとおり、カーネルという言葉は、AIだけでなくコンピューターの世界でも使われます。
OSの心臓部
たとえば「Linuxカーネル」は、OS(オペレーティングシステム)の心臓部、中核部分です。
カーネルは、ハードウェア(CPUやメモリなど)と、僕たちが使うソフトウェア(アプリ)をつなぐ部分で、次のような仕事をしています。
つまり、中心で全体を動かす仕組み、というわけです。
これも、機械学習のカーネルと同じように、全体の中心にあって、いろいろなものをつなぐ「核」となる部分。名前の由来も、まさに「核」なんですね。
Jupyterの「カーネル」も同じ仲間
データサイエンスを学んでいると、Jupyter Notebookで「カーネルを再起動」というボタンを見かけることもありますよね。
この「カーネル」は、ノートブックに書いたPythonのコードを、裏側で実際に実行しているプログラムのことです。
これも、ノートブックの「中心」で計算を担う部分なので、カーネルと呼ばれているんです。
| よく聞く言葉 | 何のカーネル? |
|---|---|
| カーネル法・カーネルトリック・RBFカーネル | 機械学習(データの似ている度合いを測る関数) |
| 畳み込みカーネル・カーネルサイズ | CNN(画像にかけるフィルター) |
| Linuxカーネル | OSの中核 |
| Jupyterのカーネル | ノートブックのコードを実行するプログラム |
これで、どの場面で「カーネル」という言葉が出てきても、大丈夫だと思います!
カーネルのまとめ
最後に、今回のポイントをおさらいしましょう!
ウマたん要は、カーネルとは「データを変換して、本質を浮かび上がらせる核」なんです!どの分野のカーネルなのかを意識すれば、もう混乱しなくて大丈夫です!
機械学習やディープラーニングを体系的に学びたいのであれば、当メディアが運営するスクール「スタアカ」がオススメです!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる