SVM(サポートベクターマシン)とは?特徴とRによる実装!
目次
 ウマたん
当サイト【スタビジ】の本記事では、機械学習手法の中でもアルゴリズムが分かりやすい上に汎化能力が高い優秀な手法SVM(サポートベクターマシン)についてまとめていきます!理論とRでの実装を合わせて見ていきますよー!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
機械学習手法の中でも汎化能力が高いとされ使われることの多いSVM(サポートベクターマシン)
この記事では、そんなSVM(サポートベクターマシン)について見ていきます!
ウマたんSVMは実装が容易でそれなりに高い精度をたたき出す優秀な手法だよ!
以下の動画でも簡単に解説していますよ!

他の手法についてはこちらも合わせてチェック!
 パターン認識の事例やAIや機械学習との関連性をわかりやすく解説!当サイト【スタビジ】の本記事では、パターン認識とは何なのかについて具体的な事例や手法、さらにはPythonでの実装方法を交えて分かりやすく解説していきます!
 【これだけはおさえておきたい!】ビジネスで役立つAI用語45選まとめ!当サイト【スタビジ】の本記事では、ディープラーニング系/機械学習系/統計学系の3つのカテゴリに分けて重要な用語を説明していきます!
SVM(サポートベクターマシン)とは
SVMとは、機械学習の中でも有名な手法の1つ。
SVMの特徴は、「マージン最大化」と「カーネルトリック」。
順番に見ていきましょう!
マージン最大化
SVMは「マージン最大化」というアイデアで分類データにおいて非常に高い精度をほこります。
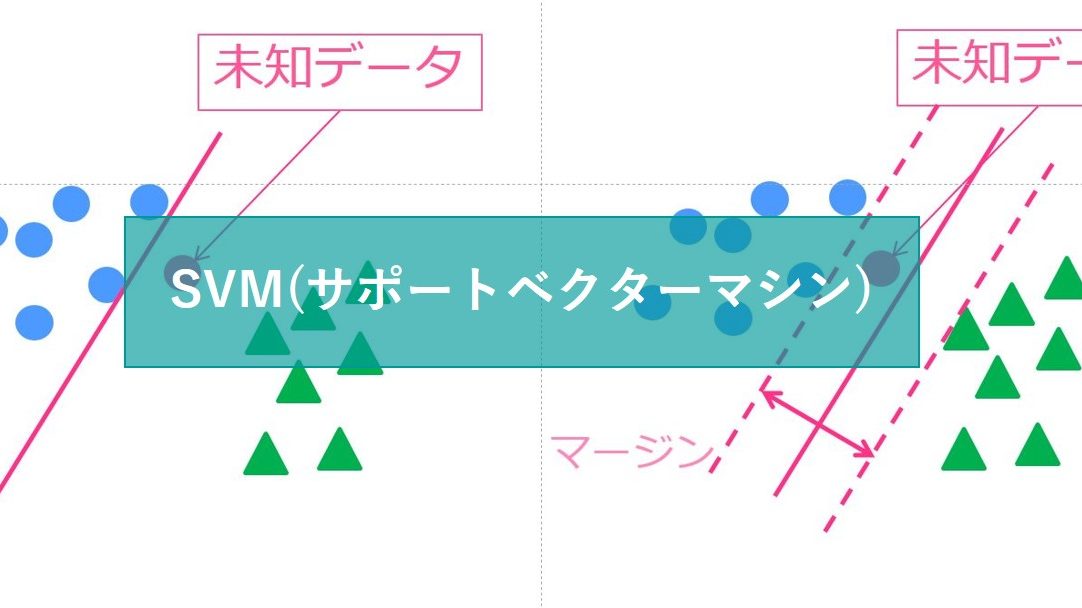
以下の図を見てみてください。
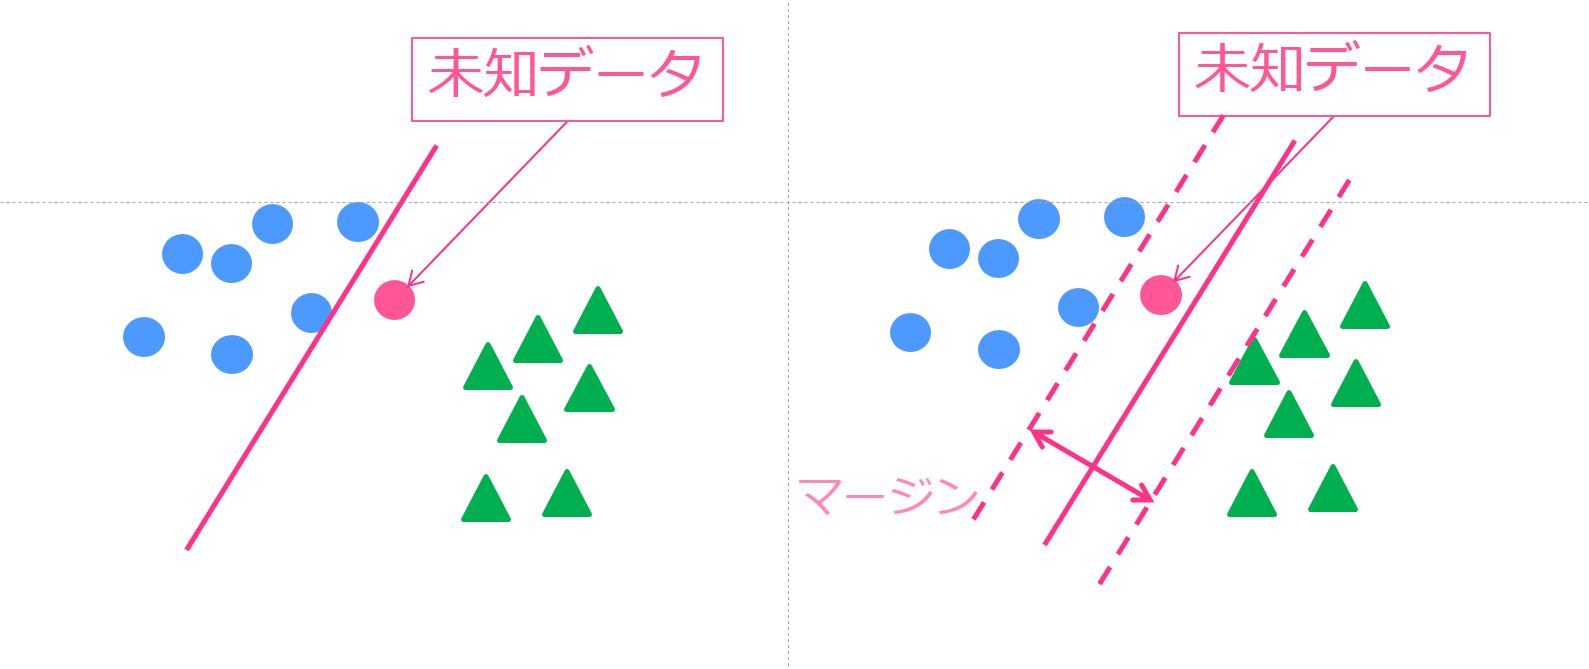
〇と△で分類したいのですが左のような識別境界線を引いてしまうと、新たな未知の〇データに関して上手く分類することができません。
なるべく、右の図のように〇と△の中間地点に識別境界線を引くべきです。
そして、この場合見なくちゃいけないのは境界に近い〇と△のデータ。
これら境界に近いデータのことをサポートベクトルと呼びます。
これらのサポートベクトルのマージンが最大になるように境界線を引く方法が「マージン最大化」であり、SVMの肝になる手法です。
マージン最大化については視覚的に分かりやすいので大丈夫だと思います。
カーネルトリック
カーネルトリックは少々難易度高です。
正直僕自身も完璧に理解しているとは言い難い・・笑
先ほどの例では、線形直線を引いて分類を行いました。
しかしデータの構造的に線形直線で分類出来ることばかりではありません。
データが真ん中に内側と外側に集まっている以下の図のようなパターンもあります。
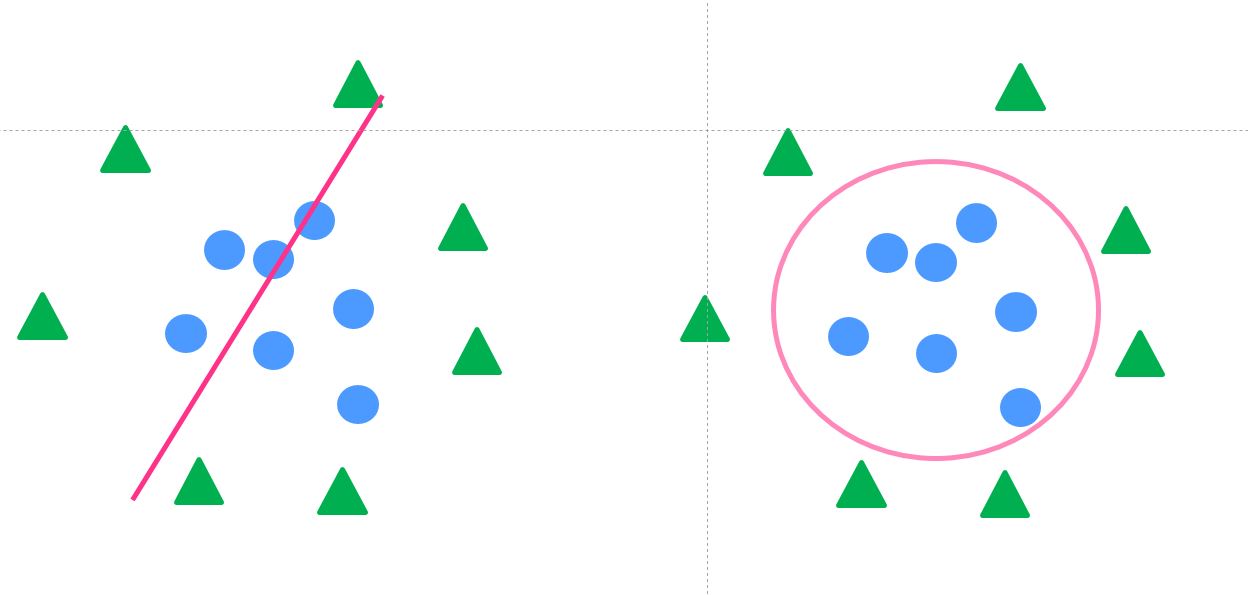
そんな時、左図のように直線では分類できません。
右図のような非線形の識別境界線が必要になってくるのです。
非線形な識別境界線を引くには、データを非線形変換する必要があります。
データ構造が複雑になればなるほど、非線形変換は大変です。
そこで登場するのがカーネルトリック。
カーネルトリックでは、そのような複雑な非線形変換をせずとも非線形識別境界線を引くことが可能なのです。
SVMのメリット
SVMについてなんとなく理解いただけたでしょうか?
さて、そんなSVMですが数ある機械学習手法と比べた時にどんなメリットがあるのでしょうか?
SVMの特徴である「マージン最大化」は、学習データを完璧に分類できれば良い!という考え方とは少し違います。
実は、ある程度分類ができなくても良いというマージンをソフトマージン、なるべく完璧に分類するようなマージンをハードマージンと呼んでいます。
SVMの場合は、ソフト・ハードあれど、マージン最大化を行うことが目的であるので、無理やり全ての学習データを分類するようなモデルは作りません。
一方、他の機械学習手法は学習データに対して過度にフィッティングし完璧に分類しようとします。
そうすると起きるのが過学習と呼ばれる現象。過適合などとも言ったりしますね。
過学習とは、学習モデルにフィッテングし過ぎて、あらたなデータに対する予測精度が悪化してしまうこと。
これは、機械学習手法で結構起こり得る問題なんです。
SVMは、「マージン最大化」というアルゴリズムから過学習が起こりにくくなっているんです。
SVMをRで実装してみよう!
それでは、最後にSVMをRで実装してみます。
有名なタイタニックのデータを用います。Kaggleの公式サイトからデータをダウンロードできます。
まず、データのクレンジングを行い、欠損値は削除、不要と考えられる項目は削除しました。
項目8つ
サンプル数714
この時、生死を目的変数としそれ以外を説明変数とします。
サンプル数714のうちランダムに400個のデータを取り出し学習データとし、残りの314を予測データとします。
学習データで予測モデルを作り、予測データにあてはめ真値と予測値の判別率を精度として比較します。
シミュレーション回数は1000回とし、上記の手順を1000回繰り返し、結果を平均したものを最終アウトプットとします。そのため、結果はばらつきがなく確からしい結果になっているはずです。
SVM(サポートベクターマシン)をランダムフォレスト、ナイーブベイズ、ニューラルネットワーク、XGboost、k近傍法の5手法と比較します!
基本的に引数は全部デフォルトで!果たして結果はどうなるでしょうか!
##様々な手法で予測精度の比較を行う##
##randomForest,SVM,ナイーブベイズ,ニューラルネット
library(xgboost)
library(caret)
library(Matrix)
library(kernlab)
library(randomForest)
library(e1071)
library(nnet)
library(ggplot2)
library(class)
titanic<-read.csv("タイタニック乗船者リスト.csv")##データの読み込み
titanic<-na.omit(titanic)##欠損値削除
titanic$Survived<-as.factor(titanic$Survived)##質的変数に変換
sim<-10##シミュレーション回数
result<-matrix(0,sim,6)##結果の箱
titanic[,4]<-as.numeric(titanic[,4])
titanic[,9]<-as.numeric(titanic[,9])

for(i in 1:sim){
  ####学習データとテストデータに分ける####
  train.id<-sample(nrow(titanic),400)
  train.data<-titanic[train.id,-1]
  test.data<-titanic[-train.id,-1]


  ##randomForest##
  rf<-randomForest(Survived~.,train.data)
  test.data.rf<-cbind(test.data,"predict"=predict(rf,test.data))
  result[i,1]<-sum(test.data.rf$predict==test.data.rf$Survived)/nrow(test.data.rf)


  ##SVM##
  svm<-ksvm(Survived~.,train.data)
  test.data.svm<-cbind(test.data,"predict"=predict(svm,test.data))
  result[i,2]<-sum(test.data.svm$predict==test.data.svm$Survived)/nrow(test.data.svm)

  ##ナイーブベイズ##
  nb<-naiveBayes(Survived~.,train.data)
  test.data.nb<-cbind(test.data,"predict"=predict(nb,test.data))
  result[i,3]<-sum(test.data.nb$predict==test.data.nb$Survived)/nrow(test.data.nb)

  ##ニューラルネット##
  nn<-nnet(Survived~.,train.data,size=5)
  test.data.nn<-cbind(test.data,"predict"=round(predict(nn,test.data),0))
  result[i,4]<-sum(test.data.nn$predict==test.data.nn$Survived)/nrow(test.data.nn)

  ##XGboost##
  label.data.train<-as.integer(train.data$Survived)-1##目的変数を01に
  label.data.predict<-as.integer(test.data$Survived)-1

  train.data.xg<-train.data[,-1]##目的変数取り除く
  test.data.xg<-test.data[,-1]

  xgb.data<-xgb.DMatrix(data.matrix(train.data.xg),label=label.data.train)##Xgb型へ成型
  xgb.data.predict<-xgb.DMatrix(data.matrix(test.data.xg))

  param <- list(
    "objective" = "binary:logistic"
    ,"eta" = 0.01
    # ,"max_depth" = 10
    ,"min_child_weight" = 5
    # ,"subsample" = 1
    # ,"colsample_bytree" = 1
  )##パラメータ適当

  model <- xgboost(
    param=param
    ,data=xgb.data
    ,nrounds=1000
  )##実際の学習

  predict_xgb<-predict(model,xgb.data.predict)

  a<-c()
  m<-length(predict_xgb)#行数

  for(l in 1:m){
    if(predict_xgb[l]>0.5){a[l]<-1}
    else{a[l]<-0}
  }
  result[i,5]<-sum(a==label.data.predict)/length(a)

  #k-nn
  knn<-knn(train.data,test.data,train.data[,"Survived"] ,prob=T,k=3)
  test.data.knn<-cbind(test.data,"predict"=knn)
  result[i,6]<-sum(test.data.knn$predict==test.data.knn$Survived)/nrow(test.data.knn)

}

result.c<-apply(result,2,mean)##simの平均値
result.c<-t(as.matrix(result.c))
result.c<-rbind(result.c,result.c)
result.c<-round(result.c,3)
##グラフ描画
colnames(result.c) <- c("RF","SVM","Bayes","NN","xgb","knn")
df<-data.frame(method=colnames(result.c),result=colMeans(result.c))
gp<-ggplot(df,aes(x=method,y=result,fill=method))
gp<-gp+geom_bar(width=0.8,stat="identity")
gp<-gp+ylab("result")
gp<-gp+geom_text(label=colMeans(result.c),vjust=1)
plot(gp)
kernlabというパッケージに入っているksvmという関数を用いて解析を行っていきます。
##SVM##
svm<-ksvm(Survived~.,train.data)
test.data.svm<-cbind(test.data,”predict”=predict(svm,test.data))
result[i,2]<-sum(test.data.svm$predict==test.data.svm$Survived)/nrow(test.data.svm)
データ加工は描画でいくつかコードを書いていますが、実際にSVMを行っているのはこの数行!
Survived~.はSurvivedを目的変数としてそれ以外を説明変数にするよーということです。
結果は以下のようになりました!
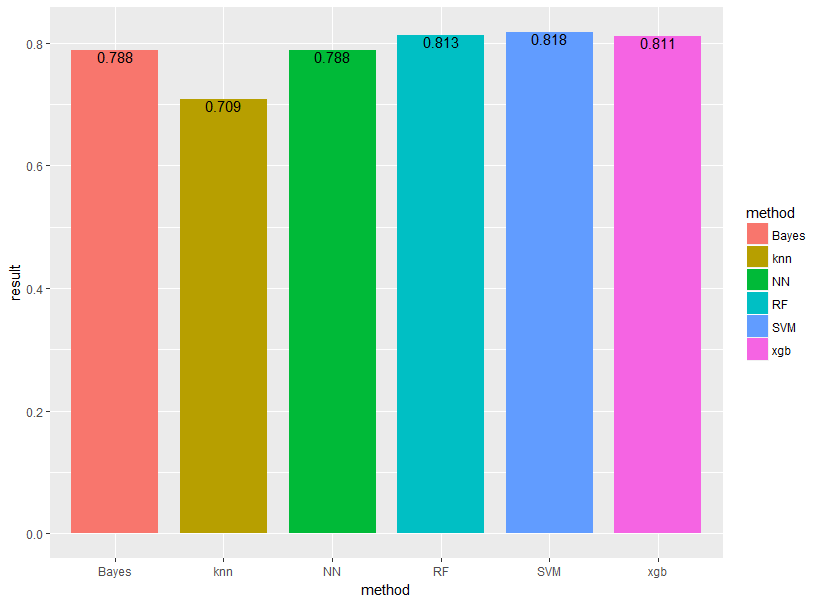 それぞれBayes(ナイーブベイズ)、knn(k近傍法)、NN(ニューラルネットワーク)、RF(ランダムフォレスト)、SVM(サポートベクターマシン)、xgb(XGboost)と表示しています。
見事SVMの勝利!やはりランダムフォレスト・SVM・XGboostあたりが強いですね!
SVMが若干ランダムフォレストよりも精度が良いという結果になっています。
ちなみに計算速度はランダムフォレストの方が速く、SVMは若干遅めです。
SVM(サポートベクターマシン) まとめ
本記事では、SVMの特徴と実装方法について見てきました。
最後にまとめておきましょう!
SVMは非常に優秀な手法ですが、実装が簡単なので是非試してみてください!
ウマたんもっと踏み込んで知りたい人はカーネルトリックについて調べてみるとよいよ!
SVMに関してもっと詳しく知りたいかたは以下の書籍を参考にしてみてください!


ちなみにランダムフォレストをはじめとした機械学習に関して深く勉強したい方は以下の記事を見てみてください!
 【5分で分かる】機械学習の独学勉強ロードマップを徹底的にまとめていく!当サイト【スタビジ】の本記事では、機械学習の独学勉強ロードマップについて徹底的にまとめていきます。機械学習をいきなり理論からしっかり勉強しようとすると挫折しかねません。そこで、この記事ではなるべく挫折しないロードマップをお伝えしてきますよ!
データサイエンス全般について知りたい方は以下の記事をご覧ください。
 【5分で分かる】データサイエンティストに必要なスキルと独学勉強ロードマップ!当サイト【スタビジ】の本記事では、データサイエンティストに求められるスキルとそれを身に付けるための勉強法について徹底的にまとめていきます!入門者でも、しっかりデータサイエンティストについて理解しある程度独学で駆け出しの状態までいけることを目指します。
また、今回はRを使ってきましたが機械学習の文脈ではPythonの方がよく使われていたりします。Pythonを勉強したい方は以下をチェックしてみてください!
 【Python独学勉強法】Python入門を3ヶ月で習得できる学習ロードマップ当サイト【スタビジ】の本記事では、過去僕自身がPythonを独学を駆使しながら習得した経験をもとにPythonを効率よく勉強する方法を具体的なコード付き実装例と合わせてまとめていきます。Pythonはできることが幅広いので自分のやりたいことを明確にして勉強法を選ぶことが大事です。
またこれらの知識を総合的に学べる「スタビジアカデミー(スタアカ)」というスクールを当メディアで運営しておりますので興味のある方は是非チェックしてみてください!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる