【わかりやすく解説】XGboostとは?理論とPythonとRでの実践方法!
目次
 ウマたん
当サイト【スタビジ】の本記事では、機械学習手法の中でも非常に有用で様々なコンペで良く用いられるXgboost(XGブースト)についてまとめていきたいと思います。最後にはPythonとRで他の機械学習手法と精度比較を行っているのでぜひ参考にしてみてください。
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
KaggleやSIGNATEなどのデータ分析コンペでも頻繁に用いられているXGboost。
最近では、LightGBMに王座の場を奪われつつありますが、まだまだ現役で使われている名実ともに最強の教師あり学習手法です。
この記事では、そんなXGboostに関して解説していきたいと思います!
ウマたん教師あり学習でとりあえずよく分からないけど精度出したければXGboostをはじめとする勾配ブースティング木を使っておけば問題ない!(安易)
XGboostとは
XGBoostについて簡単に見ていきましょう!動画でも解説していますよー!

XGboostは「eXtreme Gradient Boosting」の略で2014年に発表された手法です。
勾配ブースティングと呼ばれるアンサンブル学習と決定木を組み合わせた手法で非常に高い汎化能力を誇ります。
アンサンブル学習とは、弱学習器(それほど性能の高くない手法)を複数用いて総合的に結果を出力する方法で、バギングとブースティングというタイプがあります。
バギングは弱学習器を並列に使うイメージ。決定木とバギングを組み合わせたのがランダムフォレストです。
ランダムフォレストの簡単なイメージが以下!
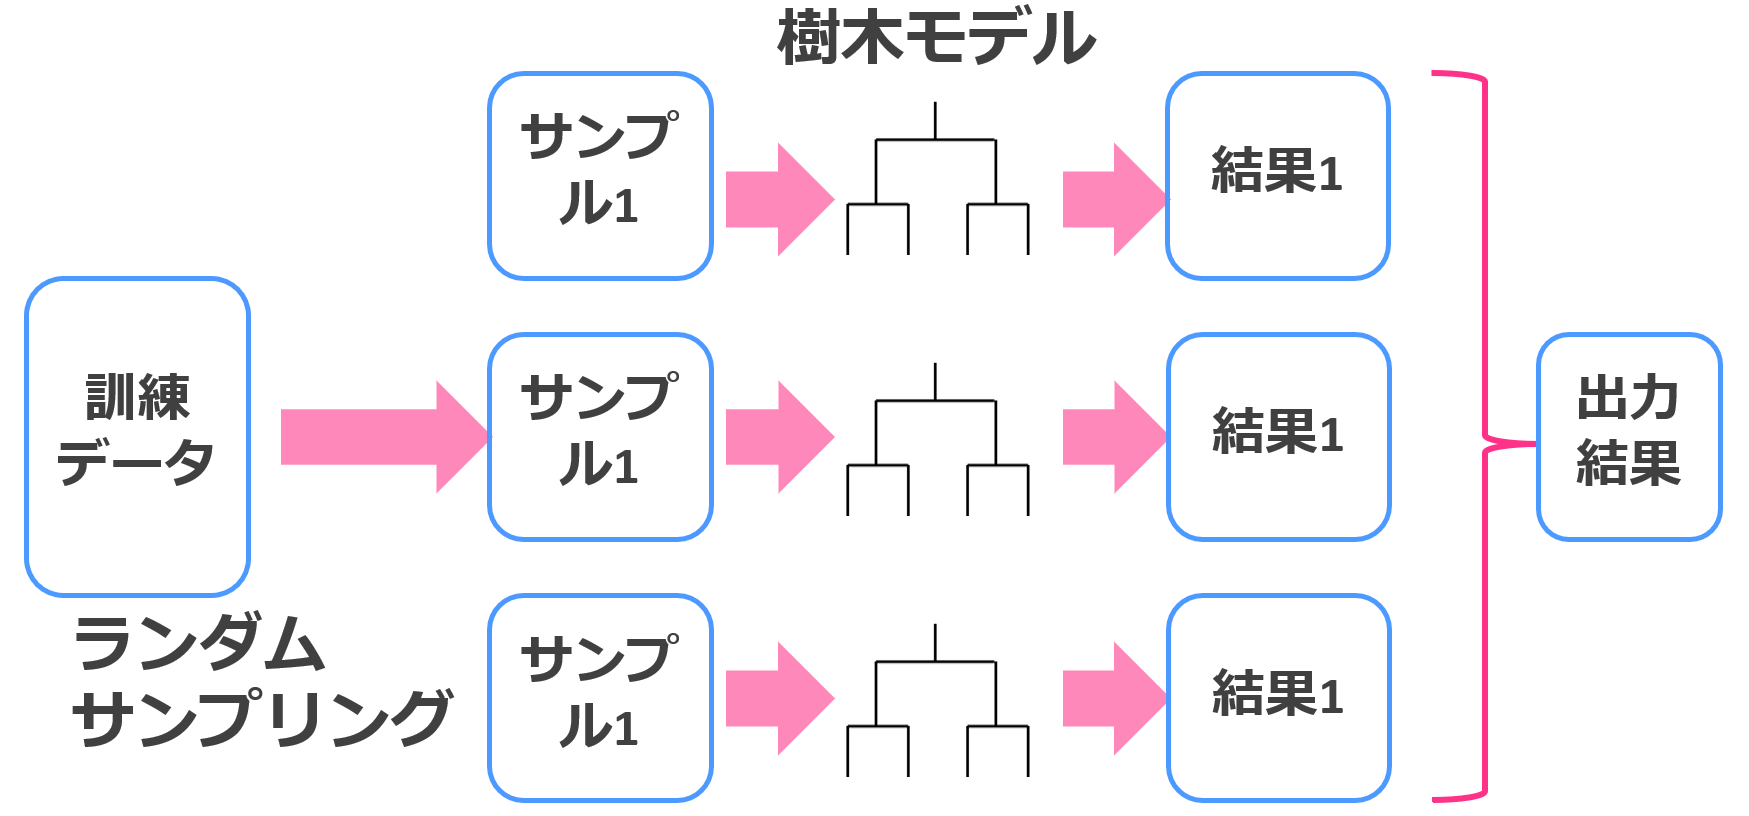
並列に決定木モデルを扱ってそれぞれのモデルの結果を総合的に判断します。
一方でブースティングは弱学習器を直列に使います。
ブースティングと決定木を組み合わせたのがXGboostなのです。
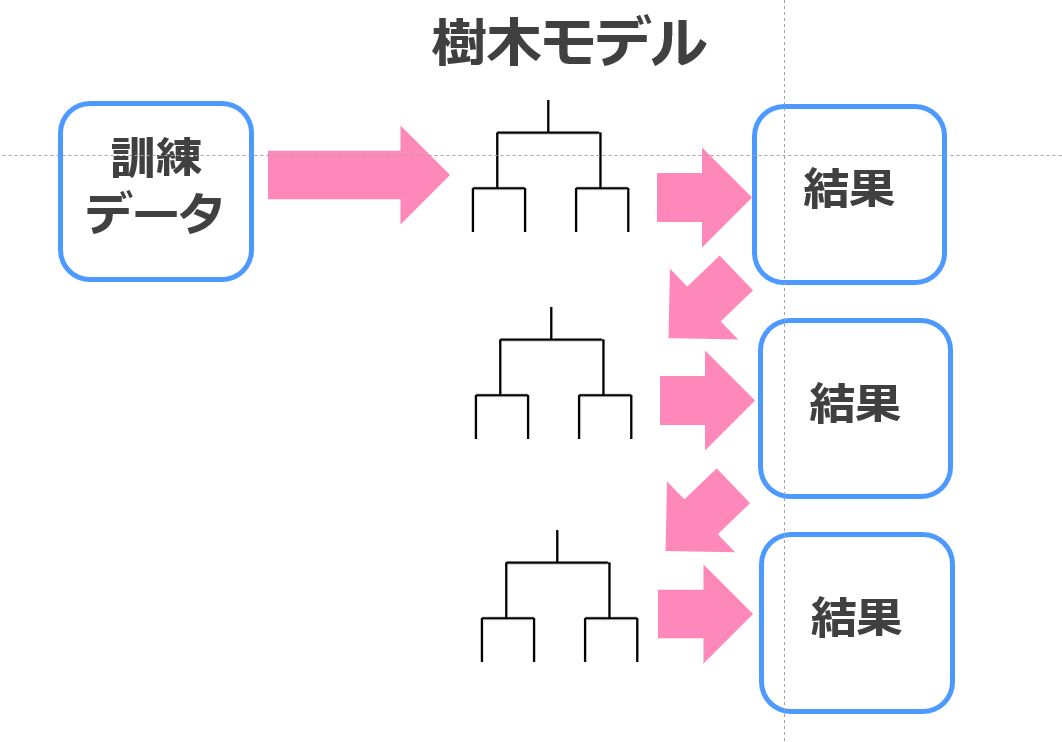
最初の学習器で上手く分類・推定できなかった部分に対して重みを付けて次の弱学習器で学習を行います。
そうすることで、上手く推定できない部分もできるようになってきます。
最終的には、それぞれのモデルに対して精度の高さを基に重みを付けて集約し、モデルを作成します。
3人寄れば文殊の知恵的な感じですね!
XGBoostの論文はこちら!この後述べる特徴なども詳しく書かれています!
In this paper, we described a scalable end-to-end tree boosting system called XGBoost, which is used widely by data scientists to acheve state-of-the-art results on many machine learning challenges.
XGboostの特徴
XGboostの特徴を見ていきましょう!
精度が比較的高い
冒頭でも書きましたが、Kaggleでもまだまだ用いられている精度の高い手法です。
一般的にバギングを用いたランダムフォレストよりも精度は高くなります。
 ロボたん
え、そしたらランダムフォレストの出番はないんじゃ、、、?
学習に時間がかかる
ブースティングは直列に学習を行うため、バギングよりも学習に時間がかかります。
大規模データを解析するとなると、それなりの学習時間がかかるので注意が必要です。
ロボたんちゃんと欠点もありましたか、、、
ウマたんデータ量によって使用する手法を変えることも大事だね!
実は、そんなXGboostの弱点を克服するためにリリースされたのがLightGBM(軽いXGboost的なイメージ)なのです。
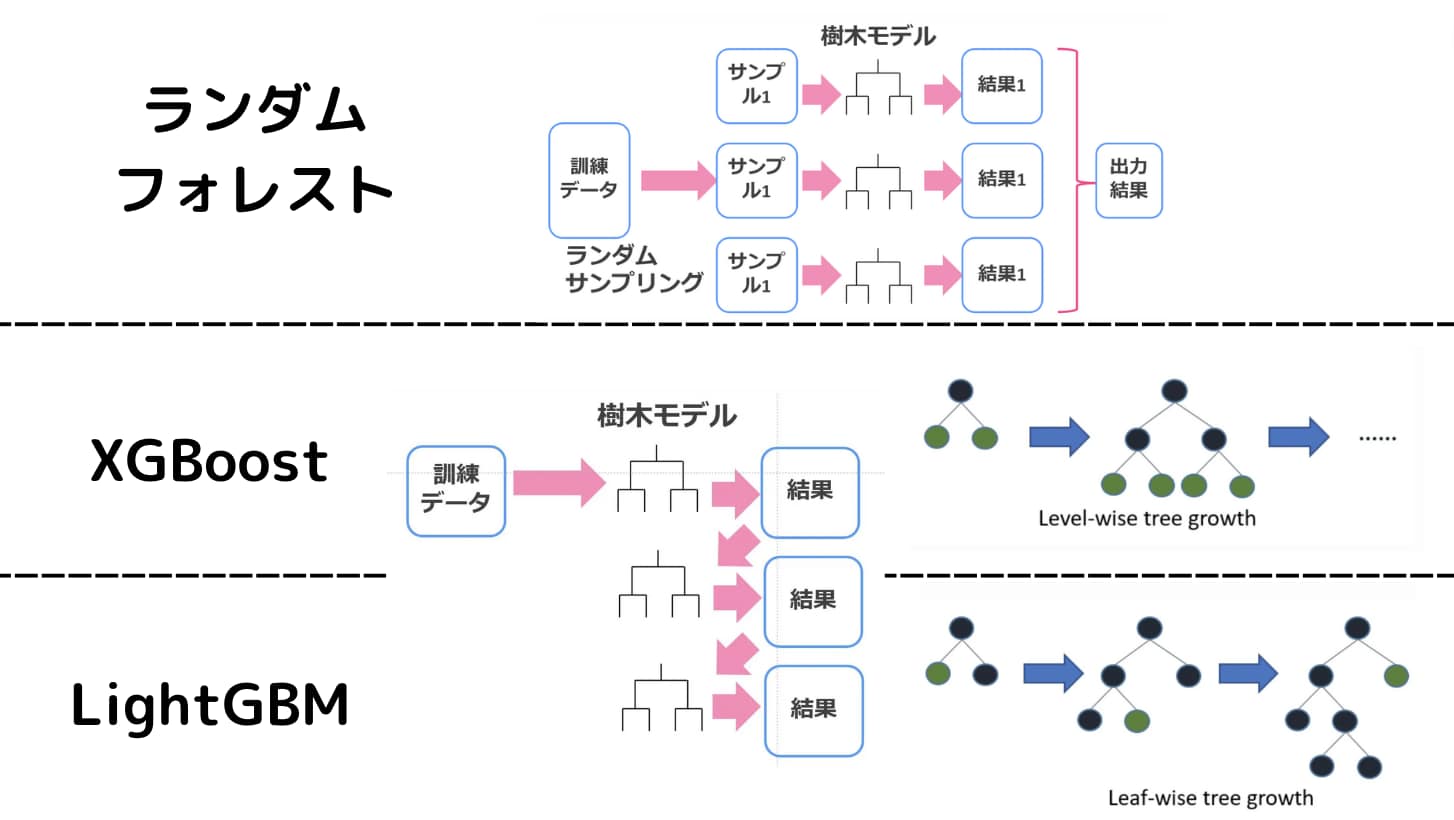
XGboostでは決定木の階層が同時に深くなっていきますが、LightGBMでは階層は一定ではありません。片方のノードだけ深くなることもあります。
これをLeaf-wiseと呼びます。
 【図解で解説】LightGBMの仕組みとPythonでの実装を見ていこう!当サイト【スタビジ】の本記事では、最強の機械学習手法「LightGBM」についてまとめていきます。LightGBM の特徴とPythonにおける回帰タスクと分類タスクの実装をしていきます。LightGBMは決定木と勾配ブースティングを組み合わせた手法で、Xgboostよりも計算負荷が軽い手法であり非常によく使われています。
パラメータの数が多くチューニングが必要
XGboostには数々のパラメータが存在します。
精度を上げるためにはパラメータのチューニングが必要になってきます。
パラメータのチューニングの方法にはグリッドサーチやベイズ最適化などがあります。
 ハイパーパラメータのチューニングについて解説!PythonでのLightGBM実装と一緒に見ていこう!当サイト【スタビジ】の本記事では、機械学習モデルの精度を上げるのに必要なハイパーパラメータのチューニングについて徹底的に解説していきます!各種機械学習手法には複数のパラメータがありそれらを細かくチューニングすることで精度を上げることが可能なんです!
決定木と比較すると解釈容易性が低い
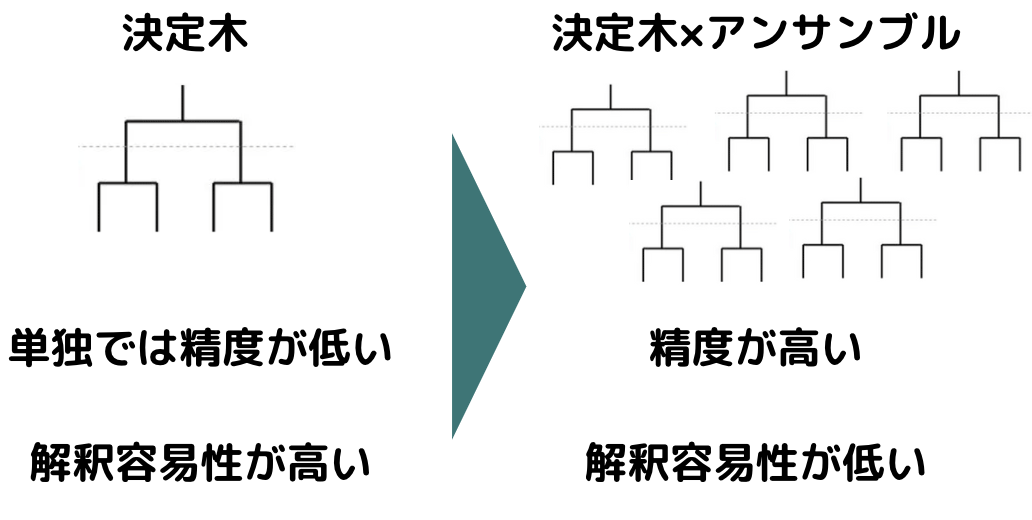
決定木は結果がツリー構造で可視化されるので解釈容易性が高く、他人に説明する際や現状を紐解く際には便利です。
一方でXGboostは、複数の決定木をアンサンブルしてしまうので解釈容易性が低くなってしまいます。
ただ、どの特徴量が効いているかなどの特徴量重要度は算出することが可能です。
回帰タスクに対してXGboostをPythonで実装してみよう!
XGboostはRやPythonで簡単に実装することができます。
まずは、実際にPythonを用いてXGboostを実装してみましょう!
最初に回帰タスクに対してXGBoostを実装してみます。
データ分析コンペ DataDojoの「中古マンション価格予測チャレンジ」というコンペのデータを題材にしていきます。
国産データコンペのNishika(2026年3月にサービス終了)で開催されていたトレーニングコンペで、今はDataDojoで同じコンペに無料で参加できます。
まず DataDojoにGoogleアカウントでログインして、コンペの「データ」タブから学習データ(train.zip)とテストデータ(test.csv)をダウンロードしてください(※ログインしないとデータをダウンロードできません)。
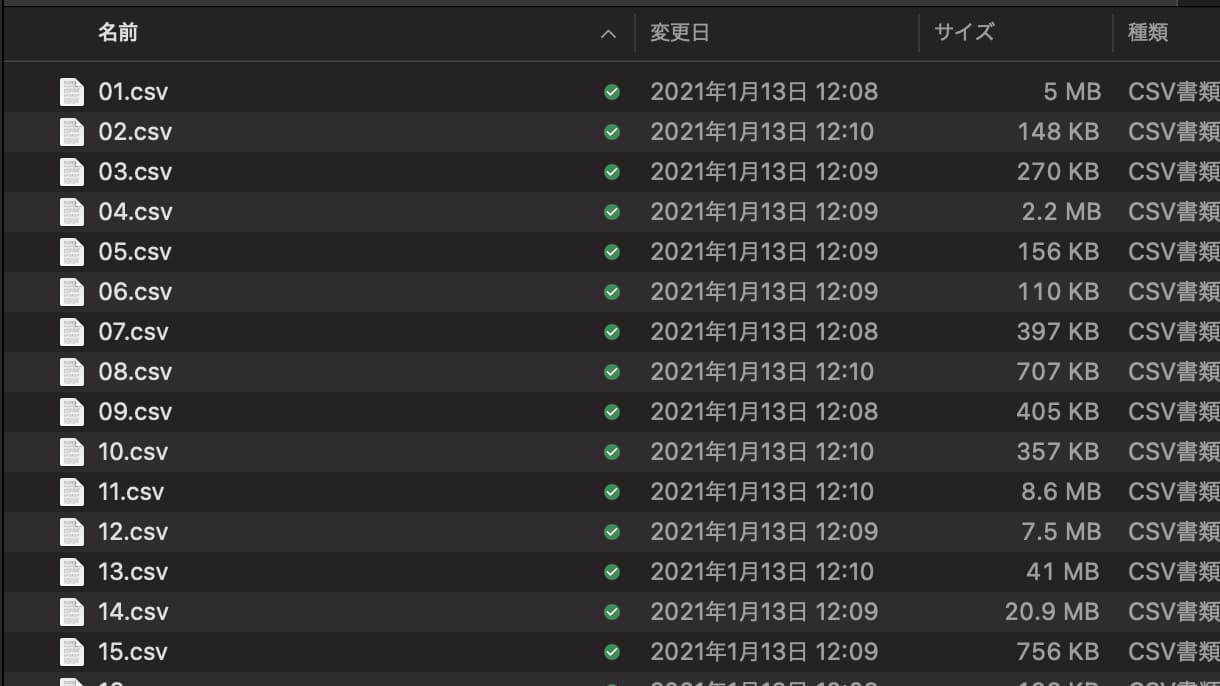
globは、ディレクトリに格納されたファイル名を抽出するのに便利なライブラリです。
 【5分で分かる】コード付きで解説!Pythonのglobの使い方まとめ!本記事では、Pythonでファイル取得に便利なライブラリ”glob”の使い方について見ていきます!大量のデータファイルを扱うデータ分析の場面で利用することが多いので、ぜひ使いこなせるようになりましょう!
import glob
import pandas as pd
import numpy as np
import xgboost as xgb
import category_encoders as ce
from sklearn.model_selection import train_test_split

files = glob.glob("train/*.csv")
data_list = []
for file in files:
    data_list.append(pd.read_csv(file, index_col=0))
df = pd.concat(data_list)
category_encodersは変数をカテゴリ変数化するためのライブラリです。
学習データには複数CSVが入っているので、それらをglobで結合させてデータフレーム化していきます。
続いてデータが少し汚いのでカラムを削除したり型の変換などをおこなっていきます。
def data_pre(df):
    nonnull_list = []
    for col in df.columns:
        nonnull = df[col].count()
        if nonnull == 0:
            nonnull_list.append(col)
    df = df.drop(nonnull_list, axis=1)

    df = df.drop("市区町村名", axis=1)

    df = df.drop("種類", axis=1)

    dis = {
        "30分?60分":45,
        "1H?1H30":75,
        "2H?":120,
        "1H30?2H":105
    }
    df["最寄駅:距離(分)"] = df["最寄駅:距離(分)"].replace(dis).astype(float)

    df["面積(㎡)"] = df["面積(㎡)"].replace("2000㎡以上", 2000).astype(float)


    y_list = {}
    for i in df["建築年"].value_counts().keys():
        if "平成" in i:
            num = float(i.split("平成")[1].split("年")[0])
            year = 33 - num
        if "令和" in i:
            num = float(i.split("令和")[1].split("年")[0])
            year = 3 - num
        if "昭和" in i:
            num = float(i.split("昭和")[1].split("年")[0])
            year = 96 - num
        y_list[i] = year
    y_list["戦前"] = 76
    df["建築年"] = df["建築年"].replace(y_list).astype(float)

    year = {
        "年第1四半期": ".25",
        "年第2四半期": ".50",
        "年第3四半期": ".75",
        "年第4四半期": ".99"
    }
    year_list = {}
    for i in df["取引時点"].value_counts().keys():
        for k, j in year.items():
            if k in i:
                year_rep = i.replace(k, j)
        year_list[i] = year_rep
    df["取引時点"] = df["取引時点"].replace(year_list).astype(float)

    cols = ["都道府県名", "地区名", "最寄駅:名称", "間取り", "建物の構造", "用途", "今後の利用目的", "都市計画", "改装", "取引の事情等"]
    ce_df = ce.OrdinalEncoder(cols=cols, handle_unknown='value')
    df = ce_df.fit_transform(df)

    return df

df = data_pre(df)以下の箇所では質的変数に関してカテゴリーエンコーディングをおこなっていきます(今のcategory_encodersではhandle_unknown='impute'が使えなくなったので'value'にしています)。
cols = ["都道府県名", "地区名", "最寄駅:名称", "間取り", "建物の構造", "用途", "今後の利用目的", "都市計画", "改装", "取引の事情等"]
    ce_df = ce.OrdinalEncoder(cols=cols, handle_unknown='value')
    df = ce_df.fit_transform(df)
そして最終的にXGBoostを実装していきます。
df_train, df_val =train_test_split(df, test_size=0.2)

col = "取引価格(総額)_log"
train_y = df_train[col]
train_x = df_train.drop(col, axis=1)

val_y = df_val[col]
val_x = df_val.drop(col, axis=1)

train_data = xgb.DMatrix(train_x, label=train_y)
eval_data = xgb.DMatrix(val_x, label=val_y)

xgb_params = {
    "objective": "reg:squarederror",
    'eval_metric': "mae"
    }
evals = [(train_data, 'train'), (eval_data, 'eval')]

gbm = xgb.train(
    xgb_params,
    train_data,
    num_boost_round=100,
    early_stopping_rounds=10,
    evals=evals,
)学習用のデータと検証用のデータに分けています。
学習をする際は、xgb.DMatrixというXGBoost用のデータ型に変換するのが特徴です。
その後はパラメータをかんたんにセットしモデル構築をおこなっていきます。
今回eval_metricをMAE(平均絶対誤差)に設定しているので、MAEで算出されます。
パラメータチューニングをしたり特徴量エンジニアリングをすることで精度は上がります。
以下に全コードを載せておきます。
import glob
import pandas as pd
import numpy as np
import xgboost as xgb
import category_encoders as ce
from sklearn.model_selection import train_test_split

files = glob.glob("train/*.csv")
data_list = []
for file in files:
    data_list.append(pd.read_csv(file, index_col=0))
df = pd.concat(data_list)
df_test = pd.read_csv("test.csv", index_col=0)

def data_pre(df):
    nonnull_list = []
    for col in df.columns:
        nonnull = df[col].count()
        if nonnull == 0:
            nonnull_list.append(col)
    df = df.drop(nonnull_list, axis=1)

    df = df.drop("市区町村名", axis=1)

    df = df.drop("種類", axis=1)

    dis = {
        "30分?60分":45,
        "1H?1H30":75,
        "2H?":120,
        "1H30?2H":105
    }
    df["最寄駅:距離(分)"] = df["最寄駅:距離(分)"].replace(dis).astype(float)

    df["面積(㎡)"] = df["面積(㎡)"].replace("2000㎡以上", 2000).astype(float)


    y_list = {}
    for i in df["建築年"].value_counts().keys():
        if "平成" in i:
            num = float(i.split("平成")[1].split("年")[0])
            year = 33 - num
        if "令和" in i:
            num = float(i.split("令和")[1].split("年")[0])
            year = 3 - num
        if "昭和" in i:
            num = float(i.split("昭和")[1].split("年")[0])
            year = 96 - num
        y_list[i] = year
    y_list["戦前"] = 76
    df["建築年"] = df["建築年"].replace(y_list).astype(float)

    year = {
        "年第1四半期": ".25",
        "年第2四半期": ".50",
        "年第3四半期": ".75",
        "年第4四半期": ".99"
    }
    year_list = {}
    for i in df["取引時点"].value_counts().keys():
        for k, j in year.items():
            if k in i:
                year_rep = i.replace(k, j)
        year_list[i] = year_rep
    df["取引時点"] = df["取引時点"].replace(year_list).astype(float)

    cols = ["都道府県名", "地区名", "最寄駅:名称", "間取り", "建物の構造", "用途", "今後の利用目的", "都市計画", "改装", "取引の事情等"]
    ce_df = ce.OrdinalEncoder(cols=cols, handle_unknown='value')
    df = ce_df.fit_transform(df)

    return df

# カテゴリの番号を学習データとテストデータでそろえるため、つなげてから前処理して分け直す
df_all = data_pre(pd.concat([df, df_test]))
df = df_all[df_all["取引価格(総額)_log"].notnull()]
df_test = df_all[df_all["取引価格(総額)_log"].isnull()].drop("取引価格(総額)_log", axis=1)

df_train, df_val =train_test_split(df, test_size=0.2)

col = "取引価格(総額)_log"
train_y = df_train[col]
train_x = df_train.drop(col, axis=1)

val_y = df_val[col]
val_x = df_val.drop(col, axis=1)

train_data = xgb.DMatrix(train_x, label=train_y)
eval_data = xgb.DMatrix(val_x, label=val_y)

xgb_params = {
    "objective": "reg:squarederror",
    'eval_metric': "mae"
    }
evals = [(train_data, 'train'), (eval_data, 'eval')]

gbm = xgb.train(
    xgb_params,
    train_data,
    num_boost_round=100,
    early_stopping_rounds=10,
    evals=evals,
    )

# テストデータで予測して提出用のファイルを作る
predict = gbm.predict(xgb.DMatrix(df_test))
df_test["取引価格(総額)_log"] = predict
df_test[["取引価格(総額)_log"]].to_csv("submit_test.csv")全コードでは、カテゴリーエンコーディングの番号が学習データとテストデータでずれないように、2つをつなげてから前処理して分け直しています。最後の部分で、テストデータの予測値をsubmit_test.csvに書き出しています。
作成したsubmit_test.csvをコンペの「提出」タブからアップロードすると、自動で採点されてリーダーボードに順位が出ます(DataDojoのこのコンペの評価指標はRMSE(二乗平均平方根誤差)で、提出は1日5回までです)。
分類タスクに対してXGboostをPythonで実装してみよう!
先ほどはDataDojoというデータコンペの中古マンション価格データを題材に回帰タスクに対してXGBoostを実装しました。
続いてはMnistという文字の識別分類データを題材に分類タスクに対してXGBoostを実装していきます。
また、今回は他の手法と精度比較をおこなっていきます。
その手法とは、Xgboostと同じ勾配ブースティング手法であるLight gbmとCatboostの2つです!
XGBoostよりも後に開発された2つの強力な手法と精度を比較してみましょう!
今回扱うMnistデータセットの特徴は以下です。
それでは、コードをみていきましょう!
import xgboost as xgb
import pandas as pd
import numpy as np
from tensorflow.keras.datasets import mnist
from sklearn.model_selection import train_test_split

# Kerasに付属の手書き数字画像データをダウンロード
np.random.seed(0)
(X_train_base, labels_train_base), (X_test, labels_test) = mnist.load_data()

# Training set を学習データ(X_train, labels_train)と検証データ(X_validation, labels_validation)に8:2で分割する
X_train,X_validation,labels_train,labels_validation = train_test_split(X_train_base,labels_train_base,test_size = 0.2)

# 各画像は行列なので1次元に変換→X_train,X_validation,X_testを上書き
X_train = X_train.reshape(-1,784)
X_validation = X_validation.reshape(-1,784)
X_test = X_test.reshape(-1,784)

#正規化
X_train = X_train.astype('float32')
X_validation = X_validation.astype('float32')
X_test = X_test.astype('float32')
X_train /= 255
X_validation /= 255
X_test /= 255

# 訓練・テストデータの設定
train_data = xgb.DMatrix(X_train, label=labels_train)
eval_data = xgb.DMatrix(X_validation, label=labels_validation)
X_data = xgb.DMatrix(X_test, label=labels_test)

#経過時間計測
import time
start = time.time()

xgb_params = {
    # 多値分類問題
    'objective':'multi:softmax',
    # クラス数
    'num_class': 10,
    # 学習用の指標 (Multiclass logloss)
    'eval_metric': 'mlogloss',
    }
evals = [(train_data, 'train'), (eval_data, 'eval')]

gbm = xgb.train(
    xgb_params,
    train_data,
    num_boost_round=100,
    early_stopping_rounds=10,
    evals=evals,
    )

preds = gbm.predict(X_data)
from sklearn.metrics import accuracy_score
print('accuracy_score:{}'.format(accuracy_score(labels_test, preds)))

#経過時間
print('elapsed_timetime:{}'.format(time.time()-start))
まずは、Mnistのデータをインポートして分類するために加工していきます!
続いて、Xgboost用のデータ構造に変換します。
最後にパラメータをセットしてXgboostで学習を行っていきます!
結果は・・・
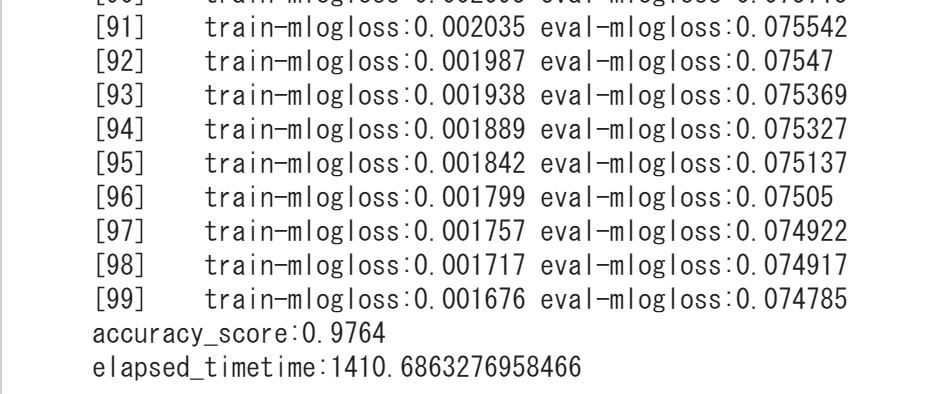
精度・・0.976!!非常に高い!
実はLight gbmやCatboostよりも高くなっています。
Light gbmは0.972、Catboostは0.9567!
ただ処理時間が他の手法よりも圧倒的に遅いんです。
以下の記事で比較しているので詳しくはチェックしてみてください!
 勾配ブースティング決定木の手法をPythonで実装して比較していく!当サイト【スタビジ】の本記事では、勾配ブースティングの各手法をPythonで実装して徹底比較していきます!勾配ブースティングの代表手法「Xgboost」「Light gbm」「Catboost」で果たしてどのような違いがあるのでしょうか?
XGboostをRで実装してみよう!
Pythonでの実装を見てきましたが、続いてはRを用いて実装していきます。
今回は、Kaggleの公式サイトで提供されているTitanicのデータを使います。
データのクレンジングを行い、欠損値は削除、不要と考えられる項目は削除します。
生死(Survive)を目的変数としそれ以外を説明変数とします。
サンプル数714のうちランダムに400個のデータを取り出し学習データとし、残りの314を予測データとします。
学習データで予測モデルを作り、予測データにあてはめ真値と予測値の判別率を精度として比較します。
シミュレーション回数は10回とし、上記の手順を10回繰り返し、結果を平均したものを最終アウトプットとします。シミュレーション回数をもっと増やせば精度の信頼性は上がります。
先程は、Light gbmとCatboostの2つと比較しましたが、RではXGboostをランダムフォレスト、サポートベクターマシン、ナイーブベイズ、ニューラルネットワーク、k近傍法の5手法と比較します!
基本的に引数は全部デフォルトで!果たして結果はどうなるでしょうか!
##様々な手法で予測精度の比較を行う##
##randomForest,SVM,ナイーブベイズ,ニューラルネット
library(xgboost)
library(caret)
library(Matrix)
library(kernlab)
library(randomForest)
library(e1071)
library(nnet)
library(ggplot2)
library(class)
titanic<-read.csv("タイタニック乗船者リスト.csv")##データの読み込み
titanic<-na.omit(titanic)##欠損値削除
titanic$Survived<-as.factor(titanic$Survived)##質的変数に変換
sim<-10##シミュレーション回数
result<-matrix(0,sim,6)##結果の箱
titanic[,4]<-as.numeric(titanic[,4])
titanic[,9]<-as.numeric(titanic[,9])

for(i in 1:sim){
  ####学習データとテストデータに分ける####
  train.id<-sample(nrow(titanic),400)
  train.data<-titanic[train.id,-1]
  test.data<-titanic[-train.id,-1]


  ##randomForest##
  rf<-randomForest(Survived~.,train.data)
  test.data.rf<-cbind(test.data,"predict"=predict(rf,test.data))
  result[i,1]<-sum(test.data.rf$predict==test.data.rf$Survived)/nrow(test.data.rf)


  ##SVM##
  svm<-ksvm(Survived~.,train.data)
  test.data.svm<-cbind(test.data,"predict"=predict(svm,test.data))
  result[i,2]<-sum(test.data.svm$predict==test.data.svm$Survived)/nrow(test.data.svm)

  ##ナイーブベイズ##
  nb<-naiveBayes(Survived~.,train.data)
  test.data.nb<-cbind(test.data,"predict"=predict(nb,test.data))
  result[i,3]<-sum(test.data.nb$predict==test.data.nb$Survived)/nrow(test.data.nb)

  ##ニューラルネット##
  nn<-nnet(Survived~.,train.data,size=5)
  test.data.nn<-cbind(test.data,"predict"=round(predict(nn,test.data),0))
  result[i,4]<-sum(test.data.nn$predict==test.data.nn$Survived)/nrow(test.data.nn)

  ##XGboost##
  label.data.train<-as.integer(train.data$Survived)-1##目的変数を01に
  label.data.predict<-as.integer(test.data$Survived)-1

  train.data.xg<-train.data[,-1]##目的変数取り除く
  test.data.xg<-test.data[,-1]

  xgb.data<-xgb.DMatrix(data.matrix(train.data.xg),label=label.data.train)##Xgb型へ成型
  xgb.data.predict<-xgb.DMatrix(data.matrix(test.data.xg))

  param <- list(
    "objective" = "binary:logistic"
    ,"eta" = 0.01
    # ,"max_depth" = 10
    ,"min_child_weight" = 5
    # ,"subsample" = 1
    # ,"colsample_bytree" = 1
  )##パラメータ適当

  model <- xgboost(
    param=param
    ,data=xgb.data
    ,nrounds=1000
  )##実際の学習

  predict_xgb<-predict(model,xgb.data.predict)

  a<-c()
  m<-length(predict_xgb)#行数

  for(l in 1:m){
    if(predict_xgb[l]>0.5){a[l]<-1}
    else{a[l]<-0}
  }
  result[i,5]<-sum(a==label.data.predict)/length(a)

  #k-nn
  knn<-knn(train.data,test.data,train.data[,"Survived"] ,prob=T,k=3)
  test.data.knn<-cbind(test.data,"predict"=knn)
  result[i,6]<-sum(test.data.knn$predict==test.data.knn$Survived)/nrow(test.data.knn)

}

result.c<-apply(result,2,mean)##simの平均値
result.c<-t(as.matrix(result.c))
result.c<-rbind(result.c,result.c)
result.c<-round(result.c,3)
##グラフ描画
colnames(result.c) <- c("RF","SVM","Bayes","NN","xgb","knn")
df<-data.frame(method=colnames(result.c),result=colMeans(result.c))
gp<-ggplot(df,aes(x=method,y=result,fill=method))
gp<-gp+geom_bar(width=0.8,stat="identity")
gp<-gp+ylab("result")
gp<-gp+geom_text(label=colMeans(result.c),vjust=1)
plot(gp)
xgboostというパッケージに入っている関数を用いて解析を行っていきます。
XGboost以外は基本的にパッケージを読み込み関数を記述すれば問題ないのですが、XGboostだけ特別な型にするためにデータ加工をしています。
xgb.data<-xgb.DMatrix(data.matrix(train.data.xg),label=label.data.train)
他の機械学習手法は普通のデータフレーム型で扱えるんですが、XGboostは特殊な型にしなくてはいけないのが少し面倒なんですよねー!
結果は以下のようになりました!
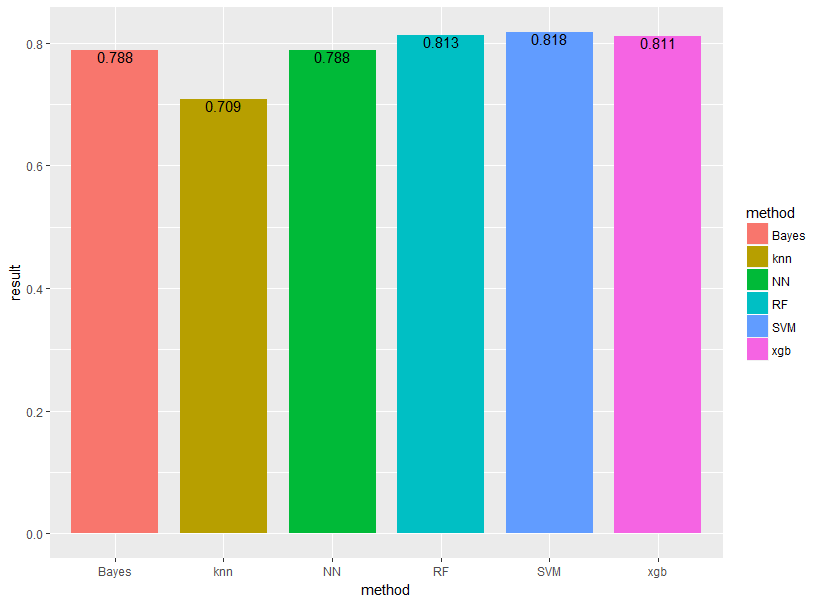
それぞれBayes(ナイーブベイズ)、knn(k近傍法)、NN(ニューラルネットワーク)、RF(ランダムフォレスト)、SVM(サポートベクターマシン)、xgb(XGboost)と表示しています。
k近傍法(黄色)が一番パフォーマンスが悪く、SVM(青色)が最もパフォーマンスが良いという結果になりました!
XGboostにはパラメータが非常にたくさんあるので注意が必要です。
今回は、二値の質的変数が目的変数なので
“objective“ = “binary:logistic“
を使用しています。
分類なのか回帰なのか、マルチクラスなのかによってobjectiveを変えるようにしましょう!
他にもたくさんのパラメータがあります。
パラメータをチューニングすることで精度がだいぶ変わるので、是非試してみてください!
XGboost まとめ
本記事では、XGboostについて様々な観点から見てきました。
XGboostは非常に精度の高い手法であり簡易的に実装してみてもその効果を確かめることができました。
最後にXGboostについてまとめておきましょう!
是非XGboostを試してみてください!
以下の記事で他の機械学習手法やデータサイエンス全般については以下でまとめていますので興味があればご覧ください!
 【入門】機械学習のアルゴリズム・手法をPythonとRの実装と一緒に解説!当サイト【スタビジ】の本記事では、入門者向けに機械学習についてカンタンにまとめていきます。最終的にはどのように機械学習を学んでいけばよいかも見ていきます。細かい手法の実装もPython/Rを用いておこなっていくので適宜参考にしてみてください。
 【5分で分かる】データサイエンティストに必要なスキルと独学勉強ロードマップ!当サイト【スタビジ】の本記事では、データサイエンティストに求められるスキルとそれを身に付けるための勉強法について徹底的にまとめていきます!入門者でも、しっかりデータサイエンティストについて理解しある程度独学で駆け出しの状態までいけることを目指します。
機械学習手法の実装にはPythonが最適です。
Pythonの習得方法に関しては以下の記事でまとめています!
 【Python独学勉強法】Python入門を3ヶ月で習得できる学習ロードマップ当サイト【スタビジ】の本記事では、過去僕自身がPythonを独学を駆使しながら習得した経験をもとにPythonを効率よく勉強する方法を具体的なコード付き実装例と合わせてまとめていきます。Pythonはできることが幅広いので自分のやりたいことを明確にして勉強法を選ぶことが大事です。
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「機械学習実装」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。


