【徹底比較】【Python】データ分析コンペそれぞれの特徴とトレーニング実装
目次
 ウマたん
本記事では、データ分析コンペそれぞれの特徴について徹底的に見ていきます。データ分析コンペでは機械学習を使ってモデルを構築していきます!実はデータ分析コンペのサービスはKaggleだけではなく、いくつかの種類があるので是非色んなコンペに参加してみてください!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
データ分析をある程度できるようになるとぜひ挑戦してほしいのがデータ分析コンペ!
データ分析コンペを開催するサービスといえばKaggleが有名ですが、それ以外にも国産のSignateやDataDojoなどのデータ分析コンペがあるんです。
 ロボたん
え!?データ分析コンペってKaggleくらいしかないのかと思ってたー!
ウマたん実は他のコンペもいくつかあって、そちらのほうがデータが扱いやすかったり入賞しやすかったりするんだよー!
そこでこの記事では、データ分析コンペの特徴についてまとめていきたいと思います!
また、いくつかのコンペのトレーニングデータのテスト実装もしていきます。
各データ分析コンペの特徴
さてまずは、各データ分析コンペの特徴について比較していきましょう!
ここで紹介するのは以下の3つです。
やっぱりKaggleが圧倒的な知名度を誇るのですが、SignateやDataDojoといった国産のデータ分析コンペもあるので是非チェックしてみてください!
Kaggle
| 【オススメ度】 | |
|---|---|
| 【入賞のしやすさ】 | |
| 【レベル】 | 中級者〜上級者 |
Kaggleとはデータサイエンティスト40万人を超える世界中のデータサイエンティストがひしめき合うコミュニティ。
そんなKaggleの基本構造は、企業が与えた課題に対して腕に自信のあるデータサイエンティストたちが挑む。
数か月の期間、与えられたデータを基に試行錯誤して最適なモデルを構築したチームにはあらかじめ決められていた賞金が付与されるというもの。
Kaggleにはランクがあり、10以位内に入賞するとゴールドメダルがもらえるのですがゴールドメダルを5回手に入れるとグランドマスターという最高位の称号を得ることができます。
Kaggleを生業にしているKagglerと呼ばれる人たちもいるくらい、Kaggleは非常に盛り上がりを見せています。
企業は賞金というインセンティブを用意することで、自社のデータ活用を世界的な水準まで押し上げることが可能です。
そして、活躍の場が制限されていたデータサイエンティストがKaggleによって日の目を浴びることになりました。
企業にとっても個人にとってもWin-Winな場になっているんです!
ロボたん素晴らしいコミュニティだね!!
ウマたんデータサイエンティスト同士で交流も生まれて刺激も与えあえるしねー!
ただ年々レベルが上がっていて、上位に入賞するのは厳しくなりつつあります。
そしてデータセットも非常に膨大なものが多く初心者が扱うにはあまりにも時間がかかってしまうケースが多いです。
もちろんKaggleはオススメのデータ分析コンペサービスですが、なかなか取り組み続けるのには気概がいるのも事実。
ぜひ他のデータ分析コンペサービスも覗いてみるとよいでしょう!
以下の記事でKaggleの説明とKaggleへサブミットする準備などについてまとめていますので是非チェックしてみてください!
 【初心者向けKaggle入門】Kaggleの勉強法とサブミットの前準備!当サイト【スタビジ】の本記事では、Kaggleについて解説していきKaggleに挑戦するまでにどのようなことを勉強しておいたらよいのか丁寧に解説していきます。ある程度データサイエンスの土台が出来た後はKaggleに挑戦し、世界各国の猛者と凌ぎを削りましょう!
Signate
公式HP:https://signate.jp/
| 【オススメ度】 | |
|---|---|
| 【入賞のしやすさ】 | |
| 【レベル】 | 中級者〜 |
Signateという国産のデータ分析コンペもあります。
国産のデータ分析コンペの中では知名度が高く、公式サイトによると登録者数はのべ10万人以上。データコンペの開催数や参加人数も多いです。
レベルはKaggleよりも少し取り組みやすいくらいのイメージです。
初心者向けの「練習問題」も用意されているので、まずはこちらで腕試しするのがオススメです。
またKaggleは海外のプラットフォームなのでほとんど英語なのに対して国産のプラットフォームは日本語なのもよいところですね。
DataDojo
| 【オススメ度】 | |
|---|---|
| 【入賞のしやすさ】 | -(学習講座と連携した学習型のコンペです) |
| 【レベル】 | 初級者〜 |
DataDojoは「学びながら挑戦できるデータ分析コンペプラットフォーム」です。
すべてのコンペに学習講座が連携していて、講座でデータ分析の手法を学びながら、実データでモデルを構築して予測結果のCSVを提出できます。
今開催されているのは、国産データコンペのNishika(2026年3月にサービス終了)で開催されていた「中古マンション価格予測」のコンペです。Nishikaのサービス終了にともなって、DataDojoで同じコンペが開催されることになりました。
このコンペの連携講座は、Udemyの「【初学者向け】データ分析コンペで楽しみながら学べるPython×データ分析講座」です。
Googleアカウントでログインすればすぐに参加できるので、最初の力試しにちょうどいいですよ!
のちほど、この中古マンション価格予測チャレンジのデータを題材に機械学習の実装をしていきます。
データ分析コンペのトレーニングデータを使って実装していく
ここまでで、データ分析コンペを比較してきましたが、実際にどんなものなのか DataDojoの「中古マンション価格予測チャレンジ」というコンペのデータに対してLight gbmを実装してみたいと思います。
まず DataDojoにGoogleアカウントでログインし、中古マンション価格予測チャレンジの学習データ(train.zip)とテストデータ(test.csv)をダウンロードしてください(※ログインしないとデータをダウンロードできません)。
コンペのページの「データ」タブからダウンロードできます。
学習データには複数CSVが入っているので、それらをglobで結合させてデータフレーム化していきます。
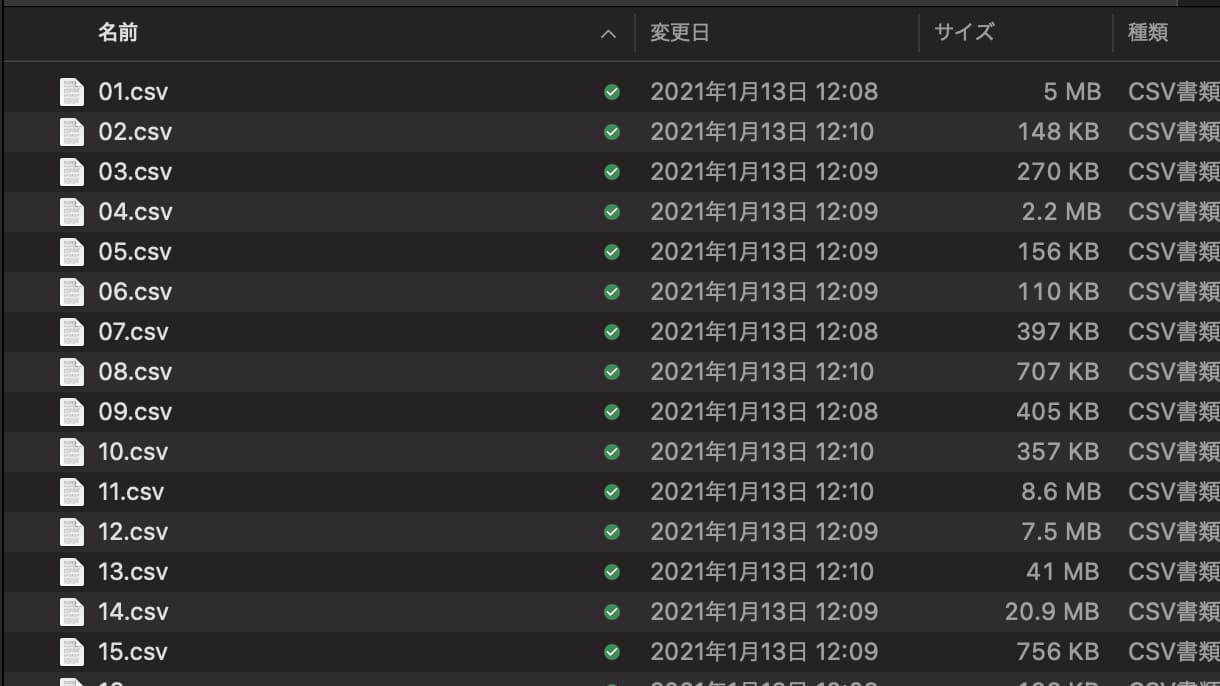
globは、ディレクトリに格納されたファイル名を抽出するのに便利なライブラリです。
 【5分で分かる】コード付きで解説!Pythonのglobの使い方まとめ!本記事では、Pythonでファイル取得に便利なライブラリ”glob”の使い方について見ていきます!大量のデータファイルを扱うデータ分析の場面で利用することが多いので、ぜひ使いこなせるようになりましょう!
import glob
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_absolute_error as mae

files = glob.glob("train/*.csv")
data_list = []
for file in files:
    data_list.append(pd.read_csv(file, index_col=0))
df = pd.concat(data_list)
カラムを見てみると・・・
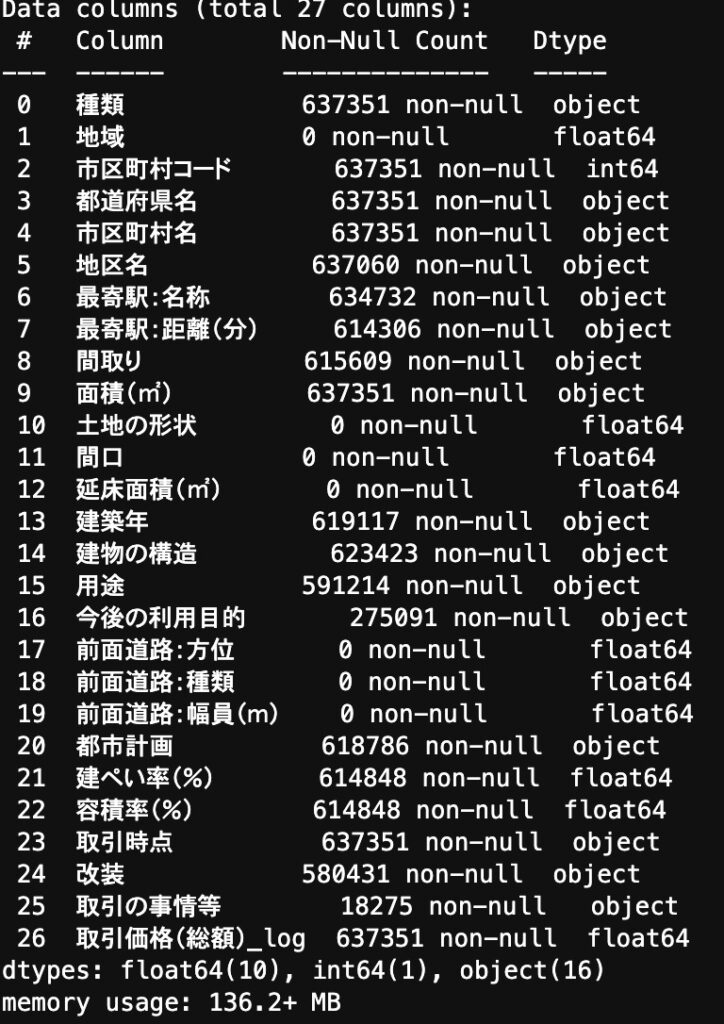
欠損値があったり、数値型で欲しいデータが文字列型になっていたりするので前処理を施していきます!
def data_pre(df):
    nonnull_list = []
    for col in df.columns:
        nonnull = df[col].count()
        if nonnull == 0:
            nonnull_list.append(col)
    df = df.drop(nonnull_list, axis=1)

    df = df.drop("市区町村名", axis=1)

    df = df.drop("種類", axis=1)

    dis = {
        "30分?60分":45,
        "1H?1H30":75,
        "2H?":120,
        "1H30?2H":105
    }
    df["最寄駅:距離(分)"] = df["最寄駅:距離(分)"].replace(dis).astype(float)

    df["面積(㎡)"] = df["面積(㎡)"].replace("2000㎡以上", 2000).astype(float)


    y_list = {}
    for i in df["建築年"].value_counts().keys():
        if "平成" in i:
            num = float(i.split("平成")[1].split("年")[0])
            year = 33 - num
        if "令和" in i:
            num = float(i.split("令和")[1].split("年")[0])
            year = 3 - num
        if "昭和" in i:
            num = float(i.split("昭和")[1].split("年")[0])
            year = 96 - num
        y_list[i] = year
    y_list["戦前"] = 76
    df["建築年"] = df["建築年"].replace(y_list).astype(float)

    year = {
        "年第1四半期": ".25",
        "年第2四半期": ".50",
        "年第3四半期": ".75",
        "年第4四半期": ".99"
    }
    year_list = {}
    for i in df["取引時点"].value_counts().keys():
        for k, j in year.items():
            if k in i:
                year_rep = i.replace(k, j)
        year_list[i] = year_rep
    df["取引時点"] = df["取引時点"].replace(year_list).astype(float)

    for col in ["都道府県名", "地区名", "最寄駅:名称", "間取り", "建物の構造", "用途", "今後の利用目的", "都市計画", "改装", "取引の事情等"]:
                df[col] = df[col].astype("category")

    return df

df = data_pre(df)
この前処理に関してここでは詳細は省きますが、全てが欠損値になっているカラムを削除して、「最寄り駅・面積・建築年・取引時点」に関して変換をおこなっています。
そして前処理をおこなったデータに対してLight gbm を実装!
LightGBM 4.0からearly_stopping_roundsの引数はなくなったので、callbacksでlgb.early_stopping(100)を渡しています。
df_train, df_val =train_test_split(df, test_size=0.2)

col = "取引価格(総額)_log"
train_y = df_train[col]
train_x = df_train.drop(col, axis=1)

val_y = df_val[col]
val_x = df_val.drop(col, axis=1)

trains = lgb.Dataset(train_x, train_y)
valids = lgb.Dataset(val_x, val_y)

params = {
    "objective": "regression",
    "metrics": "mae"
}

model = lgb.train(params, trains, valid_sets=valids, num_boost_round=1000, callbacks=[lgb.early_stopping(100)])
簡単ですね!
ここでは評価指標にMAE(平均絶対誤差)を使っていて、Validationデータでの結果は
0.0764となりました!
データコンペですのでテストデータで予測値を算出し提出するところまでやってみましょう!
df_test = pd.read_csv("test.csv", index_col=0)
df_test = data_pre(df_test)

predict = model.predict(df_test)
df_test["取引価格(総額)_log"] = predict
df_test[["取引価格(総額)_log"]].to_csv("submit_test.csv")
これでサブミット用のファイルを作成することができましたー!
簡単に実装できましたねー!
作成したファイルをサブミットしてみましょうー!
コンペのページの「提出」タブから、作成したCSVをアップロードしてサブミットすることが出来ます(1日5回まで)。
提出すると自動で採点されて、リーダーボードで自分の順位を確認できます。DataDojoのこのコンペの評価指標はRMSE(二乗平均平方根誤差)です。
ちなみにNishikaで開催されていたときは評価指標がMAEで、テストデータでの結果は0.0792でしたー!
全コードは以下になります!
import glob
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_absolute_error as mae

files = glob.glob("train/*.csv")
data_list = []
for file in files:
    data_list.append(pd.read_csv(file, index_col=0))
df = pd.concat(data_list)

def data_pre(df):
    nonnull_list = []
    for col in df.columns:
        nonnull = df[col].count()
        if nonnull == 0:
            nonnull_list.append(col)
    df = df.drop(nonnull_list, axis=1)

    df = df.drop("市区町村名", axis=1)

    df = df.drop("種類", axis=1)

    dis = {
        "30分?60分":45,
        "1H?1H30":75,
        "2H?":120,
        "1H30?2H":105
    }
    df["最寄駅:距離(分)"] = df["最寄駅:距離(分)"].replace(dis).astype(float)

    df["面積(㎡)"] = df["面積(㎡)"].replace("2000㎡以上", 2000).astype(float)


    y_list = {}
    for i in df["建築年"].value_counts().keys():
        if "平成" in i:
            num = float(i.split("平成")[1].split("年")[0])
            year = 33 - num
        if "令和" in i:
            num = float(i.split("令和")[1].split("年")[0])
            year = 3 - num
        if "昭和" in i:
            num = float(i.split("昭和")[1].split("年")[0])
            year = 96 - num
        y_list[i] = year
    y_list["戦前"] = 76
    df["建築年"] = df["建築年"].replace(y_list).astype(float)

    year = {
        "年第1四半期": ".25",
        "年第2四半期": ".50",
        "年第3四半期": ".75",
        "年第4四半期": ".99"
    }
    year_list = {}
    for i in df["取引時点"].value_counts().keys():
        for k, j in year.items():
            if k in i:
                year_rep = i.replace(k, j)
        year_list[i] = year_rep
    df["取引時点"] = df["取引時点"].replace(year_list).astype(float)

    for col in ["都道府県名", "地区名", "最寄駅:名称", "間取り", "建物の構造", "用途", "今後の利用目的", "都市計画", "改装", "取引の事情等"]:
                df[col] = df[col].astype("category")

    return df

df = data_pre(df)

df_train, df_val =train_test_split(df, test_size=0.2)

col = "取引価格(総額)_log"
train_y = df_train[col]
train_x = df_train.drop(col, axis=1)

val_y = df_val[col]
val_x = df_val.drop(col, axis=1)

trains = lgb.Dataset(train_x, train_y)
valids = lgb.Dataset(val_x, val_y)

params = {
    "objective": "regression",
    "metrics": "mae"
}

model = lgb.train(params, trains, valid_sets=valids, num_boost_round=1000, callbacks=[lgb.early_stopping(100)])

df_test = pd.read_csv("test.csv", index_col=0)
df_test = data_pre(df_test)

predict = model.predict(df_test)
df_test["取引価格(総額)_log"] = predict
df_test[["取引価格(総額)_log"]].to_csv("submit_test.csv")パラメータチューニングや特徴量エンジニアリングによってさらに精度が上がりますので是非色々と手を動かしてみてください!
今回扱ったデータは中古マンションの価格データということで比較的扱いやすいデータセットになっています。
Signateの練習問題には、需要予測のほかに画像認識や自然言語処理のデータなどもあるので是非挑戦してみてください!
データ分析コンペに臨む上での勉強法
トレーニングコンペでの実装をおこなってきましたが、完全に初心者の方にとってはなかなか難しいと思います。
そこでここではデータ分析コンペに臨む上でおすすめの勉強法や勉強教材についてまとめていきます。
大きく分けてやってほしいことは以下の2つです。
データ分析の全体像を把握する
データ分析の全体像を把握するためには、以下の「俺たちひよっこデータサイエンティストが世界を変える」という書籍がオススメです!

あまり具体的なデータサイエンティストの仕事について分かりやすく書いている本が見当たらなかったので自分で執筆しました!
勾配ブースティング木のXGBoostを使ったビジネスシーンでの実装についてストーリー形式で簡単にまとめていますのでイメージをふくらませてもらうのにちょうど良いかと思います!
価格は300円ちょっとですし、Kindle unlimitedであれば無料で読めるのでぜひチェックしてみてくださいね!
他にも以下の書籍がデータ分析の全体像を理解する上でオススメなので適宜目を通してみてください!


機械学習の基礎知識を身に付ける
続いて機械学習の基礎知識を身に付けていきます。
このフェーズでは、以下のUdemyコースがオススメです!
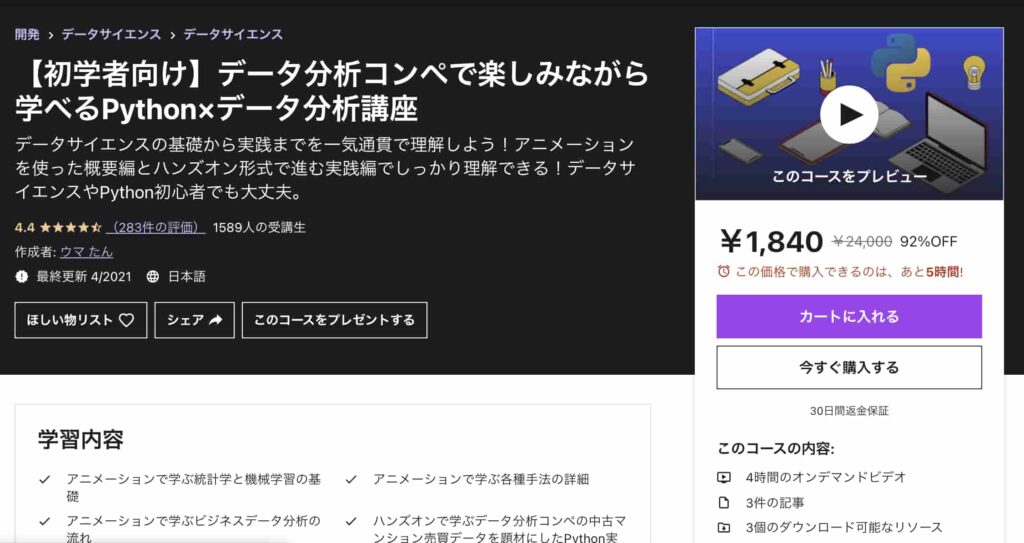
【初学者向け】データ分析コンペで楽しみながら学べるPython×データ分析講座
| 【オススメ度】 | |
|---|---|
| 【講師】 | 僕自身!今なら購入時に「NZWCLGF4BTZENY6E」という講師クーポンコードを入れると90%オフ以上の割引価格になりますのでぜひご受講ください! |
| 【時間】 | 4時間 |
| 【レベル】 | 初級~中級 |
このコースは、なかなか勉強する時間がないという方に向けてコンパクトに分かりやすく必要最低限の時間で重要なエッセンスを学び取れるように作成しています。
アニメーションを使った概要編とハンズオン形式で進む実践編に分かれており、概要編ではYoutubeの内容をより体系的にデータ分析・機械学習導入の文脈でまとめています。
データサイエンスの基礎について基本のキから学びつつ、なるべく堅苦しい説明は抜きにしてイメージを掴んでいきます。
統計学・機械学習の基本的な内容を学び各手法の詳細についてもなるべく概念的に分かりやすく理解できるように学んでいきます。
そしてデータ分析の流れについては実務に即したCRISP-DMというフレームワークに沿って体系的に学んでいきます!
データ分析というと機械学習でモデル構築する部分にスポットがあたりがちですが、それ以外の工程についてもしっかりおさえておきましょう!
続いて実践編ではデータコンペの中古マンションのデータを題材にして、実際に手を動かしながら機械学習手法を実装していきます。
ここでは、探索的にデータを見ていきながらデータを加工し、その上でLight gbm という機械学習手法を使ってモデル構築までおこなっていきます。
是非興味のある方は受講してみてください!
Twitterアカウント(@statistics1012)にメンションいただければ1500円になる講師クーポンを発行いたします!
ちなみにもっと理論に踏み込みたい!という方は以下を参考にしてみてください!
AI・機械学習を学ぶ前手の数学勉強法については以下の記事で詳しくまとめています!
 AI(人工知能)や機械学習でどこまでの数学レベルが必要なのか5分で解説!当サイト【スタビジ】本記事では、AIを理解する上で必要な数学の知識についてまとめていきます。AI理解に必要な数学は難しくありません。高校数学レベルの微積・線形代数・確率統計が分かっていれば問題なし。それらの数学をどのように勉強していけばよいのかについてもまとめていきますよー!
Pythonでの実装
ここからガッツリPythonでの実装に入っていきます。
先ほどの「【初学者向け】データ分析コンペで楽しみながら学べるPython×データ分析講座」でもPython実装部分はあるのでそちらで学んでいただいても問題ないですが、ガッツリ学ぶのであれば当メディアが運営するスタアカ(スタビジアカデミー)が非常にオススメです!
スタアカ(スタビジアカデミー)
公式サイト:https://toukei-lab.com/achademy/
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
データサイエンティストとしての自分の経験をふまえてエッセンスを詰め込んだのがこちらのスタビジアカデミー、略して「スタアカ」!!
当メディアが運営するスクールです。
月額1,280円のライトプランで、統計学から機械学習・生成AIまで全コースが受講し放題です!
プレミアムプランでは、24時間以内の質問対応と現役データサイエンティストとの1on1(30分×4回)を実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
ウォルマートのデータを使って商品の予測分析をしたり、実務で使うことの多いGoogleプロダクトのBigQueryを使って投球分析をしたり、データサイエンティストに必要なビジネス・マーケティングの基礎を学んでマーケティングプランを作ってもらったりする盛りだくさんの内容になってます!
また、さらに深い特徴量エンジニアリングなどについて学びたい方は以下の書籍は非常に勉強になります!

ぜひチェックしてみてください!
またデータ加工集計可視化100本ノックというUdemyコースも私が講師で作っていますのでこちらも力試しに使ってみてください!!
また、PythonでオススメのUdemyコースについて以下でまとめています!
 【20コース以上受講】UdemyのおすすめPythonコースを徹底レビュー!当サイト【スタビジ】の本記事では、世界最大の教育プラットフォーム「Udemy」のPython講座を20コース以上受講した僕がそれぞれのコースを徹底的にレビューしていきます!ぜひムダな時間を費やさず目的に沿った効率の良いPython学習を進めてくださいね!
Pythonの勉強に関しては以下の記事で詳しく解説していますので是非チェックしてみてください!
 【Python独学勉強法】Python入門を3ヶ月で習得できる学習ロードマップ当サイト【スタビジ】の本記事では、過去僕自身がPythonを独学を駆使しながら習得した経験をもとにPythonを効率よく勉強する方法を具体的なコード付き実装例と合わせてまとめていきます。Pythonはできることが幅広いので自分のやりたいことを明確にして勉強法を選ぶことが大事です。
結局どのデータ分析コンペを選べばよい?
さて、結局いくつかのデータ分析コンペがあることは分かりましたが、どのコンペを選べばよいのでしょう?
結論から言うと、サービスで選ぶのではなくコンペで選ぶことをオススメします。
コンペの内容は色んなものがあるので、自分が得意な領域だったり自分が取り組んでみたい領域のコンペティションを探して挑戦してみることをオススメします。
そのためには、KaggleもSignateもDataDojoもとりあえず全て登録しておいて、定期的にコンペティションをチェックすることをオススメします。
初心者の方はまずDataDojoの中古マンション価格予測チャレンジやSignateの練習問題から始めるのがおすすめですが、ぜひ自分の取り組みたいコンペを色々と探してみてください!
ウマたん金融系データやスポーツ系データなど、様々な種類のコンペがあるんだ!
データ分析コンペ まとめ
ここまでご覧いただきありがとうございました!
本記事では、データ分析コンペについて見てきました。
データ分析コンペといってもKaggleだけではなく、いくつかのコンペティションがあることがご理解いただけたでしょうか?
データ分析コンペティションは実践力を積むのに非常にオススメな場で、ぜひぜひ取り組んで欲しいです。
Kaggle・Signate・DataDojoの中から自分に合ったコンペを探して挑戦してみましょう!
データサイエンティストへの勉強法や機械学習・Pythonの勉強法については以下の記事で解説しています。
 【5分で分かる】データサイエンティストに必要なスキルと独学勉強ロードマップ!当サイト【スタビジ】の本記事では、データサイエンティストに求められるスキルとそれを身に付けるための勉強法について徹底的にまとめていきます!入門者でも、しっかりデータサイエンティストについて理解しある程度独学で駆け出しの状態までいけることを目指します。
 【5分で分かる】機械学習の独学勉強ロードマップを徹底的にまとめていく!当サイト【スタビジ】の本記事では、機械学習の独学勉強ロードマップについて徹底的にまとめていきます。機械学習をいきなり理論からしっかり勉強しようとすると挫折しかねません。そこで、この記事ではなるべく挫折しないロードマップをお伝えしてきますよ!
【Python独学勉強法】Python入門を3ヶ月で習得できる学習ロードマップ当サイト【スタビジ】の本記事では、過去僕自身がPythonを独学を駆使しながら習得した経験をもとにPythonを効率よく勉強する方法を具体的なコード付き実装例と合わせてまとめていきます。Pythonはできることが幅広いので自分のやりたいことを明確にして勉強法を選ぶことが大事です。
またデータ分析手法については以下の記事で詳しくまとめています!
 【初心者向け】データ分析の手法を分かりやすく解説!Pythonで実装してみよう!当サイト【スタビジ】の本記事では、データ分析における手法の種類とデータ分析時の注意点をまとめていきます。データ分析に使う手法は非常に多いので一つ一つ習得していきましょう!最後にはデータ分析に使う言語についてもまとめていきますよ!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「機械学習実装」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。