【5分で分かる】「CRISP-DM」の流れをデータサイエンティストが徹底解説!

目次
 ウマたん
本記事では、データ分析において非常に重要なプロセスである「CRISP-DM」について簡単に解説していきます。この言葉自体を覚える必要はありませんが、CRISP-DMのフレームワークをしっかり体に刷り込んでおくことがデータ分析においては重要です。
こんにちは!
データサイエンティストのウマたん(@statistics1012)です。
データ分析において必要な考え方である「CRISP-DM」。
おそらくCRISP-DMという言葉は知らなくても、多くの人がこの「CRISP-DM」を日ごろから無意識的におこなっていることでしょう。
CRISP-DMという言葉自体を覚えることそのものには意味がありませんが、CRISP-DMを理解してこのフレームワークに立ち返ることでデータ分析を効率よく行うことができます。
 ロボたん
確かにフレームワークは覚えるだけでは意味がないよね!実践して使えるようにならないと!
ウマたんそうなんだ!理解して実践!
この記事では、そんなCRISIP-DMというプロセスに関してまとめていきます。
以下のYoutube動画でも解説しているので是非チェックしてみてくださいね!

CRISP-DMとは
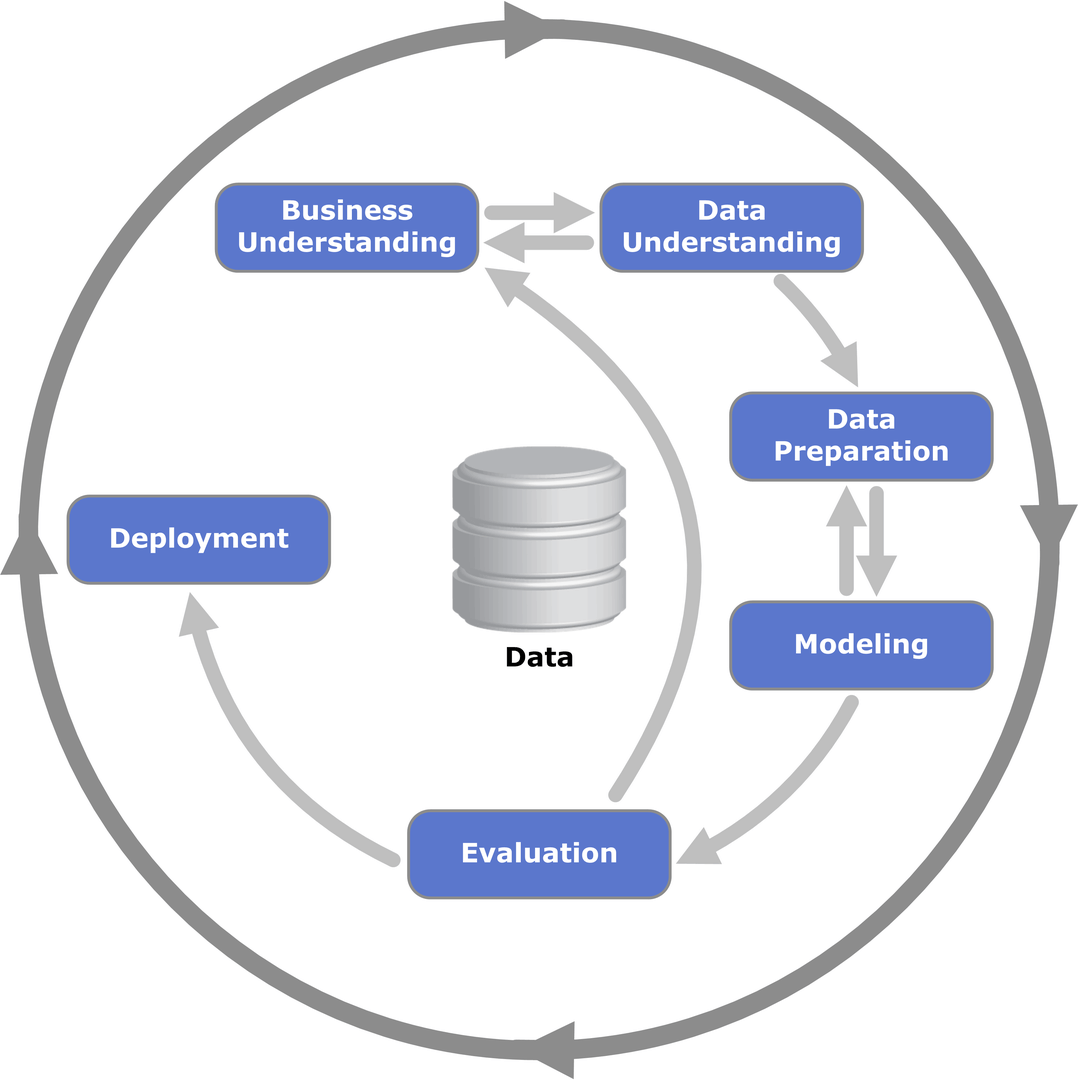
(出典:Wikipedia-‘Cross-industry standard process for data mining’)
CRISP-DMとは、「Cross-industry standard process for data mining」の略であり、データマイニング・データサイエンス・AI開発などにおいて業界横断で標準的に使えるデータ分析プロセスになります。
このCRISP-DMには全部で6つのプロセスがあります。
それぞれについて詳しく見ていきましょう!
Business Understanding
まず全てのデータ分析は、ビジネス理解から始まります。
ロボたんビジネス理解ってデータ分析関係なくない!?
ウマたんいや、データ分析だからといって、いきなりデータを触ってモデルを構築するわけではないんだよ!
データ分析というと、プログラミング言語やツールを使ってデータにアクセスするイメージがあると思いますが、最初は往々にしてビジネスを理解してビジネス課題を特定するところから始まります。
とはいえ、この段階でデータを触ってはいけないわけではありません。
理想はマクロ的な視点でビジネス課題を特定してその課題に対する仮説を基にデータを触ることですが、個人的にはデータをとりあえず触ってみるというところから始まってよいと思っています。
というかそこにあまり理路整然とした順番は必要ありません。
図でもBusiness UnderstandingとData Understandingが行き来しているように、シャープな課題特定と仮説立てにはこのプロセスの行き来が必要なのです。
ここでは、その課題に対してどのような出口設計をするのか、どのように効果検証を行うのかという事前設計も重要です。
このフェーズはコンサルタントの仕事に近く、コンサル本が役に立ちますが、定番は「イシューからはじめよ」といったところでしょうか。

Business understandingの工程に関しては以下の記事で詳しく解説しています。
 データ分析におけるビジネス理解の重要性と具体例について見ていこう!当サイト【スタビジ】の本記事では、データ分析におけるビジネス理解の重要性と具体例について解説していきます!データ分析の価値を最大化するためにはその前手のビジネス課題の特定が非常に重要なんです。ビジネスをしっかり理解してデータ分析の価値を高めていきましょう!
Data Understanding
Business Understandingと相互的に行うのがData Understanding。
データの構造や中身を分かっていないと、データ分析に移ることはできません。
もしかしたら元々Business Understandingで設計した課題と仮説を検証するデータがそもそも揃っていないかもしれません。
その場合、そのデータを新たに計測もしくは別のDMPから連携するのか、それとも別の検証方法を考えるべきなのか検討しなくてはいけません。
ここでDMPをしっかり作り込めているか否かの差が大きく出てきてしまいます。
また、このフェーズでは探索的データ分析(EDA)と呼ばれるステップをおこなっていきます。
このステップは地味な面も多いですが、これからのモデル構築の精度を決める非常に重要なステップとも言えます。
以下の記事で探索的データ分析(EDA)については詳しく解説していますので是非チェックしてみてください!
 探索的データ分析(EDA)の手順と方法について実データ×Pythonで理解しよう!当サイト【スタビジ】の本記事では、データ分析において非常に重要な探索的データ分析(EDA)のステップと方法について解説していきます!地味に思えるかもしれませんが、非常に重要でEDAなしには精度の高いモデルは構築できませんし、意味のある意思決定はできません。実データを題材にPythonを使いながら手を動かしてEDAを学んでいきますよ。
データを簡単に集計して可視化を行い、どこに課題があるのか見極めていくことになります。
PythonだとPandasを使い加工集計し、MatplotlibやSeabornと呼ばれるライブラリを使用することで比較的簡易的に可視化を行うことができます。
ウマたん可視化することで初めてわかる関係もあるから、このプロセスを疎かにしないように!
Data Preparation
続いてData Preparation。
このプロセスは、いわゆるデータ分析における前加工・前処理と言われるところです。
最もデータ分析において時間がかかる工程であり、地味な作業が多いです。
などの工程が必要になります。
Modeling
データ分析という言葉から連想されるイメージはこのモデリングの場合が多いかもしれません。
しかし、実際はこのモデリング自体は便利なライブラリが用意されているためそれほど時間がかからないのです。
※モデル構築のコーディングには時間はかかりませんが、モデル学習自体は時間がかかる場合が多いです。
選択するモデルにはたくさんの種類がありますが、選択する上での基準はいくつかあります。
例えば、
精度だけを求めるのであれば、勾配ブースティングもしくはディープラーニング。
解釈容易性を求めるのであれば、決定木やロジスティック回帰などが好まれます。
またKaggleなどのデータコンペでは、とにかく高い精度を出力することが求められるのでいくつかのモデルを組みあわせて(アンサンブル)、最終結果とすることもあります。
そもそも勾配ブースティングが自体がアンサンブル学習なのですが、それをさらに他の様々な手法とアンサンブルすることは、本質的ではないとは思いますが現にそれで精度が上がるのです。
機械学習の手法は以下で一挙にまとめています!
 【入門】機械学習のアルゴリズム・手法をPythonとRの実装と一緒に解説!当サイト【スタビジ】の本記事では、入門者向けに機械学習についてカンタンにまとめていきます。最終的にはどのように機械学習を学んでいけばよいかも見ていきます。細かい手法の実装もPython/Rを用いておこなっていくので適宜参考にしてみてください。
Evaluation
モデルを構築した後にそれで終わりではありません。
そのモデルを評価しなくてはいけません。
評価指標には、
などがあります。
機械学習領域と統計学領域で同じ指標でも言い方が違ったりややこしいのですが、
✓回帰のタスクであれば、RMSEあたり
✓分類のタスクであれば、再現率・適合率
を使用することが多い気がします。
再現率・適合率に関しては以下の不均衡データの記事で詳しくまとめています!
 不均衡データの対策方法と評価指標!SmoteをPythonで実装して検証していく!当サイト【スタビジ】の本記事では、実データによくありがちな不均衡データの特徴とどのように分析していったら良いかについてまとめてみました!最終的にSMOTEというオーバーサンプリング手法を使ってPythonで解析していきます!
実は、このEvaluationの段階で、思ったような効果が出ていないと判断された場合「CRISP-DM」でいうBusiness Understandingに戻ってしまっています。
つまりは、そもそも最初に立てた課題設定が間違っていたという大きな手戻りが発生しているわけですね。
CRISP-DMにおける評価のフェーズに関しては以下の記事で詳しく解説しています!
 機械学習の分類・予測精度における評価指標を徹底解説!当サイト【スタビジ】の本記事では、機械学習を実装する上での評価指標について徹底的にまとめていきます!回帰タスクや分類タスクにおける評価指標について見ていきましょう。評価フェーズや評価における注意点についても解説していきます。
Deployment
ここまできて、やっとビジネスに落とし込むことができます。
この時、しっかり現場と握れていないとDeploymentが出来ないという結果に陥りかねません。
しっかりDeploymentまで行うことができてデータ分析であり、それを行うことができるのがデータサイエンティストなのです。
そのためには、データホルダーだけで進めるのではなくマーケティングサイド・ビジネスサイドとしっかり業務要件やビジネス設計を明確にして共有しておくことが非常に大事です。
Deploymentについては以下の記事で詳しく解説しています!
 機械学習実装・導入「Deployment(デプロイ)」に関しての注意点をまとめておく!当サイト【スタビジ】の本記事では、機械学習実装「Deployment」における注意点についてまとめていきます。基礎分析の後、機械学習モデルを構築しても最終的に実装まで出来ないと意味がありません。必ず最終フェーズのデプロイについて理解しておきましょう!
CRISP-DMの利用場面
CRISP-DMの利用場面というよりも、データ分析の実例と言った方が早いかもしれませんが例えば顧客の解約率を予測してそれを防ぐことなどがあります。
これをCRISP-DMに当てはめると、非常に簡略化していますが以下のようなイメージです。
・Business Understanding
売上が落ちているのは何が原因なのか→既存顧客の解約率が下がっている→既存顧客の流出を防ぐことが急務である→既存顧客の解約率を予測する
・Data Understanding
どのようなデータがあるか調査、どのようなデータが顧客解約予測に利きそうか基礎分析
・Data Preparation
データの結合、前処理、加工、特徴量生成
・Modeling
機械学習手法でモデル構築
・Evaluation
顧客解約予測における実解約と予測解約の再現率・適合率で評価
・Deployment
解約予測された顧客に対するアプローチ(クーポン付与、メールセグメント、DM、直接アプローチ)
ちなみにデータ分析のプロセスを簡単に分かりやすくまとめているのが以下の書籍になります。
拙著「俺たちひよっこデータサイエンティストが世界を変える」

この小説はCRISP-DMにおけるDeploymentまで出来ていないのですがデータ分析のプロセスがなんとなーく分かるかなと思います。
CRISP-DM まとめ
本記事では、CRISP-DMについて見てきました!
CRISP-DMのステップをより詳しく理解するために以下のUdemyコースを用意しています。是非チェックしてみてください!
【初学者向け】データ分析コンペで楽しみながら学べるPython×データ分析講座
| 【オススメ度】 | |
|---|---|
| 【講師】 | 僕自身!今なら購入時に「FLSHDGEJURXF」という講師クーポンコードを入れると90%オフ以上の割引価格になりますのでぜひご受講ください! |
| 【時間】 | 4時間 |
| 【レベル】 | 初級~中級 |
僕自身がUdemyの色んなコースを受けてみた中で、他のコースにはないこんなコースあったらいいなみたいなコースを作ってみました。
このコースは、なかなか勉強する時間がないという方に向けてコンパクトに分かりやすく必要最低限の時間で重要なエッセンスを学び取れるように作成しています。
アニメーションを使った概要編とハンズオン形式で進む実践編に分かれており、概要編ではYoutubeの内容をより体系的にデータ分析・機械学習導入の文脈でまとめています。
データサイエンスの基礎について基本のキから学びつつ、なるべく堅苦しい説明は抜きにしてイメージを掴んでいきます。
統計学・機械学習の基本的な内容を学び各手法の詳細についてもなるべく概念的に分かりやすく理解できるように学んでいきます。
そしてデータ分析の流れについてはCRISP-DMに沿って体系的に学んでいきます!
データ分析というと機械学習でモデル構築する部分にスポットがあたりがちですが、それ以外の工程についてもしっかりおさえておきましょう!
続いて実践編ではデータコンペの中古マンションのデータを題材にして、実際に手を動かしながら機械学習手法を実装していきます。
ここでは、探索的にデータを見ていきながらデータを加工し、その上でLight gbm という機械学習手法を使ってモデル構築までおこなっていきます。
是非興味のある方は受講してみてください!
Twitterアカウント(@statistics1012)にメンションいただければ1500円になる講師クーポンを発行いたします!
また、当メディアが運営するAIデータサイエンス特化スクールの「スタアカ(スタビジアカデミー)」でも、CRISP-DMに沿って分析の流れをミッチリ学ぶことが可能です。
公式サイト:https://toukei-lab.com/achademy/
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
月額1,280円のライトプランで、統計学から機械学習・生成AIまで全コースが受講し放題です!
プレミアムプランでは、24時間以内の質問対応と現役データサイエンティストとの1on1(30分×4回)を実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
他のスクールのカリキュラムはPythonでの機械学習実装だけに焦点が当たっているものが多く、実務に即した内容になっていないものが多いです。
そんな課題感に対して、実務で使うことの多いSQLや機械学習のビジネス導入プロセスの理解などもあわせて学べるボリューム満点のコースになっています!
ウォルマートのデータを使って商品の予測分析をしたり、実務で使うことの多いGoogleプロダクトのBigQueryを使って投球分析をしたり、データサイエンティストに必要なビジネス・マーケティングの基礎を学んでマーケティングプランを作ってもらったりする盛りだくさんの内容になってます!
冒頭でも述べましたが、CRISP-DMという言葉を知っているかどうかは重要ではありません。
CRISP-DMのフレームワーク
の流れと各プロセスを理解して実践できるようにしましょう!
ロボたんなるほどー!一見Modelingだけが目立つけど、それは一連のデータ分析の一部分でしかないんだねー!
ウマたんModelingよりも実はBusiness UnderstandingやData Preparationなど前手のプロセスが非常に重要なんだよ!
データ分析に有用なPythonの勉強法については以下の記事でまとめています。
 【Python独学勉強法】Python入門を3ヶ月で習得できる学習ロードマップ当サイト【スタビジ】の本記事では、過去僕自身がPythonを独学を駆使しながら習得した経験をもとにPythonを効率よく勉強する方法を具体的なコード付き実装例と合わせてまとめていきます。Pythonはできることが幅広いので自分のやりたいことを明確にして勉強法を選ぶことが大事です。
また、データサイエンティストについてロードマップは以下の記事でまとめていますので是非参考にしてみてください!
 【5分で分かる】データサイエンティストに必要なスキルと独学勉強ロードマップ!当サイト【スタビジ】の本記事では、データサイエンティストに求められるスキルとそれを身に付けるための勉強法について徹底的にまとめていきます!入門者でも、しっかりデータサイエンティストについて理解しある程度独学で駆け出しの状態までいけることを目指します。
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「データサイエンティスト」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。