チャーン分析/チャーン予測とは?実際に用いられる手法とPythonでの実装方法
目次
 ウマたん
この記事では、顧客の離反を防ぐための施策であるチャーン分析についてまとめていきます。チャーン分析に使える手法をいくつか紹介した後、その中で定番のロジスティック回帰分析をPythonで実装していきます!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
サービスをグロースさせるためには当たり前ですがそのサービスが保有する会員数・契約者数を増やすことが大事。
そして、契約増加数は(新規契約数ー解約数)で表現することができます。
サービスローンチ直後は新規契約数をとにかく増やすことに注力するべきですが、ある程度安定した市場になってくると解約数をいかに減らすかが喫緊の問題になってきます。
例えば、日本の3大キャリアは新規契約数を取ることに躍起になり解約数を減らす手段がなかなかワークしていないのが現状です。
既存の顧客のロイヤリティを高めいかに解約数を減らすかが非常に重要になってきているのです。
そんな解約数を減らすために有用なのが「チャーン分析」と呼ばれる手法。
ウマたんチャーン分析はもし上手くいけば大きなビジネスインパクトを与えることができるんだ!
この記事ではそんなチャーン分析の特徴とPythonでの実装を見ていきたいと思います。
ウマたんPythonの勉強は以下の記事をチェック!
 【Python独学勉強法】Python入門を3ヶ月で習得できる学習ロードマップ当サイト【スタビジ】の本記事では、過去僕自身がPythonを独学を駆使しながら習得した経験をもとにPythonを効率よく勉強する方法を具体的なコード付き実装例と合わせてまとめていきます。Pythonはできることが幅広いので自分のやりたいことを明確にして勉強法を選ぶことが大事です。
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!
チャーン分析とは
それでは、まずチャーン分析とは何なのか見ていきましょう!
以下のYoutube動画でも詳しく解説しています!

チャーン分析のチャーンとは、英語で「かき混ぜる・激しく動く」などの意味。そこからビジネスの世界でチャーンと言うと解約という意味を表します。
すなわちチャーン分析とは解約する顧客を予測するという分析手法。
解約予測なので、チャーン予測とも呼ばれます。
チャーン分析により正確に解約顧客を予測することが出来れば、効率よく解約顧客を減らすことができる可能性が高くなります。
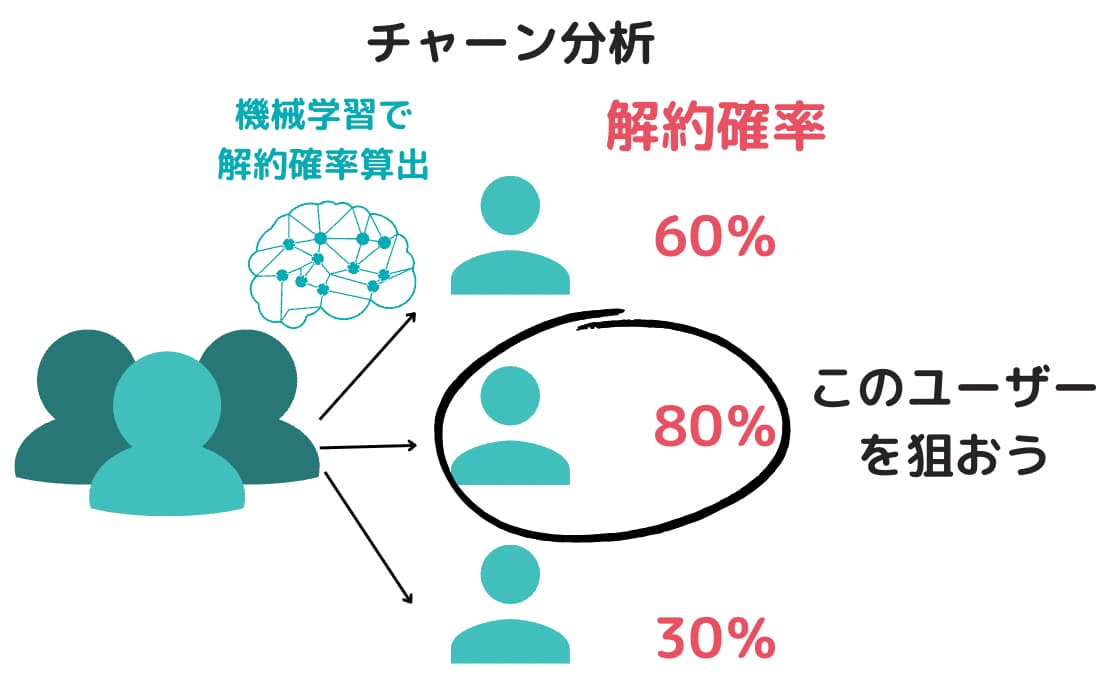
やみくもに解約数を減らそうとするのではなく、このままだと解約してしまいそうな人に対して適切な施策を打つことが可能になるのです。
チャーン分析に用いられる手法
チャーン分析においては予測するだけではなく、どの変数が解約に影響しているかを解釈する必要も出てきます。
分析手法には、精度に重きを置く手法と結果の解釈に重きを置く手法がありますのでそれぞれについて見ていきたいと思います。
ロジスティック回帰分析
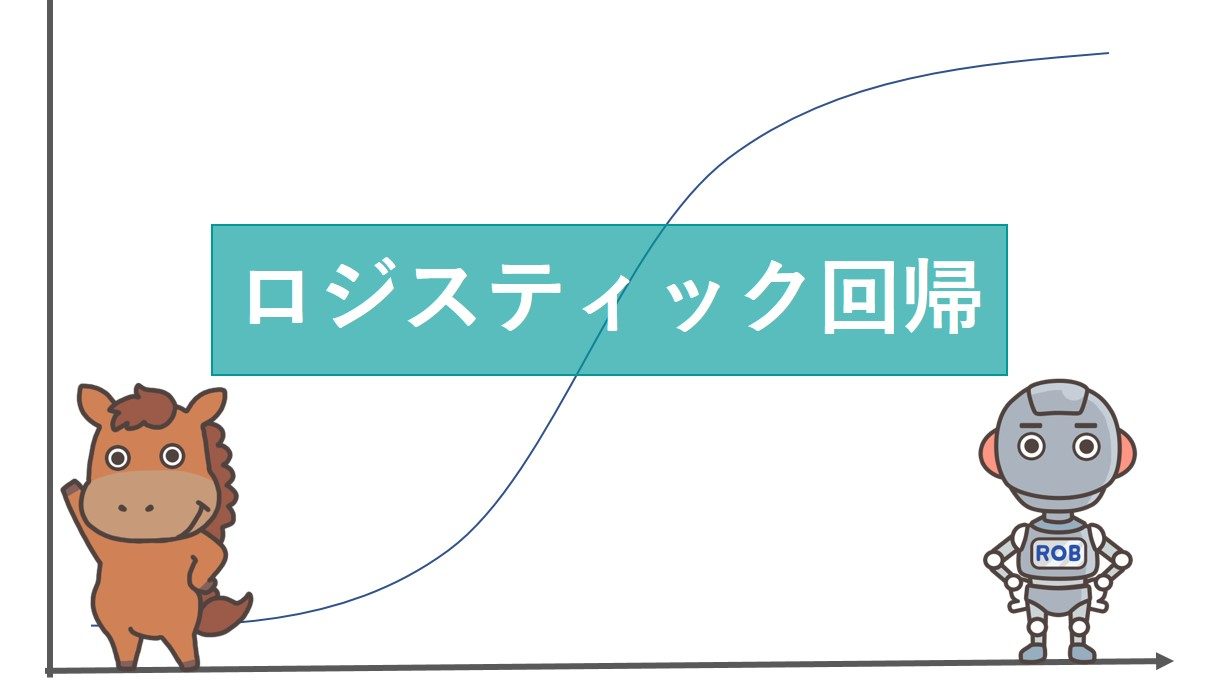
ロジスティック回帰分析は、線形重回帰分析の応用であり線形回帰分析を拡張した手法であり、重回帰分析の仲間なので説明変数がどのくらい目的変数に寄与しているかも理解しやすく、今後の施策に活かしやすくなっています。
また、結果は0,1ではなく確率値で表現することが可能なため解約する確率が80%以上と予測された人に施策を打つなどと閾値を決めてアクションを取ることができるのが特徴です。
こちらは、結果の解釈に重きを置く手法。
予測精度だけ見ると、これから紹介する機械学習手法の方が高いことが多いです。
ロジスティック回帰分析に関してもっと詳しく知りたい方はこちらをご覧ください!
ロジスティック回帰の理論とRによる実装方法を徹底解説!当サイト【スタビジ】の本記事では、ロジスティック回帰についてRでの実装と共に見ていきます。ロジスティック回帰は2値分類問題において解釈がしやすく実務の場でもよく用いられている手法です。最後に理論と実装をより深く学ぶ勉強法も紹介していきますよー!
ウマたん解釈性の高さから、ビジネスの現場でもよく使われる手法だよ!
ランダムフォレスト
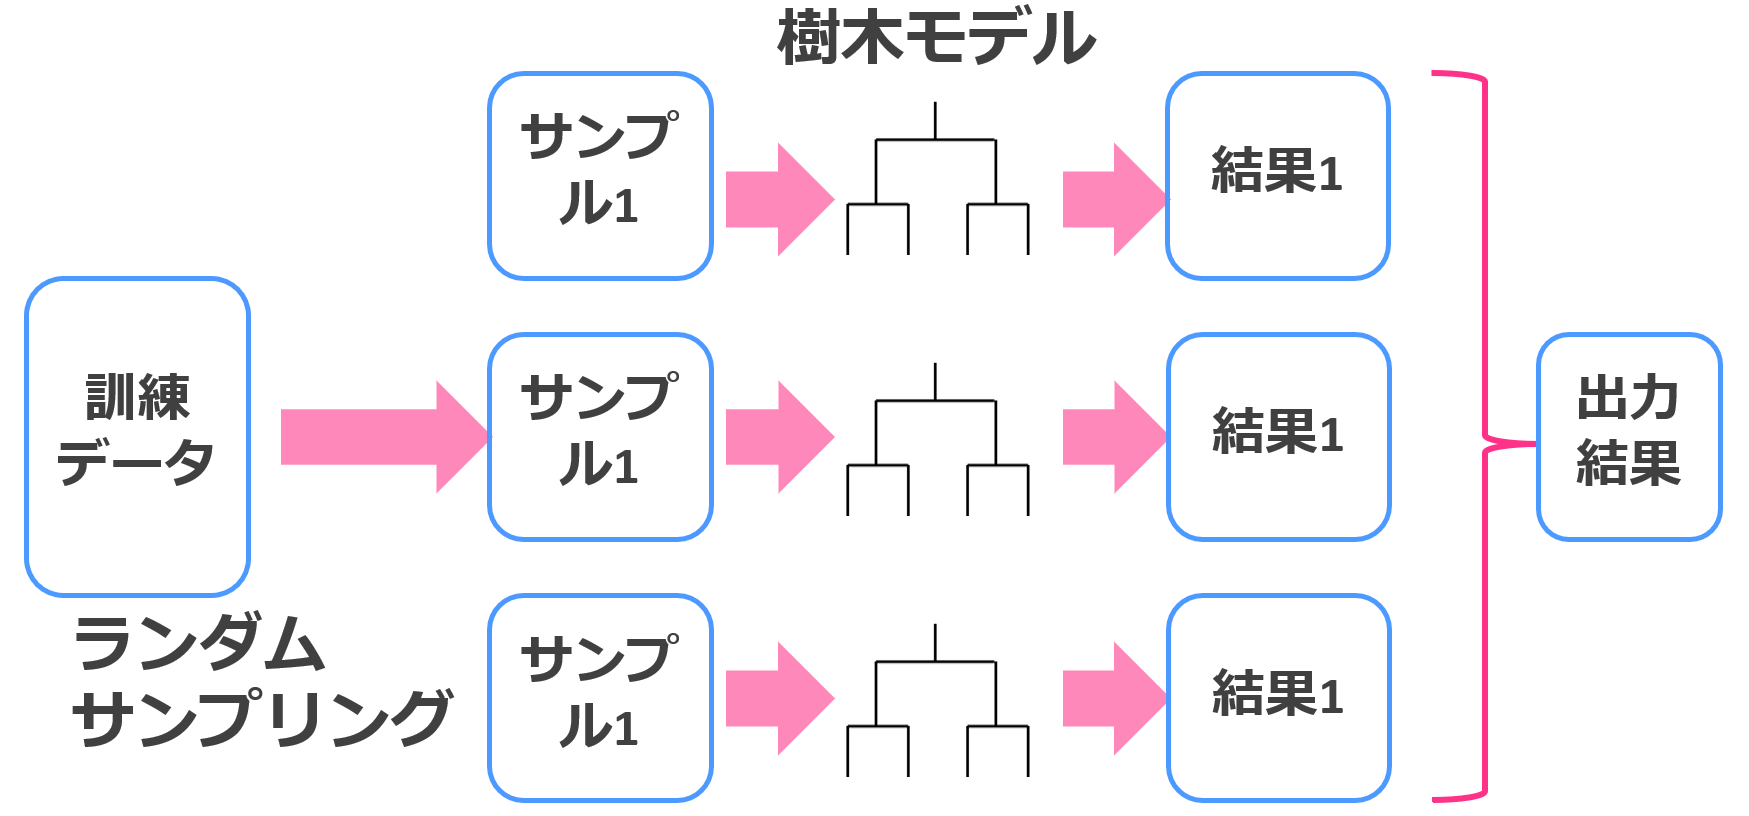
ランダムフォレストは、簡単な実装でかつ高速でそこそこ高い精度をたたき出せる便利な手法。
ざっくり言うと、
決定木をたくさん集めて合体させた手法
です。
決定木は単体だとそれほど強い手法ではありません。
しかし、その決定木をバギングと呼ばれる集団学習法を用いてたくさん集めてくると最強のランダムフォレストが出来上がるんです。
集団学習法は,決して精度が高いとはいえない弱いモデルをたくさん構築し,これらの予測結果を統合することで高い精度を出す方法論です。
ランダムフォレストでは変数重要度を算出することが可能でどの変数が寄与しているかは把握することが可能です。
ランダムフォレストに関してもっと詳しく知りたい方はこちらをご覧ください!
 ランダムフォレスト(random forest)とは?PythonとRで実装してみよう!当サイト【スタビジ】の本記事では、決定木をアンサンブル学習することにより汎化能力を高めた強力な機械学習手法「ランダムフォレスト」について見ていきましょう!アルゴリズムを確認した後にRでもPythonでも実装をおこなっていきますよー!
XGBoost
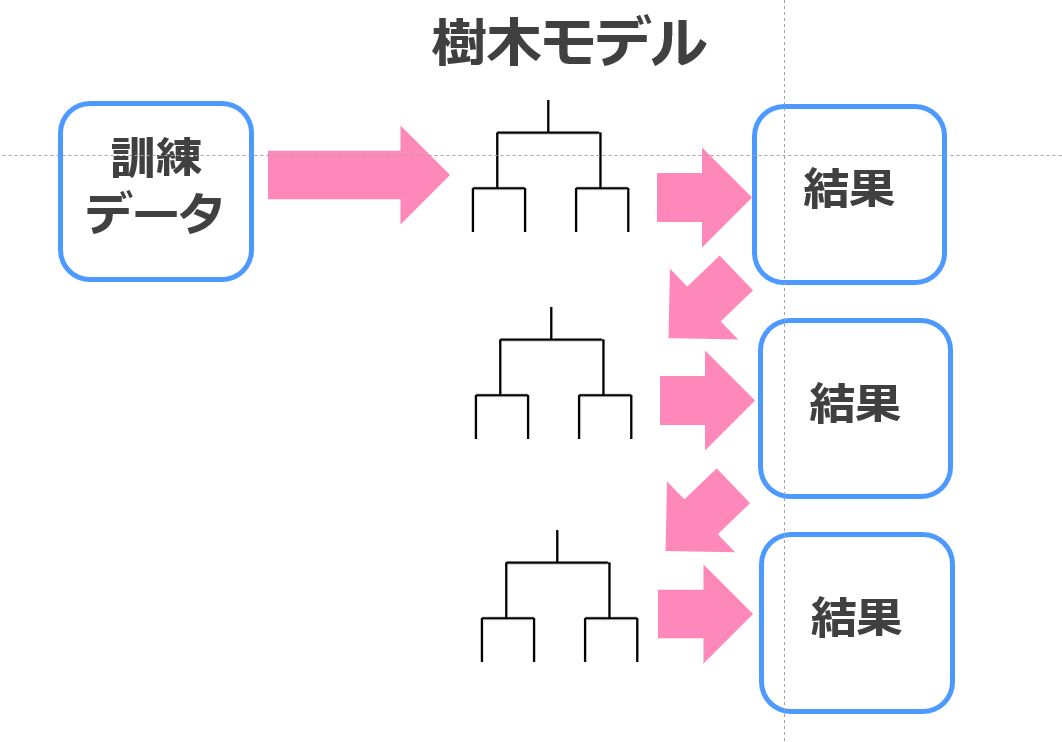
XGBoostもランダムフォレストと同じく決定木を基にした手法です。
ランダムフォレストはアンサンブル学習であるバギングを決定木と組み合わせていますが、XGBoostではアンサンブル学習であるブースティングを決定木と組み合わせています。
バギングは弱い学習器(決定木)が並列で多数決を行うことで効果を発揮するイメージですが、ブースティングは直列でチューニングを行い徐々に改善していくイメージです。
データセットやパラメータにもよりますが、ランダムフォレストよりもXGBoostの方が時間がかかる分精度が高い場合が多いです。
XGBoostでも変数重要度を算出することが可能です。
ただ、どの説明変数がどのくらい変化したら目的変数もどのくらい変化するかを算出するのはロジスティック回帰分析に得意とするところでXGBoostやランダムフォレストでは難しいです。
XGBoostに関して詳しくは以下の記事をご覧ください!
 【わかりやすく解説】XGboostとは?理論とPythonとRでの実践方法!当ブログ【スタビジ】の本記事では、機械学習手法の中でも非常に有用で様々なコンペで良く用いられるXgboostについてまとめていきたいと思います。最後にはRで他の機械学習手法と精度比較を行っているのでぜひ参考にしてみてください。
ちなみにXgboostを改良したLightGBMとCatboostもいかにまとめています!
 【図解で解説】LightGBMの仕組みとPythonでの実装を見ていこう!当サイト【スタビジ】の本記事では、最強の機械学習手法「LightGBM」についてまとめていきます。LightGBM の特徴とPythonにおける回帰タスクと分類タスクの実装をしていきます。LightGBMは決定木と勾配ブースティングを組み合わせた手法で、Xgboostよりも計算負荷が軽い手法であり非常によく使われています。
 Catboostとは?XgboostやLightGBMとの違いとPythonでの使い方を見ていこうー!!当サイト【スタビジ】の本記事では、XgboostやLightGBMに代わる新たな勾配ブースティング手法「Catboost」について徹底的に解説していき最終的にPythonにてMnistの分類モデルを構築していきます。LightGBMやディープラーニングとの精度差はいかに!?
ウマたん
XGboostやランダムフォレストも使われることはあるけど、まだまだロジスティック回帰分析はビジネス最前線でよく使われるメジャーな手法なんだ!
チャーン分析による企業課題の解決を以下の小説でまとめていますので是非参考にしてみてください!

あまり具体的なデータサイエンティストの仕事について分かりやすく書いている本が見当たらなかったので自分で執筆しました!
ストーリー形式で分かりやすく書いていますので、目を通していただけるとイメージが湧くと思います。
価格は300円ちょっとですし、Kindle unlimitedであれば無料で読めるのでぜひチェックしてみてくださいね!
チャーン分析で気を付けなければいけないこと
チャーン分析で高い精度を算出するのは適切な変数さえ選べばそれほど難しくはありません。
ただ大事なのは、その結果をどのようにビジネスに落とし込むか。
例えばある変数が解約率にものすごく影響していることが分かったとしても、そのような変数は往々にして「これまでの継続月数」などアンコントローラブルであり解約に影響しているのは当たり前である変数なことが多いです。
仮に継続月数が長いほど解約率が低いという因果関係が分かったとして嬉しいでしょうか?
ふーん、まあ当たり前だよね、継続月数を伸ばすのが難しいんだよ、とそれだけではアクションに繋がりません。
そこでよく行われるのは、解約率によってユーザーをセグメント分けしそれぞれのセグメントに対してABテスト的にある施策を打ってみてその結果を受け今後の施策を使い分けるというモノ。
例えば、解約率20%以下ユーザーに過剰なクーポン施策を行うとチャーンレートが上がってしまうかもしれませんが、80%以上のユーザーに対しては過剰なクーポン施策が有効かもしれません。
ユーザーをセグメントに分けて効果検証を行うことで、ただの予測がアクションに結び付く結果になるのです。
実際にロジスティック回帰分析でチャーン分析をやってみよう!
ここでは簡易的にロジスティック回帰分析を使ってチャーン分析を行ってみます。
PythonでもRでも簡単に実装できますが、今回はPythonを使って実装してみます。
用いるのは、ライブラリscikit-learnに入っているdiabetesというデータセット。
from sklearn.datasets import load_diabetes
diabetes = load_diabetes()
print(diabetes.feature_names)
[‘age’, ‘sex’, ‘bmi’, ‘bp’, ‘s1’, ‘s2’, ‘s3’, ‘s4’, ‘s5’, ‘s6’]
患者の状況と1年後の症状がデータとして入っています。
10個の説明変数に対して、症状を表す1つの量的変数が目的変数。
それぞれの変数については見ていかず予測精度だけ見ていきます。
チャーン分析にふさわしいデータセットが見つからなかったので、今回はこのデータセットを使って疑似的にチャーン変数を作っていきます。
1年後の症状は量的変数で入っているので、ここでは平均より高い場合は1、低い場合は0と無理やり変換して、ある患者の現在の症状から1年後の0・1症状を予測します。
本来であれば、解約をフラグの0,1に対して解約確率を算出するイメージです。
コードは以下。
# 必要なライブラリ読み込み
import numpy as np
import pandas as pd
from statistics import mean
from sklearn.datasets import load_diabetes
diabetes = load_diabetes()
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression as LR

# 01に変換
label=[]
for i in diabetes.target:
    if i>mean(diabetes.target):
        label.append(1)
    else: label.append(0)

# ランダムにテストデータと訓練データ作成
X_train, X_test, y_train, y_test = train_test_split(
        diabetes.data, label, test_size=0.5, random_state=1234)

# ロジスティック回帰実行
clf = LR()
clf.fit(X_train, y_train)

# テストデータのラベル予測
a = clf.predict(X_test)

# 予測精度
clf.score(X_test, y_test)
アウトプットとしては、テストデータの0/1を予測したリストと、予測精度が算出されます。
疑似的にチャーン分析を行うことができました。
無理やり0/1変数を作り出したのでそれほど高い予測精度は出ておりません。
ここでは行いませんが、XGBoostやランダムフォレストで実装するともっと良い精度が出るでしょう。
また、回帰モデルの回帰係数を用いれば、それぞれのサンプルのチャーン確率を算出することができます。
チャーン確率によってユーザーをセグメント分けすることでビジネスチャンスが見出されるかもしれません。
チャーン分析 まとめ
本記事では、チャーン分析の説明と注意点、簡単な実装について見てきました!
チャーン分析を身に付ければビジネスに大きなインパクトを与えられること間違いなし!
チャーン分析の考え方自体は簡単ですが、
はなかなか難しい。
統計学・機械学習・データサイエンス・AI・Pythonについて勉強したい方は以下の記事を参考にしてみてください!
 【初心者必見】統計学入門に必要な知識と独学勉強方法を簡単に学ぼう!当ブログ【スタビジ】の本記事では、統計学入門に必要な知識をカンタンにまとめ、それらをどのように効率的に独学で勉強していけばよいかをお話ししていきます。統計学は難しいイメージが少しありますが、学び方をしっかり考えれば大丈夫!
 【5分で分かる】機械学習の独学勉強ロードマップを徹底的にまとめていく!当サイト【スタビジ】の本記事では、機械学習の独学勉強ロードマップについて徹底的にまとめていきます。機械学習をいきなり理論からしっかり勉強しようとすると挫折しかねません。そこで、この記事ではなるべく挫折しないロードマップをお伝えしてきますよ!
 【5分で分かる】データサイエンティストに必要なスキルと独学勉強ロードマップ!当サイト【スタビジ】の本記事では、データサイエンティストに求められるスキルとそれを身に付けるための勉強法について徹底的にまとめていきます!入門者でも、しっかりデータサイエンティストについて理解しある程度独学で駆け出しの状態までいけることを目指します。
 【これだけ!】AI(人工知能)の勉強ロードマップを徹底的に解説!当サイト【スタビジ】の本記事では、AIを勉強するロードマップについて徹底的に解説していきます。まずは、AIの概要について理解して統計学の基本知識・機械学習の基本知識・Pythonでの実装・インフラ周りの知識などを包括的に理解していきましょう!
【Python独学勉強法】Python入門を3ヶ月で習得できる学習ロードマップ当サイト【スタビジ】の本記事では、過去僕自身がPythonを独学を駆使しながら習得した経験をもとにPythonを効率よく勉強する方法を具体的なコード付き実装例と合わせてまとめていきます。Pythonはできることが幅広いので自分のやりたいことを明確にして勉強法を選ぶことが大事です。
また、詳しくAIやデータサイエンスの勉強がしたい!という方は当サイト「スタビジ」が提供するスタビジアカデミーというサービスで体系的に学ぶことが可能ですので是非参考にしてみてください!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「Python基礎」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。