【入門】機械学習のアルゴリズム・手法をPythonとRの実装と一緒に解説!

目次
 ウマたん
当サイト【スタビジ】の本記事では、入門者向けに機械学習のアルゴリズム・手法についてカンタンにまとめていきます。RやPythonによる実装も同時に行うので概要の理解と手を動かしながらの実装の理解を同時にしていきましょう!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
AIやビッグデータ、機械学習という言葉が巷を賑わせていますが、実際に機械学習とは何かご存知でしょうか?
 ロボたん
んー、何なのかイマイチ分かっていない部分も多いなー・・
ウマたん言葉だけが先歩きしてしまっている感は否めないよねー!
この記事では、機械学習のアルゴリズムや手法の種類とPythonやRによる実装について見ていきますよ!
ウマたんどんな人にとっても機械学習について知っておくことは大事だよ!
機械学習の実装方法について網羅的に知りたいのであれば「スタアカ(スタビジアカデミー)」をチェックしてみてください!
機械学習と密接に関わっているパターン認識についての記事もぜひご参照ください!
 パターン認識の事例やAIや機械学習との関連性をわかりやすく解説!当サイト【スタビジ】の本記事では、パターン認識とは何なのかについて具体的な事例や手法、さらにはPythonでの実装方法を交えて分かりやすく解説していきます!
機械学習とは
まずは、機械学習について簡単に確認しておきましょう!
以下の動画でも分かりやすく解説していますよー!

機械学習とは、その名の通り「機械に学習させてルールを作り出す」ということ。
機械学習が発展する前は、人間がルールを決めていました。
レコメンドで言えば、

この商品を購入した人にはこの商品を紹介したいから、そのようなルールを決めよう!
というように(ルールベースレコメンドと呼びます)。
そこに存在するのは人間の勘と想像です。
実際にこのようなレコメンドはまだまだ実用的に使われていますが、より精度の高いレコメンドを行うためには機械学習が必要になります。
「この商品を購入した人はこの商品を購入する確率が高いから、そのようなルールを作る」というように現在存在するデータを学習して自動的にルールを作っていくわけです。
最近よく使われているレコメンドロジックは協調フィルタリングと言います。
簡単に言うと行動パターンの似ているユーザーが買っているモノを似たユーザーにレコメンドするといった仕組み。
レコメンドロジックについてはこちらの記事に詳しくまとめていますのでよければご覧ください!
 レコメンドで使われる4つのアルゴリズムを簡単に紐解く!当サイト【スタビジ】の本記事では、レコメンドに用いられる4つのアルゴリズムについて数式は使わずに簡単に解説していきます。レコメンドはどこに向かうのかみたいな議論もしていきたいと思います。果たして完璧なレコメンドはあり得るのでしょうか?
このように現在存在するデータから自動的にルールを作ってくれるアルゴリズムが機械学習なのです。
ちなみに統計学を起点とする多変量解析手法群もその定義からすると機械学習の中に含まれますが、機械学習手法と統計学ではスタンスが若干違います。
統計学は現在のデータを解釈することを目的としますが、機械学習は未知のデータを正確に予測できることを目的とします。
僕は、統計学は解釈追求型、機械学習は精度追求型と呼んでいます。ただ境目は曖昧ですのでそれほど気にする必要はないでしょう。明確に切り分けることはできません。
詳しくは以下の記事をご覧ください!
 機械学習と統計学/多変量解析の違いについてデータサイエンティストがモノ申す!!当サイト【スタビジ】の本記事では、データサイエンスの領域の機械学習と統計学の違いについて考察していきます。定義と境界が曖昧な2つの領域ですが、目的の違いを理解しておくことが大事。機械学習は予測精度を上げることを目的とし統計学はデータ構造の把握をすることを目的とします。
機械学習アルゴリズム・手法の種類
続いて、そんな機械学習のアルゴリズムや手法にはどんな種類があるのか見ていきましょう!
機械学習には大きく分けて教師あり学習・教師なし学習・強化学習があります。
 教師あり学習と教師なし学習の違いとは?【データサイエンティストが解説】当サイト【スタビジ】の本記事では、機械学習の基本である教師あり学習と教師なし学習の違いを、回帰・分類・クラスタリングなどの具体例とともにわかりやすく解説します。どちらにも当てはまらない強化学習についても紹介しますよ!
教師あり学習
教師あり学習はデータ群に対して正解が紐づいているデータセットを学習する手法のことを指します。
例えば、タイタニックの乗船者情報(後で実際に解析に使用します)では、様々なお客さん情報に対してそのお客さんが生き残ったか死んでしまったかのデータが入っています。
生死のラベルが付いていて、それを基にどんな客が生き残ったかのルールを作ることができるのです。
教師あり学習が最も一般的で様々な場面で使われています。
決定木

決定木はタイタニック乗船データに対しても例として用いられている一般的な手法です。
決定木のアルゴリズムは非常にシンプルで、樹木構造で変数での分類規則を作っていきます。
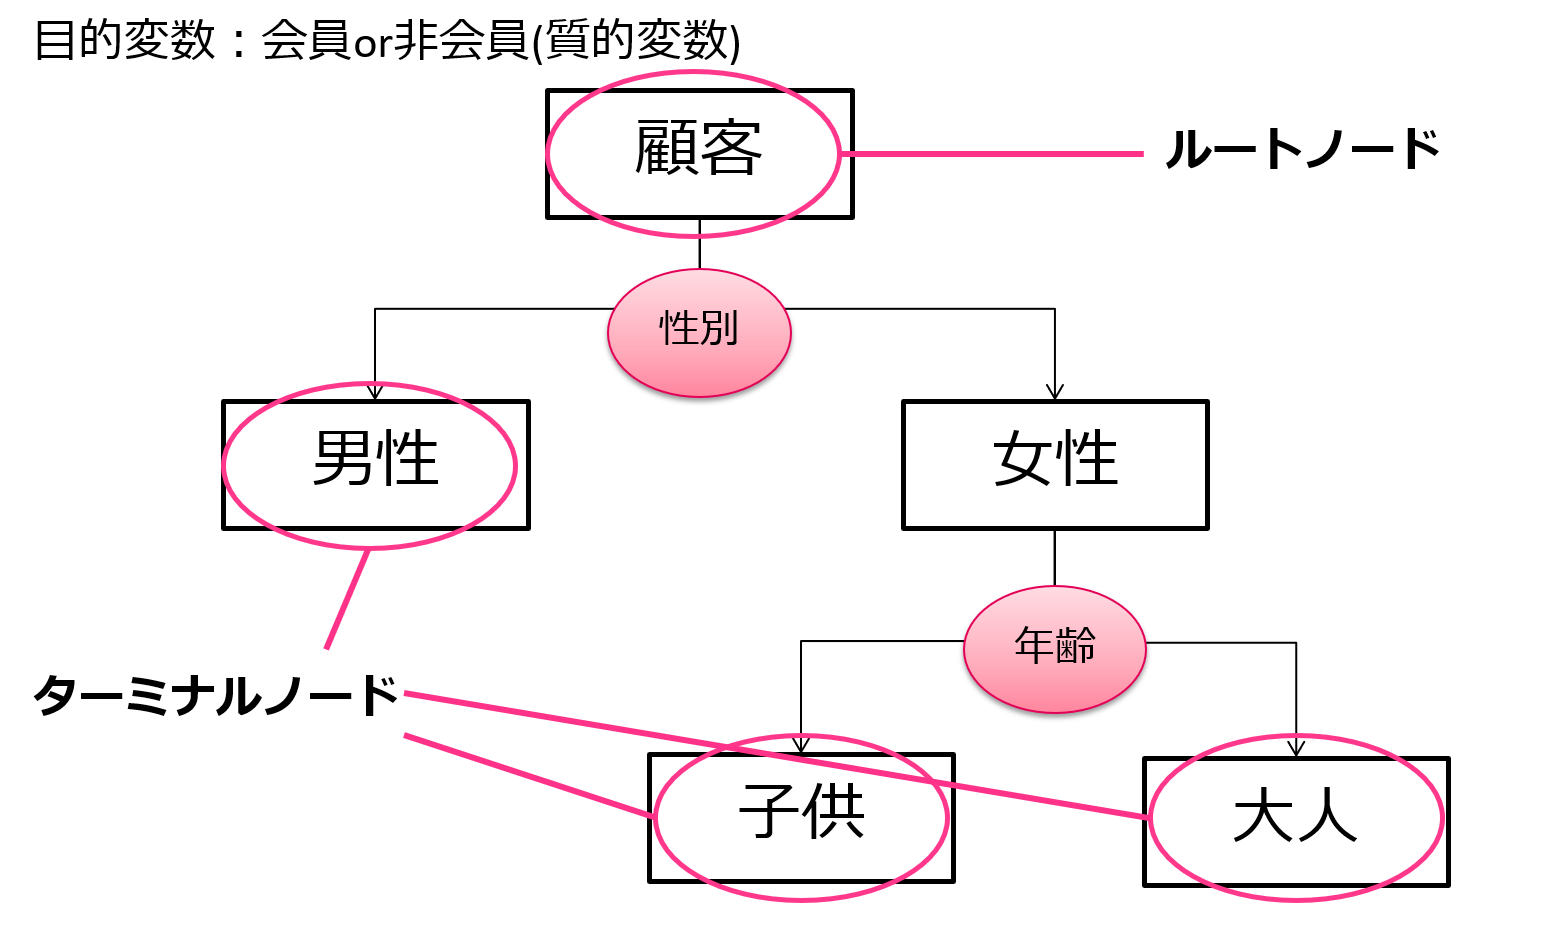
非常に分かりやすくルールも可視化しやすいためビジネスの場面で用いられることが多いです。
そういう意味でいうと、データの解釈のために使われることが多く単純な予測精度を出したいなら他の手法を用いたほうが無難です。
PythonでもRでもライブラリを呼び出すことで簡単に実装が可能。
以下はPythonのコードです。
# ライブラリの読み込み
from sklearn.tree import DecisionTreeClassifier
from sklearn import datasets
from sklearn.model_selection import train_test_split

# irisデータの読み込み
iris = datasets.load_iris()

# 特徴量とターゲットの取得
data       = iris['data']
target     = iris['target']

#学習データをテストデータを分割
train_data,test_data,train_target,test_target = train_test_split(data,target,test_size=0.5)

#モデル学習
model = DecisionTreeClassifier(criterion='gini')
model.fit(train_data, train_target)

# 正解率を表示
model.score(test_data, test_target)
決定木に関してはPython・Rどちらでの実装も合わせて以下の記事にまとめています!
 決定木について分かりやすく解説!PythonとRで実装してみよう!当サイト【スタビジ】の本記事では、機械学習手法の基本である決定木について見ていきたいと思います。アルゴリズムが分かりやすく実務でもよく使われる手法です。RとPythonでの簡単な実装も合わせておこなっていくので是非チェックしてくださいね!
k近傍法

k近傍法は、未知データの周りに存在する学習データの数から未知データのラベルを判断する機械学習モデルです。
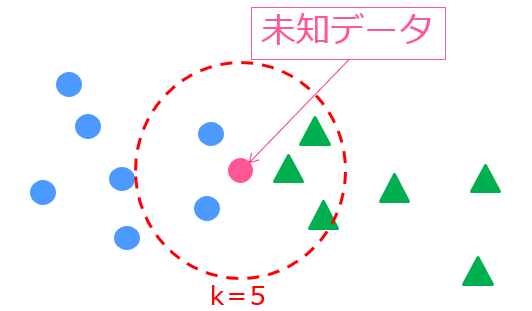
アルゴリズムはシンプルですが、ある程度精度の見込める手法です。
詳しくは以下の記事にまとめています!
後ほど紹介しますが、Rでの機械学習手法比較を行っています。
 【5分でわかりやすく解説】k近傍法とは?理論とRでの実装方法!当サイト【スタビジ】の本記事では、アルゴリズムがシンプルで分かりやすいk近傍法について理解を深めていきます。最終的にはRでの実装を行うことで理論と実装の両輪を理解していきましょう!
ランダムフォレスト

ランダムフォレストは、決定木とバギングを組み合わせた手法でそれなりの精度を簡単にたたき出してくれます。
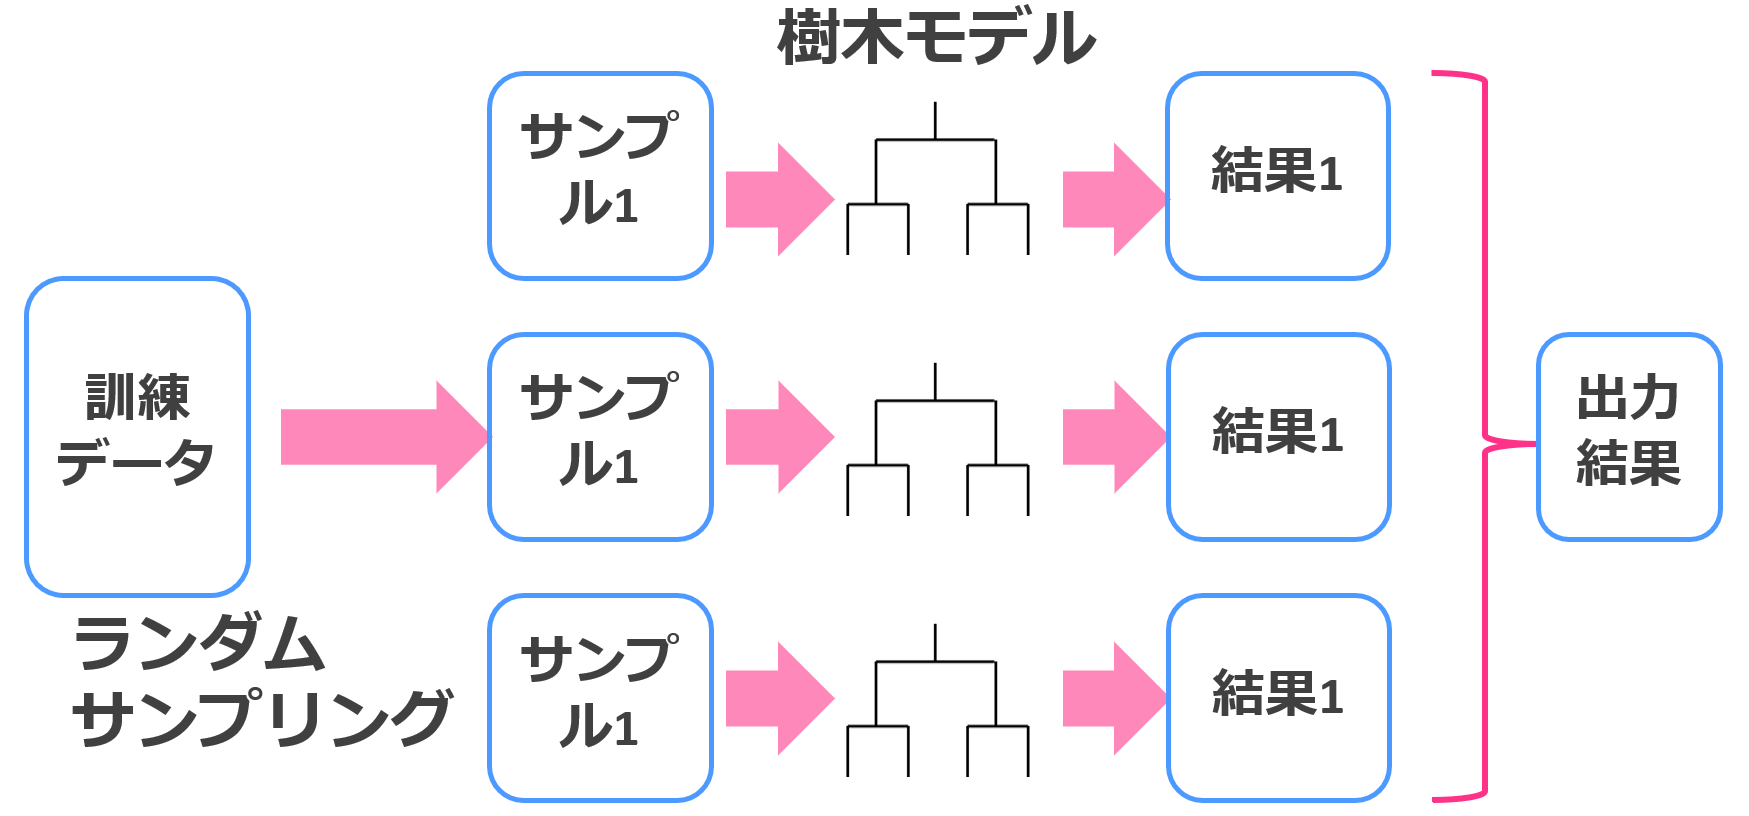
バギングは、アンサンブル学習の1つで精度を追求する際に非常によく使われるアルゴリズムです。
簡単に言うと、複数のモデルを組み合わせて最終アウトプットを決めるアルゴリズムです。
決定木のようなシンプルなアルゴリズムに対してアンサンブル学習を組み合わせるのは1つの手法として確立されています。
それほど計算負荷もかからないので、ちょっとしたデータを解析するのにはもってこいです。
決定木と同様のirisデータをPythonを使って分類できちゃいます。
# ライブラリの読み込み
from sklearn.ensemble import RandomForestClassifier
from sklearn import datasets
from sklearn.model_selection import train_test_split

# irisデータの読み込み
iris = datasets.load_iris()

# 特徴量とターゲットの取得
data       = iris['data']
target     = iris['target']

#学習データをテストデータを分割
train_data,test_data,train_target,test_target = train_test_split(data,target,test_size=0.5)

#モデル学習
model = RandomForestClassifier(n_estimators=100)
model.fit(train_data, train_target)

# 正解率を表示
model.score(test_data, test_target)
ランダムフォレストに関しては以下の記事に詳しくまとめていますので参考にしてみてください。
 ランダムフォレスト(random forest)とは?PythonとRで実装してみよう!当サイト【スタビジ】の本記事では、決定木をアンサンブル学習することにより汎化能力を高めた強力な機械学習手法「ランダムフォレスト」について見ていきましょう!アルゴリズムを確認した後にRでもPythonでも実装をおこなっていきますよー!
SVM(サポートベクターマシン)

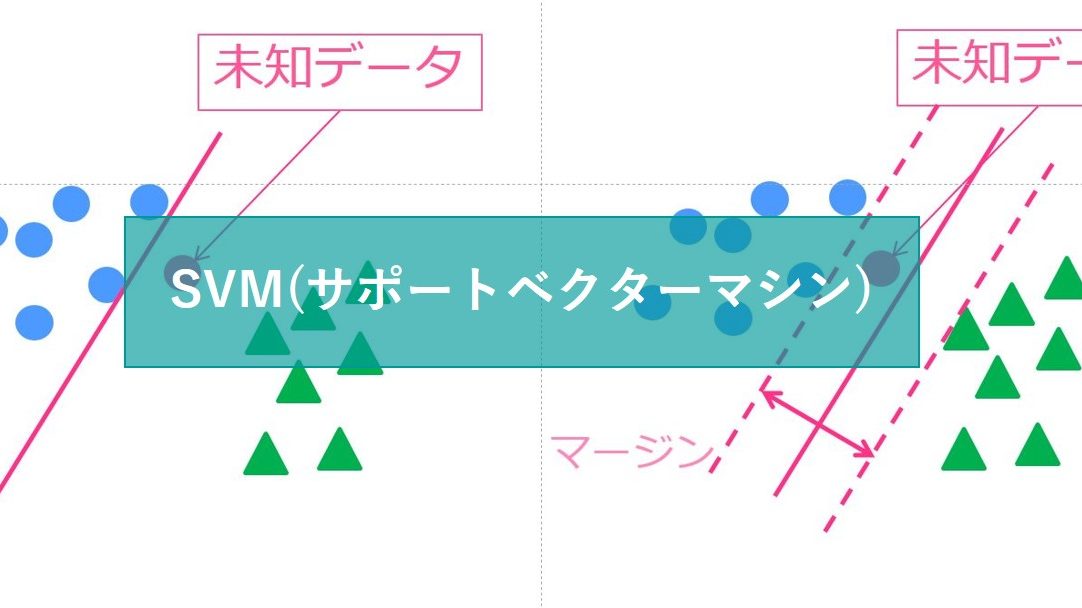
SVMもランダムフォレスト同様の精度が期待できる優秀な手法です。
サポートベクトルと呼ばれる境界付近のサンプルを使った分類とカーネル法を使った非線形化が特徴のアルゴリズムです。
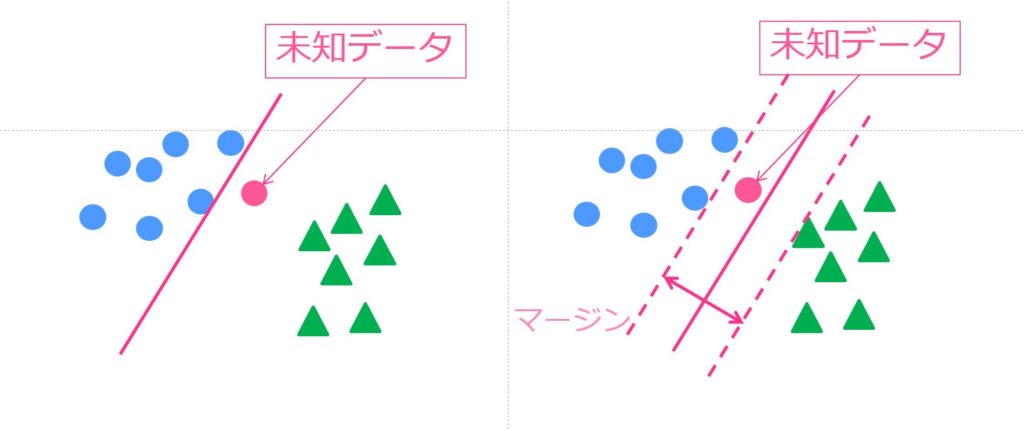
応用の幅が広く様々な分野で使われています。計算負荷は高めです。
SVMについて詳しくはこちら!
 SVM(サポートベクターマシン)とは?特徴とRによる実装!当サイト【スタビジ】の本記事では、機械学習手法の中でもアルゴリズムが分かりやすい上に汎化能力が高い優秀な手法SVM(サポートベクターマシン)についてまとめていきます!理論とRでの実装を合わせて見ていきますよー!
後ほどRでの実装比較を見ていきます
ニューラルネットワーク
ニューラルネットワークはディープラーニングの基となった手法です。

ニューラルネットワークでは人間の脳を模したシナプス結合をモデル化しており、層を信号が伝播して最終アウトプットが算出されます。
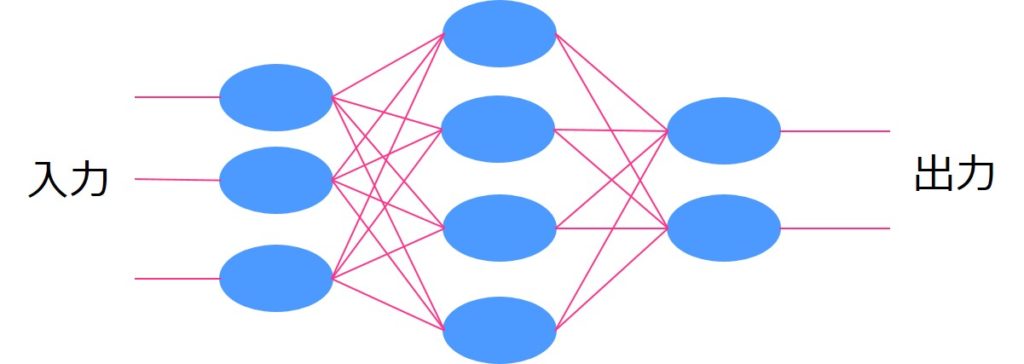
ニューラルネットワーク単体ではそれほど高い精度は見込めませんが、中間層を増やせば増やすほど学習が進み(ディープラーニングに近づき)精度が高くなります。
その分、計算負荷も上昇します。
ニューラルネットワークに関して詳しくはこちら!
 ニューラルネットワークとは?仕組みとRでの実装!当サイト【スタビジ】の本記事では、ディープラーニングの原型となるニューラルネットワークについてまとめていきます!ニューラルネットワークはディープラーニングを学ぶ上での基礎知識としておさえておいてほしい手法。Rでの実装も一緒におこなっていきますよー!
ディープラーニングに関しては以下の記事を参考にしてみてください。
 【入門】ディープラーニング(深層学習)の仕組みとPython実装のやり方!当サイト【スタビジ】の本記事では、ディープラーニングの仕組みやPythonでの実装方法について解説していきます。ディープラーニングってなんとなくブラックボックスなイメージがあるかもしれませんが、実はシンプルなアルゴリズムなんですよー!
ナイーブベイズ
ナイーブベイズはベイズ統計学の概念を用いており、様々な分野へ応用されています。
ベイズの世界では、ある事象を基に事前確率が算出され、新たに得られたデータを基に事後確率が算出されます。
そのようにして確率分布の更新が行われていきます。
ナイーブベイズが用いられる場面として最も有名なのはスパムメールの判別ですね。
スパムメールの判別では、文章に含まれる単語に対して迷惑メールである確率を算出しベイズ推定を使って迷惑メールであるか否かを推定します
以下の記事でナイーブベイズに関してまとめています!
 ナイーブベイズ(単純ベイズ)とは?概要とRでの実装!当サイト【スタビジ】の本記事では、ベイズ推定を用いた機械学習手法であるナイーブベイズについてまとめていきます!ナイーブベイズの仕組みや応用場面を見ていったあと、ナイーブベイズと他の機械学習手法をRで実装して精度を比較していきますよー!
XGboost

XGboostは、決定木と勾配ブースティングを組み合わせた手法で相当高い精度が見込めます。
Xgboostのアルゴリズムはランダムフォレストと似ているのですが、ランダムフォレストはアンサンブル学習にバギングを用いている一方Xgboostはブースティングを用いているんです。
 アンサンブル学習とは?バギングとブースティングとスタッキングの違いと注意点当サイト【スタビジ】の本記事では、アンサンブル学習についてまとめていきます!加えて学習手法のバギング、ブースティング、スタッキングについても紹介します。アンサンブル学習とは機械学習を学ぶ上で非常に重要な考えであり、いくつかのモデルを組み合わせて汎化能力を上げるもの。有名なランダムフォレストやXgboostなどもアンサンブル学習によって生み出されているんです!
勾配ブースティングの手法群は、いまだに現役のデータ分析コンペ常連の手法なんですよー!
XGboostに関しては以下の記事をご覧ください!
 【わかりやすく解説】XGboostとは?理論とPythonとRでの実践方法!当ブログ【スタビジ】の本記事では、機械学習手法の中でも非常に有用で様々なコンペで良く用いられるXgboostについてまとめていきたいと思います。最後にはRで他の機械学習手法と精度比較を行っているのでぜひ参考にしてみてください。
LightGBM

Light GBMはXgboostのあと2016年にリリースされたXgboostを改良した手法です。
Xgboostを含む通常の決定木モデルのアルゴリズムでは以下のように階層を合わせて学習していきます。
それをLevel-wiseと呼びます。
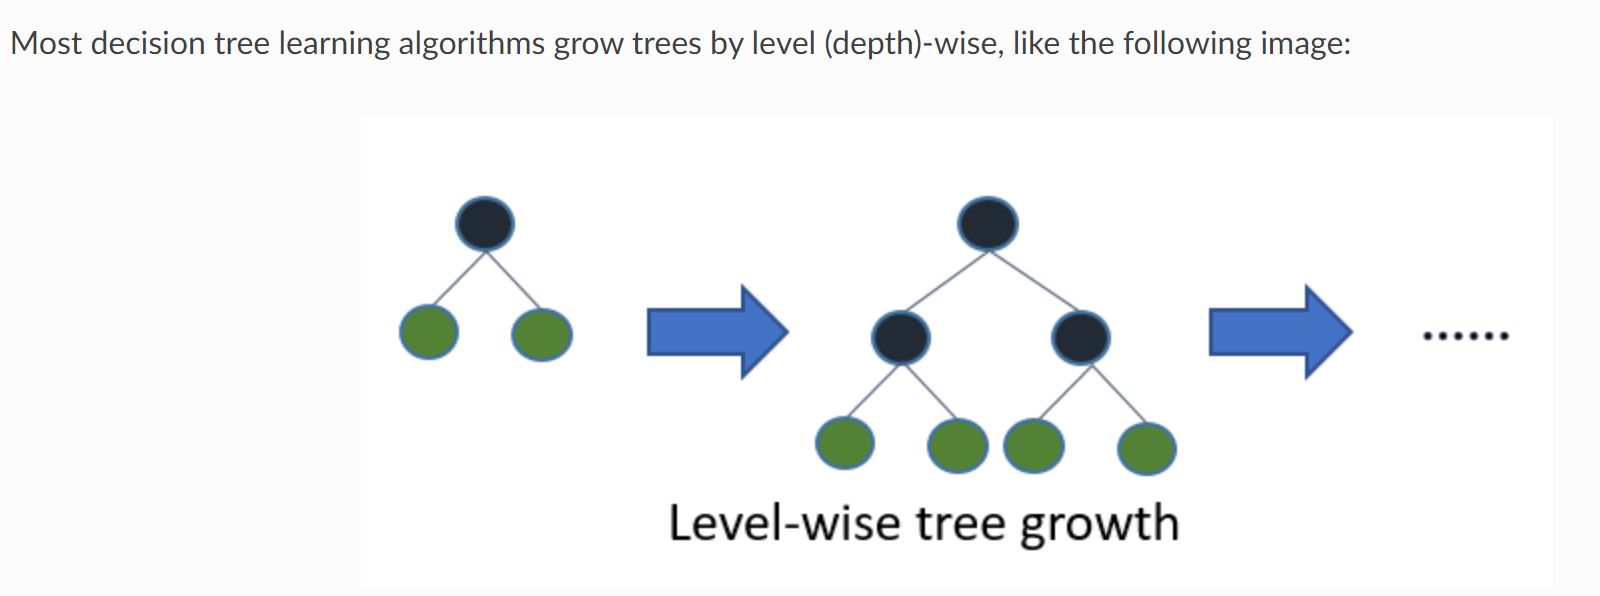
(引用元:Light GBM公式リファレンス)
一方Light GBMのアルゴリズムでは以下のように葉ごとの学習を行います。これをleaf-wise法と呼びます。
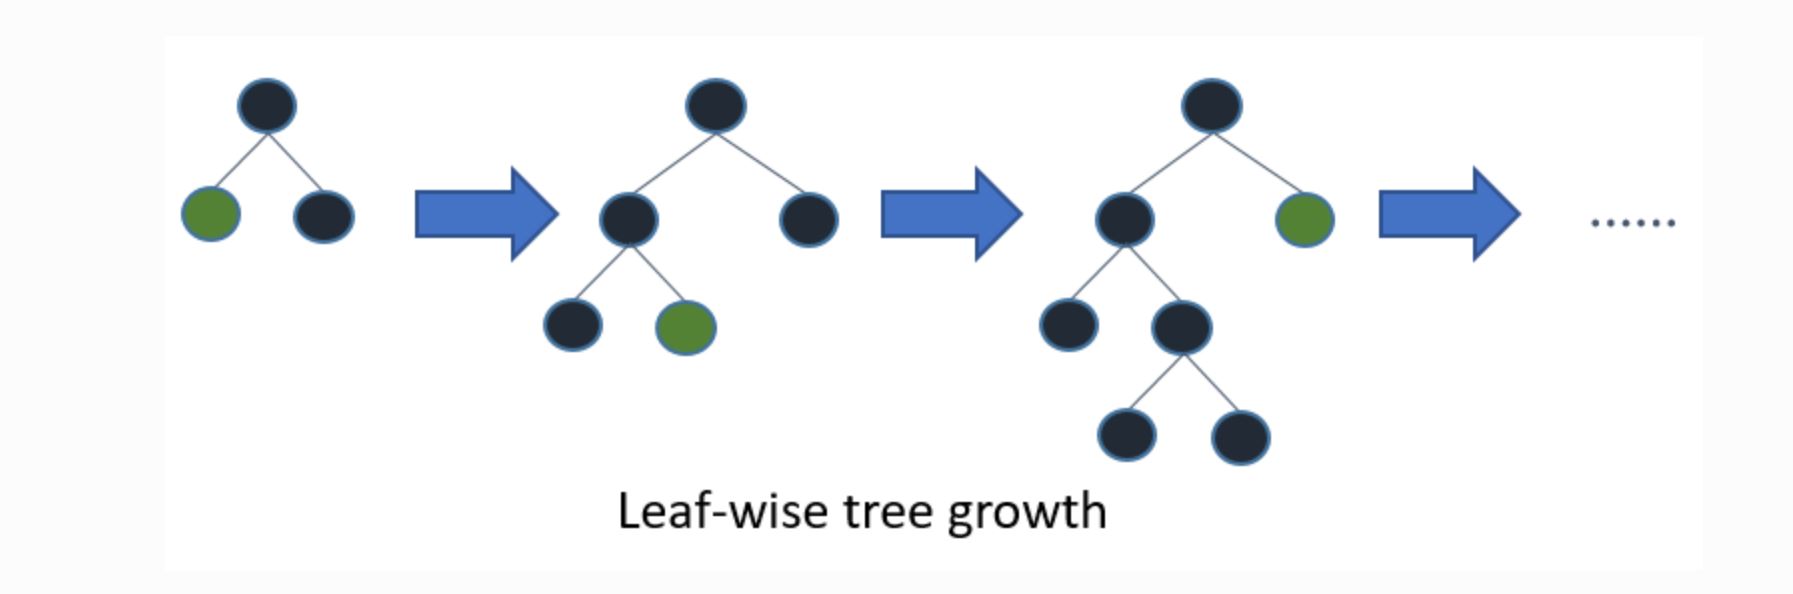
(引用元:Light GBM公式リファレンス)
これにより、ムダな学習をしなくても済むためより効率的に学習を進めることができます。
計算負荷がXgboostと全然違うので、時間の限られたコンペではLightGBMが好んで使われます。
LightGBMに関しては以下の記事で詳しくまとめています。
 【図解で解説】LightGBMの仕組みとPythonでの実装を見ていこう!当サイト【スタビジ】の本記事では、最強の機械学習手法「LightGBM」についてまとめていきます。LightGBM の特徴とPythonにおける回帰タスクと分類タスクの実装をしていきます。LightGBMは決定木と勾配ブースティングを組み合わせた手法で、Xgboostよりも計算負荷が軽い手法であり非常によく使われています。
Catboost
さらにLight GBMよりも後に発表されたのが、Catboost。
「Category Boosting」の略であり2017年にYandex社から発表された機械学習ライブラリです。
アルゴリズムの特徴は以下。
実際、他の勾配ブースティング手法との違いは微妙なところ。
後ほど精度比較していきますよー!
Catboostに関しては以下の記事でまとめています!
 Catboostとは?XgboostやLightGBMとの違いとPythonでの使い方を見ていこうー!!当サイト【スタビジ】の本記事では、XgboostやLightGBMに代わる新たな勾配ブースティング手法「Catboost」について徹底的に解説していき最終的にPythonにてMnistの分類モデルを構築していきます。LightGBMやディープラーニングとの精度差はいかに!?
教師なし学習
教師あり学習では、正解データが存在しましたが、教師なし学習では正解データは存在しません。
現在存在するデータから何か特徴を導き出す時・セグメントを行う時などに使われます。
教師なし学習の手法にはクラスター分析や主成分分析などが存在します。
先ほど機械学習と統計学の違いをお伝えした通り、統計学は現在のデータの解釈に使われることが多いです。
そのため、教師なし学習のクラスター分析や主成分分析は統計学的アプローチの文脈で使われることが多いです。
階層的クラスター分析

階層クラスター分析では木構造のような図を作ってクラスター分けを行います。
ある類似度を表す指標をもとにサンプルを融合していき、最終的に一つのクラスターを作るアルゴリズムを用います。
階層的クラスター分析に関しては以下の記事で詳しくまとめています!
 【5分で分かる】クラスター分析のPythonとRでの実装方法を見ていこう!当サイト【スタビジ】の本記事では、クラスター分析についてまとめていきます。クラスター分析は教師なし学習の定番手法で、データの構造や傾向を把握するのに非常に役立ちます。クラスター分析を利用してデータを可視化してみましょう!
k-means法
階層的クラスター分析は分かりやすく、結果が出た後に分類の様子からクラスタ数を決めることが可能です。
ただデータ量が多くなると計算に時間がかかるというデメリットがあります。
そこで登場するのが非階層的クラスター分析のk-means法。
どちらの手法も一長一短ですが、一般的にビジネスの場では膨大なデータを扱うことが多いため非階層的クラスター分析が良く用いられます。
先ほどから頻出のirisデータをk-means法で分類してみましょう!
以下がコードです。
data<-iris
data_train<-data[,-5]#5列目はラベルなので削除
km<-kmeans(data_train,3)
km$cluster
table(data[,5],km$cluster)#本物のラベルとグループ分けを比較3つの花のタイプに分かれているので、そのラベルがk-means法で上手く分類できるかどうか見ていきます。
実際におこなってみた結果がこちら
| 1 | 2 | 3 | |
| setosa | 0 | 50 | 0 |
| versicolor | 48 | 0 | 2 |
| virginica | 14 | 0 | 36 |
Verginicaは少し外してますが、それ以外は比較的当たってますね!
非常にシンプルなアルゴリズムで計算負荷も低くよく用いられます。
以下の記事でk-means法についてまとめています!
【5分でわかりやすく解説】k-means法とは?RとPythonで実装してみよう!当サイト【スタビジ】の本記事では、非階層クラスター分析のk-means法について徹底的に解説していきます。メリットとデメリットがあるので使う際は注意しましょう!x-means法という改良手法も合わせて一緒に見ていきますよー!
主成分分析

主成分分析は、1900年代前半にピアソンやホテリングにより導かれた手法であり長い歴史を持っています。
教師データ(正解データ)がいらない手法であり、手元にあるデータの次元を圧縮し構造化するのに優れています。
Pythonで主成分分析を実装していきましょう!
非常に簡単に実装することが可能です。
使用するデータは、統計科学研究所の「成績データ」。以下のURLからダウンロードできます。
https://statistics.co.jp/reference/statistical_data/statistical_data.htm
| kokugo | shakai | sugaku | rika | ongaku | bijutu | taiiku | gika | eigo |
| 30 | 43 | 51 | 63 | 60 | 66 | 37 | 44 | 20 |
| 39 | 21 | 49 | 56 | 70 | 72 | 56 | 63 | 16 |
| 29 | 30 | 23 | 57 | 69 | 76 | 33 | 54 | 6 |
| 95 | 87 | 77 | 100 | 77 | 82 | 78 | 96 | 87 |
| 70 | 71 | 78 | 67 | 72 | 82 | 46 | 63 | 44 |
| 67 | 53 | 56 | 61 | 61 | 76 | 70 | 66 | 40 |
| 29 | 26 | 44 | 52 | 37 | 68 | 33 | 43 | 13 |
9科目の点数が166人分入ってます。
import numpy as np
import pandas as pd
import sklearn
from sklearn.decomposition import PCA #主成分分析
import matplotlib.pyplot as plt
df=pd.read_csv('C:/Users/uenyu/Documents/Python Scripts/seiseki.csv')

# 主成分分析実行
pca = PCA()
feature = pca.fit(df)
# データを主成分空間に写像
feature = pca.transform(df)

#第2主成分まででプロット
plt.figure(figsize=(6, 6))
plt.scatter(feature[:, 0], feature[:, 1], alpha=0.8, c=list(df.iloc[:, 0]))
plt.grid()
plt.xlabel("PC1")
plt.ylabel("PC2")
plt.show()

#寄与率表示
pca.explained_variance_ratio_主成分分析自体は、scikit-learn内のライブラリを用います。
実際に第1主成分と第2主成分を軸にデータをプロットしてみるとこんな感じ
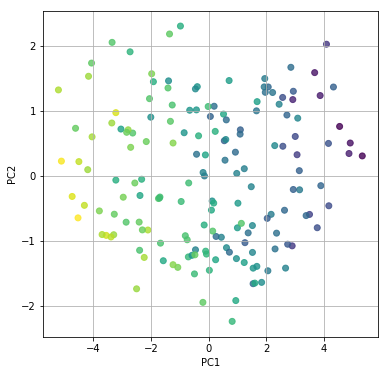
寄与率を見てみると以下のようになっており、ほぼ第2主成分までで80%を超えていることが分かります。
主成分分析については以下の記事でまとめています!
 主成分分析とは?簡単な説明とPythonでの実装!当サイト【スタビジ】の本記事では、実務の基礎分析にて使われることの多い主成分分析について詳しく見ていきます。最後にはカンタンなPythonでの実装も載せていますのでぜひ参考にしてみてください!
強化学習
強化学習は、昨今最も注目を集めている分野です。
教師あり学習と似ていますが、教師あり学習は全ての変数(特徴量)に対してフィードバックがありますが、強化学習は最終的な結果にのみフィードバックをします。
それを強化学習の世界では報酬と言いますが、報酬をたくさんもらえるように最適化すると最終的に精度の高いモデルが構築されるというイメージです。
まだまだビジネスの世界への適応例は少ない手法です。
強化学習については以下の記事にまとめています!
 強化学習を具体例と共にわかりやすく解説!Q学習をPythonで実装してみよう!当サイト【スタビジ】の本記事では、強化学習について具体例と共に解説していきます!また最終的に強化学習の中で最も一般的なアルゴリズムであるQ学習をPythonで実装していきます。迷路の最適経路を見つけるプログラムを作っていきますよ!
機械学習の各種アルゴリズム・手法をRで実装してみよう!
機械学習に対する理解がだいぶ深まったと思いますので、ここで簡易的な解析をしてみましょう!
機械学習手法を使うだけなら非常に簡単に実装できちゃうんですよー!教師あり学習を実装してみましょう!
先ほども登場した有名なタイタニックのデータを用います。Kaggleの公式サイトからデータをダウンロードできます。
まず、データのクレンジングを行い、欠損値は削除、不要と考えられる項目は削除しました。
【項目8つ】
Survived:生死 pclass:客室のクラス sex:性別 age:年齢 sibsp:兄弟・配偶者の数 parch:親・子供の数 fare:乗船料金 embarked:乗船した港
【サンプル数714】
この時、生死を目的変数としそれ以外を説明変数とします。
サンプル数714のうちランダムに400個のデータを取り出し学習データとし、残りの314を予測データとします。
学習データで予測モデルを作り、予測データにあてはめ真値と予測値の判別率を精度として比較します。
シミュレーション回数は10回とし上記の手順を10回繰り返し、結果を平均したものを最終アウトプットとします。
XGboost、ランダムフォレスト、サポートベクターマシン、ナイーブベイズ、ニューラルネットワーク、k近傍法の6手法で比較します!
基本的に引数は全部デフォルトで!果たして結果はどうなるでしょうか!
##様々な手法で予測精度の比較を行う##
##randomForest,SVM,ナイーブベイズ,ニューラルネット
library(xgboost)
library(caret)
library(Matrix)
library(kernlab)
library(randomForest)
library(e1071)
library(nnet)
library(ggplot2)
library(class)
titanic<-read.csv("タイタニック乗船者リスト.csv")##データの読み込み
titanic<-na.omit(titanic)##欠損値削除
titanic$Survived<-as.factor(titanic$Survived)##質的変数に変換
sim<-10##シミュレーション回数
result<-matrix(0,sim,6)##結果の箱
titanic[,4]<-as.numeric(titanic[,4])
titanic[,9]<-as.numeric(titanic[,9])

for(i in 1:sim){
  ####学習データとテストデータに分ける####
  train.id<-sample(nrow(titanic),400)
  train.data<-titanic[train.id,-1]
  test.data<-titanic[-train.id,-1]


  ##randomForest##
  rf<-randomForest(Survived~.,train.data)
  test.data.rf<-cbind(test.data,"predict"=predict(rf,test.data))
  result[i,1]<-sum(test.data.rf$predict==test.data.rf$Survived)/nrow(test.data.rf)


  ##SVM##
  svm<-ksvm(Survived~.,train.data)
  test.data.svm<-cbind(test.data,"predict"=predict(svm,test.data))
  result[i,2]<-sum(test.data.svm$predict==test.data.svm$Survived)/nrow(test.data.svm)

  ##ナイーブベイズ##
  nb<-naiveBayes(Survived~.,train.data)
  test.data.nb<-cbind(test.data,"predict"=predict(nb,test.data))
  result[i,3]<-sum(test.data.nb$predict==test.data.nb$Survived)/nrow(test.data.nb)

  ##ニューラルネット##
  nn<-nnet(Survived~.,train.data,size=5)
  test.data.nn<-cbind(test.data,"predict"=round(predict(nn,test.data),0))
  result[i,4]<-sum(test.data.nn$predict==test.data.nn$Survived)/nrow(test.data.nn)

  ##XGboost##
  label.data.train<-as.integer(train.data$Survived)-1##目的変数を01に
  label.data.predict<-as.integer(test.data$Survived)-1

  train.data.xg<-train.data[,-1]##目的変数取り除く
  test.data.xg<-test.data[,-1]

  xgb.data<-xgb.DMatrix(data.matrix(train.data.xg),label=label.data.train)##Xgb型へ成型
  xgb.data.predict<-xgb.DMatrix(data.matrix(test.data.xg))

  param <- list(
    "objective" = "binary:logistic"
    ,"eta" = 0.01
    # ,"max_depth" = 10
    ,"min_child_weight" = 5
    # ,"subsample" = 1
    # ,"colsample_bytree" = 1
  )##パラメータ適当

  model <- xgboost(
    param=param
    ,data=xgb.data
    ,nrounds=1000
  )##実際の学習

  predict_xgb<-predict(model,xgb.data.predict)

  a<-c()
  m<-length(predict_xgb)#行数

  for(l in 1:m){
    if(predict_xgb[l]>0.5){a[l]<-1}
    else{a[l]<-0}
  }
  result[i,5]<-sum(a==label.data.predict)/length(a)

  #k-nn
  knn<-knn(train.data,test.data,train.data[,"Survived"] ,prob=T,k=3)
  test.data.knn<-cbind(test.data,"predict"=knn)
  result[i,6]<-sum(test.data.knn$predict==test.data.knn$Survived)/nrow(test.data.knn)

}

result.c<-apply(result,2,mean)##simの平均値
result.c<-t(as.matrix(result.c))
result.c<-rbind(result.c,result.c)
result.c<-round(result.c,3)
##グラフ描画
colnames(result.c) <- c("RF","SVM","Bayes","NN","xgb","knn")
df<-data.frame(method=colnames(result.c),result=colMeans(result.c))
gp<-ggplot(df,aes(x=method,y=result,fill=method))
gp<-gp+geom_bar(width=0.8,stat="identity")
gp<-gp+ylab("result")
gp<-gp+geom_text(label=colMeans(result.c),vjust=1)
plot(gp)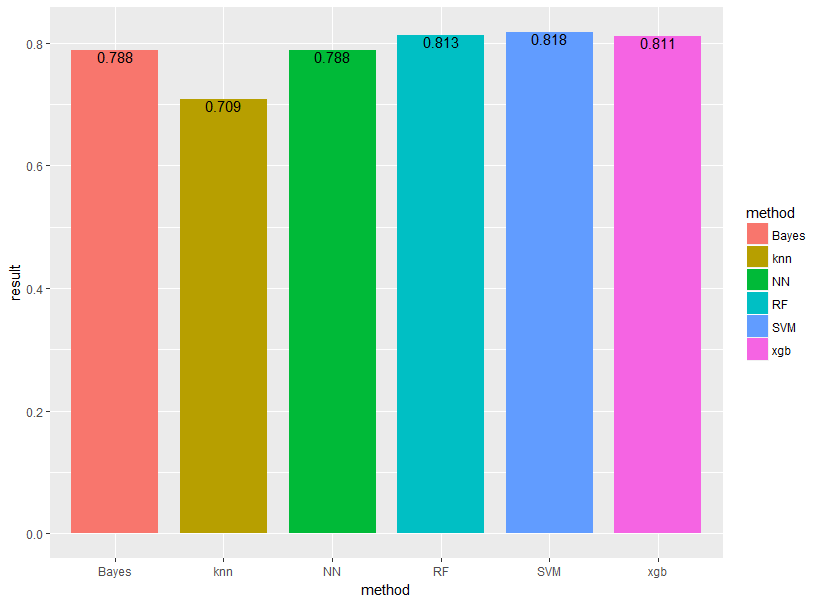
意外とランダムフォレストとSVMが強い!
シミュレーション10回なのでばらつき大きめですが、おおまかな精度の指標になるでしょう。
今回はパラメータをいじらずデフォルト設定で行ったためグリッドサーチなどでチューニングを行えば、もっと良い精度が出るでしょう。
ウマたん興味がある人は、他の機械学習手法も実装してみよう!
機械学習の各種アルゴリズム・手法をPythonで実装してみよう!
続いて、Pythonで機械学習手法を実装していきましょう!
回帰タスクと分類タスクに分けて見ていきます。
回帰タスクに対して機械学習手法を実装
まずは回帰タスクに対して機械学習手法を実装していきます。
データ分析コンペ DataDojoの「中古マンション価格予測チャレンジ」というコンペのデータに対してLightGBMを実装してみたいと思います。
国産データコンペのNishika(2026年3月にサービス終了)で開催されていたトレーニングコンペで、今はDataDojoで同じコンペに無料で参加できます。
Pythonであればいとも簡単に実装することができるんです!
まず DataDojoにGoogleアカウントでログインして、コンペの「データ」タブから学習データ(train.zip)とテストデータ(test.csv)をダウンロードしてください(※ログインしないとデータをダウンロードできません)。
得られたデータを結合しデータフレームを作成し、データクレンジングをおこなった上でLight gbm を実装していきます。
全コードは以下になります!
import glob
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_absolute_error as mae

files = glob.glob("train/*.csv")
data_list = []
for file in files:
    data_list.append(pd.read_csv(file, index_col=0))
df = pd.concat(data_list)

def data_pre(df):
    nonnull_list = []
    for col in df.columns:
        nonnull = df[col].count()
        if nonnull == 0:
            nonnull_list.append(col)
    df = df.drop(nonnull_list, axis=1)

    df = df.drop("市区町村名", axis=1)

    df = df.drop("種類", axis=1)

    dis = {
        "30分?60分":45,
        "1H?1H30":75,
        "2H?":120,
        "1H30?2H":105
    }
    df["最寄駅:距離(分)"] = df["最寄駅:距離(分)"].replace(dis).astype(float)

    df["面積(㎡)"] = df["面積(㎡)"].replace("2000㎡以上", 2000).astype(float)


    y_list = {}
    for i in df["建築年"].value_counts().keys():
        if "平成" in i:
            num = float(i.split("平成")[1].split("年")[0])
            year = 33 - num
        if "令和" in i:
            num = float(i.split("令和")[1].split("年")[0])
            year = 3 - num
        if "昭和" in i:
            num = float(i.split("昭和")[1].split("年")[0])
            year = 96 - num
        y_list[i] = year
    y_list["戦前"] = 76
    df["建築年"] = df["建築年"].replace(y_list).astype(float)

    year = {
        "年第1四半期": ".25",
        "年第2四半期": ".50",
        "年第3四半期": ".75",
        "年第4四半期": ".99"
    }
    year_list = {}
    for i in df["取引時点"].value_counts().keys():
        for k, j in year.items():
            if k in i:
                year_rep = i.replace(k, j)
        year_list[i] = year_rep
    df["取引時点"] = df["取引時点"].replace(year_list).astype(float)

    for col in ["都道府県名", "地区名", "最寄駅:名称", "間取り", "建物の構造", "用途", "今後の利用目的", "都市計画", "改装", "取引の事情等"]:
                df[col] = df[col].astype("category")

    return df

df = data_pre(df)

df_train, df_val =train_test_split(df, test_size=0.2)

col = "取引価格(総額)_log"
train_y = df_train[col]
train_x = df_train.drop(col, axis=1)

val_y = df_val[col]
val_x = df_val.drop(col, axis=1)

trains = lgb.Dataset(train_x, train_y)
valids = lgb.Dataset(val_x, val_y)

params = {
    "objective": "regression",
    "metrics": "mae"
}

model = lgb.train(params, trains, valid_sets=valids, num_boost_round=1000, callbacks=[lgb.early_stopping(100)])

df_test = pd.read_csv("test.csv", index_col=0)
df_test = data_pre(df_test)

predict = model.predict(df_test)
df_test["取引価格(総額)_log"] = predict
df_test[["取引価格(総額)_log"]].to_csv("submit_test.csv")
LightGBM 4.0からearly_stopping_roundsの引数はなくなったので、callbacksでlgb.early_stopping(100)を渡しています。
ここでは評価指標にMAE(平均絶対誤差)を使っていて、バリデーションの推定精度は
0.0764となりました!
テストデータをサブミットすることでコンペにスコアを提出することももちろん可能です。
df_test = pd.read_csv("test.csv", index_col=0)
df_test = data_pre(df_test)

predict = model.predict(df_test)
df_test["取引価格(総額)_log"] = predict
df_test[["取引価格(総額)_log"]].to_csv("submit_test.csv")作成したsubmit_test.csvをコンペの「提出」タブからアップロードすると、自動で採点されてリーダーボードに順位が出ます(DataDojoのこのコンペの評価指標はRMSE(二乗平均平方根誤差)で、提出は1日5回までです)。
以下の記事でより詳しく解説していますので是非チェックしてみてください!
【図解で解説】LightGBMの仕組みとPythonでの実装を見ていこう!当サイト【スタビジ】の本記事では、最強の機械学習手法「LightGBM」についてまとめていきます。LightGBM の特徴とPythonにおける回帰タスクと分類タスクの実装をしていきます。LightGBMは決定木と勾配ブースティングを組み合わせた手法で、Xgboostよりも計算負荷が軽い手法であり非常によく使われています。
また、機械学習による需要予測の解説と実際のPythonでの実装を以下の記事で行っていますのでそちらもぜひチェックしてみてください!
 AIモデルによる需要予測の事例と手法を紹介!Pythonで実装してみよう!当サイト【スタビジ】の本記事では、AIモデルによって顧客の需要を予測する手法とその事例について紹介します!また、Pythonで簡単な実装も行っていきましょう!
分類タスクに対して機械学習手法を実装
先程は価格の予想ということで、回帰タスクでしたが続いては分類タスクに対して機械学習手法を実装していきたいと思います。
使う手法は先程も使った人気の勾配ブースティング手法「Xgboost」「LightGBM」「Catboost」
使用するデータセットは画像識別のベンチマークによく使用されるMnistというデータです。
Mnistは以下のような特徴を持っています。
ディープラーニングのパフォーマンスをカンタンに測るのによく利用されますね。
それぞれの手法のコードをざっと並べて見ていきましょう!
import xgboost as xgb
import pandas as pd
import numpy as np
from tensorflow.keras.datasets import mnist
from sklearn.model_selection import train_test_split

# Kerasに付属の手書き数字画像データをダウンロード
np.random.seed(0)
(X_train_base, labels_train_base), (X_test, labels_test) = mnist.load_data()

# Training set を学習データ(X_train, labels_train)と検証データ(X_validation, labels_validation)に8:2で分割する
X_train,X_validation,labels_train,labels_validation = train_test_split(X_train_base,labels_train_base,test_size = 0.2)

# 各画像は行列なので1次元に変換→X_train,X_validation,X_testを上書き
X_train = X_train.reshape(-1,784)
X_validation = X_validation.reshape(-1,784)
X_test = X_test.reshape(-1,784)

#正規化
X_train = X_train.astype('float32')
X_validation = X_validation.astype('float32')
X_test = X_test.astype('float32')
X_train /= 255
X_validation /= 255
X_test /= 255

# 訓練・テストデータの設定
train_data = xgb.DMatrix(X_train, label=labels_train)
eval_data = xgb.DMatrix(X_validation, label=labels_validation)
X_data = xgb.DMatrix(X_test, label=labels_test)

#経過時間計測
import time
start = time.time()

xgb_params = {
    # 多値分類問題
    'objective':'multi:softmax',
    # クラス数
    'num_class': 10,
    # 学習用の指標 (Multiclass logloss)
    'eval_metric': 'mlogloss',
    }
evals = [(train_data, 'train'), (eval_data, 'eval')]

gbm = xgb.train(
    xgb_params,
    train_data,
    num_boost_round=100,
    early_stopping_rounds=10,
    evals=evals,
    )

preds = gbm.predict(X_data)
from sklearn.metrics import accuracy_score
print('accuracy_score:{}'.format(accuracy_score(labels_test, preds)))

#経過時間
print('elapsed_timetime:{}'.format(time.time()-start))
import lightgbm as lgb
import pandas as pd
import numpy as np
from tensorflow.keras.datasets import mnist
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# Kerasに付属の手書き数字画像データをダウンロード
np.random.seed(0)
(X_train, labels_train), (X_test, labels_test) = mnist.load_data()

# 各画像は行列なので1次元に変換→X_train,X_validation,X_testを上書き
X_train = X_train.reshape(-1,784)
X_test = X_test.reshape(-1,784)

#正規化
X_train = X_train.astype('float32')
X_test = X_test.astype('float32')
X_train /= 255
X_test /= 255

# 訓練・テストデータの設定
train_data = lgb.Dataset(X_train, label=labels_train)
eval_data = lgb.Dataset(X_test, label=labels_test, reference= train_data)

params = {
'task': 'train',
'boosting_type': 'gbdt',
'objective': 'multiclass',
'num_class': 10,
'verbose': 5,
}

gbm = lgb.train(
    params,
    train_data,
    valid_sets=eval_data,
    num_boost_round=50,
)

preds = gbm.predict(X_test)
preds
y_pred = []
for x in preds:
  y_pred.append(np.argmax(x))

accuracy_score(labels_test, y_pred)
import pandas as pd
import numpy as np
from tensorflow.keras.datasets import mnist
from sklearn.model_selection import train_test_split
# Kerasに付属の手書き数字画像データをダウンロード
np.random.seed(0)
(X_train_base, labels_train_base), (X_test, labels_test) = mnist.load_data()
# Training set を学習データ(X_train, labels_train)と検証データ(X_validation, labels_validation)に8:2で分割する
X_train,X_validation,labels_train,labels_validation = train_test_split(X_train_base,labels_train_base,test_size = 0.2)
# 各画像は行列なので1次元に変換→X_train,X_validation,X_testを上書き
X_train = X_train.reshape(-1,784)
X_validation = X_validation.reshape(-1,784)
X_test = X_test.reshape(-1,784)
#正規化
X_train = X_train.astype('float32')
X_validation = X_validation.astype('float32')
X_test = X_test.astype('float32')
X_train /= 255
X_validation /= 255
X_test /= 255
# 訓練・テストデータの設定
from catboost import Pool
train_pool = Pool(X_train, labels_train)
validate_pool = Pool(X_validation, labels_validation)
#経過時間計測
import time
start = time.time()
from catboost import CatBoostClassifier
params = {
'early_stopping_rounds' : 10,
'iterations' : 100,
'custom_loss' :['Accuracy'],
'random_seed' :42
}
# パラメータを指定した場合は、以下のようにインスタンスに適用させる
model = CatBoostClassifier(**params)
cab = model.fit(train_pool, eval_set=validate_pool)
preds = cab.predict(X_test)
from sklearn.metrics import accuracy_score
print('accuracy_score:{}'.format(accuracy_score(labels_test, preds)))
#経過時間
print('elapsed_timetime:{}'.format(time.time()-start))
結果は以下のようになりました!
精度はXgboostが最もよくLightGBMが最も処理が早いという結果になりましたー!
以下の記事で各手法の実装に関しては詳しく解説していますのでぜひチェックしてみてください!
 勾配ブースティング決定木の手法をPythonで実装して比較していく!当サイト【スタビジ】の本記事では、勾配ブースティングの各手法をPythonで実装して徹底比較していきます!勾配ブースティングの代表手法「Xgboost」「Light gbm」「Catboost」で果たしてどのような違いがあるのでしょうか?
ちなみに2020年にリリースされた機械学習のライブラリ「PyCaret」を使えば多くの機械学習手法を簡単に比較することが出来るので簡易的に実装したい場合をPyCaretを使ってみてください。
機械学習を勉強するのにおすすめなサービス・本
非常に幅広く、様々な手法が混在する機械学習手法について見てきましたがこれらを学習するのにおすすめなサービスや書籍を紹介していきます!
Udemy
公式サイト:https://www.udemy.com/
なかなか初心者向けの書籍がないので最初はUdemyというオンライン学習プラットフォームで学習を進めることをオススメします!
Udemyは世界最大の教育プラットフォームです。
 【体験談】評判の良いUdemyを30コース以上受けている僕が徹底レビュー!当サイト【スタビジ】の本記事では、世界最大のオンライン学習プラットフォームであるUdemyのメリット・デメリット・評判・口コミについてまとめていきます!実際にプログラミングやデータサイエンス、Webマーケ関連のコースを30個以上受講している体験談をもとにお伝えしていきます。
Udemyにはいくつかの講座がありますが、機械学習が広く学べてデータ分析の実践まで行える講座としては以下の僕の講座がオススメです!
【初学者向け】データ分析コンペで楽しみながら学べるPython×データ分析講座
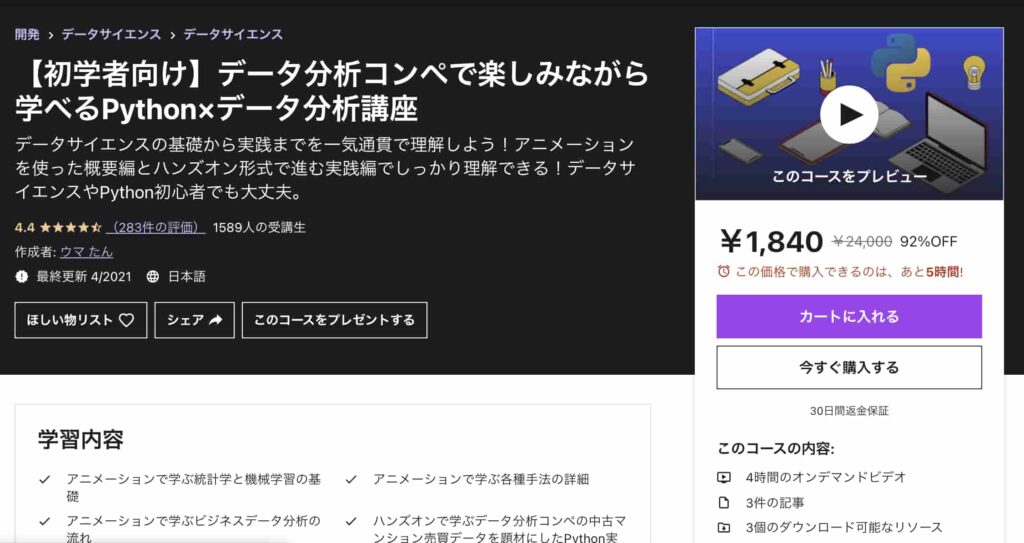
僕自身がUdemyの色んなコースを受けてみた中で、他のコースにはないこんなコースあったらいいなみたいなコースを作ってみました。
このコースは、なかなか勉強する時間がないという方に向けてコンパクトに分かりやすく必要最低限の時間で重要なエッセンスを学び取れるように作成しています。
アニメーションを使った概要編とハンズオン形式で進む実践編に分かれており、概要編では体系的にデータ分析・機械学習導入の文脈でまとめています。
プログラミングスクール
プログラミングスクールは高額でなかなか手が届かないという人も多いですが、使い方によっては非常にコスパのよいサービスです。
僕自身通った経験のあるプログラミングスクールでオススメなのはテックアカデミー!
現役エンジニアのパーソナルメンターがつくので分からないところも解消しやすく書籍などで進めるよりは圧倒的に進みが早いです。
価格は3か月で284,900円!
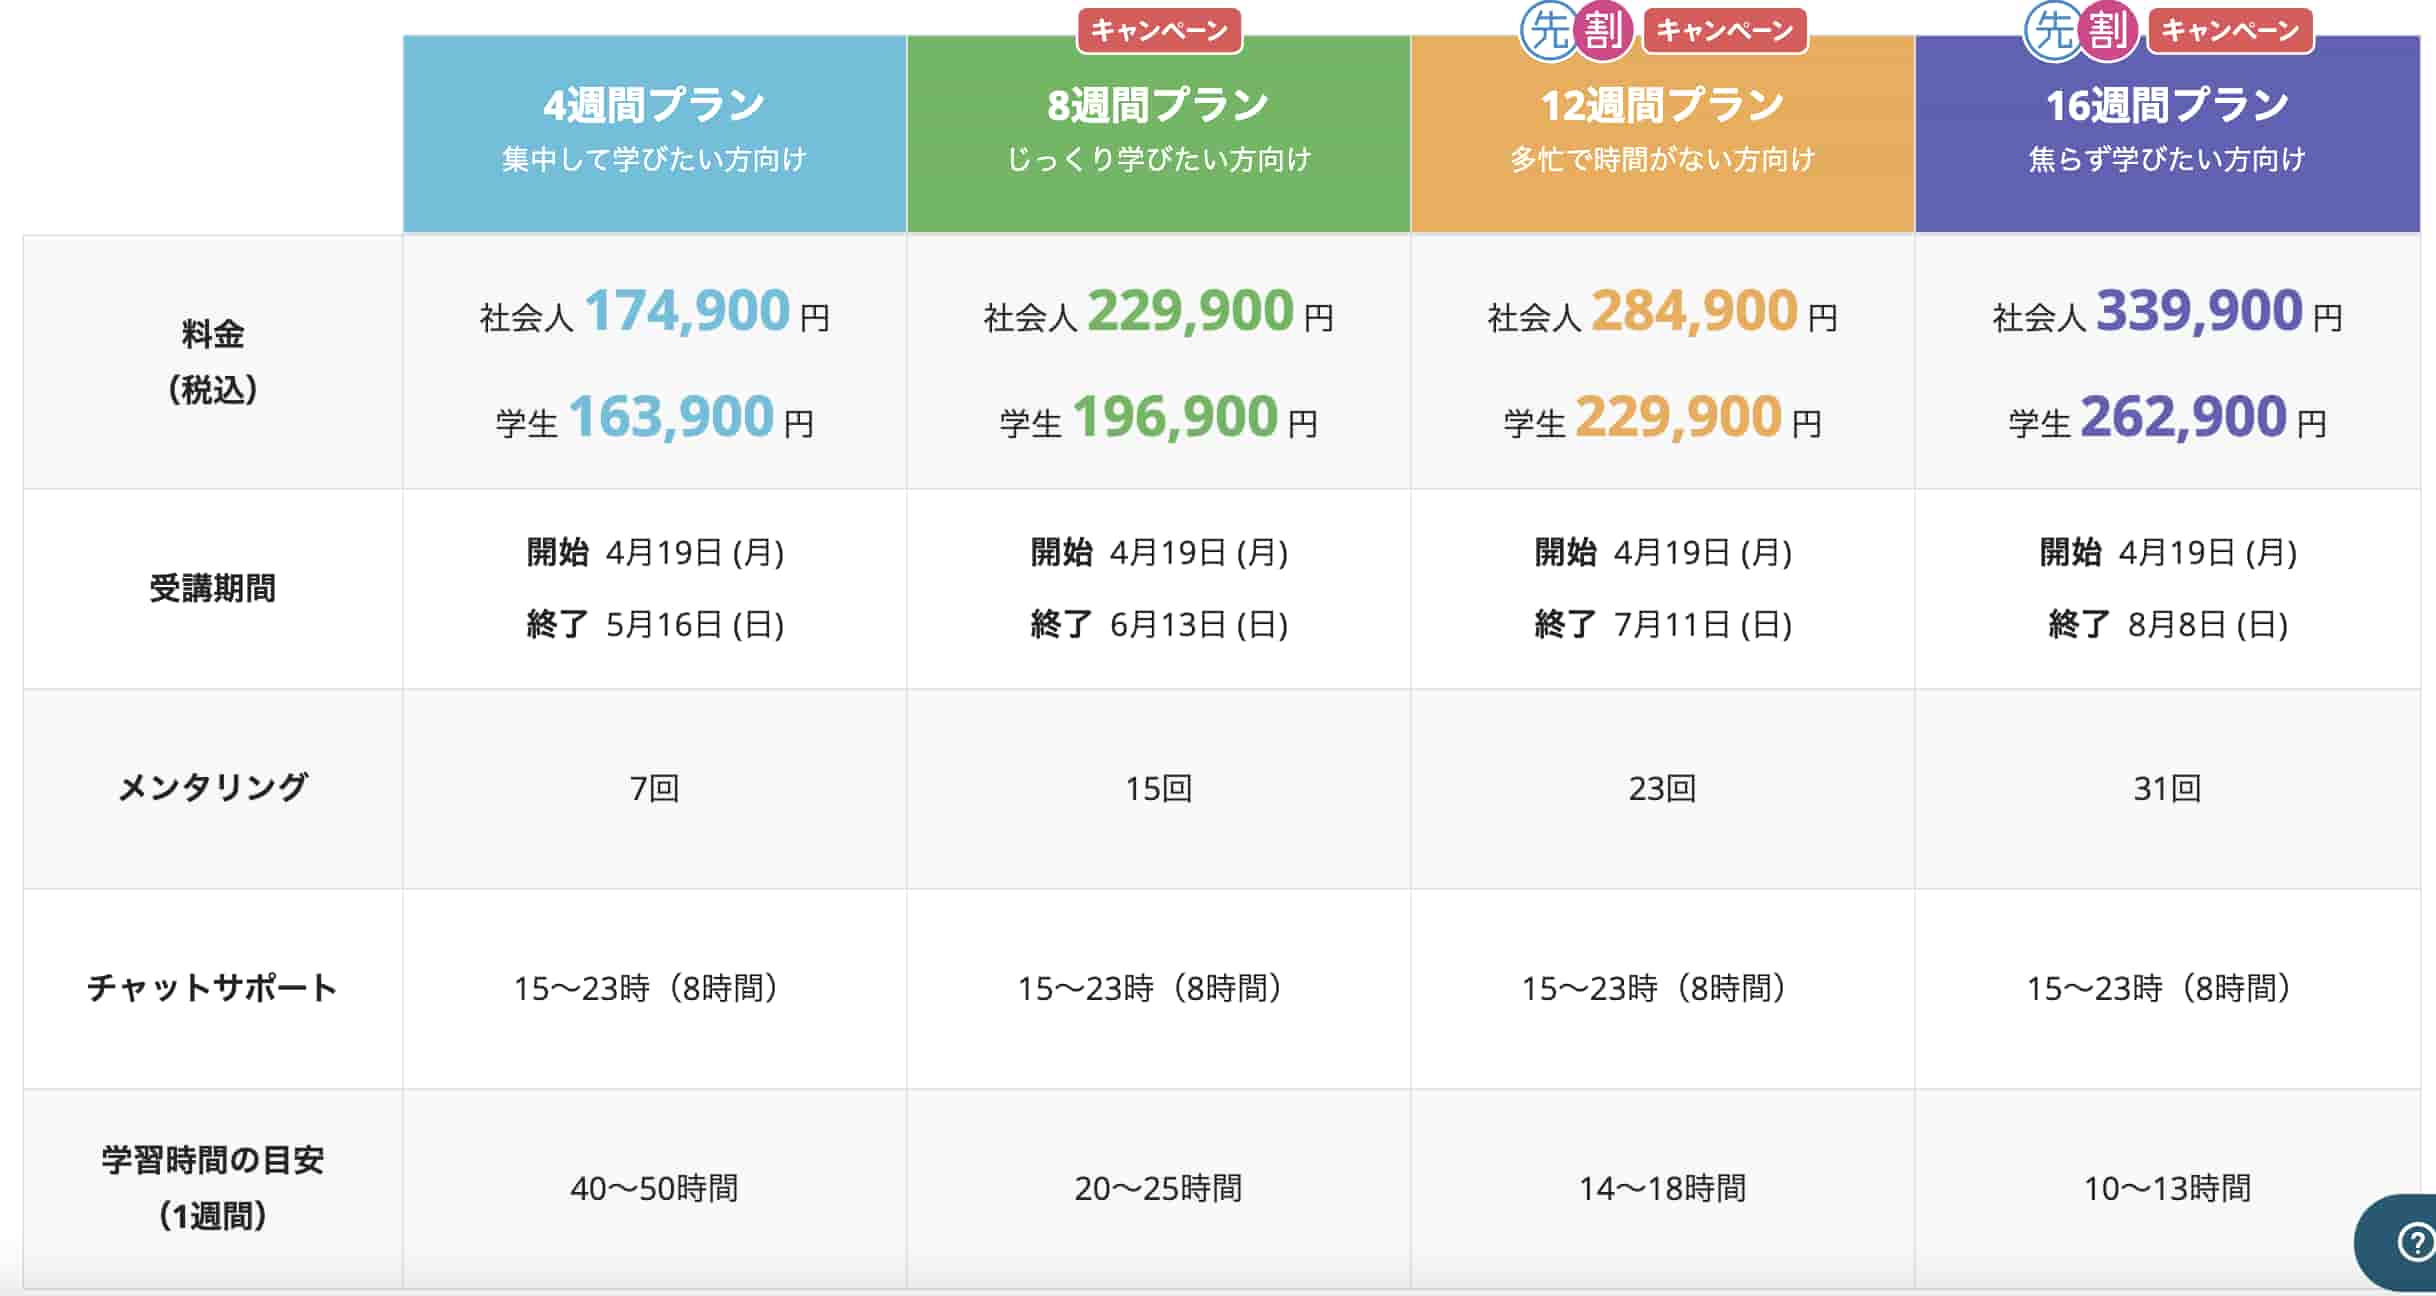
価格は少々かかりますが、その文お尻に火が付きます。
メンターのレベルは非常に高いので自分のやる気さえあれば教材の範囲を超えた内容をガツガツ学ぶことが可能!
僕自身3か月のコースを1か月で終わらせて、応用をガツガツ学んでました。
 【体験談】テックアカデミー評判は?3か月本気受講してみたので徹底レビュー!当ブログ【スタビジ】では、様々なプログラミングスクールの中からテックアカデミーのメリット・デメリット・評判について3か月の体験談をもとに赤裸々にレビューしていきます。
ただテックアカデミーはそれなりに高い・・・ということで・・・
作っちゃいました!業界最安級AIデータサイエンス特化のスクール「スタアカ(スタビジアカデミー)」
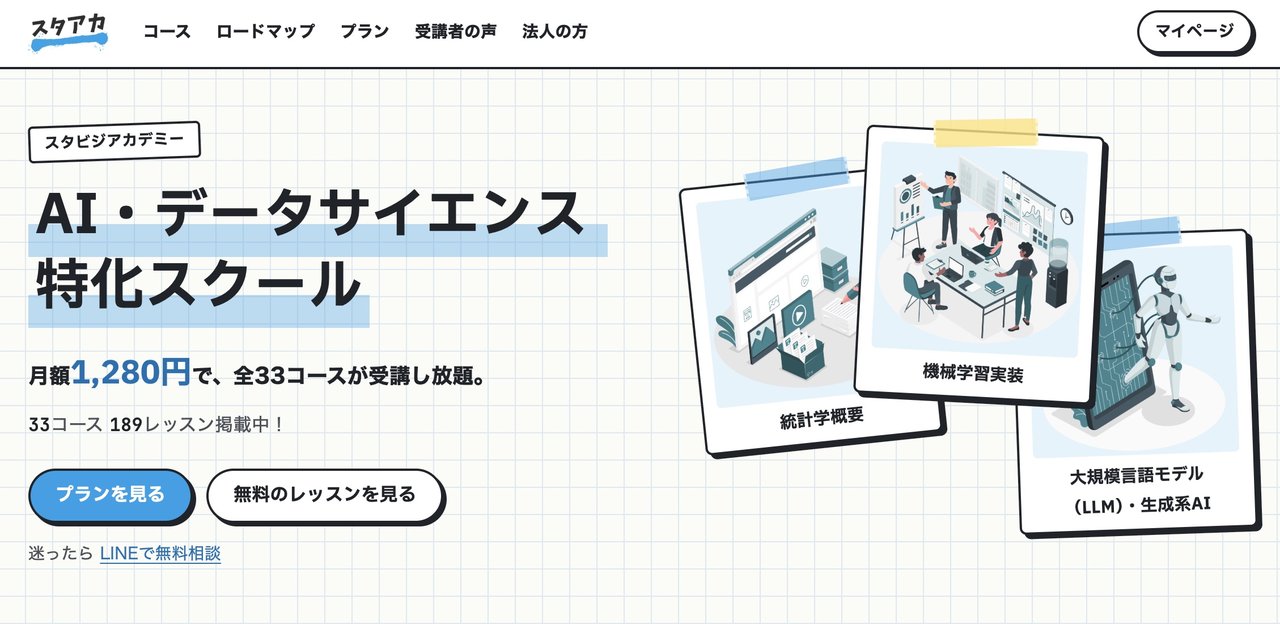
公式サイト:https://toukei-lab.com/achademy/
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
データサイエンティストとしての自分の経験をふまえてエッセンスを詰め込んだのがこちらのスタビジアカデミー、略して「スタアカ」!!
当メディアが運営するスクールです。
月額1,280円のライトプランで、統計学から機械学習・生成AIまで全コースが受講し放題です!
プレミアムプランでは、24時間以内の質問対応と現役データサイエンティストとの1on1(30分×4回)を実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
他のスクールのカリキュラムはPythonでの機械学習実装だけに焦点が当たっているものが多く、実務に即した内容になっていないものが多いです。
そんな課題感に対して、実務で使うことの多いSQLや機械学習のビジネス導入プロセスの理解なども合わせて学べるボリューム満点のコースになっています!
ウォルマートのデータを使って商品の予測分析をしたり、実務で使うことの多いGoogleプロダクトのBigQueryを使って投球分析をしたり、データサイエンティストに必要なビジネス・マーケティングの基礎を学んでマーケティングプランを作ってもらったりする盛りだくさんの内容になってます!
機械学習やデータサイエンスを学べるスクールは他にもたくさんあります。
以下の記事でまとめていますのでこちらも合わせてチェックしてみてください!
 【徹底比較】データサイエンティストになるための学習ができるスクール9選!当サイト【スタビジ】の本記事では、データサイエンティストへの学習ができるスクールを紹介していきます。スクールに通ったからと言ってデータサイエンティストになれるわけではありませんが、データサイエンティストへの基本を着実に固めることは可能です…
データ分析コンペサービス
データ分析コンペは自分の実力を試す場としては非常に効果的です。
他の人の回答なども見ることができるので勉強にもなりますし、入賞するとお金がもらえるケースも多いのでモチベーションにもなります。
ある程度勉強したらDataDojoやSignateなどのデータ分析コンペで実践を積むことをオススメします。
Signateには初心者向けの「練習問題」があり、Kaggleのコンペよりも取り組みやすいので腕試しをするのにちょうど良いです。
今回取り上げたテーブルデータ以外にも以下のような画像データやテキストデータの練習問題があります。
以下の記事でデータ分析コンペの比較していますので是非チェックしてみてください!
 【徹底比較】【Python】データ分析コンペそれぞれの特徴とトレーニング実装当サイト【スタビジ】の本記事では、データ分析コンペそれぞれの特徴について徹底的に見ていきます。実はデータ分析コンペのサービスはKaggleだけではなく、いくつかの種類があるので是非色んなコンペに参加してみてください!トレーニングコンペの実装とデータ分析コンペに臨む上での勉強法についてもまとめていきますよー!
書籍:データ解析のための統計モデリング入門

データ解析のための統計モデリング入門は、統計学の基本的な線形モデルから徐々に拡張していってベイズモデリングまで領域を広げていきます。
統計学や機械学習領域について広く学んだ後に読むと理解が深まると思うのでぜひ呼んでみてください!
書籍:これなら分かる最適化数学

こちらの書籍は機械学習のアルゴリズムに対しての理解をもっと深めたい!理論をもう少し踏み込んで学びたい!という方におすすめな書籍です。
結構難解な内容もありますが、しっかり読めば機械学習理論の力がしっかり付くこと間違いなし!
書籍:Kaggleで勝つデータ分析の技術

機械学習を使った実践について学びたいのであればこちら!
「Kaggleで勝つデータ分析の技術」
先ほども軽く登場したKaggleというデータ分析コンペの猛者が著者で書かれている実践的なデータ分析のための書籍です。
機械学習のアルゴリズムや手法の内容よりも、どのようにデータを調理してデータ分析に活かせばよいかという話がしっかり載っている最強の書籍です!
機械学習のおすすめ本については以下の記事でも詳しくまとめていますので是非チェックしてみてください!
 厳選14冊!機械学習を勉強する上でおすすめな本!当サイト【スタビジ】の本記事では、機械学習を勉強するのにオススメな書籍を紹介していきます。機械学習は大量のデータから予測を行うことを得意とする手法群。しっかり機械学習手法の理論から学んでいくことが大事!
機械学習の勉強法については以下の記事でまとめていますので是非チェックしてみてください!
 【5分で分かる】機械学習の独学勉強ロードマップを徹底的にまとめていく!当サイト【スタビジ】の本記事では、機械学習の独学勉強ロードマップについて徹底的にまとめていきます。機械学習をいきなり理論からしっかり勉強しようとすると挫折しかねません。そこで、この記事ではなるべく挫折しないロードマップをお伝えしてきますよ!
機械学習のアルゴリズムと手法 まとめ
本記事では機械学習についてみてきましたー!
機械学習は、非常に簡単に実装できます。
ただその分、機械学習が実装できるだけでは意味がありません。
どのようなデータを機械に与えて、得られた結果をどのように解釈するか。それが最も大事な部分になります。
得られた結果をどのようにビジネスに落とし込むか・ビジネスインパクトを出すか。ここがデジタルマーケター・データサイエンティストの腕の見せ所ですね!
ウマたん機械学習はあくまで手段だ!目的を見失わないようにしよう!
機械学習と同時にPythonを学んだり、統計学を学んだり、ディープラーニングを学んだりしていきましょう!
ぜひ好きな方向に進んでくださいねー!
 【Python独学勉強法】Python入門を3ヶ月で習得できる学習ロードマップ当サイト【スタビジ】の本記事では、過去僕自身がPythonを独学を駆使しながら習得した経験をもとにPythonを効率よく勉強する方法を具体的なコード付き実装例と合わせてまとめていきます。Pythonはできることが幅広いので自分のやりたいことを明確にして勉強法を選ぶことが大事です。
 統計学とは?当サイト【スタビジ】の本記事では、統計学について徹底的にまとめていきます。統計学の歴史・統計学で使われる手法・統計学に必要なプログラミング言語などを詳しく紹介していきますよー!この機会に統計学をしっかり理解しておきましょう!
 【初心者向けKaggle入門】Kaggleの勉強法とサブミットの前準備!当サイト【スタビジ】の本記事では、Kaggleについて解説していきKaggleに挑戦するまでにどのようなことを勉強しておいたらよいのか丁寧に解説していきます。ある程度データサイエンスの土台が出来た後はKaggleに挑戦し、世界各国の猛者と凌ぎを削りましょう!
 【初心者向け】ディープラーニングの勉強ロードマップまとめ!当サイト【スタビジ】本記事では、ディープラーニングの学習方法について詳しくまとめていきます!ディープラーニングは難しいと思われがちですが、アルゴリズムは意外とシンプルで実装自体も非常に簡単なんです!Pythonでの実装もおこなっていきますよー!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「機械学習概要」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。
