【5分でわかりやすく解説】k近傍法とは?理論とRでの実装方法!
目次
 ウマたん
本記事では、アルゴリズムがシンプルで分かりやすいk近傍法について理解を深めていきます。最終的にはRでの実装を行うことで理論と実装の両輪を理解していきましょう!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
アルゴリズムが分かりやすくて使いやすい手法であるk近傍法!
 ロボたん
強力な手法とは言えないけど、感覚的に分かりやすくていいよねー!
ウマたんそうそう!説明もしやすいしね!
この記事ではそんなk近傍法というクラス判別の手法をご説明します!
アルゴリズムも非常に分かりやすく使いやすいk近傍法についてみていきましょう!
最後にはRでの実装方法も見ていきますよー!
ウマたんk近傍法は使いやすい機械学習手法!
他の手法についてはこちらも合わせてご参照ください!
 パターン認識の事例やAIや機械学習との関連性をわかりやすく解説!当サイト【スタビジ】の本記事では、パターン認識とは何なのかについて具体的な事例や手法、さらにはPythonでの実装方法を交えて分かりやすく解説していきます!
 【これだけはおさえておきたい!】ビジネスで役立つAI用語45選まとめ!当サイト【スタビジ】の本記事では、ディープラーニング系/機械学習系/統計学系の3つのカテゴリに分けて重要な用語を説明していきます!
k近傍法とは
それではk近傍法の解説からはじめましょう!
以下の動画でも解説しているのでぜひチェックしてみてください!

k近傍法とはデータを分類する時に活躍する手法です。
ある未知データが与えられたとき、周りの学習データのクラスからその未知データの分類を決定するもの。
そしてkとは手法に与えるパラメーターで、近くに存在する学習データのクラス数を示しています。
たとえば、このような状況では、
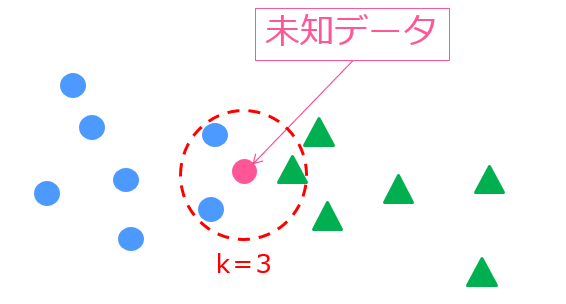
k=3なので未知データの周りの3つのデータを判断材料とします。
実際に見てみると、青〇のクラスが2つ、緑△のクラスが1つなので、未知データは青〇と判断されます。
続いてこのkを5にするとどうなるでしょう?
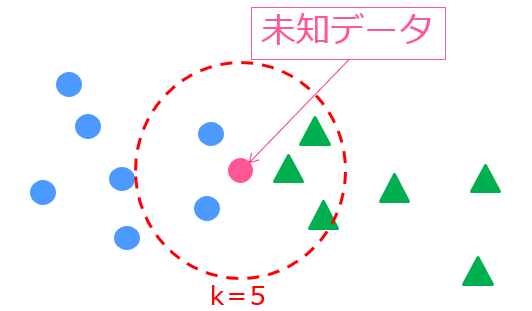
k=5なので周りの5個を判断材料とします。
実際に見てみると、青〇のクラスが2つ、緑△のクラスが3つなので、未知データは緑△と判断されます。
kの値を変えることで分類されるクラスが変わりましたね!
今回挙げた例は非常に分類が難しい例であり、このような場合はそれほど多くありませんがkの値によって分類されるクラスが変わる可能性はあるよ!というお話でした。
ちなみにRで解析する時はclassパッケージのknnという関数を使うと良いでしょう!
この時デフォルトではk=1になっています。すなわちこれは、近くの1つしか判断材料に入れないということ。
これは最近傍法というk近傍法の特殊な例になってしまい局所最適に陥りやすいです。
あまりにも大きすぎるkの値は不均衡データに対して上手く分類できなくなってしまう可能性もありますが、ある程度大きい値にした方が良いでしょう!
個人的には5が推奨です。解析の時は大抵5を選択していました。
実はこのk近傍法の考え方を不均衡データに応用したSMOTEという方法があります。
 不均衡データの対策方法と評価指標!SmoteをPythonで実装して検証していく!当サイト【スタビジ】の本記事では、実データによくありがちな不均衡データの特徴とどのように分析していったら良いかについてまとめてみました!最終的にSMOTEというオーバーサンプリング手法を使ってPythonで解析していきます!
k近傍法の識別規則
それでは、具体的にk近傍法の識別規則について数式で見ていきましょう!
\begin{eqnarray}
\left\{
\begin{array}{l}
j&…&((k_j)=max(k_1,…,k_K)の時)\\
reject&…&((k_1,…,k_j)=max(k_1,…,k_K)の時)\\
\end{array}
\right.
\end{eqnarray}
非常に簡単な数式になりました!
この時は近傍kのうち、クラスiに属するデータ数を表しています。
近傍kの中でも最もクラスjに属するデータが多いときそのデータをjと識別します。
最もデータ数が多いクラスが多数存在する場合は識別不能となります。
k近傍法は非常に分かりやすいアルゴリズムなのでとっかかりやすいです!
Rのパッケージで一発で出来ちゃうんで使ってみましょう!
ちなみにk近傍法と名前の似ている手法にk-means法という機械学習手法があります。
名前は似ていても手法は全く違います!k-means法は教師なし学習でありクラスター分析の一種!
k-means法については以下の記事でまとめているのでよければご覧ください!
 【5分でわかりやすく解説】k-means法とは?RとPythonで実装してみよう!当サイト【スタビジ】の本記事では、非階層クラスター分析のk-means法について徹底的に解説していきます。メリットとデメリットがあるので使う際は注意しましょう!x-means法という改良手法も合わせて一緒に見ていきますよー!
k近傍法をRで実装!
k近傍法はRやPythonで簡単に実装することができます。実際にRを用いてk近傍法を実装してみましょう!
今回は、Kaggleの公式サイトで提供されているTitanicのデータを使います。
kaggleに関しては以下の記事で詳しく解説しているのであわせてチェックしてみてください。
 【初心者向けKaggle入門】Kaggleの勉強法とサブミットの前準備!当サイト【スタビジ】の本記事では、Kaggleについて解説していきKaggleに挑戦するまでにどのようなことを勉強しておいたらよいのか丁寧に解説していきます。ある程度データサイエンスの土台が出来た後はKaggleに挑戦し、世界各国の猛者と凌ぎを削りましょう!
データのクレンジングを行い、欠損値は削除、不要と考えられる項目は削除します。
生死(Survive)を目的変数としそれ以外を説明変数とします。
サンプル数714のうちランダムに400個のデータを取り出し学習データとし、残りの314を予測データとします。
学習データで予測モデルを作り、予測データにあてはめ真値と予測値の判別率を精度として比較します。
シミュレーション回数は10回とし、上記の手順を10回繰り返し、結果を平均したものを最終アウトプットとします。
k近傍法をXGboost、ランダムフォレスト、サポートベクターマシン、ナイーブベイズ、ニューラルネットワークの5手法と比較します!他の手法については他の記事をご覧ください。
##様々な手法で予測精度の比較を行う##
##randomForest,SVM,ナイーブベイズ,ニューラルネット
library(xgboost)
library(caret)
library(Matrix)
library(kernlab)
library(randomForest)
library(e1071)
library(nnet)
library(ggplot2)
library(class)
titanic<-read.csv("タイタニック乗船者リスト.csv")##データの読み込み
titanic<-na.omit(titanic)##欠損値削除
titanic$Survived<-as.factor(titanic$Survived)##質的変数に変換
sim<-10##シミュレーション回数
result<-matrix(0,sim,6)##結果の箱
titanic[,4]<-as.numeric(titanic[,4])
titanic[,9]<-as.numeric(titanic[,9])

for(i in 1:sim){
  ####学習データとテストデータに分ける####
  train.id<-sample(nrow(titanic),400)
  train.data<-titanic[train.id,-1]
  test.data<-titanic[-train.id,-1]


  ##randomForest##
  rf<-randomForest(Survived~.,train.data)
  test.data.rf<-cbind(test.data,"predict"=predict(rf,test.data))
  result[i,1]<-sum(test.data.rf$predict==test.data.rf$Survived)/nrow(test.data.rf)


  ##SVM##
  svm<-ksvm(Survived~.,train.data)
  test.data.svm<-cbind(test.data,"predict"=predict(svm,test.data))
  result[i,2]<-sum(test.data.svm$predict==test.data.svm$Survived)/nrow(test.data.svm)

  ##ナイーブベイズ##
  nb<-naiveBayes(Survived~.,train.data)
  test.data.nb<-cbind(test.data,"predict"=predict(nb,test.data))
  result[i,3]<-sum(test.data.nb$predict==test.data.nb$Survived)/nrow(test.data.nb)

  ##ニューラルネット##
  nn<-nnet(Survived~.,train.data,size=5)
  test.data.nn<-cbind(test.data,"predict"=round(predict(nn,test.data),0))
  result[i,4]<-sum(test.data.nn$predict==test.data.nn$Survived)/nrow(test.data.nn)

  ##XGboost##
  label.data.train<-as.integer(train.data$Survived)-1##目的変数を01に
  label.data.predict<-as.integer(test.data$Survived)-1

  train.data.xg<-train.data[,-1]##目的変数取り除く
  test.data.xg<-test.data[,-1]

  xgb.data<-xgb.DMatrix(data.matrix(train.data.xg),label=label.data.train)##Xgb型へ成型
  xgb.data.predict<-xgb.DMatrix(data.matrix(test.data.xg))

  param <- list(
    "objective" = "binary:logistic"
    ,"eta" = 0.01
    # ,"max_depth" = 10
    ,"min_child_weight" = 5
    # ,"subsample" = 1
    # ,"colsample_bytree" = 1
  )##パラメータ適当

  model <- xgboost(
    param=param
    ,data=xgb.data
    ,nrounds=1000
  )##実際の学習

  predict_xgb<-predict(model,xgb.data.predict)

  a<-c()
  m<-length(predict_xgb)#行数

  for(l in 1:m){
    if(predict_xgb[l]>0.5){a[l]<-1}
    else{a[l]<-0}
  }
  result[i,5]<-sum(a==label.data.predict)/length(a)

  #k-nn
  knn<-knn(train.data,test.data,train.data[,"Survived"] ,prob=T,k=3)
  test.data.knn<-cbind(test.data,"predict"=knn)
  result[i,6]<-sum(test.data.knn$predict==test.data.knn$Survived)/nrow(test.data.knn)

}

result.c<-apply(result,2,mean)##simの平均値
result.c<-t(as.matrix(result.c))
result.c<-rbind(result.c,result.c)
result.c<-round(result.c,3)
##グラフ描画
colnames(result.c) <- c("RF","SVM","Bayes","NN","xgb","knn")
df<-data.frame(method=colnames(result.c),result=colMeans(result.c))
gp<-ggplot(df,aes(x=method,y=result,fill=method))
gp<-gp+geom_bar(width=0.8,stat="identity")
gp<-gp+ylab("result")
gp<-gp+geom_text(label=colMeans(result.c),vjust=1)
plot(gp)
classというパッケージに入っているknnという関数を用います。
他の手法では大丈夫なんですが、knnは文字列として入っている質的変数を数値に直さなくてはいけないのでこのような処理を施しています。
titanic[,4]<-as.numeric(titanic[,4])
titanic[,9]<-as.numeric(titanic[,9])
関数knnでは学習データと未知データと目的変数を与えます。データによっては、パラメータkで精度が大きく変わる可能性があります。
#k-nn
knn<-knn(train.data,test.data,train.data[,"Survived"] ,prob=T,k=3)
test.data.knn<-cbind(test.data,"predict"=knn)
result[i,6]<-sum(test.data.knn$predict==test.data.knn$Survived)/nrow(test.data.knn)
結果は以下のようになりました。やはりk近傍法が最も精度が低い・・・
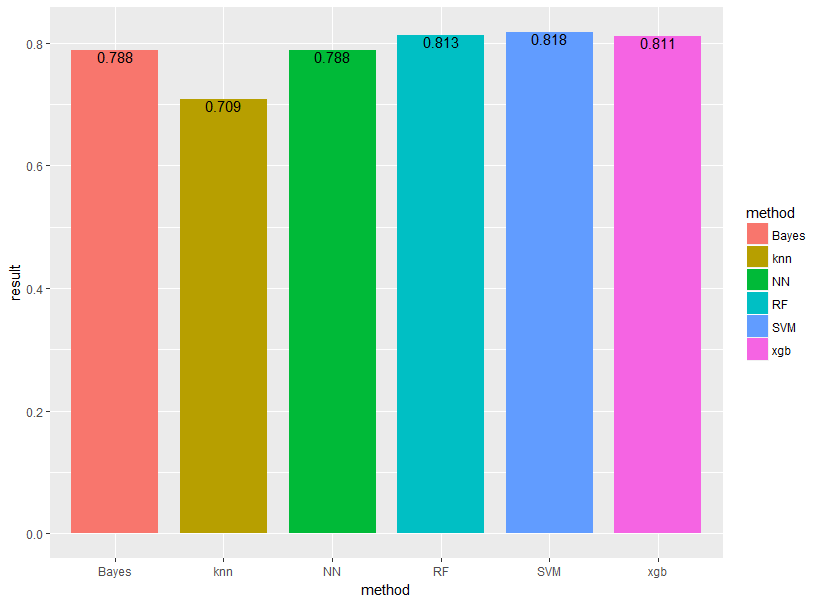
他の機械学習手法に比べるとアルゴリズムが非常にシンプルなのでしょうがない!
ウマたんそれでも解釈性は高いから、ビジネスシーンで用いられることは多いんだよ!
k近傍法 まとめ
本記事では、k近傍法について見てきました。
k近傍法はアルゴリズムがシンプルで分かりやすく、精度も比較的高いのでビジネスシーンでも用いられることが多いです。
是非k近傍法を使ってみてください。
ちなみにk近傍法に関しては、機械学習の王道本「はじめてのパターン認識」で取り上げていますのでそちらを読んで理解を深めると良いでしょう!

もし機械学習手法について理解を深めたいのであれば以下の記事を参考にしてみてください!
 【入門】機械学習のアルゴリズム・手法をPythonとRの実装と一緒に解説!当サイト【スタビジ】の本記事では、入門者向けに機械学習についてカンタンにまとめていきます。最終的にはどのように機械学習を学んでいけばよいかも見ていきます。細かい手法の実装もPython/Rを用いておこなっていくので適宜参考にしてみてください。
また、機械学習の勉強やデータサイエンスの勉強については以下の記事で詳しく解説しています!
 【5分で分かる】機械学習の独学勉強ロードマップを徹底的にまとめていく!当サイト【スタビジ】の本記事では、機械学習の独学勉強ロードマップについて徹底的にまとめていきます。機械学習をいきなり理論からしっかり勉強しようとすると挫折しかねません。そこで、この記事ではなるべく挫折しないロードマップをお伝えしてきますよ!
 【5分で分かる】データサイエンティストに必要なスキルと独学勉強ロードマップ!当サイト【スタビジ】の本記事では、データサイエンティストに求められるスキルとそれを身に付けるための勉強法について徹底的にまとめていきます!入門者でも、しっかりデータサイエンティストについて理解しある程度独学で駆け出しの状態までいけることを目指します。
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる