タグチメソッド
目次
日本であまり知られていないタグチメソッド。その秘密と有用性に迫ります!
タグチメソッドとは?
タグチメソッドとは田口玄一博士が考案した、研究開発や工程管理を効率的に行うための分野です。国内では品質工学と呼ばれています。また、米国などではタグチメソッドと呼ばれて親しまれています。
日本では当初それほど知名度は高くなかったのですが、米国では古くからタグチメソッドの名で親しまれ、多くの生産の現場を改善してきました。
実は世界各国の生産現場を支えているのが田口玄一先生の考案したタグチメソッドなのです!
その背景を経て、日本でも多くの生産現場で使われるようになってきました。しかし、未だにタグチメソッドを実際に取り入れている現場は少なく、リコール問題や品質問題など重大な問題があとを絶ちません。
戦後世界から絶賛された日本の品質の姿は取り戻すことができるのでしょうか
リコールが増えている?!
先ほど申し上げたように、日本ではリコール問題があとを絶ちません。
下の図は国産の自動車のリコール台数を表したグラフ(平成28年度まで)で緑色のバーがリコール台数になります。
2010年代に入って大きく増えていることが分かります。
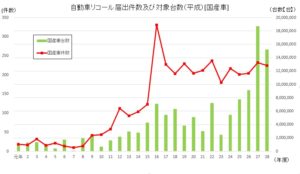
(出典:国土交通省 自動車局HP)
その後も国産車と輸入車をあわせたリコールの届出は年間400件前後で推移していて、令和4年度は383件・約465万台でした。
リコールが起きると消費者が被害を被るだけでなく、リコールをした企業に大きな負担がかかります。
最悪の場合、倒産というケースも免れないでしょう。
さて、このようなリコール問題や品質問題を防ぐために先程ご紹介したタグチメソッドが重要な働きをするわけですが、その働きを製品生産プロセスに焦点を当てて考えていきましょう。
製品を生産するプロセス
リコール問題は未然に防ぎたい!世の中に製品が出る前に防ぎたい!
製品生産プロセス
さて、製品を生産する時、どのようなプロセスがあるでしょうか。
①市場調査
②製品開発
③ライン設計
④材料調達
⑤プロトタイプ生産
⑥需要予測
⑦本製品生産
⑧出荷
細かく分けましたが、大きく分けると
①〜⑤で前段階の試作品を生産し改善
⑥〜⑧で実際の製品を生産していきます
①〜⑤の段階で品質を作り込む作業をタグチメソッドではロバストパラメータ設計と呼びます。
⑥〜⑧の段階で実際に工程管理を行い、異常な製品を弾きます。それをタグチメソッドではMTシステムと呼びます。
それではこれらの説明にうつっていきましょう!
ロバストパラメータ設計
先程生産の過程で①〜⑤に当たるとご紹介したロバストパラメータ設計ですが、ここでいかに品質を作り込むかによって後々大きく変わってくるのでまず、このロバストパラメータ設計を理解し、実践することが大事です。
多くの生産の現場では、実際に作ってみてから問題があったら改善しようという怠惰な姿勢が散見されます。
例えば、あるモーターを生産する現場で不良が見つかりました。モーターのサイズの規格が製造工程で大きくなっています。
それではこの出力を調整し、モーターのサイズを規格内に抑えることが必要なのか。実はそうではない場合が多いのです。不良の原因は、目に見える出力ではなく、ノイズに対するロバストさの不足による原因が多いのです。
つまり、この場合、モーターのサイズの出力を調整したところで今度はモーターの騒音の規格が超えてしまうなどの別の不良が発生する可能性があります。
そのためタグチメソッドでは、まず、ノイズに対するロバストネスを高め、製品の入力に対する出力のばらつきを抑えた後に出力を調整します。
これによりリコール問題などの未然防止が可能になるのです
MTシステム
MTシステムは先程の製品生産のプロセスにおける⑥〜⑧の段階で用いられる手法群です。
MTシステムはマハラノビス・タグチシステムの略であり、田口先生がマハラノビス距離を用いて提案した各手法群という意味です。
MTシステムは大きく分けると異常検知・回帰に分かれ、その中でもいくつかの手法に分かれています。
・MT法
MTシステムの最も古い代表的な手法で、異常検知に用いられます。
一般的に正常状態は1つですが異常の状態は様々です。
そのため、ある状態を異常と固定し考えていると思わぬ落とし穴にハマり品質問題を起こしてしまうことになりかねません。
そこでMT法では単位空間とマハラノビス距離という概念を用いることで、より様々な異常原因に対応した異常検知が可能です。
以下が具体的な計算手順になります!
-
正常と分かっているp次元のデータから標本平均ベクトルと標本共分散行列を計算します。
-
判別したいデータの異常スコアを計算します。MT法では変数の数で割って、正常なデータの異常スコアの平均がおよそ1になるようにします。
-
がある閾値より小さければ正常、大きければ異常と判別します。
機械学習の各種異常検知手法に比べると検出力は弱いですが、もし仮に異常原因がわかっていない場合はMT法が圧倒的に有用となります。
より詳しいことが知りたい方はMT法のページを見てみてください!
・RT法
RT法はMT法の派生手法で比較的新しい手法となっております。
MT法では、サンプル数>変数でないと分散共分散行列の逆行列が求められず、マハラノビス距離の計算ができません。
それを可能にしたのがRT法です。
RT法では、単位空間の平均ベクトルに対する感度(傾き)と、そこからのずれ(残差の標準偏差)の2つを変数として用います。
以下具体的な計算手順です!
-
正常だと分かっているデータを単位空間とします。単位空間のデータで項目ごとの平均と標準偏差を求めます。
-
各サンプルにおいて各項目を並べたベクトルと各項目の平均を並べたベクトルをそれぞれ次のように表します。
-
各サンプルで統計量とを求めます。
-
とを用いて分散共分散行列を求めます。
-
分散共分散行列の余因子行列を求めます。
-
各サンプルのマハラノビス距離の2乗を求めます。の逆行列はを行列式で割ったものなので、次のようになります。
さて、この解析手順を見ると元々はp次元あったデータを2つの統計量に要約してからマハラノビス距離を算出しています。
これが長所の理由です。
これにより高次元の場合にも解析のできる非常に有用な手法となっています。
より詳しいことが知りたい方はRT法のページを見てみてくださいね!
・T法
T法は回帰に用いられる手法です。
説明変数を目的変数から推定する逆回帰というテクニックを用いて解析を行います。説明変数の数に依存しないため変数>サンプル数の状況下でも計算可能となっております。重回帰分析と比較されることの多い手法です。
試作品を作った段階ではサンプル数が多く取れません。その状況で説明変数と目的変数の関係を見たい時、従来の重回帰分析では説明変数を減らすしか方法がありませんでした。しかし、T法を使えば、多くの説明変数と目的変数の関係を小サンプルの状況で観測することができます。
以下具体的な計算手順です!
T法による解析の手順は以下の通りです。
-
学習データの中から目的変数が中位にあるデータを単位空間とします。学習データから単位空間の平均を引くことでデータの基準化を行います。
-
比例定数とSN比を算出します(は単位空間以外のデータ(信号空間)の数です)。
-
逆推定をすることで各説明変数に対する目的変数の推定値を求めます。
-
各説明変数に対する目的変数の推定値をSN比によって重み付け総合をして基準化済みの総合推定値を算出します。
-
単位空間の平均を加えることで基準化前の総合推定値を求めます。
単位空間の基準化の仕方によって派生手法であるTa法やTb法なども提案されています。
より詳しいことが知りたい方はT法のページを見てみてくださいね!
まとめと書籍
いかがだったでしょうか。
タグチメソッドはあまり知られていない考え方かもしれませんが、世界中の品質を支える大切な手法です。
今後さらにタグチメソッドが多くの現場で使われるようになり、日本そして世界の品質・生産の現場が良くなることを願っています。
ちなみにタグチメソッドを勉強する上で有用な書籍を以下に取り上げておきますので良かったらご覧ください。
タグチメソッド入門

非常に簡単にタグチメソッドについて述べられています。
分量も少なくスラスラ読めると思うので初めてタグチメソッドを勉強するという方はまず読んでみると良いと思います。
入門タグチメソッド

先程の「タグチメソッド入門」じゃ物足りないよという人にはこちらの本をおすすめします。
タグチメソッドの背後にあるアルゴリズムや式構造を理解することができると思います。
入門MTシステム

上記の2つだと、ロバストパラメータ設計についてはある程度理解が進むと思いますが、MTシステムに関して深く知りたい方はこちらを読んでみることをおすすめします。

大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる