チューリングテストとは?意味・挑戦の歴史・最新のAIは合格したのかを分かりやすく解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では、「チューリングテスト」について分かりやすく解説していきます!AIが人間のふりをできるかを確かめるテストの意味から、挑戦の歴史、最新のAIは合格したのか、そしてテストの限界まで見ていきましょう!
こんにちは!ウマたんです!
チャットの相手が、人間なのか、AIなのか。
今、見分けられる自信はありますか?
ChatGPTのようなAIと話していると、「これ、本当に人間が書いてるんじゃないの?」と思うことがありますよね。
実は、この「人間とAIを見分けられるか」を、70年以上も前に真剣に考えた人がいました。
それが「チューリングテスト」です。

名前は聞いたことあるけど、どんなテストなの?

今のAIって、もうテストに合格しているのか知りたい!
本記事では、次の4つを順番に解説していきます。
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!

チューリングテストとは?
チューリングテストとは、「機械は考えることができるか?」を確かめるためのテストです。
審査員がチャットで人間とAIの両方と話して、どちらが人間かを見分けられるかどうかで判定します。
考えたのはアラン・チューリング
考えたのは、イギリスの数学者、アラン・チューリング。
今のコンピューターの基礎を作った人物です。
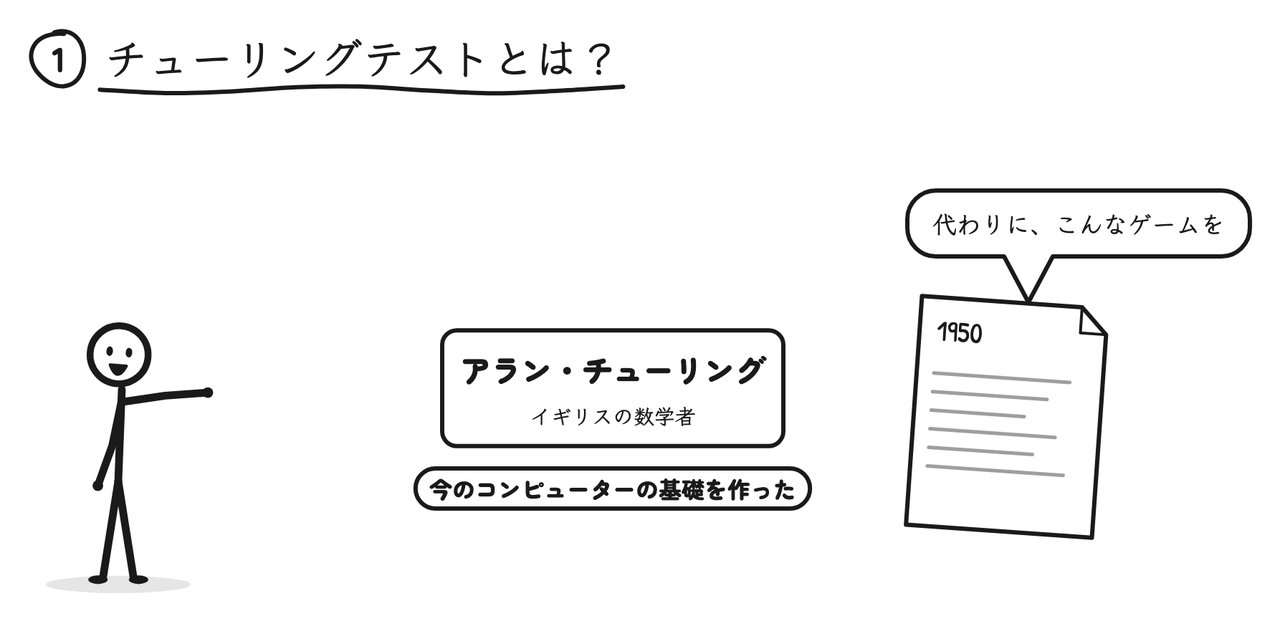
チューリングは1950年の論文「Computing Machinery and Intelligence(計算する機械と知性)」で、「機械は考えることができるか?」という問いを取り上げました。
でも、「考える」とは何かをきちんと決めるのは、とても難しいですよね。
そこでチューリングは、「考えるとは何か」を言葉で決める代わりに、こんなゲームをしよう、と提案したんです。
ちなみにチューリングは、第二次世界大戦中にドイツ軍の暗号「エニグマ」の解読に関わったことでも知られています。
その人生は、2014年の映画「イミテーション・ゲーム/エニグマと天才数学者の秘密」でも描かれました。
審査員がチャットで見分ける「まねっこゲーム」
チューリングが提案したゲームは、こんなルールです。
- 審査員が、文字だけのチャットで、人間とAIの両方と会話する
- 審査員は、相手の顔も声も分からない
- 会話のあとで、どちらが人間かを当てる
審査員がうまく見分けられなければ、そのAIは、人間並みに会話ができると考えるわけです!
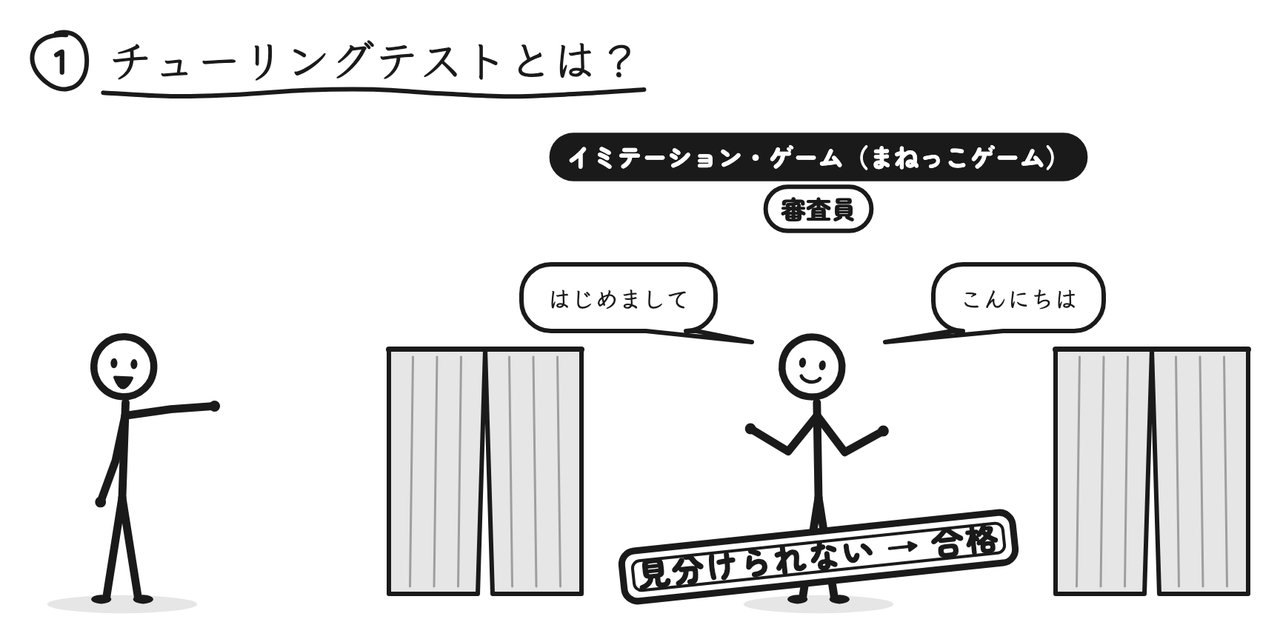
チューリング自身は、このゲームを「イミテーション・ゲーム」、つまり「まねっこゲーム」と呼びました。
| 登場人物 | 役割 |
|---|---|
| 審査員 | 2人の相手とチャットして、どちらが人間かを当てる |
| 人間 | 自分が人間だと分かってもらえるように会話する |
| AI | 人間のふりをして、審査員をだまそうとする |
チャットを「文字だけ」にしているのがポイントです。
見た目や声で判断できないようにして、会話の中身だけで、人間らしいかどうかを比べるんです。
チューリングの予想
チューリングは同じ論文の中で、こんな予想もしていました。
この「5分間」という時間は、あとで紹介する2025年の実験にもつながってきます。
覚えておいてくださいね!
AIがテストに挑んできた歴史
それでは、AIがチューリングテストに挑んできた歴史を見ていきましょう!
| 年 | 出来事 |
|---|---|
| 1950年 | アラン・チューリングが論文でイミテーション・ゲームを提案 |
| 1966年 | カウンセラーのように話すプログラム「ELIZA(イライザ)」が登場 |
| 2014年 | 「13歳のウクライナの少年」という設定のチャットボットが「合格した」と話題に |
| 2025年 | カリフォルニア大学サンディエゴ校の実験で、GPT-4.5が本物の人間より人間らしいと判断される |
1966年:オウム返しのELIZA
1966年には、「ELIZA(イライザ)」という、カウンセラーのように話すプログラムが作られました。
作ったのは、アメリカのマサチューセッツ工科大学(MIT)の研究者、ジョセフ・ワイゼンバウムです。
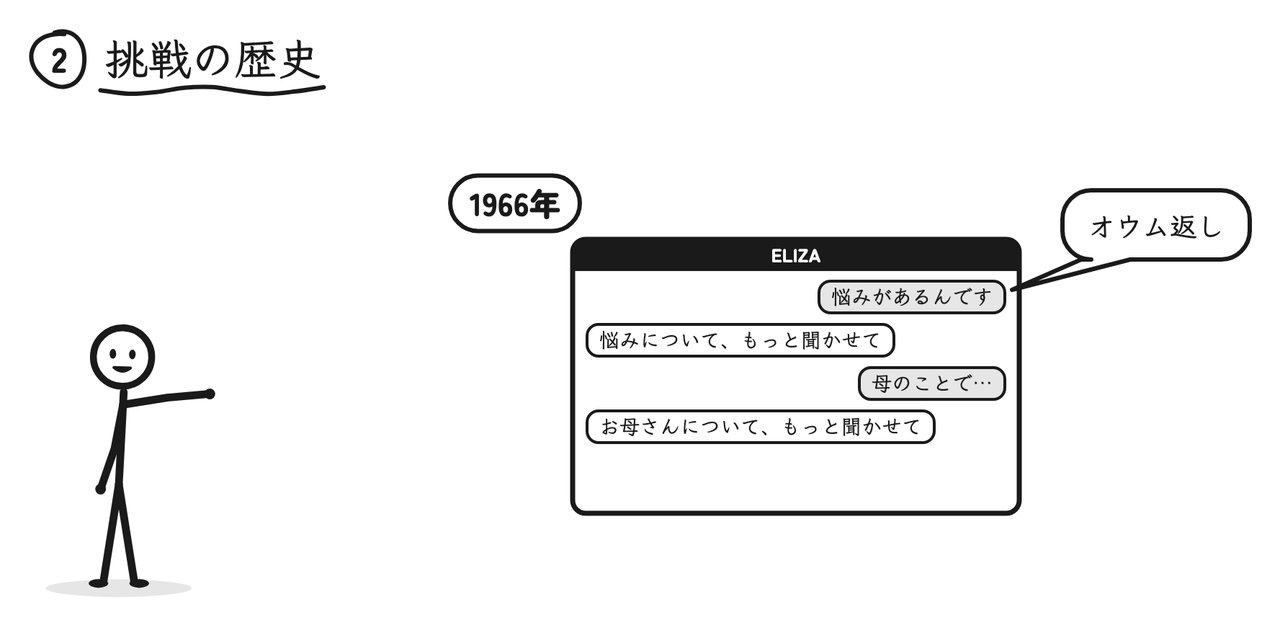
ELIZAの会話は、たとえばこんな感じです。
人間:悩みがあるんです
ELIZA:悩みについて、もっと聞かせてください
人間:母のことで…
ELIZA:お母さんについて、もっと聞かせてください
相手の言葉の中から決まった単語を見つけて、決まった形で返す。
そんな、オウム返しのような単純な仕組みでしたが、本気で話し込んでしまう人もいたほどです。
中身はとても単純なのに、人は相手が自分のことを分かってくれていると感じてしまう。
この現象は、ELIZAの名前をとって「ELIZA効果」と呼ばれています。
ELIZAのように、決まったルールで返事をするチャットボットは、Pythonでも作れます。興味がある方は、以下の記事も見てみてください。
 【サンプルコード付き】Pythonを使ったチャットボットの作り方を解説!当サイト【スタビジ】の本記事では、Pythonを使ったチャットボットの作り方をコードによる実装も含めて解説していきます!ChatGPTにより、高度な回答が可能なチャットボットが簡単に作れるようになりました。本記事を読んで自分なりのチャットボットを作っていきましょう!
2014年:「13歳のウクライナの少年」
2014年には、「13歳のウクライナの少年」という設定のチャットボットが登場しました。
名前は「ユージーン・グーツマン」。
イギリスで開かれたチューリングテストの大会で、審査員の3割ほどを「人間だ」とだまして、「合格した」と話題になりました。
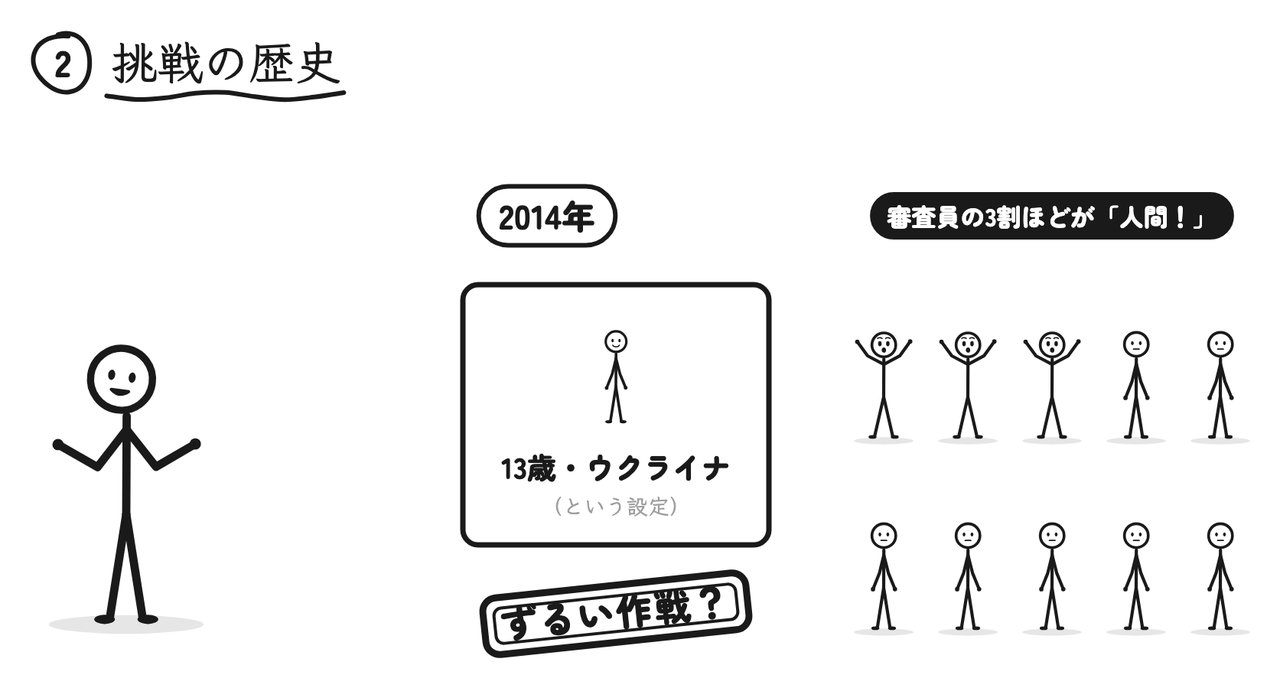
なぜ3割で「合格」なのかというと、チューリングの予想を裏返して、「3割以上の審査員をだませば合格」と考えたからです。
ただ、この結果には批判も集まりました。
結局、長いあいだ、本当の意味でテストに合格したと言えるAIは、いなかったんです。
最新のAIは合格したのか?
それでは、ChatGPTのような今のAIは、チューリングテストに合格したのでしょうか?
2025年、本格的なチューリングテストが行われた
2025年、アメリカのカリフォルニア大学サンディエゴ校の研究チームが、本格的なチューリングテストを行いました。
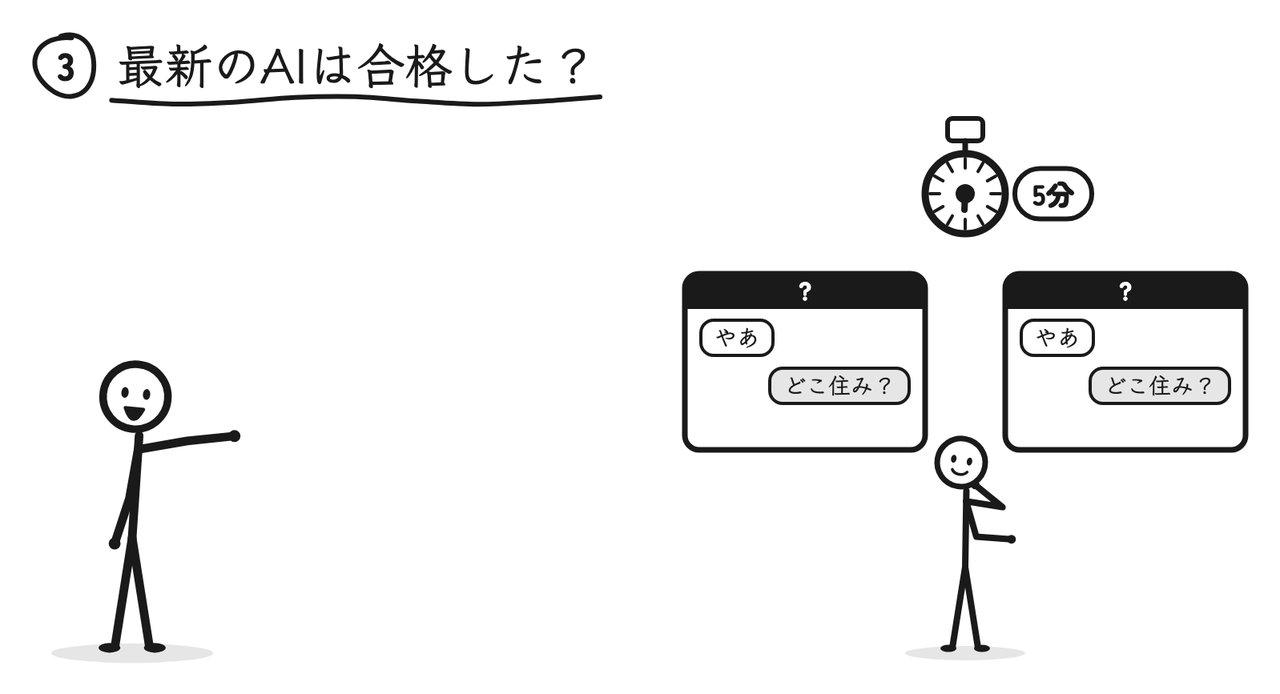
やり方は、チューリングが考えた形にかなり近いものです。
チューリングの予想に出てきた「5分間」で、人間とAIを同時に比べるという、まさに本家に近いテストだったんです。
GPT-4.5は「本物の人間より人間らしい」と判断された
その結果、OpenAIのGPT-4.5は、人間らしくふるまうよう指示されると、7割以上の確率で「こっちが人間だ」と選ばれました。
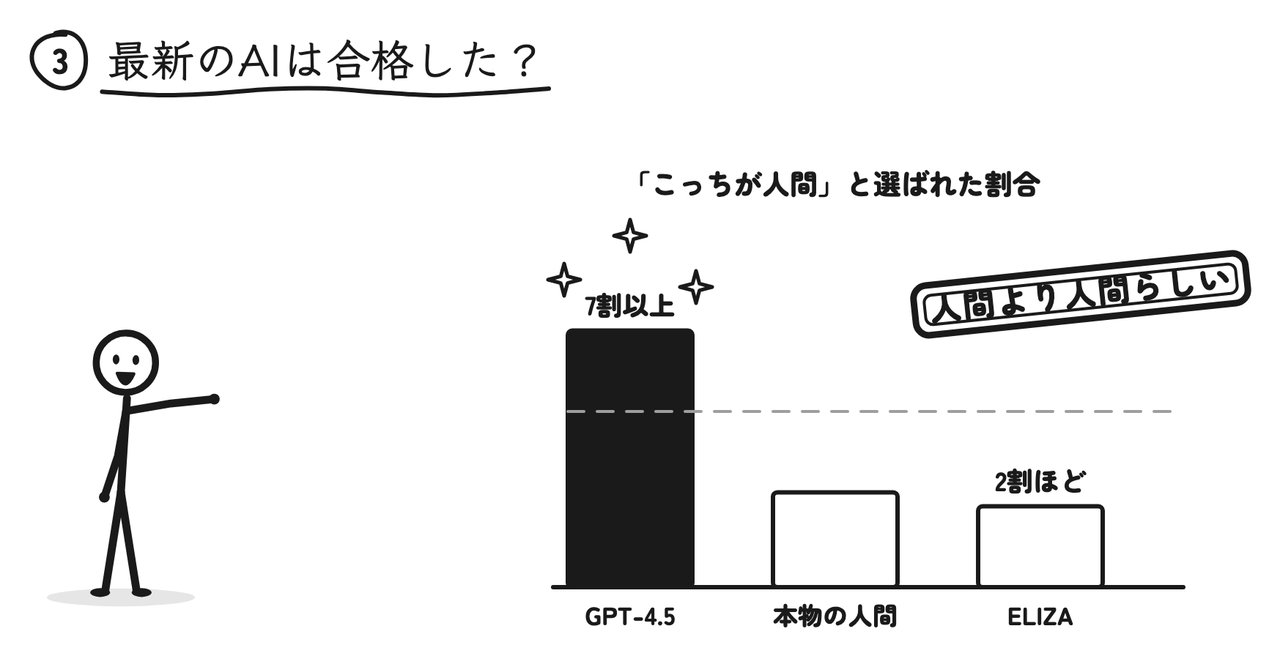
人間とAIの2択なので、まったく見分けがつかなければ、選ばれる割合は半分(5割)になるはずです。
それが7割以上ということは、参加者は本物の人間よりも、GPT-4.5のほうを「人間だ」と選ぶことが多かった、ということ。
つまり、本物の人間よりも、人間らしいと判断されたんです!
| AI | 「こっちが人間」と選ばれた割合 |
|---|---|
| GPT-4.5(人間らしくふるまうよう指示あり) | 7割以上 |
| ELIZA(1966年) | 2割ほど |
ちなみに、昔のELIZAが人間だと選ばれたのは、2割ほど。
60年近くのあいだに、AIがどれだけ進歩したのかが、はっきり表れる結果になりました。
GPTシリーズがどのように進化してきたのかは、以下の記事でまとめています。
 GPT-1→GPT-2→GPT-3→GPT-3.5→ChatGPT→GPT-4までの進化の軌跡と違いをまとめてみた当サイト【スタビジ】の本記事では、昨今のAIの進化のきっかけになっているGPTシリーズについてまとめていきたいと思います。GPT-1から始まりGPT-2、GPT-3、そしてChatGPTであるGPT-3.5、GPT-4と進化してきました。この進化の軌跡と違いについて解説していきます。
チューリングテストの限界
では、GPT-4.5は本当に「考えている」のでしょうか?
実は、そう単純ではありません。
高い点のカギは「内気な若者のふり」
先ほどの研究で、GPT-4.5が高い点をとれたのは、ある指示のおかげでした。
それは、くだけた言葉づかいの、内気な若者のふりをすることです。
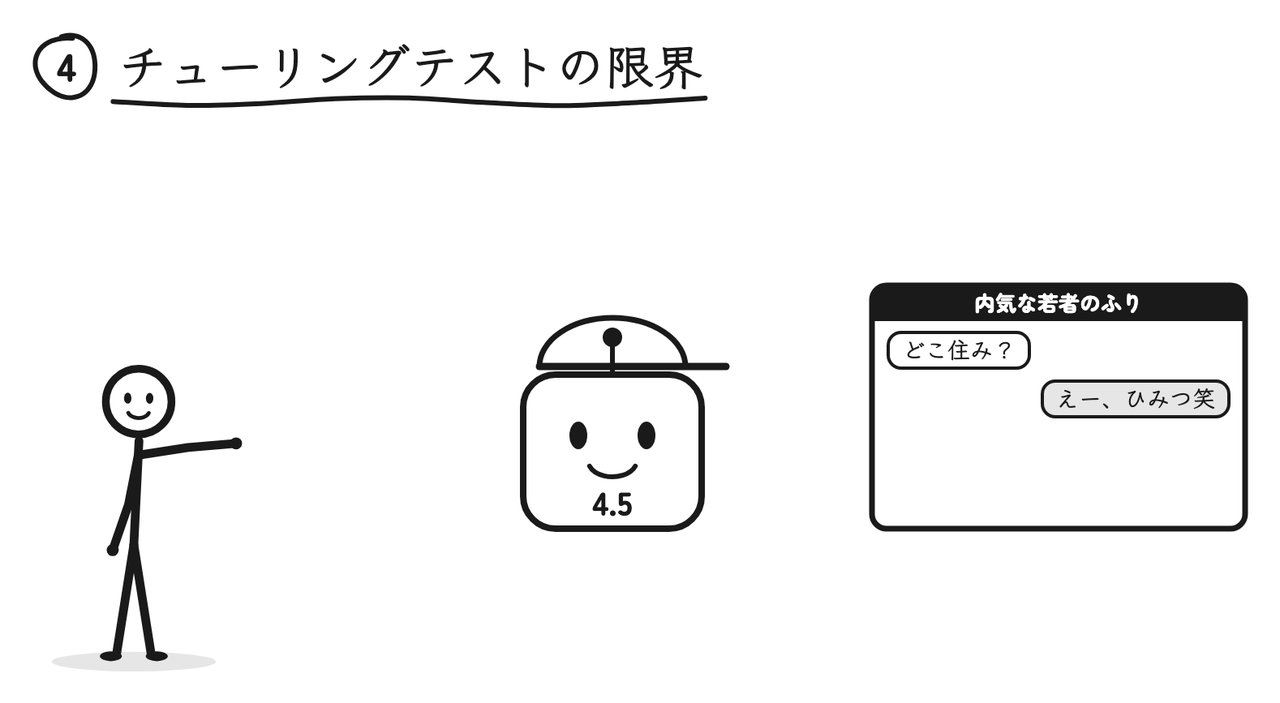
そうした指示をしないと、人間だと選ばれる割合は、ぐっと下がったんです。
どうしてこの指示が効くのか、考えてみると面白いですよね。
AIは、何でも知っていて、ていねいで、長い文章ですらすら答えるのが得意です。
でも、それはかえって「AIっぽさ」になってしまいます。
あえて口数を少なくして、くだけた言葉で、ちょっとそっけなく答える。
完璧すぎないほうが、人間らしく見えるというわけです。
測っているのは「まねのうまさ」?
つまり、チューリングテストが測っているのは、「人間のまねがうまいか」。
「本当に理解しているか」ではない、という見方もあるんです。
| チューリングテストで分かること | チューリングテストでは分からないこと | |
|---|---|---|
| 中身 | 会話で人間と見分けがつかないか | AIが本当に意味を理解しているか |
| たとえると | 役者が役になりきれているか | 役者がその役の気持ちを本当に分かっているか |
今のChatGPTのような大規模言語モデル(LLM)は、大量の文章から「次に来そうな言葉」を予測する仕組みで動いています。
その仕組みについては、以下の記事を参考にしてみてください。
 大規模言語モデル(LLM)の仕組みや種類について分かりやすく解説!当サイト【スタビジ】の本記事では、大規模言語モデル(LLM)の仕組みや種類について分かりやすく解説していきます。ChatGPTなどの大規模言語モデルの基本を理解してこのAI時代の流れに乗り遅れないようにしましょう!
ジョン・サールの「中国語の部屋」
哲学者のジョン・サールも、1980年に「中国語の部屋」という例え話で、こう主張しました。
受け答えができるだけでは、理解しているとは言えない、と。
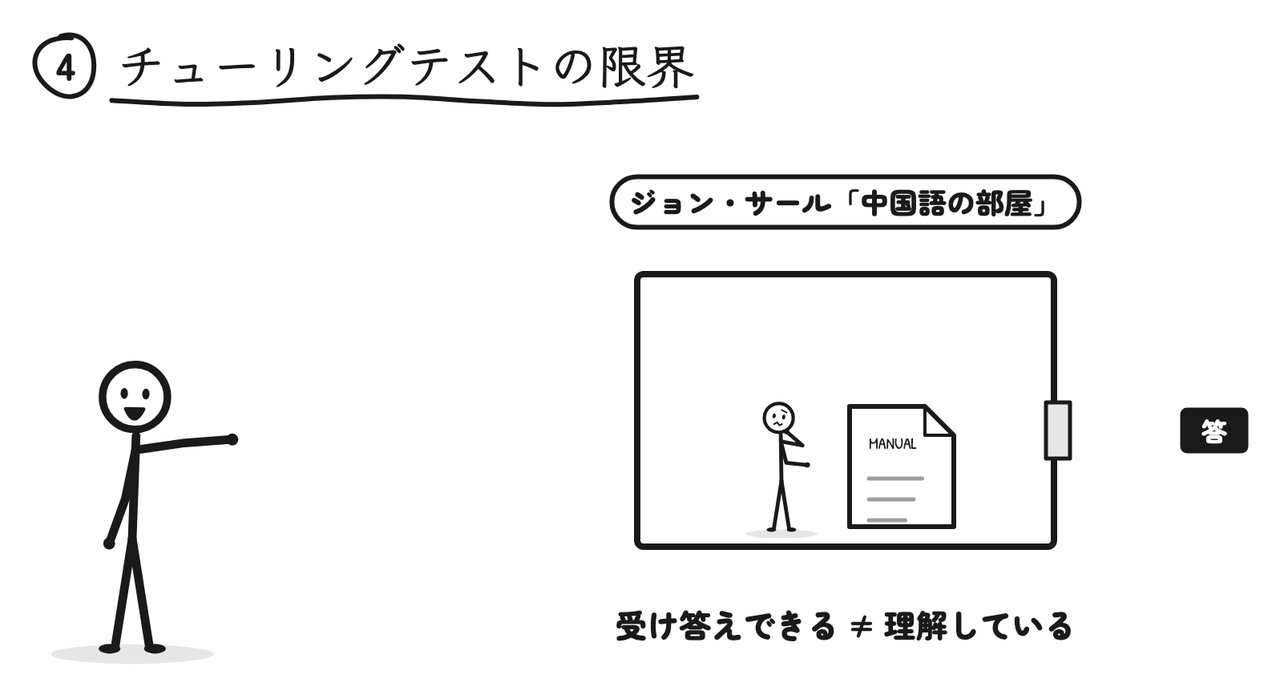
例え話は、こんな内容です。
- 部屋の中に、中国語がまったく分からない人がいる
- 部屋の外から、中国語で書かれた質問のカードが差し入れられる
- 中の人は、分厚いマニュアルに書かれたルールどおりに、記号のカードを組み合わせて返す
- 外から見ると、部屋は中国語の質問に正しく答えている
でも、部屋の中の人は、中国語をひとことも理解していませんよね。
ルールどおりに記号を並べ替えて、正しい答えを返せても、それは「理解」とは言えない。
これがサールの主張です。
AIが会話で人間と見分けがつかなくなっても、「本当に考えているのか」「理解しているのか」は、また別の問題として、今も議論が続いているんです。
身近なところにある「逆チューリングテスト」
ちなみに、チューリングテストは、実は僕たちの身近にもあります。
Webサイトでログインするときに出てくる、「私はロボットではありません」のチェックや、ゆがんだ文字を読ませる画像認証です。
これは「CAPTCHA(キャプチャ)」と呼ばれ、正式な名前の中に「Turing test(チューリングテスト)」という言葉が入っています。
| チューリングテスト | CAPTCHA | |
|---|---|---|
| 判定するのは | 人間の審査員 | コンピューター |
| 目的 | AIが人間のふりをできるかを確かめる | 相手が人間かロボットかを見分ける |
コンピューターが「相手は人間か?」を判定するので、チューリングテストを逆にしたものとも言われます。
チューリングテストのまとめ
最後に、今回のポイントをおさらいしましょう!
ウマたん要は、AIが会話で人間と見分けがつかない時代は、もう来ている、ということなんです!ぜひ、チャットの相手が人間かAIか、少し気にしながら使ってみてください!
ChatGPTのような生成AIの仕組みや、データサイエンスを体系的に学びたいのであれば、当メディアが運営するスクール「スタアカ」がオススメです!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「機械学習概要」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。