Hugging Faceとは?AIモデルを探して試せる「AI界のGitHub」を分かりやすく解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では、「Hugging Face」について分かりやすく解説していきます!AIのモデルを探して試せるサイトの正体から、意外な誕生の歴史、できること、使うときの注意点まで見ていきましょう!
こんにちは!ウマたんです!
新しいAIのモデルが発表されると、よく「Hugging Faceで公開されました」と耳にしますよね。
MetaやGoogleのような大きな会社も、大学の研究室も、個人の開発者も、みんな同じ場所にAIを置いている。
その場所こそが「Hugging Face(ハギングフェイス)」です。

名前はよく見るけど、結局どんなサイトなの?

プログラミングに詳しくなくても使えるのか知りたい!
本記事では、次の4つを順番に解説していきます。
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!
Hugging Faceとは?
Hugging Faceとは、AIのモデルやデータを、世界中の人が公開して共有できるサイトです。
ちなみに名前は、両手を広げて抱きしめているような顔の絵文字「hugging face」から来ています。
AIの箱をぎゅっと抱きしめているイメージで覚えておくと、忘れにくいですよ!
「AI界のGitHub」と呼ばれる理由
Hugging Faceは、よく「AI界のGitHub」とも呼ばれています。
GitHubは、世界中のエンジニアがプログラムを公開して、共有しているサイトです。
GitHubがプログラムの置き場所なら、Hugging FaceはAIの置き場所、というわけです!
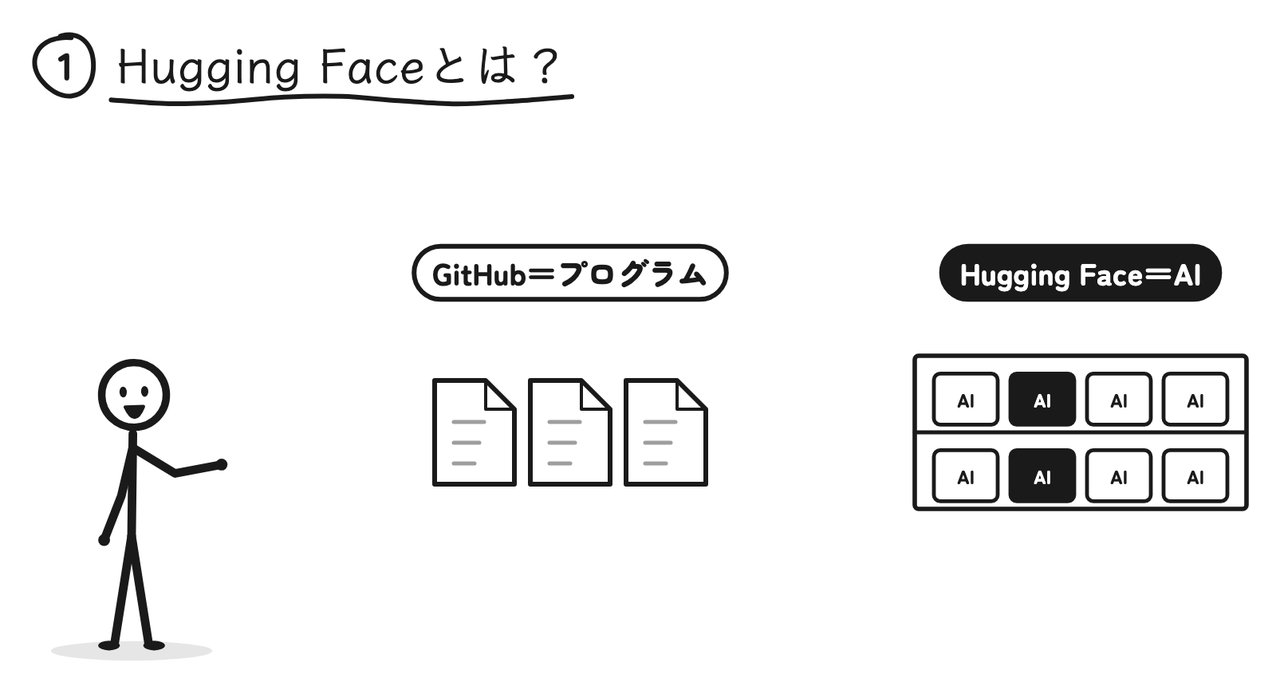
| GitHub | Hugging Face | |
|---|---|---|
| 置いてあるもの | プログラム(ソースコード) | AIのモデル・データセット・デモ |
| できること | コードを探す・ダウンロードする・みんなで直す | モデルを探す・ブラウザで試す・ダウンロードして使う |
| 使う人 | エンジニア | AIの研究者・開発者・AIを学ぶ人 |
300万を超えるモデルが並ぶ「AIの倉庫」
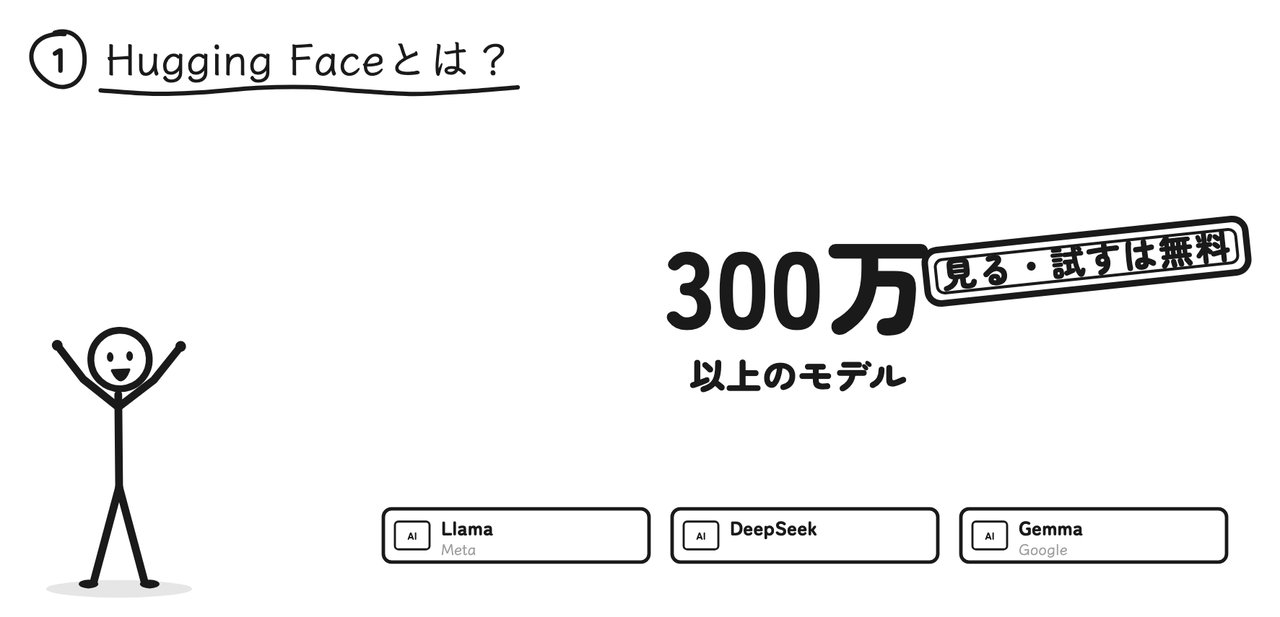
Hugging Faceで公開されているモデルは、なんと300万を超えます(2026年8月に300万を超えたと報告されています。2026年10月時点)。
その中には、MetaのLlamaや、DeepSeek、GoogleのGemmaなど、ニュースで名前を聞く有名なモデルも数多く並んでいます。
まさに、AIがずらりと並んだ大きな倉庫なんです。
しかも、見るだけ、試すだけなら無料。
AIを学ぶ人や作る人にとって、欠かせない場所になっています!
MetaのLlamaについては、以下の記事で詳しく解説しています。
 【大量の学習データ!】Meta開発のLLMであるLLaMA、LLaMA2、派生モデルAlpacaについて解説!当サイト【スタビジ】の本記事では、Meta社の開発する大規模言語モデル(LLM)であるLLaMAについて解説していきます!LLaMAはパラメータの少ない軽量モデルでありながら他のLLMに匹敵する精度を誇るモデルでオープンソース化されています。LLaMA次世代のLLaMA2やLLaMAをベースに開発されたAlpacaについても見ていきましょう!
Hugging Faceの意外な誕生の歴史
今ではAIの世界の中心にあるHugging Faceですが、実は最初からAIの置き場所だったわけではありません。
ここからは、Hugging Faceの意外な誕生の歴史を見ていきましょう!
最初は10代向けのチャットボットのアプリだった
Hugging Faceは2016年、フランス出身の3人(Clément Delangue、Julien Chaumond、Thomas Wolf)が、ニューヨークで立ち上げた会社です。
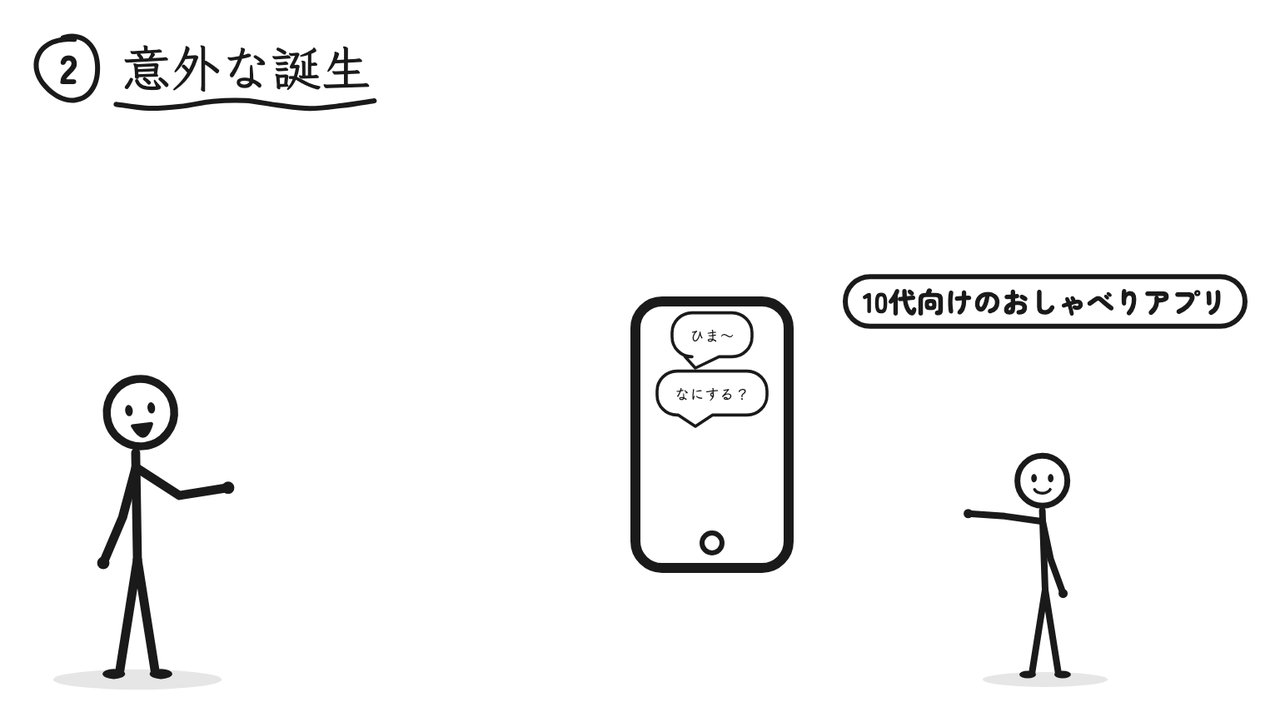
実は最初に作っていたのは、10代の若者向けの、おしゃべりチャットボットのアプリでした。
AIの友だちとスマホでおしゃべりする、そんなアプリだったんです。
道具を無料で公開したら大人気に
転機になったのは、そのアプリの開発の中で作ったAIの道具を、無料で公開したことでした。
これが研究者や開発者の間で、大人気になったんです。
特に「Transformers」という道具は、最新のAIを、たった数行のコードで使えるようにしました!
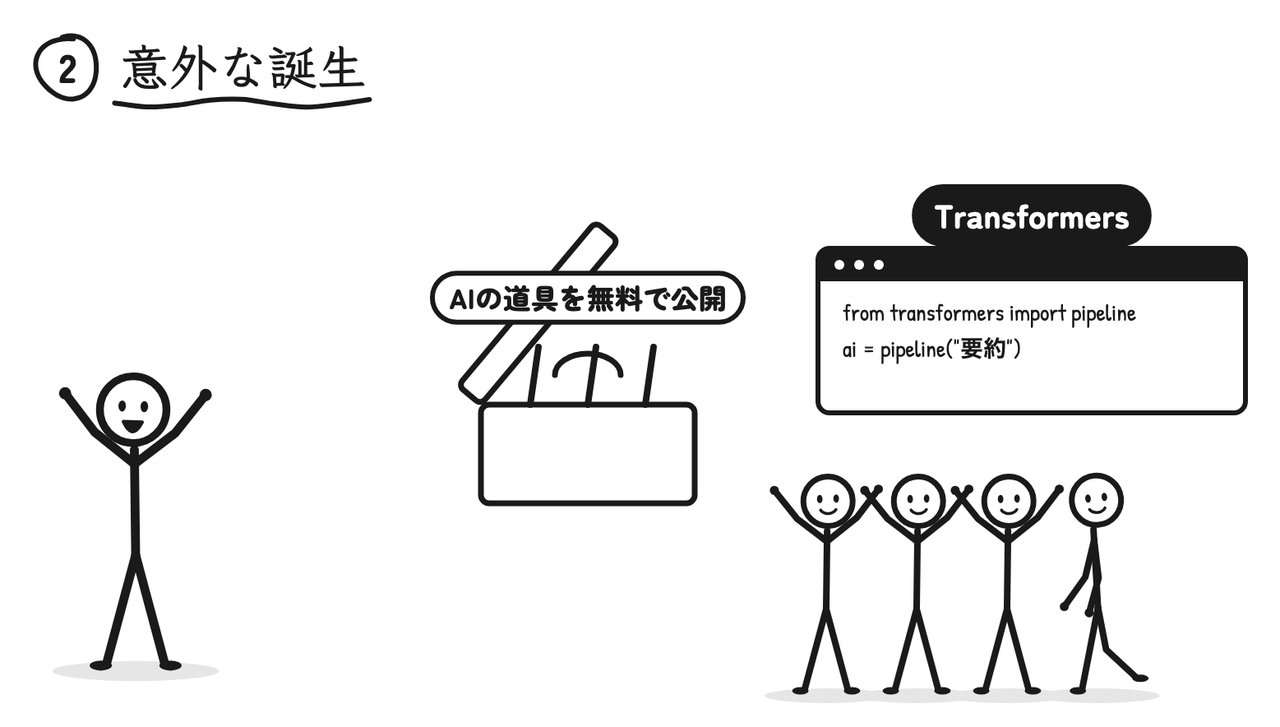
それまでは、論文で発表された最新のAIを自分で動かそうとすると、モデルの組み立てから学習済みの重みの読み込みまで、たくさんの準備が必要でした。
その面倒な部分を、Transformersがまるごと引き受けてくれたわけです。
ちなみに「Transformers」という名前は、ChatGPTなどのもとになっているAIの仕組み「Transformer(トランスフォーマー)」から来ています。
Transformerの仕組みについては、以下の記事で解説しています。
 Transformer(トランスフォーマー)をAI進化の流れと共にわかりやすく解説!Attention層に至るまで当サイト【スタビジ】の本記事では、昨今のAIブームのベースとなっているTransformer(トランスフォーマー)について簡単に解説していきたいと思います!Transformerはディープラーニングの進化をブレークスルーさせた技術なんです
「AIのモデルを共有する場所」に生まれ変わった
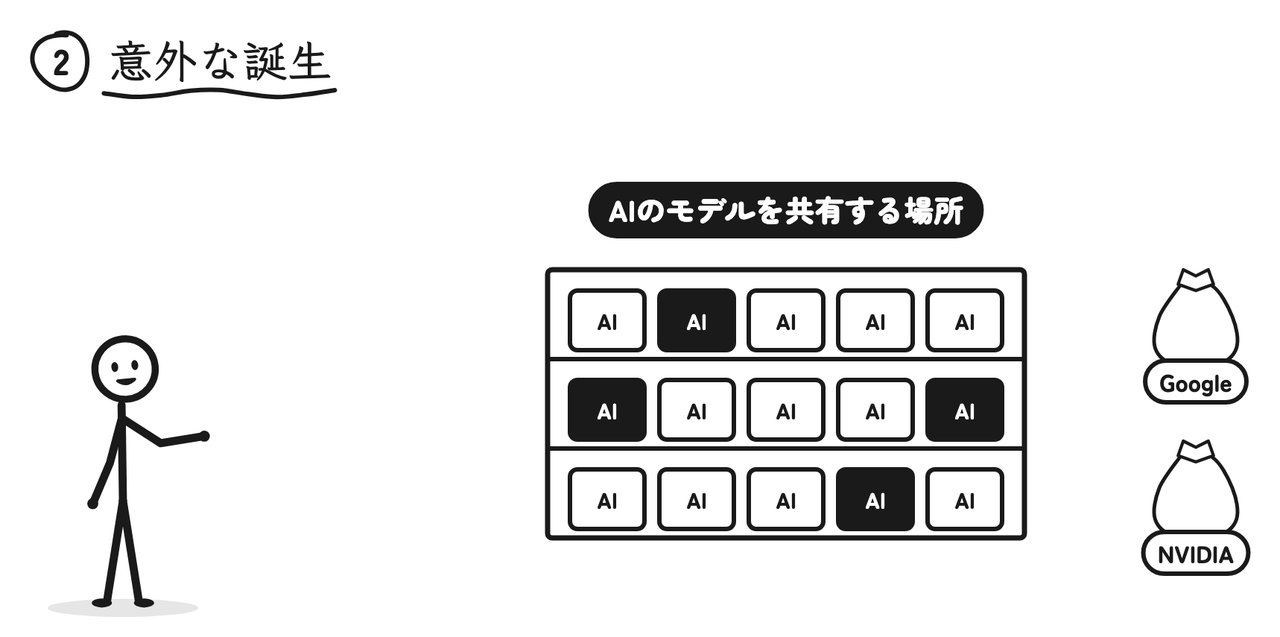
道具が広く使われるようになったことをきっかけに、Hugging Faceは「AIのモデルを共有する場所」へと生まれ変わりました。
今では、GoogleやNVIDIAなども出資する、世界のAIを支える会社に成長しています。
| 時期 | できごと |
|---|---|
| 2016年 | フランス出身の3人がニューヨークで創業。10代向けのチャットボットのアプリを作る |
| その後 | 開発の中で作ったAIの道具を無料で公開し、研究者や開発者の間で大人気に |
| 今 | 「AIのモデルを共有する場所」として、GoogleやNVIDIAなども出資する会社に |
チャットボットの会社が、自分たちの道具を惜しまず公開したことで、世界中のAIが集まる場所になった。
「公開して、みんなで使う」という姿勢が、Hugging Faceを大きくしたんです!
Hugging Faceでできること
続いて、Hugging Faceで実際に何ができるのかを見ていきましょう!
できることは、大きく分けて3つあります。
モデルを「探す」
1つ目は、モデルを「探す」ことです。
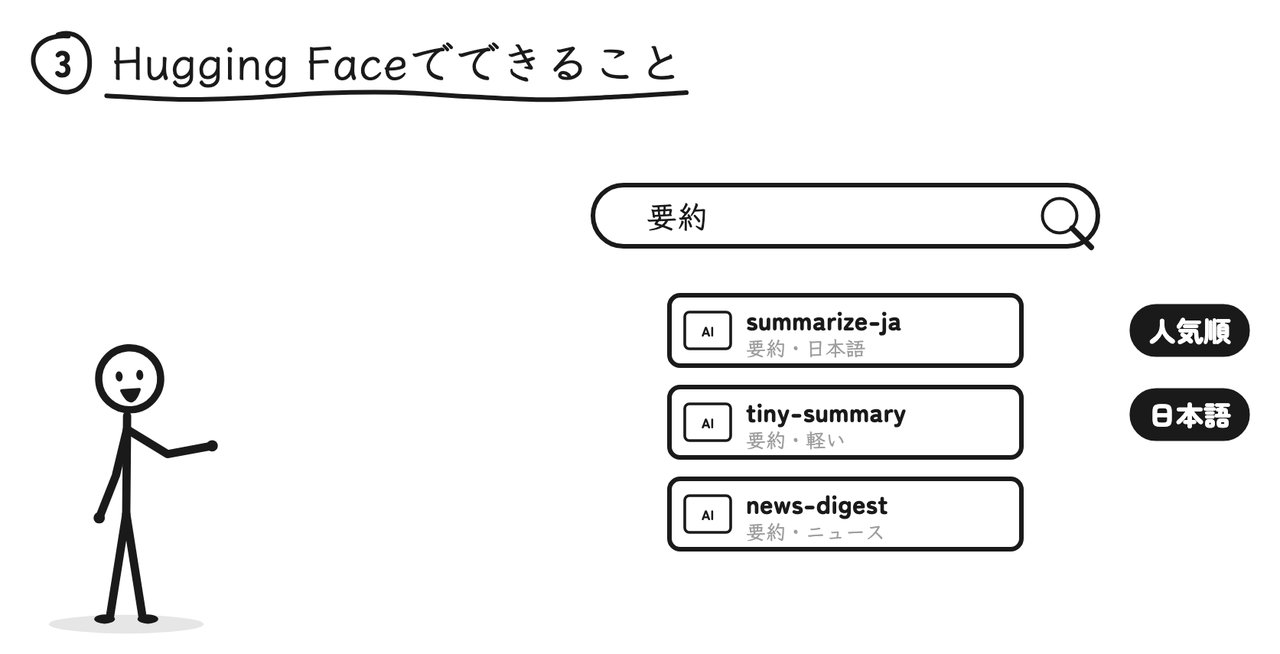
「文章の要約」や「画像の生成」など、やりたいことで絞り込めば、ぴったりのモデルが見つかります。
| 絞り込み・並べ替え | こんなときに便利 |
|---|---|
| やりたいこと(タスク)で絞り込む | 「文章を要約したい」「画像を作りたい」など、目的が決まっているとき |
| 人気の順に並べる | たくさんの人に使われている、定番のモデルを選びたいとき |
| 言語で絞り込む | 日本語に強いモデルを探したいとき |
たとえば「日本語の文章を要約したい」なら、次のような流れで探していきます。
それぞれのモデルには説明のページがあって、何ができるモデルなのか、どう使うのか、どんな条件で使ってよいのかが書かれています。
気になるモデルが見つかったら、まずはこのページを読むところから始めましょう!
ダウンロード数や「いいね」の数も表示されているので、どれくらい使われているモデルなのかも一目で分かります。
ブラウザで「試す」
2つ目は、ブラウザで「試す」ことです。
「Spaces」というページでは、ほかの人が作ったAIのデモを、その場で動かせるんです!
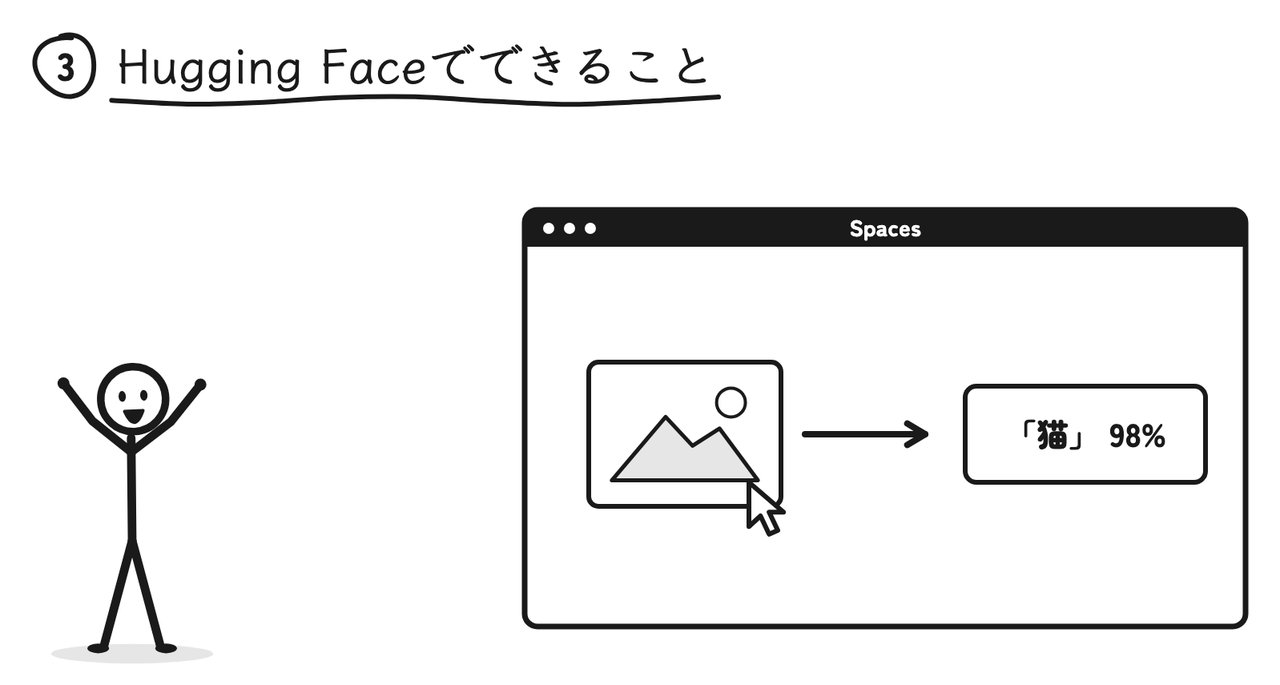
たとえば画像を入れると結果が出てくるデモなら、画像をアップロードしてボタンを押すだけ。
プログラムを書かなくても、ブラウザだけでAIを試せるので、プログラミングに詳しくない人でも気軽に触れます。
Spacesのデモは、PythonのGradioというライブラリで作られているものが多くあります。Gradioで自分のAIアプリを作る方法は、以下の記事で解説しています。
 Gradioを使ってPythonで簡単に機械学習Webアプリを開発してみよう!当サイト【スタビジ】の本記事では、Gradioの使い方を解説していきます!Gradioは機械学習モデルをデモするためのPythonライブラリ!誰でも機械学習モデルを使って予測や分類できるようなWebアプリを簡単に開発できます!
自分の環境で「使う」
3つ目は、自分のパソコンやサーバーで「使う」ことです。
気に入ったモデルはダウンロードして、自分の環境で動かせます。
Pythonなら、Transformersを使って、数行書くだけ。
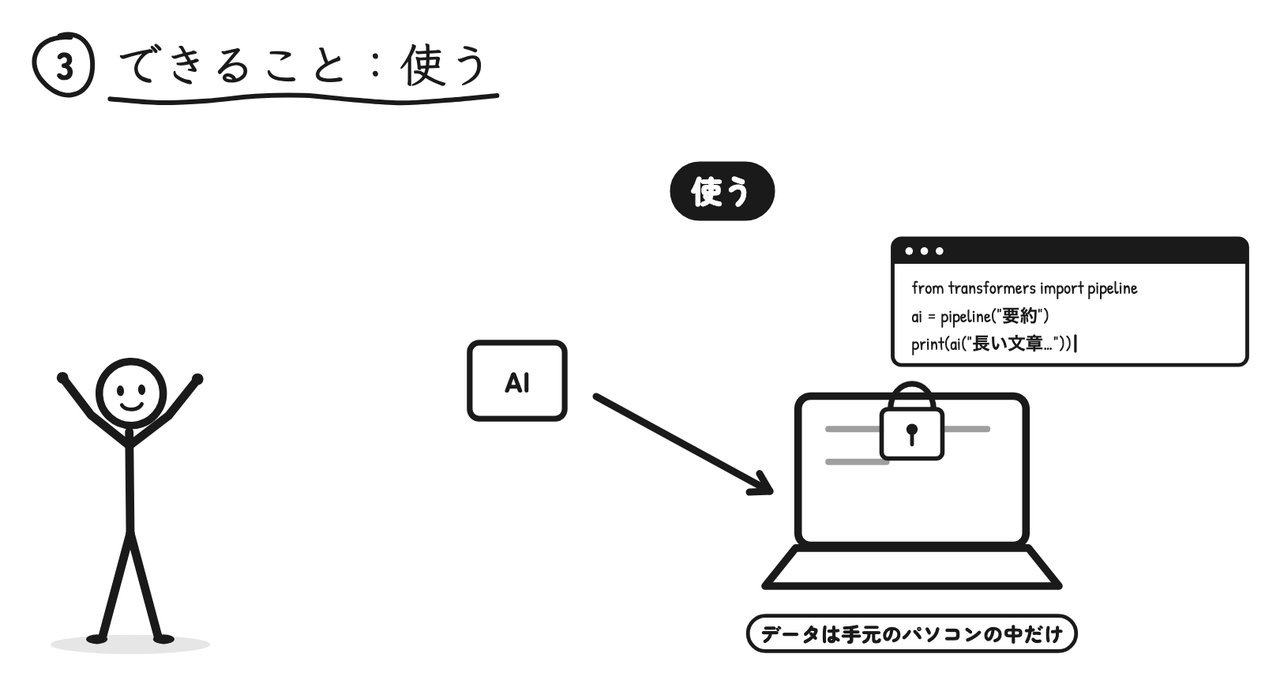
たとえば、文章が前向きか後ろ向きかを判定する「感情分析」なら、次のように書きます(先に pip install transformers torch でインストールしておきます)。
from transformers import pipeline

# 感情分析の道具を用意する(初回はモデルが自動でダウンロードされる)
classifier = pipeline("sentiment-analysis")

print(classifier("I love this movie!"))
実行すると、「POSITIVE(前向き)」という判定と、その確からしさの数字が返ってきます。
モデルを指定しないときは、英語用のモデルが自動で選ばれます。日本語の文章を扱うときは、pipeline("sentiment-analysis", model="モデルの名前") のように、Hugging Faceで見つけた日本語のモデルの名前を指定しましょう。
そして、手元で動かすことには大きなメリットがあります。
ネットに出したくないデータでも、手元のパソコンの中だけでAIを動かせるので安心なんです!
社外に出せない資料を要約したい、といった場面でも使えますね。
さらに、ダウンロードしたモデルに自分のデータで追加の学習をさせる「ファインチューニング」で、自分の仕事に合ったAIに仕立て直すこともできます。
自分のパソコンで大規模言語モデルを動かす「ローカルLLM」については、以下の記事で詳しく解説しています。
 【入門】ローカルLLMって何?概要と使い方を徹底解説!当サイト【スタビジ】の本記事では、クラウドに頼らず自分のPCだけで大規模言語モデルを動かす「ローカル LLM」をわかりやすく解説します!
データセットも公開されている
ほかにも、AIの学習に使うデータ、「データセット」もたくさん公開されています。
モデルだけでなく、モデルを鍛えるための材料まで、ひとつの場所でそろうわけです。
| 置いてあるもの | 主な使い方 | |
|---|---|---|
| モデル | 学習済みのAI | ダウンロードして、そのまま使う・追加で学習させる |
| データセット | AIの学習や評価に使うデータ | 自分でモデルを鍛える・モデルの性能を比べる |
| Spaces | AIのデモ(Webアプリ) | ブラウザで試す・自分のアプリを公開する |
Hugging Faceを使うときの注意点
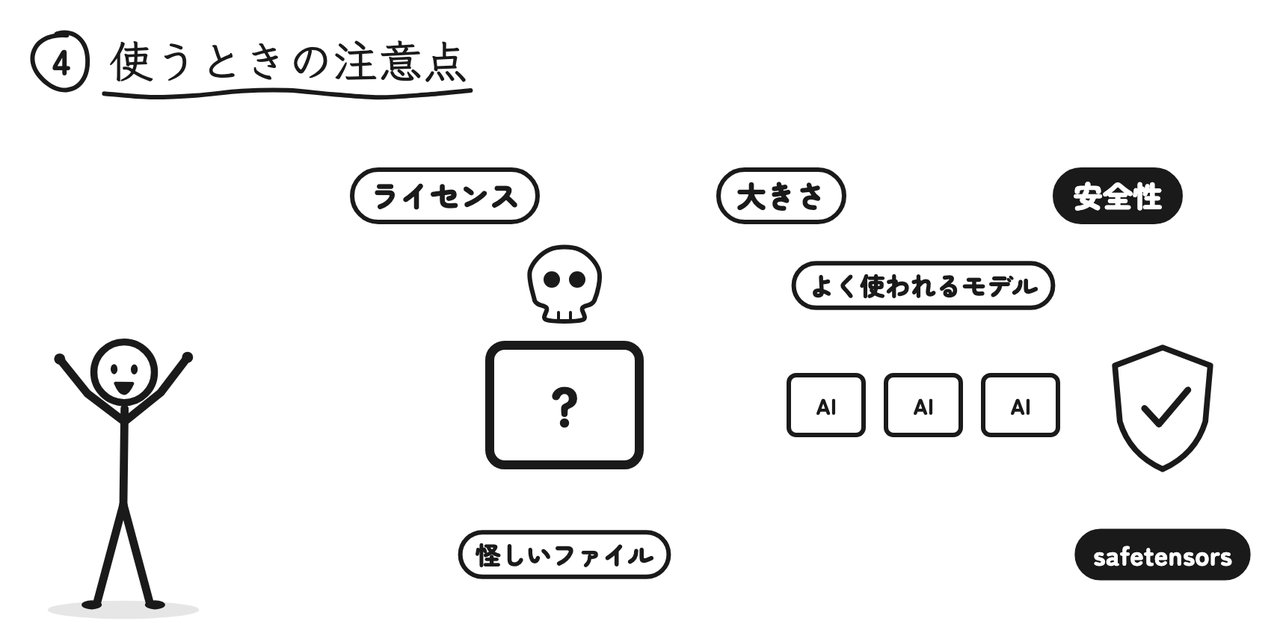
とても便利なHugging Faceですが、誰でも公開できる場所だからこそ、気をつけたいポイントがあります。
ここでは、3つの注意点を紹介します。
ライセンスを確認する
まずは、ライセンスの確認です。
モデルによって、仕事で使ってよいか、どんな条件があるかが違います。
| ライセンスの例 | ざっくりした中身 |
|---|---|
| Apache 2.0・MIT など | 仕事での利用も含めて、比較的自由に使える |
| 非商用のライセンス | 研究や個人の勉強には使えるが、仕事では使えない |
| モデル独自のライセンス | Llamaのように、モデルごとに決められた条件を守って使う |
中には、ダウンロードする前に利用条件への同意が必要なモデルもあります。
モデルのページの説明は、必ず読みましょう。
大きさを確認する
次に、大きさです。
大きなモデルは、ふつうのパソコンでは動かないこともあります。
モデルの名前には「7B」のように、大きさを表す数字が入っていることがよくあります。「B」は10億(billion)のことで、7Bなら70億個のパラメータを持つモデル、という意味です。
目安として、16ビットの数字で読み込むと、1つのパラメータに2バイトかかります。7Bのモデルなら、それだけで14GBほどのメモリが必要になる計算です。
自分のパソコンで動く大きさかを確かめてから選びましょう!
安全性を確認する
そして、安全性です。
Hugging Faceは誰でも公開できる場所なので、中には怪しいファイルがまぎれていることもあります。
そこで、次の2つを心がけましょう。
昔からよく使われている形式のファイルの中には、読み込んだときにプログラムを実行できてしまうものがあります。悪意のある人がそこにプログラムを仕込むと、モデルを読み込んだだけで勝手に動いてしまうおそれがあるんです。
一方の「safetensors」は、モデルの数字(重み)だけを保存する形式なので、読み込んでも勝手にプログラムが動くことはありません。
ファイルの形式を選べるときは、safetensorsを使うのがおすすめなんです!
Hugging Faceのまとめ
最後に、今回のポイントをおさらいしましょう!
ウマたん要は、Hugging Faceは、誰でも最新のAIを手に取れる、AIの大きな倉庫なんです!ぜひ一度、気になるAIを探しに、のぞいてみてください!
AIのモデルを実際に動かしながら、生成AIやデータサイエンスを体系的に学びたいのであれば、当メディアが運営するスクール「スタアカ」がオススメです!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる