次元削減とは?必要な理由と主な手法(主成分分析・t-SNE)のちがいを分かりやすく解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では、AI・データサイエンスの重要テーマ「次元削減」について分かりやすく解説していきます!なぜ必要なのかから、主成分分析やt-SNEといった主な手法のちがい、使われる場面まで、全体像をつかんでいきましょう!
こんにちは!ウマたんです!
お客さんのデータには、年齢、年収、住んでいる地域、買った商品、サイトを見た回数…と、何十、何百もの項目が並んでいることがよくあります。
項目が多いのは、一見すると「情報がたくさんあって良いこと」に思えますよね。
でも実は、項目が多すぎると、計算が重くなったり、全体像が見えなくなったり、AIがうまく学べなくなったりと、困ったことが起きるんです。
そこで使われるのが「次元削減」です。

主成分分析とかt-SNEとか、次元削減の手法がいろいろあって、どれを使えばいいのか分からない…

そもそも「次元」って何のこと?データの次元を減らすってどういうこと?
本記事では、次の5つを順番に解説していきます。
以下のYouTube動画でも解説していますので、あわせてチェックしてみてください!

次元削減とは?
まずは、「次元」とは何を指すのかから見ていきましょう。
データ分析での「次元」は特徴量の数
データ分析では、年齢、年収、住所など、データの1つ1つの項目(特徴量)が「次元」にあたります。
| お客さん | 年齢 | 年収 | 地域 | 購入回数 | サイト訪問回数 | … |
|---|---|---|---|---|---|---|
| Aさん | 34 | 520万円 | 東京 | 12 | 48 | … |
| Bさん | 27 | 380万円 | 大阪 | 3 | 15 | … |
この表なら、項目(列)の数が、そのままデータの次元の数です。
データに含まれる特徴量の数が多い状態を「次元が高い」と呼び、このようなデータを「高次元データ」と呼びます。
たとえば、8×8ピクセルの小さな白黒画像でも、ピクセルが64個あるので64次元のデータです。
次元削減は「情報を保ったまま圧縮する」こと
次元削減とは、たくさんある特徴量を、できるだけ情報を保ちながら、少ない特徴量に圧縮することです。
たとえば、100次元のデータを、2次元や10次元に縮めます。
イメージとしては、立体の物を写真に撮るのに似ています。
立体(3次元)を写真(2次元)にすると、奥行きの情報は失われます。
でも、撮る向きを工夫すれば、その物の形がよく分かる写真が撮れますよね。
次元削減は、「データの特徴が一番よく分かる撮り方」を探して、少ない次元に写し取る技術なんです!
次元削減が必要な理由
では、なぜ次元削減が重要なのでしょうか?
次元が多すぎると、いろいろな問題が起きるんです。
問題1:処理が重くなる
1つ目は、処理が重くなることです。
特徴量が増えると、それだけ計算に時間とメモリが必要になります。
さらに、データが散らばる空間をまんべんなく埋めるのに必要なデータの量は、次元が増えるほど指数関数的に増えていきます。
問題2:可視化できない
2つ目は、可視化できないことです。
人間が直感的に理解できるのは、2次元か3次元まで。
100次元のような高次元データを、そのまま目で見て把握するのは不可能です。
問題3:過学習が起きやすくなる
3つ目は、過学習が起きやすくなることです。
特徴量が増えるほど、モデルは手元のデータに合わせすぎてしまい、新しいデータに対する予測の性能(汎化性能)が下がってしまうんです。
このように、次元が増えすぎることで起きるさまざまな問題は、まとめて「次元の呪い」と呼ばれています。
 次元の呪いとは!?対策/対処法と共にわかりやすく解説!当サイト【スタビジ】の本記事では次元の呪いについて解説してきます。次元の呪いとは、高次元になればなるほど機械学習による回帰・分類が上手くいかない現象を指します。今回は次元の呪いとその解決方法について解説していきます。
つまり、次元削減は、計算を軽くし、可視化し、過学習を防ぐための基本なんです!
次元削減の2つのタイプ
それでは、次元削減にはどのようなタイプがあるのでしょうか?
次元削減には、大きく分けて2つのタイプがあります。
特徴選択:大事な特徴量だけを選ぶ
1つ目は「特徴選択」です。
これはシンプルに、重要な特徴量だけを選んで、残りは使わないアプローチです。
たとえば、100個の項目の中から、予測に効いている10個だけを残す、といったやり方ですね。
元の項目をそのまま使うので、「どの項目が効いているのか」が分かりやすいのが良いところです。
特徴抽出:特徴量を組み合わせて新しい軸を作る
2つ目は「特徴抽出」です。
こちらは、元の特徴量を組み合わせて、新しい特徴の軸を作るアプローチです。
たとえば、「身長」と「体重」という2つの項目を組み合わせて、「体の大きさ」という1つの軸にまとめる、といったイメージです。
| 特徴選択 | 特徴抽出 | |
|---|---|---|
| やり方 | 重要な特徴量だけを選ぶ | 特徴量を組み合わせて新しい軸を作る |
| 例 | 100項目から10項目だけ残す | 身長と体重から「体の大きさ」の軸を作る |
| 良いところ | 元の項目のままなので、意味が分かりやすい | 多くの項目の情報を、少ない軸にまとめて残せる |
| 気をつけること | 捨てた項目の情報は使えなくなる | 新しい軸が何を表すのか、読み取りにくいことがある |
| 代表的な手法 | 重要度の低い特徴量を外す、統計的な検定で選ぶ など | 主成分分析(PCA)、t-SNE、UMAP など |
ふつう「次元削減」というと、2つ目の特徴抽出のほうを指すことが多いです。
ここからは、特徴抽出の代表的な手法を見ていきましょう!
主な次元削減の手法
次元削減には、たくさんの手法があります。まずは全体像をつかんでおきましょう。
| 手法 | 縮め方 | 得意なこと | 主な使い道 |
|---|---|---|---|
| 主成分分析(PCA) | 直線的(線形) | データのばらつきが大きい方向をとらえる | 前処理、可視化、データの要約 |
| 線形判別分析(LDA) | 直線的(線形) | 正解のグループがよく分かれる方向を探す | 分類の前処理 |
| t-SNE | 曲がった関係も扱える(非線形) | 近くにあるデータどうしの関係を保つ | 可視化 |
| UMAP | 曲がった関係も扱える(非線形) | 近所の関係を保ちつつ、計算が速い | 可視化、前処理 |
| オートエンコーダ | ニューラルネットワーク | 画像などの複雑なデータを圧縮する | 特徴の圧縮、異常検知 |
この中でも特によく使われるのが、主成分分析(PCA)です。そして、可視化の定番として人気なのがt-SNEです。
この2つを、順番に見ていきましょう!
主成分分析(PCA):データが一番広がる方向を探す
次元削減の中でもっともよく使われるのが、特徴抽出の一種である「主成分分析(PCA)」です。
主成分分析は、簡単に言うと、データが一番広がっている方向を探し、その方向を軸にしてデータを並べ直す手法です。
たとえば、2次元のデータが、斜めに細長く散らばっていたとしましょう。
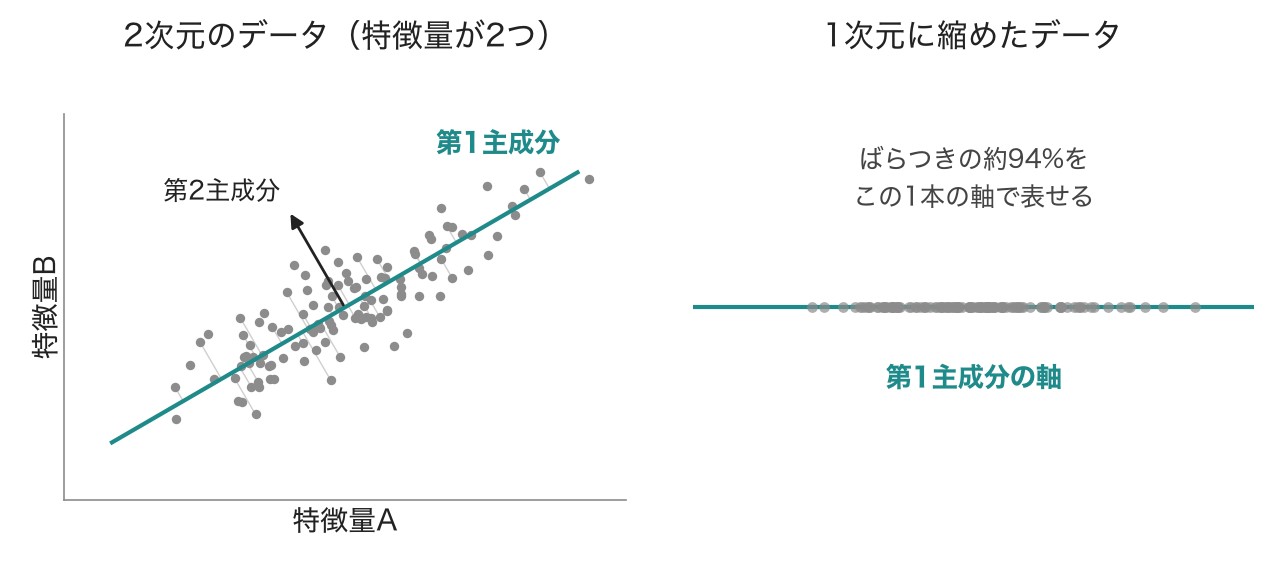
このデータは「この方向に広がっているな」という軸がありますよね。
その軸に、データを写し取る(射影する)と、情報のばらつきを保ちながら、次元を圧縮できるんです。
このデータが一番広がる方向を「第1主成分」と呼びます。図の例では、第1主成分の1本の軸だけで、元のデータのばらつきの約94%を表せています。
もし2次元に圧縮したいのであれば、第1主成分に直交(直角に交わる)しつつ、2番目に広がる方向を「第2主成分」とすることで、2つの軸にまとめられます。
ここでは2次元の平面で説明しましたが、奥行きも含めた3次元の空間で考えれば、第1主成分と第2主成分の両方に直交する、3番目の主成分も作れます。
こうして、たとえば100次元のデータを2次元や3次元に圧縮して、可視化できるようになるわけです。
それぞれの主成分が、元のばらつきの何%を表しているかは「寄与率」と呼ばれ、何個の主成分を使えば十分かを決める目安になります。
主成分分析の考え方やPythonでの実装は、以下の記事で詳しく解説しています。
 主成分分析とは?簡単な説明とPythonでの実装!当サイト【スタビジ】の本記事では、実務の基礎分析にて使われることの多い主成分分析について詳しく見ていきます。最後にはカンタンなPythonでの実装も載せていますのでぜひ参考にしてみてください!
なお、主成分分析とよく似た手法に「因子分析」があります。たくさんの項目の裏にある、共通の要因(因子)を探す手法で、アンケートの分析などでよく使われます。
 因子分析をわかりやすく解説!主成分分析との違いやPythonでの実装方法!当サイト【スタビジ】の本記事では、多変量解析の一種である因子分析について解説していきます!考え方や主成分分析との違いを説明した後、Pythonで実装していきます!
t-SNE:近いものを近くに置く、可視化の手法
続いて、可視化の定番「t-SNE(ティースニー)」です。
t-SNEについては、以下の動画でも解説しています。

t-SNEは、高次元のデータを2次元や3次元に落として、可視化するための手法です。
たとえば、画像の特徴量やユーザーの行動ログのような、数十〜数百次元のデータを、人間が見て理解できる2次元・3次元の図に変換できます。
目的は、分析そのものよりも「理解」です。
t-SNEは「t-distributed Stochastic Neighbor Embedding」の略で、2008年にローレンス・ファン・デル・マーテン氏とジェフリー・ヒントン氏が発表しました。名前を分解すると、何をしているのかが見えてきます。
| 英語 | 意味 |
|---|---|
| Neighbor | 近くにいるデータどうしの関係を |
| t-distributed | t分布を使って |
| Stochastic | 確率的に |
| Embedding | 低い次元に埋め込む |
もっと分かりやすく言うと、近いデータどうしの関係を、確率を使ってうまく低い次元に配置する手法と思ってもらえれば大丈夫です。
t-SNEは「近所の関係」を守る
t-SNEの直感的な仕組みのポイントは、「局所構造」、つまり近いものは必ず近くに置くという点です。
高次元の空間で似ているデータは、2次元でも必ず近くに配置します。
その代わり、次のようなものは、かなり犠牲にされます。
そのため、t-SNEで描いた図では、「島(まとまり)どうしの距離」や「島の大きさ」を、そのまま元のデータの差として読み取らないように注意しましょう。
また、近所をどれくらいの広さで見るかを決める「perplexity(パープレキシティ)」という設定や、乱数によって、図の見た目が変わることもあります。
主成分分析とt-SNEのちがい
では、同じように次元を圧縮する手法である、主成分分析とt-SNEは何がちがうのでしょうか?
| 主成分分析(PCA) | t-SNE | |
|---|---|---|
| 縮め方 | 線形(ばらつきが最大の方向に写す) | 非線形(近いデータどうしの関係を保つ) |
| 保つもの | データ全体の構造 | 近いデータどうしの関係(局所構造) |
| 縮めたあと | 特徴量として、モデルに入れて使える | 見るためのもの(可視化専用) |
| 軸の意味 | 読み取れる(第1主成分など) | 意味はない |
| 計算の速さ | とても速い | データが多いと時間がかかる |
| 主な使い道 | 前処理、特徴量を減らして計算コストを抑える | クラスタの分かれ方の確認、レポート用の図、異常な点を直感的に探す |
主成分分析は、全体の構造を保ちたい、次元削減したあとも特徴量として使いたい、といったニーズを満たす手法です。
そのため、モデルに入力する特徴量を減らして計算コストを抑える、前処理としてよく使われます。
一方でt-SNEは、「クラスタがきれいに分かれているかを見たい」といったニーズを満たす、可視化専用の手法です。
実際に、手書き数字の画像(8×8ピクセル=64次元)1,797枚を、それぞれの手法で2次元にしてみました。
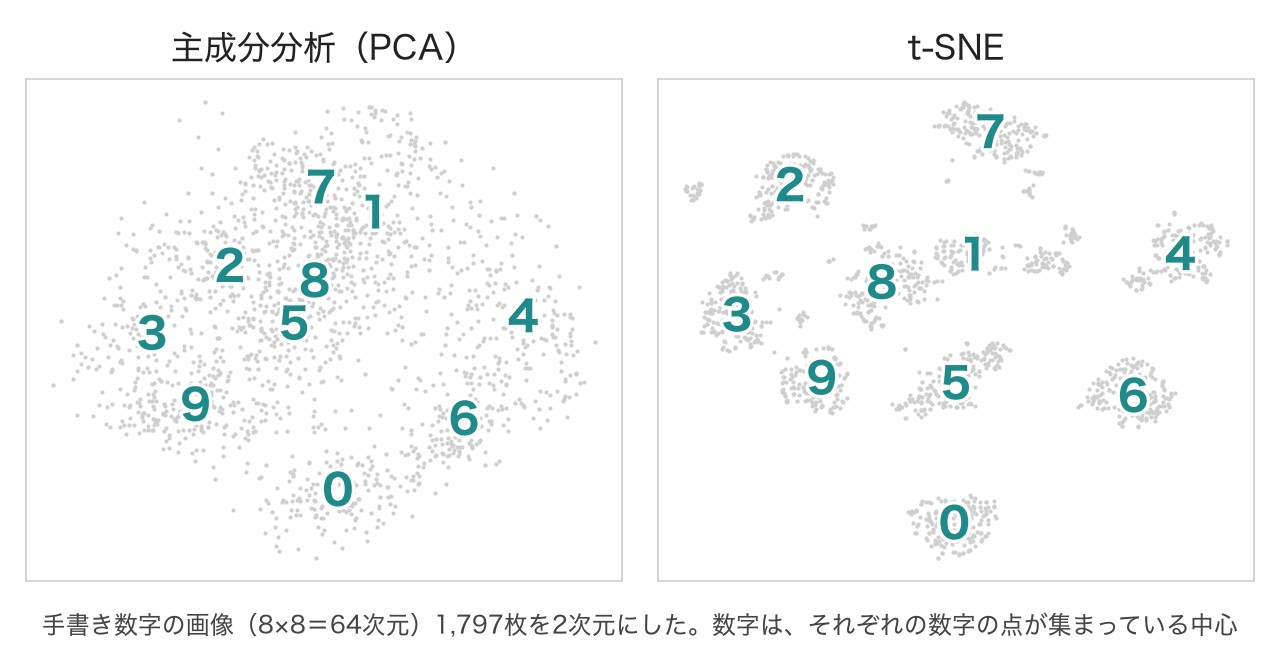
主成分分析では、数字どうしがかなり重なり合っています。実は、この2本の軸で表せているのは、元のばらつきの3割弱しかないんです。
一方、t-SNEでは、0〜9の数字ごとに、はっきりと島に分かれていますね。
どちらの手法にも、正解の数字は教えていません。それでもt-SNEでは、似た画像どうしが近くに集まって、自然と島ができるんです!
一言で言うと、主成分分析は「圧縮」、t-SNEは「可視化」というイメージです。
t-SNEは、分析に使うためのものではなく、理解するためのもの。実務では、目的に合わせて使い分けましょう。
ちなみに、t-SNEと同じく可視化によく使われる手法に「UMAP(ユーマップ)」もあります。t-SNEより計算が速く、大きなデータでも扱いやすいのが特長です。
次元削減が使われる場面
それでは、次元削減が実際にどんな場面で使われるのかを見ておきましょう。
次元削減は、多くの分野で使われています。
| 分野 | 次元削減の使い方 |
|---|---|
| 画像認識 | ピクセルの数が多すぎるので、圧縮して扱いやすくする |
| 音声分析 | 音のデータから、大事な周波数の成分(スペクトル成分)を取り出す |
| マーケティング分析 | たくさんあるお客さんの特徴量を整理して、タイプ分けや可視化をする |
| 自然言語処理 | 文章を表す埋め込みベクトル(数百〜数千次元)を圧縮・可視化する |
特に最近は、AIで文章や画像をベクトル(埋め込み)にすることが増え、数百〜数千次元のデータを扱う機会がぐっと増えました。
文章をベクトルにする方法については、以下の記事で解説しています。
 OpenAIのEmbeddings APIを使って文章の類似度算出をPythonで実装!当サイト【スタビジ】の本記事では、OpenAIのEmbedding APIについての解説と実際にPythonでEmbeddingAPIを使ってテキストの類似度を測るデモを実装していきます。Embedding APIを使うことで非常に安価に高精度の自然言語処理プログラムが作れるのでぜひ理解しておきましょう!
このように、次元削減は、さまざまな機械学習の前処理として、標準的なプロセスになっているんです!
Pythonで次元削減を試してみよう
最後に、Pythonで次元削減を試してみましょう。
先ほどの手書き数字のデータは、scikit-learnに最初から入っています。主成分分析とt-SNEで、それぞれ2次元にしてみます。
from sklearn.datasets import load_digits
from sklearn.decomposition import PCA
from sklearn.manifold import TSNE

digits = load_digits()
X, y = digits.data, digits.target
print(X.shape)  # (画像の枚数, 次元の数)

# 主成分分析(PCA)で2次元に
pca = PCA(n_components=2)
X_pca = pca.fit_transform(X)
print(X_pca.shape)
print(pca.explained_variance_ratio_.sum())  # 2つの軸で元のばらつきの何割を表せたか

# t-SNEで2次元に
tsne = TSNE(n_components=2, random_state=0)
X_tsne = tsne.fit_transform(X)
print(X_tsne.shape)
(1797, 64)
(1797, 2)
0.2850936482369929
(1797, 2)64次元のデータが、どちらも2次元になりました。主成分分析の2つの軸で表せたばらつきは、約28.5%です。
前処理として主成分分析を使うときは、「元のばらつきを何%残すか」で次元の数を決めることもできます。
from sklearn.datasets import load_digits
from sklearn.decomposition import PCA

X = load_digits().data
pca = PCA(n_components=0.9)  # 元のばらつきの90%を残せるだけの軸を使う
X_small = pca.fit_transform(X)
print(X.shape, "→", X_small.shape)
(1797, 64) → (1797, 21)64次元のデータが、ばらつきの90%を残したまま、21次元まで小さくなりました!
次元削減のまとめ
最後に、今回のポイントをおさらいしましょう!
ウマたんデータの次元が増え続ける今の時代、次元削減は必須の知識です!まずは主成分分析とt-SNEのちがいを押さえて、目的に合わせて使い分けられるようになりましょう!
主成分分析などの多変量解析や機械学習を体系的に学びたいのであれば、当メディアが運営するスクール「スタアカ」がオススメです!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる