OpenAIのEmbeddings APIを使って文章の類似度算出をPythonで実装!

目次
 ウマたん
当サイト【スタビジ】の本記事では、OpenAIのEmbeddings APIについての解説と実際にPythonでEmbeddingsAPIを使ってテキストの類似度を測るデモを実装していきます。Embeddings APIを使うことで非常に安価に高精度の自然言語処理プログラムが作れるのでぜひ理解しておきましょう!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
この記事ではOpenAIのEmbeddings APIについてどんなことができるか実装例とともに見ていきたいと思います!
OpenAIのEmbeddings APIとは?
EmbeddingsAPIの概要について解説したOpenAIのページが以下です。
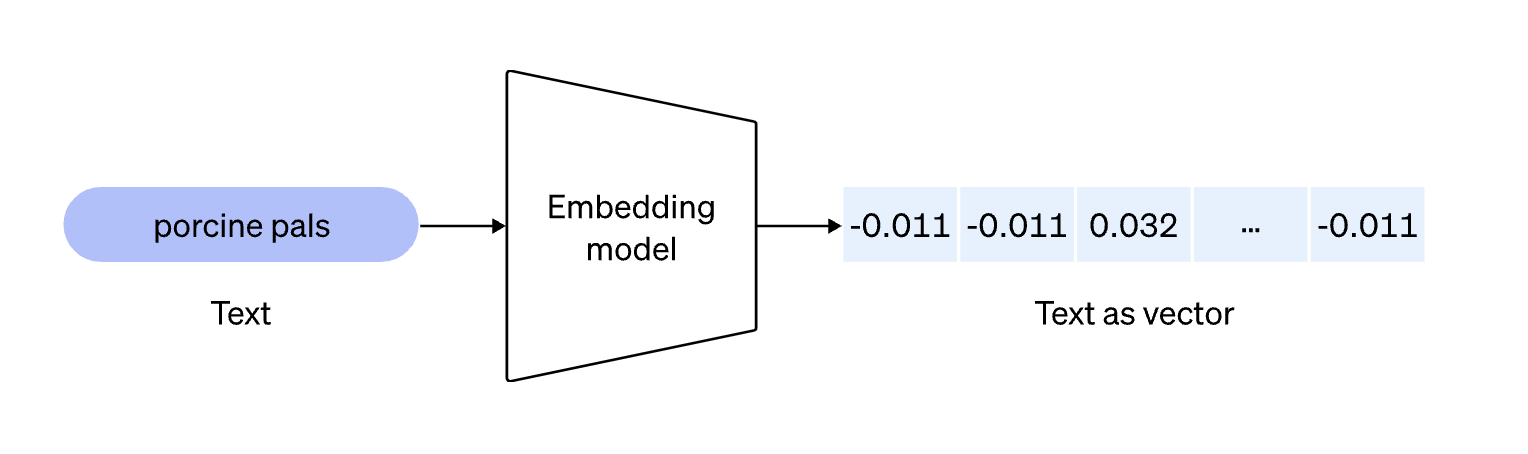
OpenAIのEmbeddings APIを使うと文章をベクトルに変換することができます。
Embeddingsは以下のようなイメージ
このベクトル化というのはOpenAIがEmbeddingsAPIを公開する前から存在し自然言語処理の分野では一般的な手法です。
ただそれを実装するには容量重めの辞書を用意しなくちゃいけなかったり色々面倒なのですが、OpenAIのEmbeddingsAPIを利用するだけで長文も簡単に安価にベクトル化できるのです!
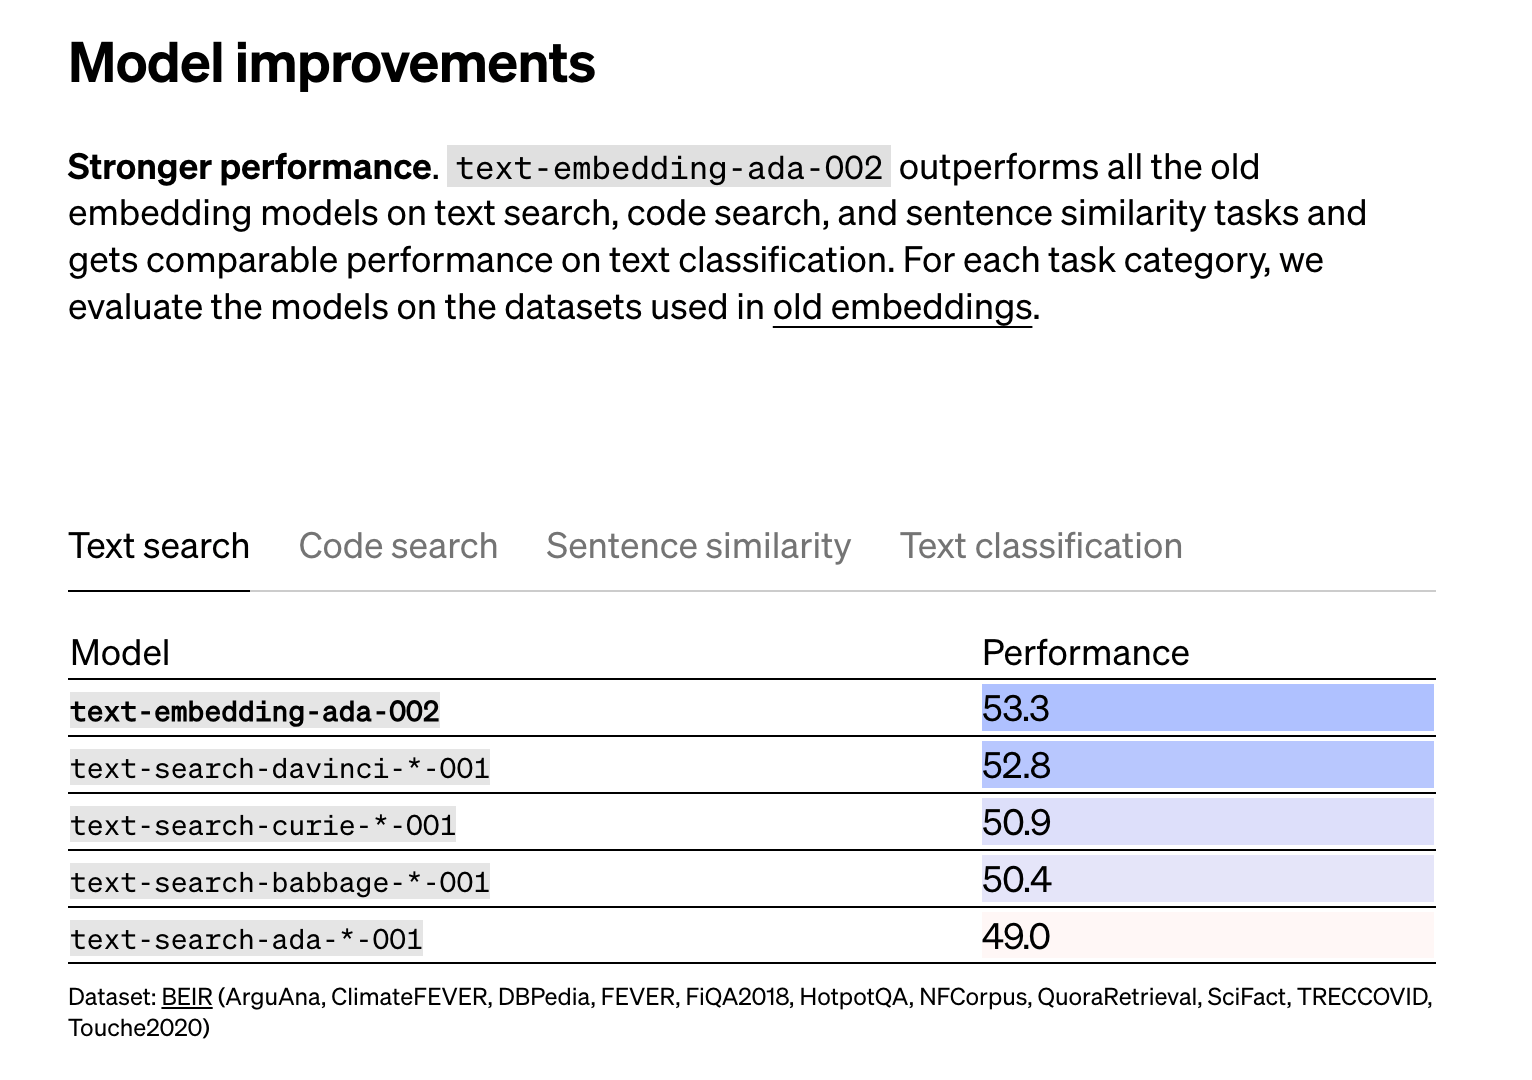
そして精度もOpenAIのEmbeddingsは高いと言われています。
実際に、いくつかの指標で検証した結果が先ほどの公式アナウンスに載っているので是非チェックしてみてください。
OpenAIのEmbeddings APIをPythonで使って類似度を算出してみよう!
それでは早速そんなOpenAIのEmbeddings APIを利用して類似度を算出してみましょう!
ウマたん簡単に実装できるので最後まで付いてきてね!
まず、必要なライブラリをインポートしてOpenAIのAPIキーを記述していきます。
OpenAIのAPIキーを取得していない人は公式サイトから取得しましょう。
from openai import OpenAI
import numpy as np

client = OpenAI(api_key="<OpenAIのAPIキー>")

# 文章どうしのCos類似度を計算する関数
def cosine_similarity(a, b):
    return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))
続いて文章をベクトル化していきます!
以下のように記述してください。
def text_to_embedding(text):
    response = client.embeddings.create(
        model="text-embedding-3-small",
        input=[text]
    )

    return response.data[0].embedding
ここでは、”text-embedding-3-small″というモデルを指定して文章をベクトル化し返してくれる関数を定義しています。
それでは、文章をベクトル化していきましょう!
texts = ["吾輩は猫である", "私は猫です", "データサイエンスが好きです"]

embeddings = []
for text in texts:
  embeddings.append(text_to_embedding(text))
これらの文章は何でも問題ありません。
1つ目と2つ目が類似度が高くなることを想定しています。
類似度はCos類似度という指標を使って計算していきます。
Cos類似度は簡単に言うと、それぞれのベクトルがどれくらい同じ方向を向いているかを表したもの。
単語ベクトルにCos類似度を当てはめることで文書の類似度を算出することが出来るのです!
、の時、Cos類似度は以下のような式で求めます!
これは、高校数学で習うCosとベクトルの関係式そのままです。
先ほどの単語ベクトル
を当てはめて見ると計算してみると、0.5477となりました。
Pythonであれば以下のように計算できますし、
import math

0.75/(math.sqrt(1.5)*math.sqrt(1.25))
25.5/(math.sqrt(26.5)*math.sqrt(26))
関数を作って以下のように計算してもよしです。
import numpy as np

def cos_sim(v1, v2):
    return np.dot(v1, v2) / (np.linalg.norm(v1) * np.linalg.norm(v2))

v1 = [ 1 , 0.5, 0.5]
v2 = [0, 0.5, 1]
cos_sim(v1, v2)
ここでは、最初に定義しておいたcosine_similarityという関数を使っていきます!(以前はOpenAIのライブラリにも同じ名前の関数が用意されていましたが、今のライブラリにはないので自分で定義しています)
まずは、1つ目と2つ目を比較してみましょう!
cosine_similarity(embeddings[0], embeddings[ 1 ])結果は約0.95となりました。
続いて、2つ目と3つ目を比較してみましょう!
cosine_similarity(embeddings[ 1 ], embeddings[ 2 ])結果は約0.82となりました。
想定どおり、1つ目と2つ目の類似度が非常に高い2つ目と3つ目の類似度はそれよりだいぶ低い結果になりました。
※上の数値は、記事を書いた当時のモデル(text-embedding-ada-002)で計算したものです。今のモデル(text-embedding-3-small)では類似度の値の大きさが変わります。
OpenAIの公式APIドキュメントは以下になりますので参考にしてみてください!
OpenAIのEmbeddings API まとめ
ここまでで、OpenAIのEmbeddings APIを利用して文章の類似度をベクトル化する方法についてまとめてきました!
最近話題の生成系AIやLLMの実装方法についてより詳しくは当メディアが運営するスタアカの以下のコースを是非チェックしてみてください!
GPTモデルをはじめとした大規模言語モデルの理論やPythonでの扱い方などを幅広く学んでいきます!
スタアカは業界最安級のAIデータサイエンススクールです。
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
AIデータサイエンスを学んで市場価値の高い人材になりましょう!
データサイエンスやAIの勉強方法は以下の記事でまとめています。
 【5分で分かる】データサイエンティストに必要なスキルと独学勉強ロードマップ!当サイト【スタビジ】の本記事では、データサイエンティストに求められるスキルとそれを身に付けるための勉強法について徹底的にまとめていきます!入門者でも、しっかりデータサイエンティストについて理解しある程度独学で駆け出しの状態までいけることを目指します。
 【これだけ!】AI(人工知能)の勉強ロードマップを徹底的に解説!当サイト【スタビジ】の本記事では、AIを勉強するロードマップについて徹底的に解説していきます。まずは、AIの概要について理解して統計学の基本知識・機械学習の基本知識・Pythonでの実装・インフラ周りの知識などを包括的に理解していきましょう!
PythonでのAPIを開発にFastAPIを使った方法を以下の記事でまとめています。
 【入門】PythonのFastAPIの使い方についてわかりやすく解説!当サイト【スタビジ】の本記事では、FastAPIの使い方を解説していきます!FastAPIはPythonでWeb APIを構築するためのフレームワーク!実際にFastAPIを触りながら使い方をマスターしていきましょう!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「大規模言語モデル(LLM)・生成系AI」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。