ランダムフォレスト(random forest)とは?PythonとRで実装してみよう!

目次
 ウマたん
当サイト【スタビジ】の本記事では、決定木をアンサンブル学習することにより汎化能力を高めた強力な機械学習手法「ランダムフォレスト」について見ていきましょう!アルゴリズムを確認した後にRでもPythonでも実装をおこなっていきますよー!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
汎化能力の非常に高いかつ簡易的に実装可能なランダムフォレストについてみていきましょう!
今でこそディープラーニングやXGboostなどの台頭により日の目を見なくなりましたが、依然としてパッケージで簡単に実装でき相当良い精度をたたき出す最強手法であることには変わりありません。
ウマたんランダムフォレストは機械学習手法の中でも非常に優秀なイメージがあるよ!学生時代は非常にお世話になったなー!
 ロボたん
ランダムフォレストについて詳しく見ていきその特徴を学んでいこう!そしてRとPythonで実装していこう!
さて、ランダムフォレストとは一体どんな手法なのでしょうか?
以下の動画でも解説をしていますよー!

ランダムフォレストとは
まず、ランダムフォレストについてまとめられた海外の論文から引用してみましょう!
Random forests are a combination of tree predictors such that each tree depends on the values of a random vector sampled independently and with the same distribution for all trees in the forest.
引用元:Google-“Random Forests”
ランダムフォレストとはざっくり言うと、
「決定木をたくさん集めて合体させた手法」
です。
決定木に関しては「決定木」を見てください。詳しくまとめています。
決定木は単体だとそれほど強い手法ではありません。
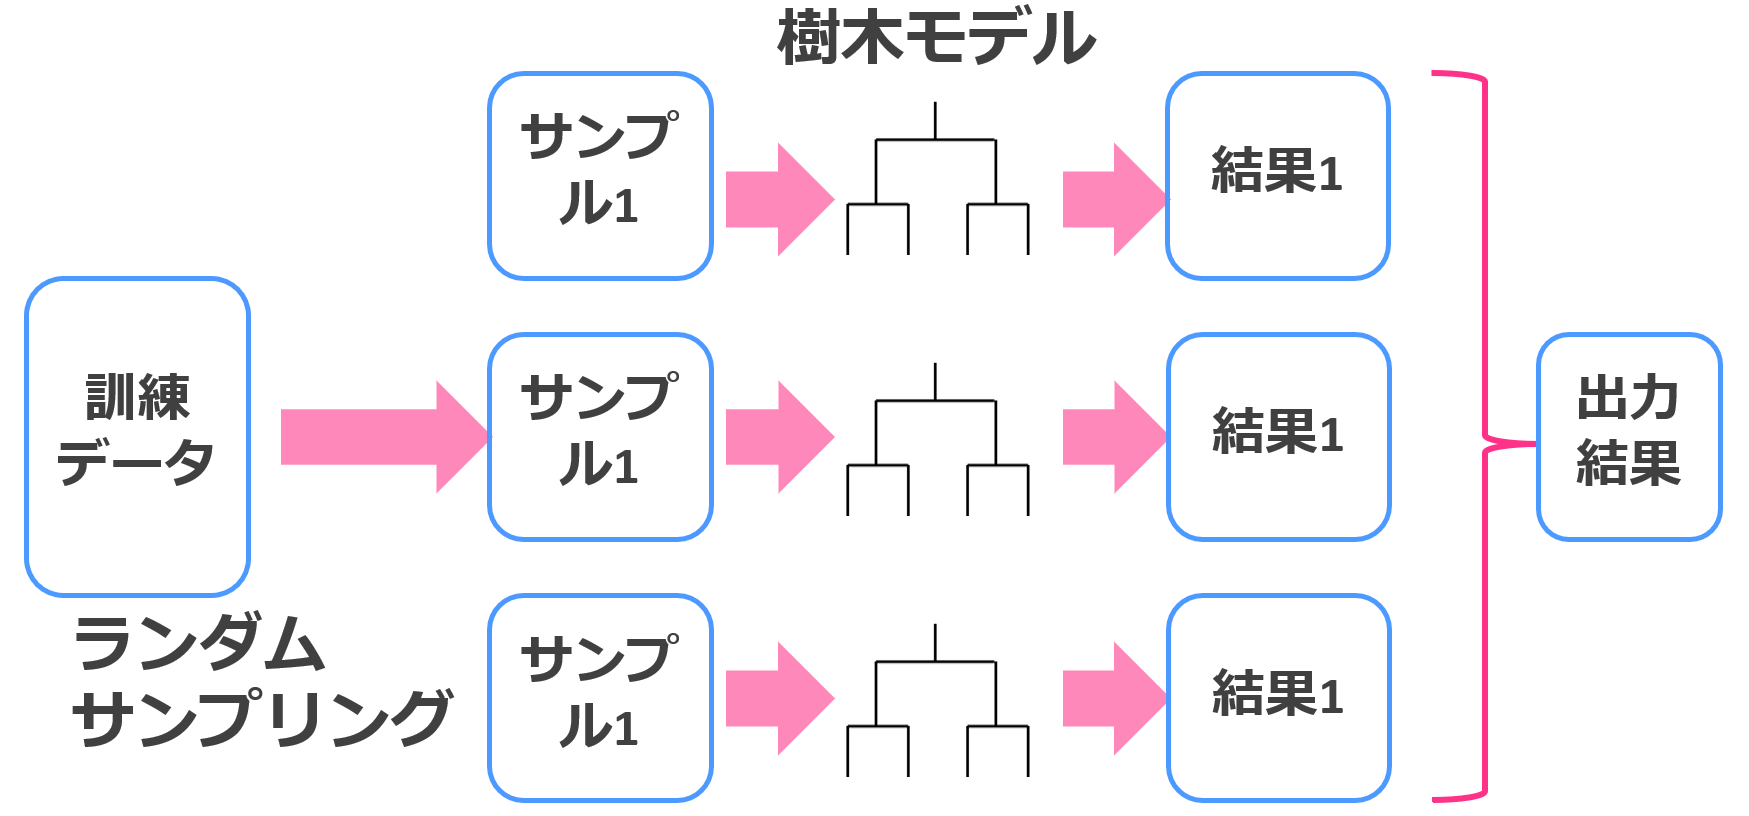
しかし、その決定木をバギングと呼ばれる集団学習法(アンサンブル学習)を用いてたくさん集めてくると最強のランダムフォレストが出来上がるんです。
アンサンブル学習法は、決して精度が高いとはいえない弱いモデルをたくさん構築し、これらの予測結果を統合することで高い精度を出す方法論です。
 アンサンブル学習とは?バギングとブースティングとスタッキングの違いと注意点当サイト【スタビジ】の本記事では、アンサンブル学習についてまとめていきます!加えて学習手法のバギング、ブースティング、スタッキングについても紹介します。アンサンブル学習とは機械学習を学ぶ上で非常に重要な考えであり、いくつかのモデルを組み合わせて汎化能力を上げるもの。有名なランダムフォレストやXgboostなどもアンサンブル学習によって生み出されているんです!
ランダムフォレストのイメージはこんな感じ。
なんでもかんでもバギングすれば良くなるわけじゃないことは注意しておきましょう!
それでは、次に具体的なアルゴリズムを見ていきます
ランダムフォレストのアルゴリズム
アルゴリズムについては、機械学習の教本として有名な「はじめてのパターン認識」から引用していきます!
非常に有名で他の機械学習手法についてもしっかり学べるので興味があれば見てみてください!

- データセットからN個のブートストラップサンプルを作成する。
- ブートストラップサンプルの中から分岐に用いる変数をM個ランダムサンプリングし、決定木を作成する。
- 1~2を繰り返す。
- 量産された決定木に対して、予測したいデータを入力する。
- 全ての結果を統合(回帰の問題では平均、分類の問題では多数決)して、1つの予測結果として出力する。
引用元:「はじめてのパターン認識」
ランダムサンプリングする変数の数Mはユーザが自由に設定することができますが、一般的には変数の数の正の平方根を取ることが多いです。
ランダムフォレストはどんな時に使える?
ランダムフォレストのアルゴリズム自体はそれほど複雑ではありませんが、決定木を弱学習器として用いており結果を解釈するのにはそれほど向いていません。
精度と解釈容易性は比較的トレードオフの関係にあるため、解釈容易性を求めるなら決定木を用いたほうが良いです。
ウマたん実務の現場では意外と単純な決定木の方が好んで使用されるよね!
ロボたんそうそう!解釈と予測の違いを明確にして手法を使い分けていったほうがいいね!以下の記事も参考にしてみてね!
 機械学習と統計学/多変量解析の違いについてデータサイエンティストがモノ申す!!当サイト【スタビジ】の本記事では、データサイエンスの領域の機械学習と統計学の違いについて考察していきます。定義と境界が曖昧な2つの領域ですが、目的の違いを理解しておくことが大事。機械学習は予測精度を上げることを目的とし統計学はデータ構造の把握をすることを目的とします。
精度を徹底的に求めるならランダムフォレストなどの機械学習手法を使いましょう!
無論、XGboostやLight gbmなどの勾配ブースティング木が強いことは言うまでもありませんが笑
ちなみにランダムフォレストでも、変数重要度を算出することができどの変数が寄与しているのかを可視化することは可能です。
ランダムフォレストをPythonで実装してみよう!
それでは早速、Pythonでランダムフォレストを実装していきます。
データ分析コンペ Nishikaの「中古マンション価格予測」というトレーニングコンペのデータに対してランダムフォレストを実装してみたいと思います。
まず Nishikaに会員登録をして中古マンション価格予測のデータから学習データとテストデータをダウンロードしてローカルのフォルダに入れておきましょうー!(※会員登録をしないとデータをダウンロードできません)。
学習データには複数CSVが入っているので、それらをglobで結合させてデータフレーム化していきます。
globは、ディレクトリに格納されたファイル名を抽出するのに便利なライブラリです。
 【5分で分かる】コード付きで解説!Pythonのglobの使い方まとめ!本記事では、Pythonでファイル取得に便利なライブラリ”glob”の使い方について見ていきます!大量のデータファイルを扱うデータ分析の場面で利用することが多いので、ぜひ使いこなせるようになりましょう!
コードは以下!
import glob
import pandas as pd
import numpy as np
import category_encoders as ce
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import r2_score

files = glob.glob("train/*.csv")
data_list = []
for file in files:
    data_list.append(pd.read_csv(file, index_col=0))
df = pd.concat(data_list)

def data_pre(df):
    nonnull_list = []
    for col in df.columns:
        nonnull = df[col].count()
        if nonnull == 0:
            nonnull_list.append(col)
    df = df.drop(nonnull_list, axis=1)

    df = df.drop("市区町村名", axis=1)

    df = df.drop("種類", axis=1)

    dis = {
        "30分?60分":45,
        "1H?1H30":75,
        "2H?":120,
        "1H30?2H":105
    }
    df["最寄駅:距離(分)"] = df["最寄駅:距離(分)"].replace(dis).astype(float)

    df["面積(㎡)"] = df["面積(㎡)"].replace("2000㎡以上", 2000).astype(float)


    y_list = {}
    for i in df["建築年"].value_counts().keys():
        if "平成" in i:
            num = float(i.split("平成")[1].split("年")[0])
            year = 33 - num
        if "令和" in i:
            num = float(i.split("令和")[1].split("年")[0])
            year = 3 - num
        if "昭和" in i:
            num = float(i.split("昭和")[1].split("年")[0])
            year = 96 - num
        y_list[i] = year
    y_list["戦前"] = 76
    df["建築年"] = df["建築年"].replace(y_list)

    year = {
        "年第1四半期": ".25",
        "年第2四半期": ".50",
        "年第3四半期": ".75",
        "年第4四半期": ".99"
    }
    year_list = {}
    for i in df["取引時点"].value_counts().keys():
        for k, j in year.items():
            if k in i:
                year_rep = i.replace(k, j)
        year_list[i] = year_rep
    df["取引時点"] = df["取引時点"].replace(year_list).astype(float)

    cols = ["都道府県名", "地区名", "最寄駅:名称", "間取り", "建物の構造", "用途", "今後の利用目的", "都市計画", "改装", "取引の事情等"]
    ce_df = ce.OrdinalEncoder(cols=cols, handle_unknown='impute')
    df = ce_df.fit_transform(df)

    return df

df = data_pre(df)
df = df.dropna()

df_train, df_val =train_test_split(df, test_size=0.2)

col = "取引価格(総額)_log"
train_y = df_train[col]
train_x = df_train.drop(col, axis=1)

val_y = df_val[col]
val_x = df_val.drop(col, axis=1)

model = RandomForestRegressor(n_estimators=100)
model.fit(train_x, train_y.values)

pre = model.predict(val_x)
r2_score(val_y, pre)
そのあと一部カラムに関しては分析しやすいように加工していきます。
そしてランダムフォレストを以下の部分で実装しています。
model = RandomForestRegressor(n_estimators=100)
model.fit(train_x, train_y.values)

pre = model.predict(val_x)
r2_score(val_y, pre)
ここでは評価指標に決定係数を使っています。
結果は0.853となりました!
それなりの精度。
ランダムフォレストをRで実装してみよう!
それでは続いてランダムフォレストを使ってRで解析を行ってみましょう!
ここで行う分析は2つ。
有名な花びらのirisデータを用いた簡単な解析とデータ解析コンペKaggleでも代表的なデータとして取り上げられているタイタニックのデータを使ったシミュレーションを何回か行う解析を行っていきます。
irisデータをランダムフォレストで分類
irisデータとはあやめの種類を分類したデータで目的変数は3カテゴリーの質的変数、説明変数は花びらの幅とか4つです。
サンプルは150個で、分類しやすいデータなのでどんな手法でも割と簡単に分類できるんですが、どうなるでしょう!
今回はランダムフォレスト以外に決定木とサポートベクターマシンとニューラルネットワークで比較しました。
library(randomForest)
library(rpart)
library(kernlab)
library(nnet)

data<-iris
ndata<-nrow(data)
ridx<-sample(ndata,ndata*0.5)
data.learn<-data[ridx,]
data.test<-data[-ridx,]

#randomforest
forest<-randomForest(Species~.,data=data.learn)
pred.forest<-predict(forest,newdata=data.test,type="class")
table(pred.forest,data.test[,5])

#決定木
cart<-rpart(Species~.,data=data.learn)
pred.cart<-predict(cart,newdata=data.test,type="class")
table(pred.cart,data.test[,5])

#svm
svm<-ksvm(Species~.,data=data.learn)
pred.svm<-predict(svm,newdata=data.test)
table(pred.svm,data.test[,5])

#nn
nn<-nnet(Species~.,data=data.learn,size=10)
pred.nn<-predict(nn,newdata=data.test,type="class")
table(pred.nn,data.test[,5])
ランダムフォレスト
 pred.forest  setosa versicolor virginica
##   setosa         29          0         0
##   versicolor      0         25         1
##   virginica       0          2        18
決定木
pred.cart    setosa versicolor virginica
##   setosa         29          0         0
##   versicolor      0         26         3
##   virginica       0          1        16
SVM
pred.svm     setosa versicolor virginica
##   setosa         29          0         0
##   versicolor      0         25         1
##   virginica       0          2        18
ニューラルネット
 pred.nn      setosa versicolor virginica
##   setosa         29          0         0
##   versicolor      0         25         2
##   virginica       0          2        17
結果はこんな感じになりました!
予想通りどれもいい感じに分類できてますね~!まあirisデータは分類しやすいので!
タイタニックでの生死予測をランダムフォレストと他の手法で比較
続いて!
タイタニックのデータを用いて解析を行っていきます。Kaggleの公式サイトからデータをダウンロードできます。
まず、データのクレンジングを行い、欠損値は削除、不要と考えられる項目は削除しました。
項目8つ
サンプル数714
この時、生死を目的変数としそれ以外を説明変数とします。
サンプル数714のうちランダムに400個のデータを取り出し学習データとし、残りの314を予測データとします。
学習データで予測モデルを作り、予測データにあてはめ真値と予測値の判別率を精度として比較します。
シミュレーション回数は10回とし、上記の手順を10回繰り返し、結果を平均したものを最終アウトプットとします。シミュレーション回数をもっと増やせば精度の信頼性は上がります。
ランダムフォレストをサポートベクターマシン、ナイーブベイズ、ニューラルネットワーク、XGboost、k近傍法の5手法と比較します!
基本的に引数は全部デフォルトで!果たして結果はどうなるでしょうか!
##様々な手法で予測精度の比較を行う##
##randomForest,SVM,ナイーブベイズ,ニューラルネット
library(xgboost)
library(caret)
library(Matrix)
library(kernlab)
library(randomForest)
library(e1071)
library(nnet)
library(ggplot2)
library(class)
titanic<-read.csv("タイタニック乗船者リスト.csv")##データの読み込み
titanic<-na.omit(titanic)##欠損値削除
titanic$Survived<-as.factor(titanic$Survived)##質的変数に変換
sim<-10##シミュレーション回数
result<-matrix(0,sim,6)##結果の箱
titanic[,4]<-as.numeric(titanic[,4])
titanic[,9]<-as.numeric(titanic[,9])

for(i in 1:sim){
  ####学習データとテストデータに分ける####
  train.id<-sample(nrow(titanic),400)
  train.data<-titanic[train.id,-1]
  test.data<-titanic[-train.id,-1]


  ##randomForest##
  rf<-randomForest(Survived~.,train.data)
  test.data.rf<-cbind(test.data,"predict"=predict(rf,test.data))
  result[i,1]<-sum(test.data.rf$predict==test.data.rf$Survived)/nrow(test.data.rf)


  ##SVM##
  svm<-ksvm(Survived~.,train.data)
  test.data.svm<-cbind(test.data,"predict"=predict(svm,test.data))
  result[i,2]<-sum(test.data.svm$predict==test.data.svm$Survived)/nrow(test.data.svm)

  ##ナイーブベイズ##
  nb<-naiveBayes(Survived~.,train.data)
  test.data.nb<-cbind(test.data,"predict"=predict(nb,test.data))
  result[i,3]<-sum(test.data.nb$predict==test.data.nb$Survived)/nrow(test.data.nb)

  ##ニューラルネット##
  nn<-nnet(Survived~.,train.data,size=5)
  test.data.nn<-cbind(test.data,"predict"=round(predict(nn,test.data),0))
  result[i,4]<-sum(test.data.nn$predict==test.data.nn$Survived)/nrow(test.data.nn)

  ##XGboost##
  label.data.train<-as.integer(train.data$Survived)-1##目的変数を01に
  label.data.predict<-as.integer(test.data$Survived)-1

  train.data.xg<-train.data[,-1]##目的変数取り除く
  test.data.xg<-test.data[,-1]

  xgb.data<-xgb.DMatrix(data.matrix(train.data.xg),label=label.data.train)##Xgb型へ成型
  xgb.data.predict<-xgb.DMatrix(data.matrix(test.data.xg))

  param <- list(
    "objective" = "binary:logistic"
    ,"eta" = 0.01
    # ,"max_depth" = 10
    ,"min_child_weight" = 5
    # ,"subsample" = 1
    # ,"colsample_bytree" = 1
  )##パラメータ適当

  model <- xgboost(
    param=param
    ,data=xgb.data
    ,nrounds=1000
  )##実際の学習

  predict_xgb<-predict(model,xgb.data.predict)

  a<-c()
  m<-length(predict_xgb)#行数

  for(l in 1:m){
    if(predict_xgb[l]>0.5){a[l]<-1}
    else{a[l]<-0}
  }
  result[i,5]<-sum(a==label.data.predict)/length(a)

  #k-nn
  knn<-knn(train.data,test.data,train.data[,"Survived"] ,prob=T,k=3)
  test.data.knn<-cbind(test.data,"predict"=knn)
  result[i,6]<-sum(test.data.knn$predict==test.data.knn$Survived)/nrow(test.data.knn)

}

result.c<-apply(result,2,mean)##simの平均値
result.c<-t(as.matrix(result.c))
result.c<-rbind(result.c,result.c)
result.c<-round(result.c,3)
##グラフ描画
colnames(result.c) <- c("RF","SVM","Bayes","NN","xgb","knn")
df<-data.frame(method=colnames(result.c),result=colMeans(result.c))
gp<-ggplot(df,aes(x=method,y=result,fill=method))
gp<-gp+geom_bar(width=0.8,stat="identity")
gp<-gp+ylab("result")
gp<-gp+geom_text(label=colMeans(result.c),vjust=1)
plot(gp)
randomForestというパッケージに入っているrandomForestという関数を用いて解析を行っていきます。
 ##randomForest##
  rf<-randomForest(Survived~.,train.data)
  test.data.rf<-cbind(test.data,"predict"=predict(rf,test.data))
  result[i,1]<-sum(test.data.rf$predict==test.data.rf$Survived)/nrow(test.data.rf)
データ加工は描画でいくつかコードを書いていますが、実際にランダムフォレストを行っているのはこの数行!
Survived~.はSurvivedを目的変数としてそれ以外を説明変数にするよーということです。
結果は以下のようになりました!
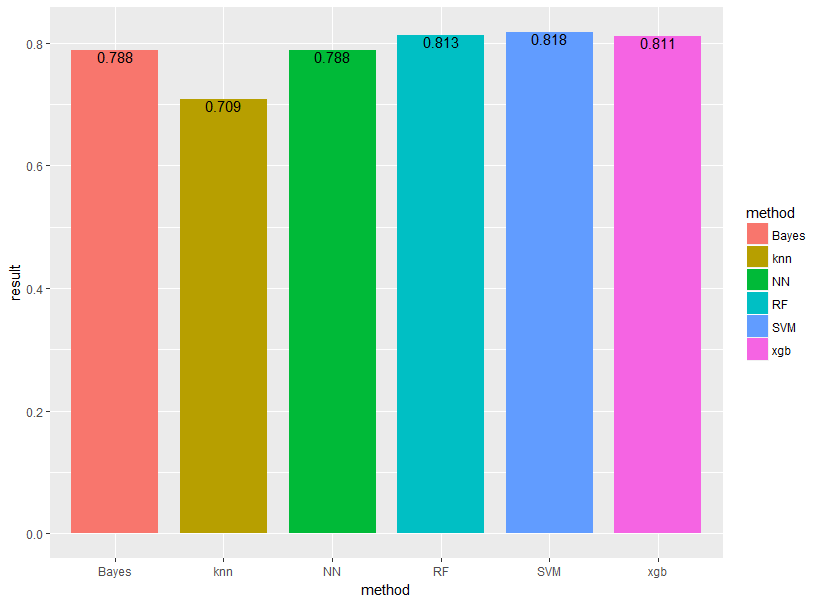
それぞれBayes(ナイーブベイズ)、knn(k近傍法)、NN(ニューラルネットワーク)、RF(ランダムフォレスト)、SVM(サポートベクターマシン)、xgb(XGboost)と表示しています。
やはりランダムフォレスト・SVM・XGboostあたりが強いですね!
ウマたんこんなに簡単に実装できて精度の高いランダムフォレストって素晴らしい!
ロボたんSVMと比較して計算負荷もそれほど高くないから時間もかからないよ!
他の手法についても是非見てみてください!
ランダムフォレスト まとめ
本記事では、ランダムフォレストについて見てきました!
簡単に実装できる割には精度が高いことが特徴です。
最後にランダムフォレストについてまとめておきましょう!
ウマたん機械学習手法の中でもかなりメジャーな手法だから、一度は自分の手で実装してみよう!
ランダムフォレストに関してもっと詳しく知りたいかたは以下の書籍を参考にしてみてください!

ちなみにランダムフォレストをはじめとした機械学習手法に関して深く勉強したい方は以下の記事を見てみてください!
 【入門】機械学習のアルゴリズム・手法をPythonとRの実装と一緒に解説!当サイト【スタビジ】の本記事では、入門者向けに機械学習についてカンタンにまとめていきます。最終的にはどのように機械学習を学んでいけばよいかも見ていきます。細かい手法の実装もPython/Rを用いておこなっていくので適宜参考にしてみてください。
 【これだけはおさえておきたい!】ビジネスで役立つAI用語45選まとめ!当サイト【スタビジ】の本記事では、ディープラーニング系/機械学習系/統計学系の3つのカテゴリに分けて重要な用語を説明していきます!
またデータサイエンスや統計学について勉強したい方は以下の記事でまとめていますのでチェックしてみてください!
 【5分で分かる】データサイエンティストに必要なスキルと独学勉強ロードマップ!当サイト【スタビジ】の本記事では、データサイエンティストに求められるスキルとそれを身に付けるための勉強法について徹底的にまとめていきます!入門者でも、しっかりデータサイエンティストについて理解しある程度独学で駆け出しの状態までいけることを目指します。
 【初心者必見】統計学入門に必要な知識と独学勉強方法を簡単に学ぼう!当ブログ【スタビジ】の本記事では、統計学入門に必要な知識をカンタンにまとめ、それらをどのように効率的に独学で勉強していけばよいかをお話ししていきます。統計学は難しいイメージが少しありますが、学び方をしっかり考えれば大丈夫!
RとPythonで実装をおこなってきましたが、機械学習手法の実装にはPythonの方がオススメ!
Pythonの学習法は以下の記事でまとめていますのでぜひチェックしてみてください!
 【Python独学勉強法】Python入門を3ヶ月で習得できる学習ロードマップ当サイト【スタビジ】の本記事では、過去僕自身がPythonを独学を駆使しながら習得した経験をもとにPythonを効率よく勉強する方法を具体的なコード付き実装例と合わせてまとめていきます。Pythonはできることが幅広いので自分のやりたいことを明確にして勉強法を選ぶことが大事です。
データサイエンスを幅広く学びたい方には当メディア運営のスクール「スタアカ」がオススメです!
ご受講お待ちしております。
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる