分散の求め方!標本分散と不偏分散の違い

目次
 ウマたん
当サイト【スタビジ】の本記事では、分散について解説していきます!分散とは「データの散らばり具合を示す」重要な指標となっています。今回は分散の定義について解説しつつ、分散のなかでも標本分散と不偏分散の違いについて解説してPythonで実装していきます!
こんにちは!
デジタルマーケター兼データサイエンティストのウマたん(@statistics1012)です!
データの傾向・性質を見る指標はたくさんありますが、「データの散らばり具合を見る」指標である分散は非常に重要です!
具体的には「データが平均からどれだけ散らばっているか」示しており、データのばらつきが大きいと分散が大きくなり、ばらつきが小さくなると分散は0に近づく特徴を持っています!
この記事では、そんな分散の解説をしながらも分散の性質を持つ標本分散と不偏分散の違いについて解説していきます。
以下の動画でも解説していますのであわせてチェックしてみてください!

分散とは?
分散とは「データのばらつきを示す指標」と定義されています。分散の値が分かることで、データの分布が予想でき、データの比較が行うことができます!
ウマたん分散の式は以下の通りに示せるよ!
=
これらの式では、がサンプルサイズ,が各サンプルごとの値、が平均値を表しています!特にを偏差と呼びます!
 ロボたん
それじゃ偏差は各サンプルの値から平均値を引いた値なんだね!
ウマたんその通り!偏差は「各サンプルの値が平均からどれだけ離れているか」を示しているんだ。そして分散は偏差の2乗平均でもあるんだ!
標本分散とは?
分散の定義を説明したので、標本分散の説明をしていきます!
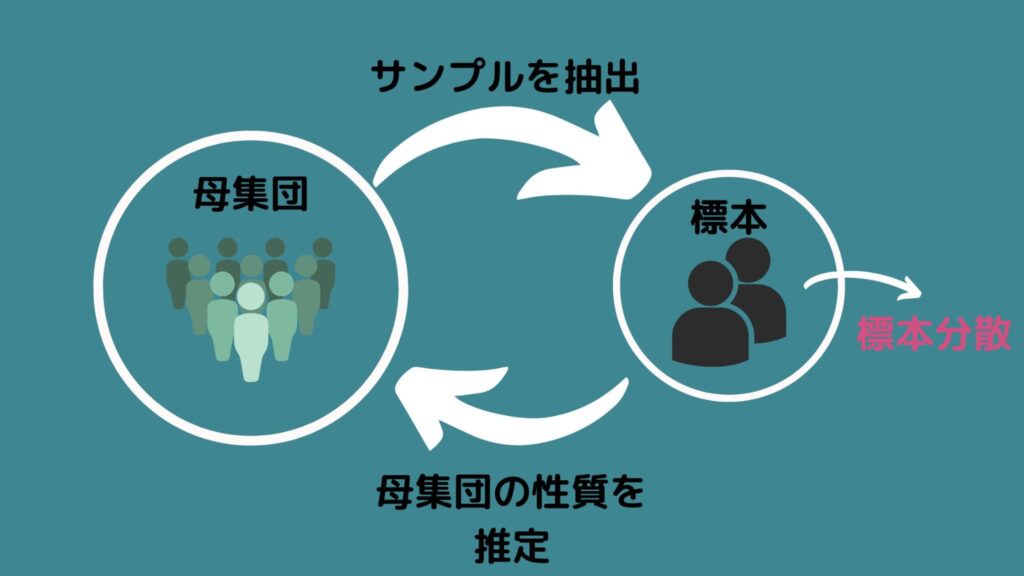
標本分散とは、「標本から計算した分散」を示しています。つまり対象の全体から一部を抽出したデータの分散を意味しています!
ウマたん標本分散の式は先程の分散の定義と同じだよ!
=
ロボたんそもそも標本をとる理由ってなんだっけ…?
ウマたん母集団が非常に大きすぎると母集団全体の観察は難しいので、母集団からいくつかのサンプル(標本)を抽出して、母集団の統計的な特徴を把握する目的があるんだ!
不偏分散とは?
次は不偏分散の説明です!
不偏分散とは、「標本が属する母集団の分散を推定した値」を示しています!
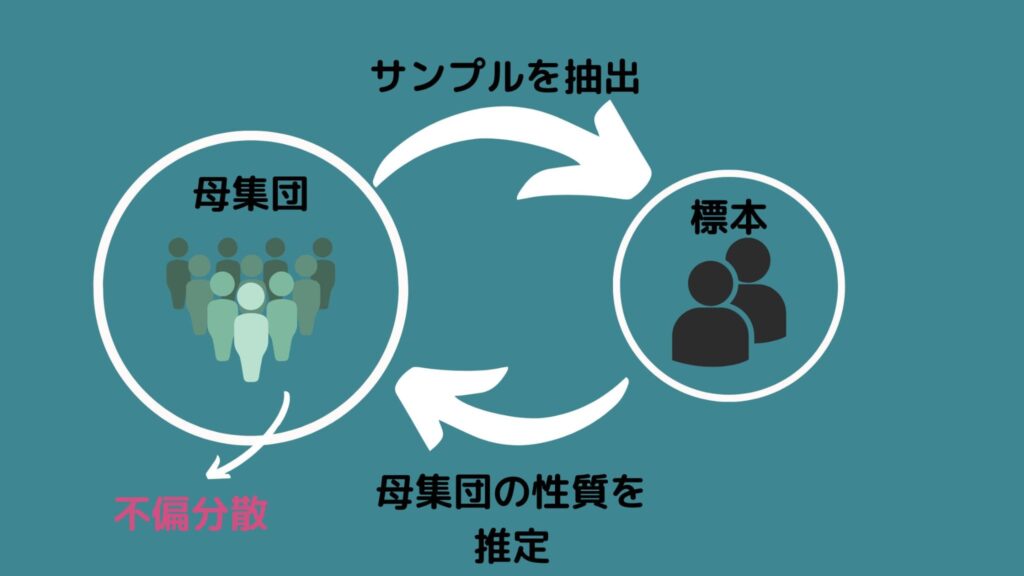
ウマたん不偏分散の式は標本分散のがに変わっているよ!
=
ロボたん不偏分散はなんでで平方和を割っているんだろう?
ウマたんそれは
推定量の期待値が母数と等しい不偏性
を持っているからなんだ!
標本分散は不偏性を持つのか?
ロボたんそれなら標本分散は不偏性をもった分散じゃないの?
ウマたんそれを実際に確かめてみよう!不偏性は以下の式が成立していればいいんだ
() =
を推定量、を母数とすると、「あるパラメータの推定量の期待値は母集団のパラメータに等しい」ということを言っています!標本から母集団のパラメータを良く推定できる強みがありますね。
そして標本分散をに代入してみましょう!
() = ( ) = )
=
=
=
=
= –
= (* = 、 = とする)
≠ なので標本分散の期待値は母分散と一致しない、つまり標本分散は不偏性を持たないことになります!
またさっきの式から、不偏分散は不偏性を持つこともわかりますね。
= = =
実際に標本分散・不偏分散をPythonで計算してみよう!
最後にPythonで標本分散・不偏分散を実装しましょう!
標本分散・不偏分散はNumpyライブラリのvar関数で算出することができます!特にvar関数はddof=Trueとすると不偏分散を算出してくれます。
問題の設定として、架空の学校にあるA組とB組のテストの平均と標本分散・不偏分散を見ることにしましょう。サンプルサイズは10人とします。
import numpy as np

#A組・B組のデータ
A = np.array([50,60,57,63,55,65,51,69,49,71])
B = np.array([30,80,40,90,25,95,32,88,27,93])

#結果
print("A組の平均:"+str(np.mean(A)))
print("B組の平均:"+str(np.mean(B)))
print("A組の標本分散:"+str(np.var(A)))
print("B組の標本分散:"+str(np.var(B)))
print("A組の不偏分散:"+str(np.var(A,ddof=True)))
print("B組の標本分散:"+str(np.var(A,ddof=True)))パッと見るとB組のデータはかなりばらついているように見える。はたして平均と標本分散・不偏分散はどうなったかな?
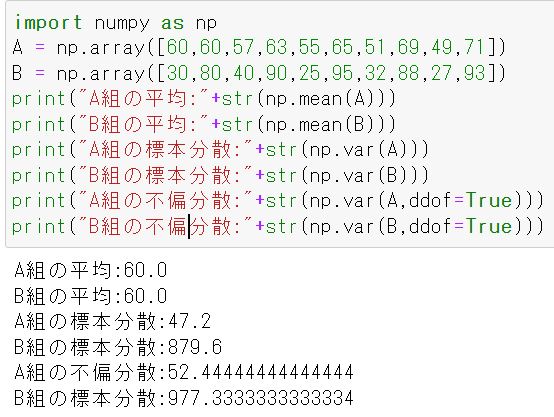
A組・B組の点数の平均は同じですが,分散に関してはB組の方が圧倒的に大きいことが分かります。つまりB組の点数のばらつきが大きいことを意味してますね!
またddof=Trueにすることでキチンと不偏分散を算出してくれていることも確認できました!
不偏分散と標本分散 まとめ
本記事では、分散の定義と標本分散・不偏分散の違いについてまとめました!
データの性質・傾向を見るために、データのばらつきを表す分散は非常に重要な指標でした。さらに分散だけでなく平均値を見たり、ヒストグラムからデータの分布を見る癖をつけると、データに対する理解が深まること間違いなしでしょう!
ウマたん基本的な統計量を見る力はとても大切だ!
そうしたデータサイエンスの力を身に付けるためにはスタビジの記事やスクールを活用すると良いでしょう。
そして僕の経験を詰め込んだデータサイエンス特化のスクール「スタアカ(スタビジアカデミー)」を運営していますので,興味のある方はぜひチェックしてみてください!
AIデータサイエンス特化スクール「スタアカ」
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
データサイエンティストとしての自分の経験をふまえてエッセンスを詰め込んだのがこちらのスタビジアカデミー、略して「スタアカ」!!
当メディアが運営するスクールです。
月額1,280円のライトプランで、統計学から機械学習・生成AIまで全コースが受講し放題です!
プレミアムプランでは、24時間以内の質問対応と現役データサイエンティストとの1on1(30分×4回)を実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
他のスクールのカリキュラムはPythonでの機械学習実装だけに焦点が当たっているものが多く、実務に即した内容になっていないものが多いです。
そんな課題感に対して、実務で使うことの多いSQLや機械学習のビジネス導入プロセスの理解などもあわせて学べるボリューム満点のコースになっています!
Pythonが初めての人でも学べるようなカリキュラムにしておりますので是非チェックしてみてください!
ウォルマートのデータを使って商品の予測分析をしたり、実務で使うことの多いGoogleプロダクトのBigQueryを使って投球分析をしたり、データサイエンティストに必要なビジネス・マーケティングの基礎を学んでマーケティングプランを作ってもらったりする盛りだくさんの内容になってます!
データサイエンスに関する記事はこちら!
 【初心者必見】統計学入門に必要な知識と独学勉強方法を簡単に学ぼう!当ブログ【スタビジ】の本記事では、統計学入門に必要な知識をカンタンにまとめ、それらをどのように効率的に独学で勉強していけばよいかをお話ししていきます。統計学は難しいイメージが少しありますが、学び方をしっかり考えれば大丈夫!
 【データサイエンティスト厳選18冊】データサイエンスを学ぶ上でオススメな本・教材!当ブログ【スタビジ】の本記事では、データサイエンスを学ぶ上でオススメできる本を厳選して紹介していきます。ここではデータサイエンティストになるために習得するスキルをデータサイエンスと称しております。いくつかの観点に切り分けて見ていきます。
データサイエンスを勉強できるスクールやサイトは、ぜひこちらを参考にしてみてください!
 【徹底比較】データサイエンティストになるための学習ができるスクール9選!当サイト【スタビジ】の本記事では、データサイエンティストへの学習ができるスクールを紹介していきます。スクールに通ったからと言ってデータサイエンティストになれるわけではありませんが、データサイエンティストへの基本を着実に固めることは可能です…
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「統計学概要」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。