Lasso(ラッソ)回帰・Ridge(リッジ)回帰を線形回帰と比較して実装してみよう!
目次
 ウマたん
本記事では、線形回帰・Lasso(ラッソ)回帰・Ridge(リッジ)回帰についてRでの実装も行いながらまとめていきます。高次元データを分析する際はぜひラッソ回帰・リッジ回帰を利用してみてくださいね!
変数が多い高次元データでは、通常の回帰分析が上手くいかない/そもそも解析不能なんてことが往々に起こります。
そんな高次元データの不都合を解決するのが「Lasso(ラッソ)回帰」や「Ridge(リッジ)回帰」!!
Lasso回帰・Ridge回帰は正則化やスパース推定と関連性が深いので、そちらを先にご覧いただけると理解が深まると思います。
 正則化正則化手法についてざっくりと説明していきます。
 スパース推定とは?理論とオススメ本を紹介!当サイト【スタビジ】の本記事では、スパース推定についてまとめていきます。スパース推定とは特定のパラメータを0と推定すること。はたしてパラメータを0と推定することでどのようなメリットがあるのでしょうか?
ウマたん
回帰分析にも色んな種類があるんだよねー!
この記事では、高次元データに対して効果を発揮する「Lasso(ラッソ)回帰」と「Ridge(リッジ)回帰」について見ていきましょう!
式や概念の説明だといまいちどんなことが起きているのかわかりにくいので実際にR言語を用いて実装していきます!
線形回帰・Lasso回帰・Ridge回帰とは
今回比較するのは、通常の線形回帰・Lasso回帰・Ridge回帰です。
簡単に、三つの手法について見ていきましょう!
通常の線形回帰
通常の線形回帰は残差が最小になるようにを推定します。
つまり、次の式を最小化するようにを推定します。
\begin{eqnarray*}
\|{\bf y}-{\bf X}{\bf \beta}\|_2^2\\
\end{eqnarray*}
 ロボたん
線形回帰は、「データの間にある関係性を見つけて、まっすぐな線で予測しちゃおう!」という感じの手法だよ。データの変数(例えば身長と体重とか)の関係を直線で表して、この線を使って新しいデータの予測をするんだ。
Ridge回帰
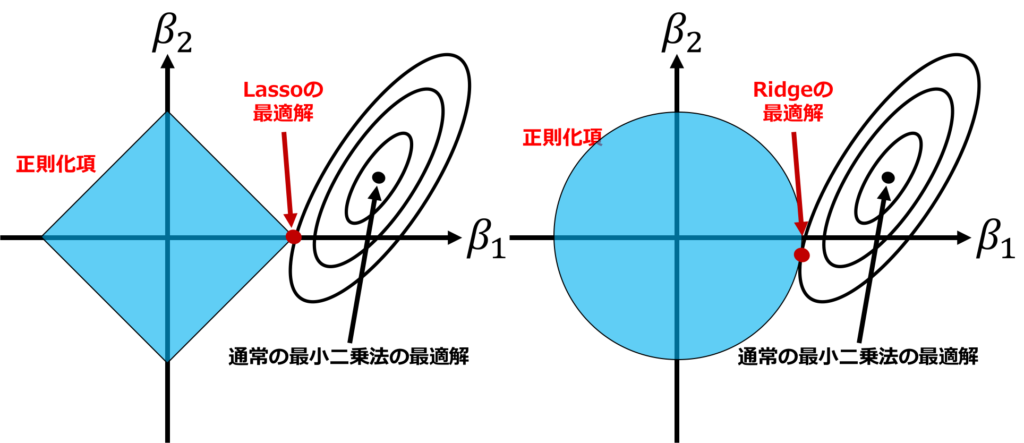
Ridge回帰は正則化手法であり、多重共線性などが起きていて通常の線形回帰ではパラメータが推定できないような場面でも罰則を与えることで推定できるようにしたものです。
ロボたん「多重共線性」についても確認しておこう!
次の式を最小化するようにを推定します。
\begin{eqnarray*}
\|{\bf y}-{\bf X}{\bf \beta}\|_2^2+\lambda\|{\bf \beta}\|_2^2\\
\end{eqnarray*}
第2項は正則化項と呼ばれ、なるべくパラメータの絶対値を小さくするような働きをします。
ここで、は正則化パラメータであり、解析者が設定するかクロスバリデーションなどで決定する必要があります。
詳しく知りたい場合、「Ridge回帰」の論文を見るとよいでしょう!
Proposed is an estimation procedure based on adding small positive quantities to the diagonal of X′X. Introduced is the ridge trace, a method for showing in two dimensions the effects of nonorthogonality.
引用:Google-“Ridge Regression: Biased Estimation for Nonorthogonal Problems”
Lasso回帰
Lasso回帰も正則化手法です。Ridge回帰とは異なりパラメータのいくつかを0に推定できるという特徴があります。
これをスパース推定と呼びます。次の式を最小化するようにを推定します。
\begin{eqnarray*}
\|{\bf y}-{\bf X}{\bf \beta}\|_2^2+\lambda\|{\bf \beta}\|_1\\
\end{eqnarray*}
今回は、線形回帰はglm()関数、LassoとRidgeはglmnetパッケージのglmnet()関数を用います。
詳しく知りたい場合、「Lasso回帰」の論文を見るとよいでしょう!
We propose a new method for estimation in linear models. the ‘lasso’ minimizes the residual sum of squares subject to the sum of the absolute value of the coefficients being less than a constant. Because of the nature of this constraint it tends to produce some coefficients that are exactly 0 and hence gives interpretable models.
引用:Google-“Regression Shrinkage and Selection via the Lasso”
Lasso回帰・Ridge回帰用の人工データ生成
今回は、実データではなく自分で発生させる人工データを扱います!
今回のデータの生成モデルを次に示します。
\begin{eqnarray*}
y_i&=&1+{\bf x}_i^T{\bf \beta}+\epsilon_i\\
{\bf \beta}&=&(1,0,-1,0,0)^T\\
{\bf x_i}&\sim& N({\bf \mu},{\bf \Sigma})\\
{\bf \mu}&=&{\bf 0}_5\\
{\bf \Sigma}&=&{\bf I}_5\\
\epsilon_i&\sim& N(0,1^2)\\
i&=&1,2,\cdots,n\\
\end{eqnarray*}
説明変数は、平均0・独立で発生させています。
また、の設定から変数2・変数4・変数5は目的変数に寄与していません。
線形回帰・Lasso回帰・Ridge回帰をRで実装
先ほど説明したデータで解析をしてみましょう!
サンプルサイズは1100とします。
100個のデータを学習データ、残りの1000個のデータをテストデータとして実験します。
それぞれ3手法で推定された回帰係数と予測誤差(MSPE;Mean Squared Prediction Error)を計算してみましょう。
library(MASS)
library(mvtnorm)
library(glmnet)

n_train <- 100
n_test <- 1000
p <- 5

β0 <- 1 ##定数項
β <- c(1,0,-1,0,0)
β <- c(β0,β)

μ <- numeric(p)
Σ <- diag(p)

σ <- 1 ##誤差標準偏差

X <- rmvnorm((n_train+n_test),μ,Σ)
X <- cbind(rep(1,(n_train+n_test)),X)
ε <- rnorm((n_train+n_test),0,σ)
y <- X%*%β+ε

data <- cbind(X,y)
data <- as.data.frame(data)
colnames(data) <- c("Int","x1","x2","x3","x4","x5","y")

##学習データとテストデータを作成
data_train <- data[1:n_train,]
data_test <- data[-(1:n_train),]

##glm(普通の線形回帰)
result_glm <- glm(formula=y~x1+x2+x3+x4+x5, data=data_train[,-1], family=gaussian(link="identity"))
##推定された回帰係数
as.matrix(result_glm$coefficients)

##glmnet(lasso)
result_lasso <- cv.glmnet(x=as.matrix(data_train[,c("x1","x2","x3","x4","x5")]), y=data_train$y, family="gaussian",alpha=1)
##推定された回帰係数
coefficients(result_lasso,s="lambda.min")

##glmnet(ridge)
result_ridge <- cv.glmnet(x=as.matrix(data_train[,c("x1","x2","x3","x4","x5")]), y=data_train$y, family="gaussian",alpha=0)
##推定された回帰係数
coefficients(result_ridge,s="lambda.min")

##予測誤差を算出
yhat_glm <- as.matrix(data_test[,colnames(data_test)!="y"])%*%as.matrix(result_glm$coefficients)
mean((data_test$y-yhat_glm)^2)

yhat_lasso <- as.matrix(data_test[,colnames(data_test)!="y"])%*%coefficients(result_lasso,s="lambda.min")
mean((data_test$y-yhat_lasso)^2)

yhat_ridge <- as.matrix(data_test[,colnames(data_test)!="y"])%*%coefficients(result_ridge,s="lambda.min")
mean((data_test$y-yhat_ridge)^2)
線形回帰・Lasso回帰・Ridge回帰の回帰係数
■通常の線形回帰で推定された回帰係数
(Intercept) 1.110727505
x1 0.862992782
x2 -0.024437489
x3 -0.757605621
x4 -0.098294387
x5 -0.008577822
■Lasso回帰で推定された回帰係数
(Intercept) 1.0713394
x1 0.7781268
x2 .
x3 -0.6778876
x4 .
x5 .
■Ridge回帰で推定された回帰係数
(Intercept) 1.08903319
x1 0.81095492
x2 -0.02288852
x3 -0.71278554
x4 -0.09335028
x5 -0.01748969
(Intercept)は定数項を表しています。
どうでしょうか、Lasso回帰は変数1と変数3以外は完全に0になっていることがわかります。
つまり、自動的に変数選択ができました!これは嬉しいですね!
ウマたん「.」と書いてあるところは0と推定されているよ!
回帰係数の2乗和を比較
また、推定された回帰係数の2乗和を計算すると次のようになりました。
■通常の線形回帰
> sum(as.matrix(result_glm$coefficients)^2)
2.562771
■Lasso
> sum(coefficients(result_lasso,s=”lambda.min”)^2)
2.212781
■Ridge
> sum(coefficients(result_ridge,s=”lambda.min”)^2)
2.361248
やはり、通常の線形回帰と比較して小さくなっています。
MSPEを比較
最後に、MSPEを比較します。
※MSPEは、Mean square prediction errorで予測値と観測値の差の二乗平均を取った値です。
■通常の線形回帰
> mean((data_test$y-yhat_glm)^2)
1.119285
■Lasso
> mean((data_test$y-yhat_lasso)^2)
1.171355
■Ridge
> mean((data_test$y-yhat_ridge)^2)
1.153019
最も良いのは通常の線形回帰になりました。
これはサンプルをたくさんあって、説明変数に相関もなく多重共線性が起きていないから当たり前ですね!
もっと、変数を増やしてみたりするとLassoやRidgeがMSPEで勝つこともあるでしょう。
ちなみに、このプログラムでは一回の計算なので結果の信頼性には欠けます。
そのため、続いてシミュレーションを何回か行って精度を検証していきましょう!
線形回帰・Lasso回帰・Ridge回帰の精度をシミュレーションで比較
どの手法が良いか・どのモデルが良いかを比較する為にはシミュレーションを繰り返して、指標の平均やばらつきをみて判断することが大切です。
たった一回の結果では本当に差があるのか偶然なのか信頼性に欠けるからです。
今回は線形回帰モデルの人工データを用いて線形回帰・Lasso・Ridgeの精度比較を行います。
実験の設定と手順
実験の流れは簡単にこんな感じです。
- 人工データを生成
- データを解析
- 指標を算出して結果を格納
- 1~3を100回繰り返す
- 結果の平均とばらつきで比較
人工データ生成
今回のデータの生成モデルを次に示します。
\begin{eqnarray*}
y_i&=&1+{\bf x}_i^T{\bf \beta}+\epsilon_i\\
{\bf \beta}&=&(1,-1,0,\cdots,0)^T\in {\bf R}^p\\
{\bf x_i}&\sim& N({\bf \mu},{\bf \Sigma})\\
{\bf \mu}&=&{\bf 0}_p\\
{\bf \Sigma}&=&{\bf I}_p\\
\epsilon_i&\sim& N(0,1^2)\\
i&=&1,2,\cdots,n\\
\end{eqnarray*}
説明変数は次元であり、平均0・独立で発生させています。
また、はp次元ベクトルであり、変数1と変数2のみが目的変数へ寄与があります。
つまり、かなりスパースな設定になっています。
今回は、を5,10,50と変化させて実験してみます。
シミュレーション実験
シミュレーション実験をしてみましょう。
サンプルサイズは1100とします。
100個のデータを学習データ、残りの1000個のデータをテストデータとして実験します。
今回用いるコード(の場合)を載せておきます。
実行する前に入っていないパッケージはインストールしておいてください。
library(MASS)
library(mvtnorm)
library(glmnet)
library(ggplot2)
library(tidyr)

times <- 100 ##シミュレーション回数

n_train <- 100
n_test <- 1000
p <- 50 #変化させて実験

β0 <- 1 ##定数項
β <- c(1,-1,numeric(p-2))
β <- c(β0,β)

μ <- numeric(p)
Σ <- diag(p)

σ <- 1 ##誤差標準偏差

MSPE <- data.frame(glm=numeric(times)+NaN, lasso=numeric(times)+NaN, ridge=numeric(times)+NaN)

for(t in 1:times){
  X <- rmvnorm((n_train+n_test),μ,Σ)
  X <- cbind(rep(1,(n_train+n_test)),X)
  ε <- rnorm((n_train+n_test),0,σ)
  y <- X%*%β+ε

  data <- cbind(X,y)
  data <- as.data.frame(data)
  colnames(data) <- c("Int",paste0('x', 1:p),"y")

  ##学習データとテストデータを作成
  data_train <- data[1:n_train,]
  data_test <- data[-(1:n_train),]

  ##glm(普通の線形回帰)
  result_glm <- glm(formula=y~., data=data_train[,colnames(data_train)!="Int"], family=gaussian(link="identity"))

  ##glmnet(lasso)
  result_lasso <- cv.glmnet(x=as.matrix(data_train[,!(colnames(data_train) %in% c("Int","y"))]),
                            y=data_train$y, family="gaussian",alpha=1)

  ##glmnet(ridge)
  result_ridge <- cv.glmnet(x=as.matrix(data_train[,!(colnames(data_train) %in% c("Int","y"))]),
                            y=data_train$y, family="gaussian",alpha=0)

  ##予測誤差を算出
  yhat_glm <- as.matrix(data_test[,colnames(data_test)!="y"])%*%as.matrix(result_glm$coefficients)
  MSPE$glm[t] <- mean((data_test$y-yhat_glm)^2)

  yhat_lasso <- as.matrix(data_test[,colnames(data_test)!="y"])%*%coefficients(result_lasso,s="lambda.min")
  MSPE$lasso[t] <- mean((data_test$y-yhat_lasso)^2)

  yhat_ridge <- as.matrix(data_test[,colnames(data_test)!="y"])%*%coefficients(result_ridge,s="lambda.min")
  MSPE$ridge[t] <- mean((data_test$y-yhat_ridge)^2)
  cat("t=",t," ")
}

##ggplotで箱ひげ図を描く
g <- ggplot(gather(MSPE), aes(y=value,x=key))
g <- g + geom_boxplot()
g <- g + xlab("Method")
g <- g + ylab("MSPE")

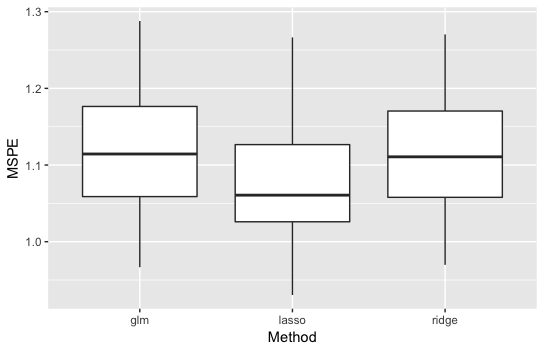
plot(g)ばらつきも含めて見たいので結果を箱ひげ図で表します。
通常の線形回帰はglmと表記してあります。
・の結果
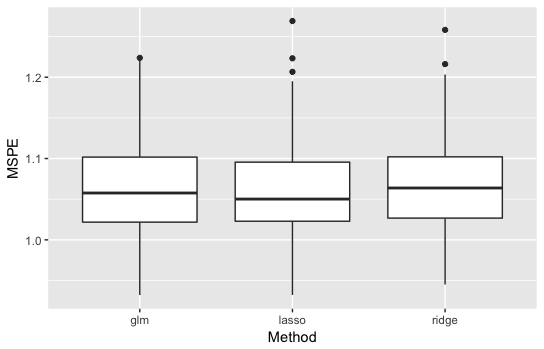
説明変数の数も多くないのであまり手法の差は見えません。
・の結果
通常の線形回帰とRidgeは同じくらいですが、Lassoが良い精度を示しています。
説明変数が多くなってスパース性が上がったことが原因でしょう。
・の結果
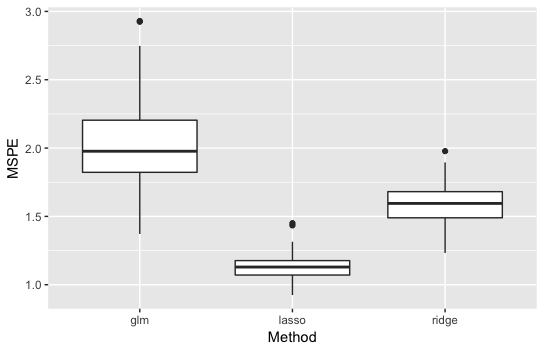
通常の線形回帰が最も悪くなり、Lassoが最も良くなりました。
差もかなり大きいです。
よって、説明変数が多くて回帰係数がスパースのとき、Lassoは予測精度が通常の線形回帰・Ridgeと比べて良いことがわかりました!
こんな感じで手法の精度を比べたいときは、シミュレーションを繰り返して比較しましょう!
しかし、「今回は人工データだからたくさんデータを生成できるけど実データで精度比較したいときはどうするの?」という疑問が出てくると思います。その場合には交差検証法を使って比較します。
 交差検証法(クロスバリデーション)の概要とRで実装方法を解説!当サイト【スタビジ】の本記事では、データ分析の場面で非常に重要である交差検証法についてまとめていきます。過学習を抑え未知データに対しても汎化能力の高いモデルを作成していくことが可能です。ぜひ交差検証法をマスターしてくださいね!
Ridge・Lassoについて理論から知りたい方はこちらの記事をご覧ください!
スパース推定とは?理論とオススメ本を紹介!当サイト【スタビジ】の本記事では、スパース推定についてまとめていきます。スパース推定とは特定のパラメータを0と推定すること。はたしてパラメータを0と推定することでどのようなメリットがあるのでしょうか?
また、機械学習手法やデータサイエンスの広範な範囲について知りたい方はぜひ以下の記事をチェックしてみてくださいね!
 【5分で分かる】機械学習の独学勉強ロードマップを徹底的にまとめていく!当サイト【スタビジ】の本記事では、機械学習の独学勉強ロードマップについて徹底的にまとめていきます。機械学習をいきなり理論からしっかり勉強しようとすると挫折しかねません。そこで、この記事ではなるべく挫折しないロードマップをお伝えしてきますよ!
 【5分で分かる】データサイエンティストに必要なスキルと独学勉強ロードマップ!当サイト【スタビジ】の本記事では、データサイエンティストに求められるスキルとそれを身に付けるための勉強法について徹底的にまとめていきます!入門者でも、しっかりデータサイエンティストについて理解しある程度独学で駆け出しの状態までいけることを目指します。
さらに当メディアでは機械学習やデータサイエンスについて幅広く学べるスクール「スタアカ」を展開しています!
ぜひチェックしてみてください!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる