画像生成AIで頻出の拡散モデルについて分かりやすく解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では、昨今の画像生成系AIの元となっている拡散モデル(diffusion model)という手法について解説していきます。話題になったDALL・EやStable Diffusionなどの手法は拡散モデルをベースに画像生成を行っています。
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
この記事では、「拡散モデル(diffusion model)」について解説していきたいと思います。
拡散モデルとは最近流行りの画像生成AIであるDALL・E2やStable Diffusionなどのベースになっている技術であり話題になっています。
そんな拡散モデルについて簡単に解説していきます。
以下の動画でも分かりやすく解説していますのであわせてチェックしてみてください!

拡散モデル(diffusion model)とは
拡散モデルを発表した最初の論文は以下です。
DDPMと略されることもあり、そのまま直訳するとノイズ除去拡散確率モデルとなります。これを拡散モデルと呼びます。
一言で言うと、「ある画像に対してランダムノイズを徐々に当てていき完全にノイズになったものを逆向きに推定した際にノイズ除去後の画像と元の画像の差分を少なくするように学習した技術」です。
以下は論文から引用した図です。
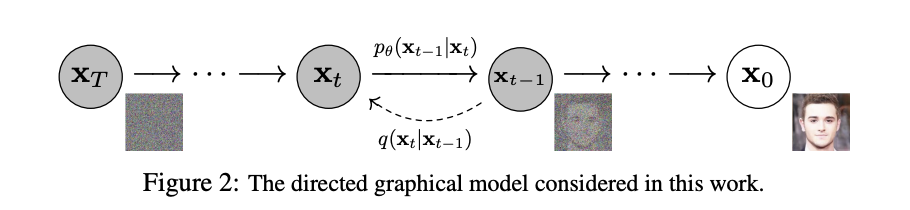
の人間の顔画像に対してランダムノイズを当てていき、最終的に完全なノイズになっているのがですね。
このランダムノイズを与える過程を逆に遡った時に元の画像と近い画像が得られるようにパラメータを最適化するのが拡散モデルの考え方です。
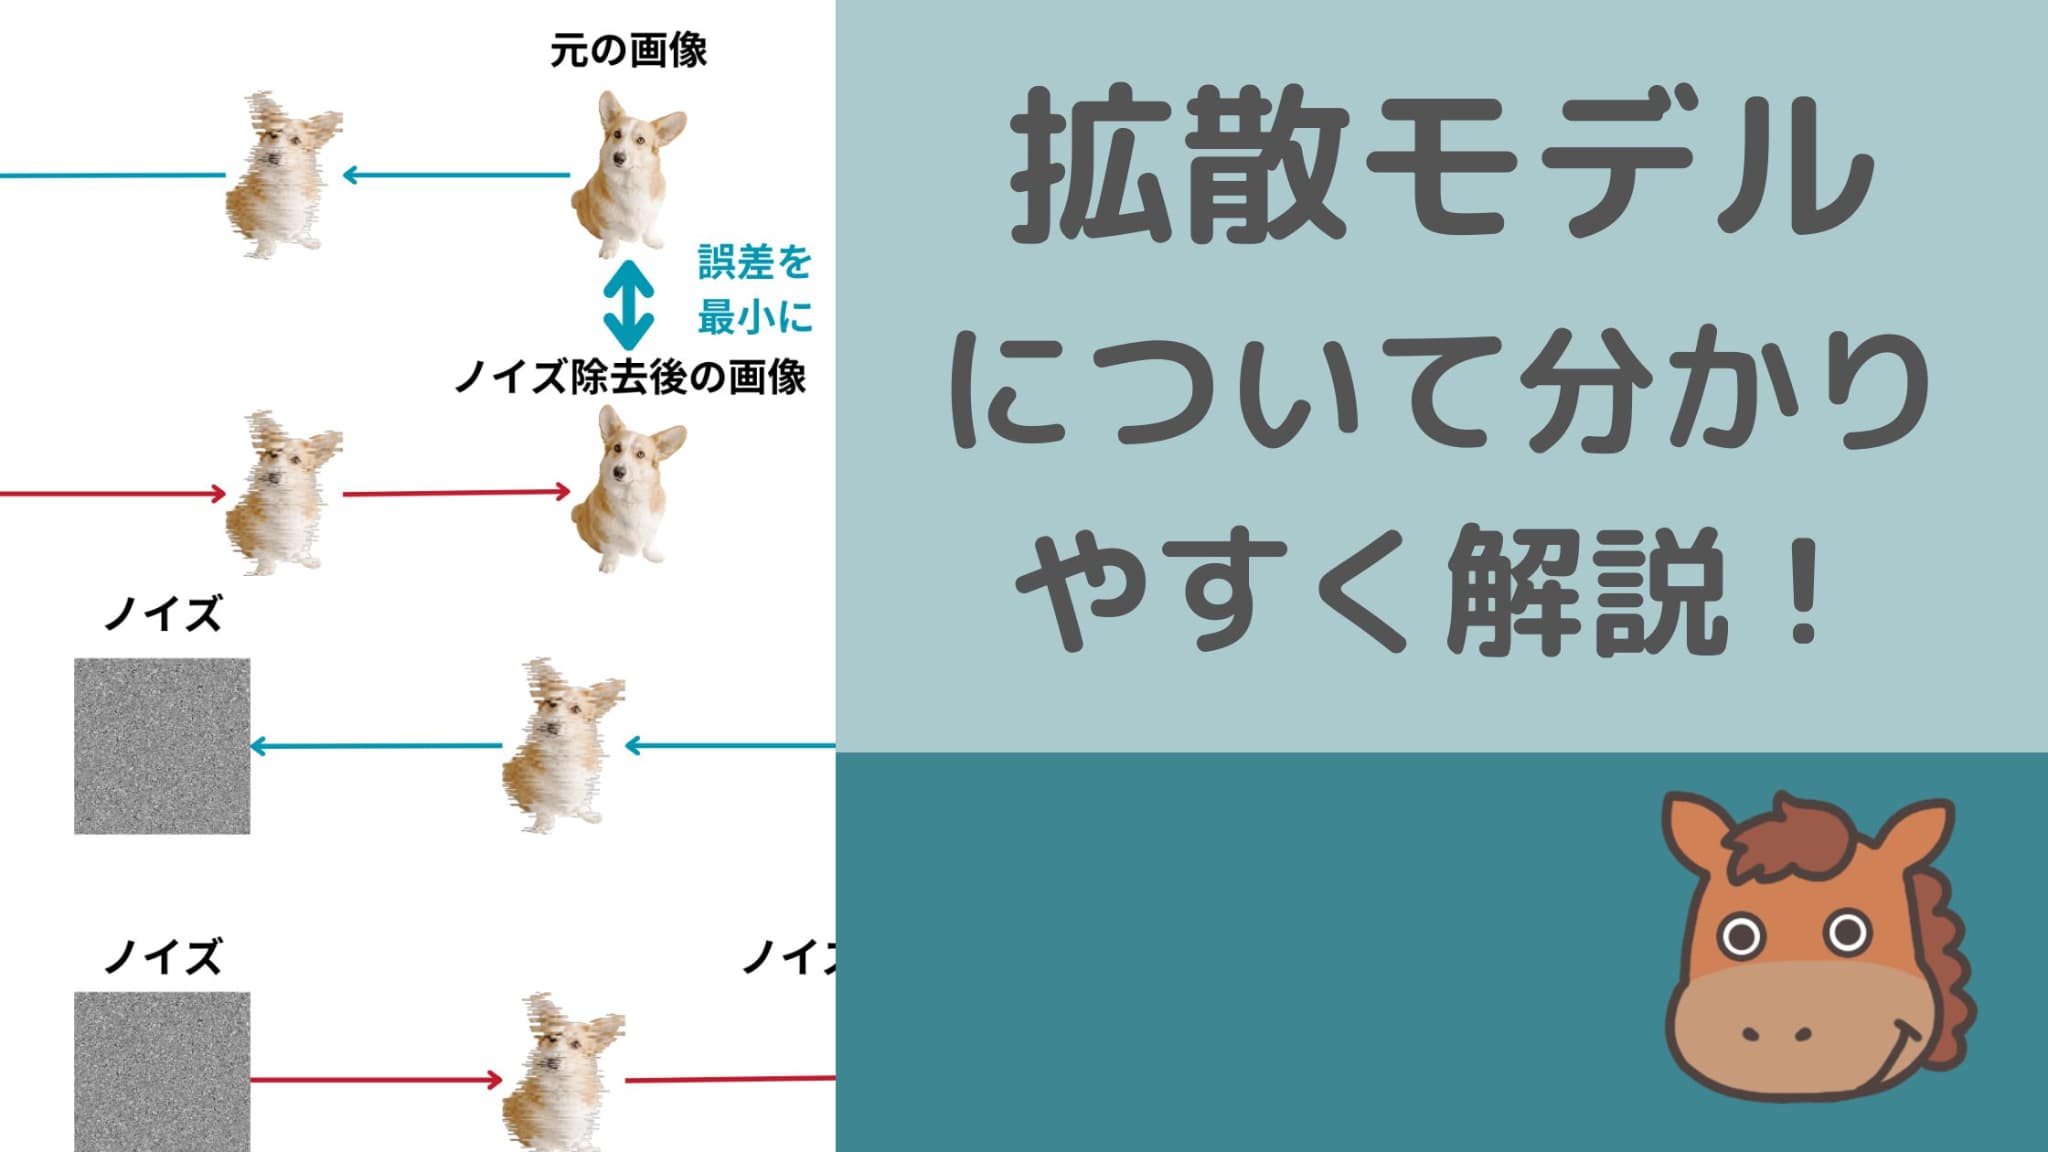
もう少し単純化して図で見てみましょう!
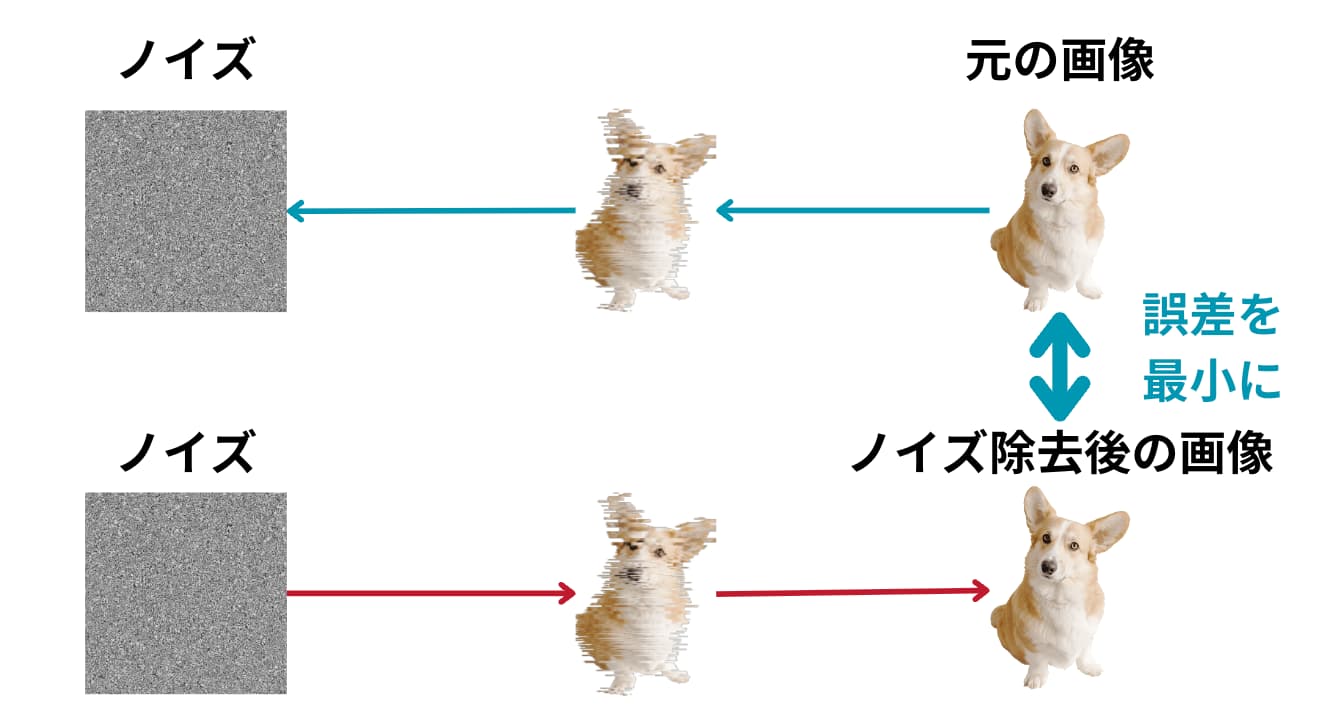
図のように犬の画像に対してノイズを乗せて、そのノイズを逆に取り除く際にノイズを取り除く部分は複数のパラメータを用いて定式化することが可能です。
ちなみに一般的にノイズには正規分布(ガウス分布)に従うノイズが当てられます。
この「ノイズ取り除く過程を定式化した部分のパラメータを調整して元の画像との差分を小さくする試み」が拡散モデルなのです!
このノイズ取り除き過程におけるパラメータ推定にはTransformerというニューラルネットワークをベースにしたアーキテクチャが使われることが多いです。
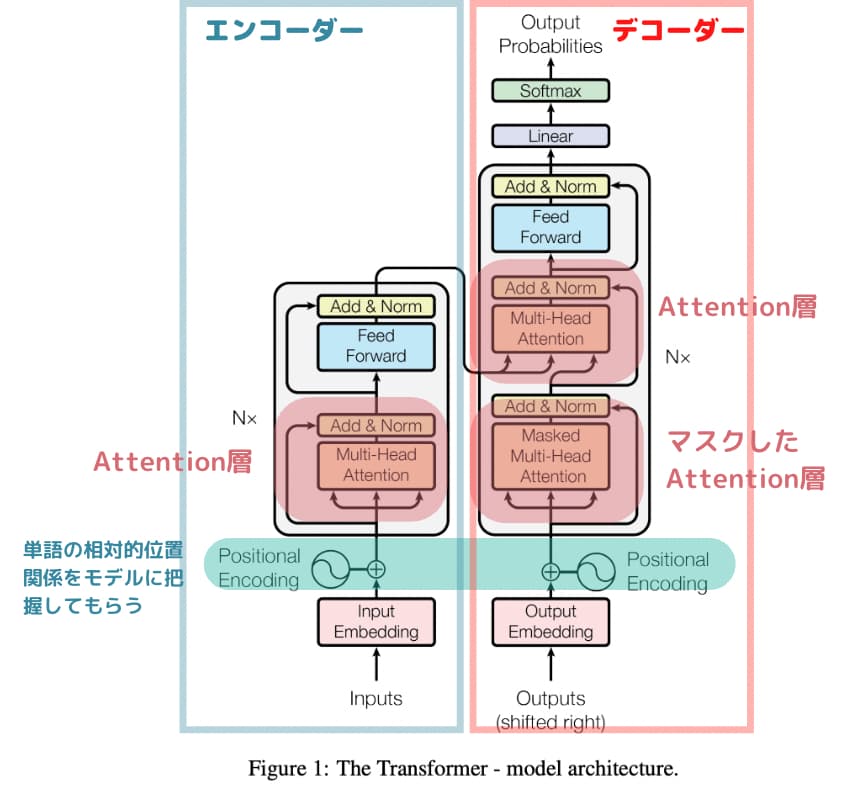
Transformerは2017年に登場した手法であり、昨今のAIブームはこのTransformerの登場によるものと言っても過言ではありません。
詳しくは以下の記事でまとめています。
 Transformer(トランスフォーマー)をAI進化の流れと共にわかりやすく解説!Attention層に至るまで当サイト【スタビジ】の本記事では、昨今のAIブームのベースとなっているTransformer(トランスフォーマー)について簡単に解説していきたいと思います!Transformerはディープラーニングの進化をブレークスルーさせた技術なんです
ウマたん
考え方は非常にシンプルだよね!
ちなみに拡散モデル以前もGANなど他の画像生成手法がありましたが、拡散モデルは従来の手法に比べてバリエーションに富んだ画像を生成することが可能です。
拡散モデルを用いた応用手法
前述の拡散モデルのアーキテクチャを見ると、どうやって指定した画像を生成するの?と思った方も多いのではないでしょうか?
実はその通りで、拡散モデル単体ではどんな画像を生成したいかを人間がコントロールする術がありません。
しかし現実世界では自分の生成したい画像を生成できないとあまり意味がありません。
そこで拡散モデルと他のアプローチを用いて多くの手法が提案されています。
DALL・E2
例えばOpenAIが発表したDALL・E2では、CLIPというアプローチを用いてテキストによる制御をした上で画像を生成しています。
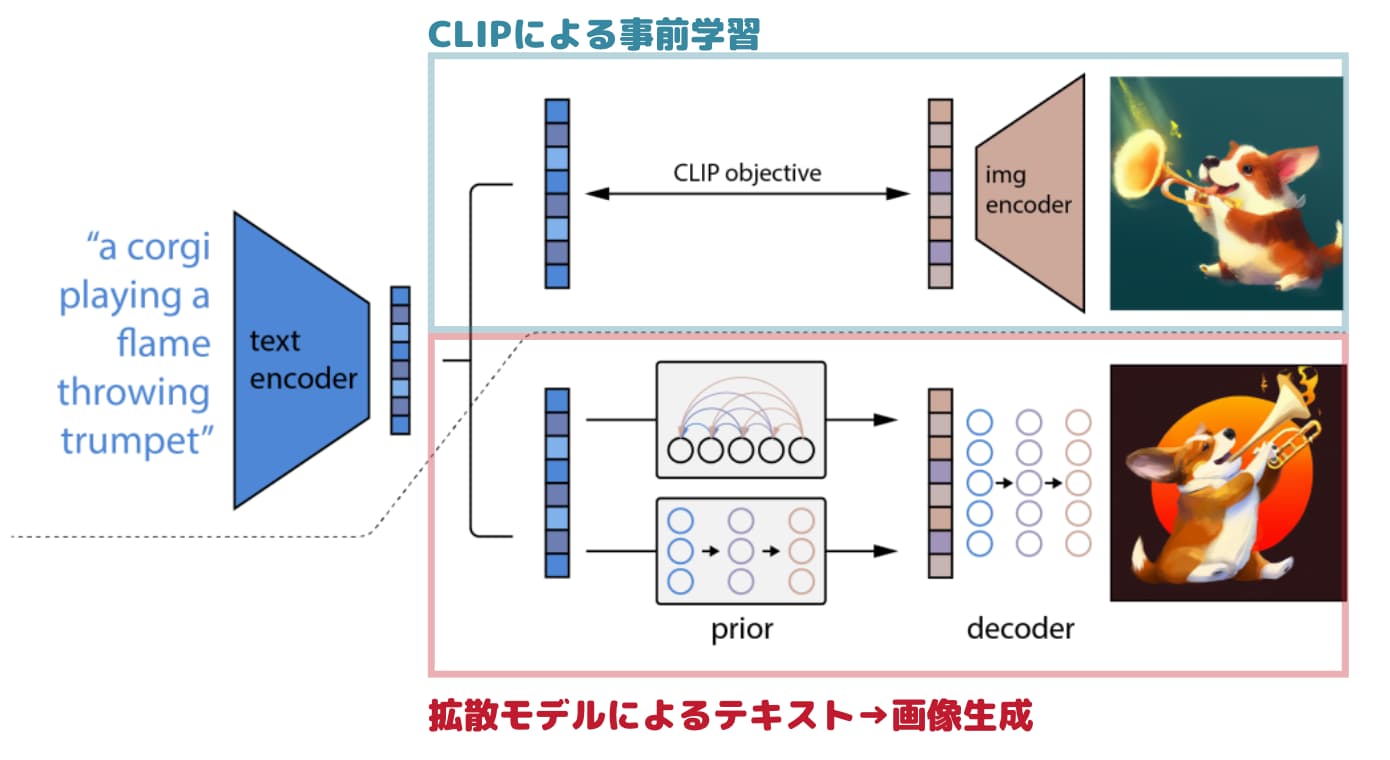 (参考:Learning Transferable Visual Models From Natural Language Supervision)
テキストによる条件付けをすることによりテキストによって画像生成を制御することが可能になるのです!
学習過程で画像をエンコーディングした情報をインプットしてあげれば、画像から画像を生成するimage to imageを行うことが可能です。
 ロボたん
文章だけで画像が生成できるなんてすごいよね〜
DALL・E2に関しては以下の記事で解説していますので是非チェックしてみてください!
 OpenAIが開発したDALL・E2(ダリ2)の使い方と仕組みを解説!当サイト【スタビジ】の本記事では、OpenAIが開発したDALL・E(ダリ)2の使い方と仕組みについて解説していきます。DALL・E(ダリ)2はテキストから非常に高精度な画像をアウトプットしてくれる生成系AIのモデルです。DALL・E(ダリ)2を理解する上ではCLIPと拡散モデルという技術をおさえておくことが重要です。
Stable Diffusion
高精度の画像を生成できることで話題のStable Diffusion!
Stable Diffusion自体の論文は公開されていませんが、詳しい解説が公式のGithub上に記載されています。
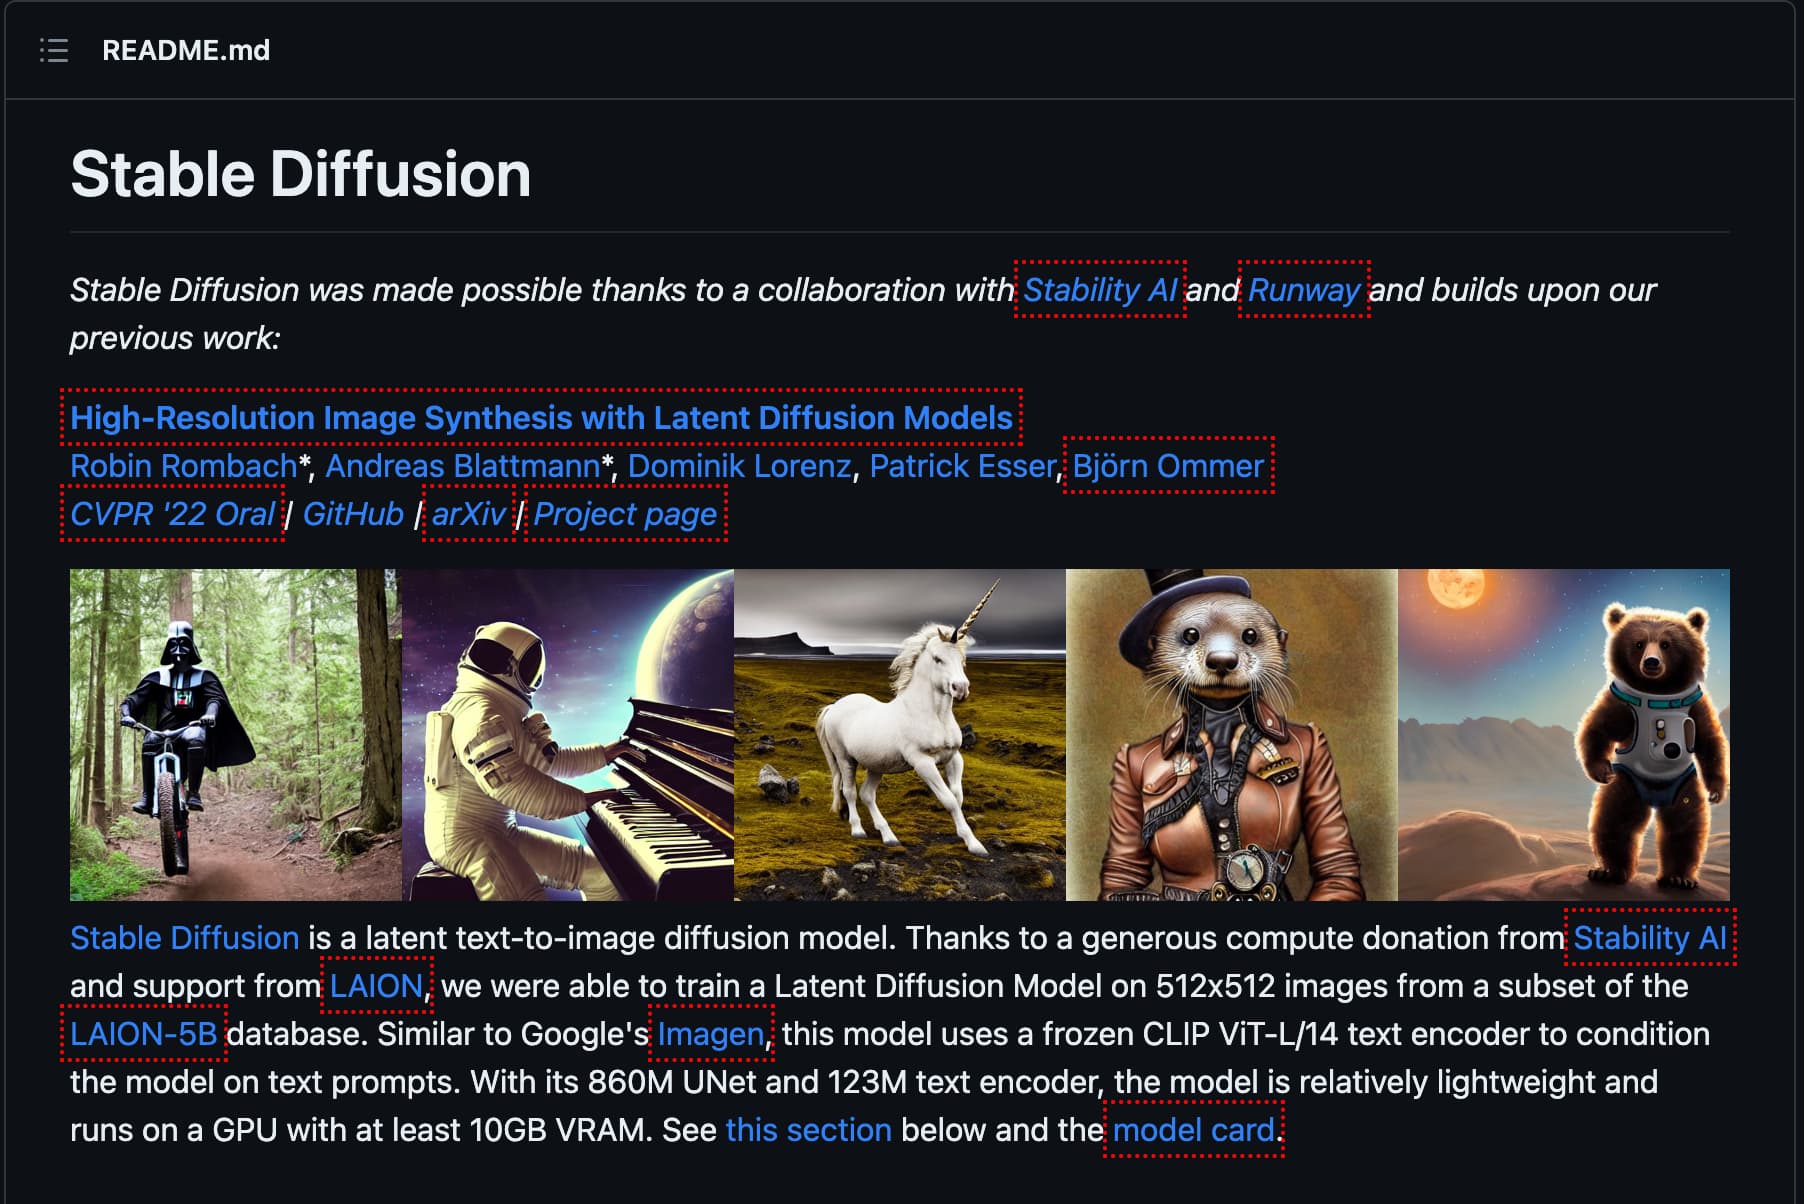
Stable Diffusionはオープンソースで世界中の誰でもプログラムを確認できるようになっているんです!
リポジトリの最初に書いてある文章を見てみましょう!
Stable Diffusion is a latent text-to-image diffusion model. Thanks to a generous compute donation from Stability AI and support from LAION, we were able to train a Latent Diffusion Model on 512×512 images from a subset of the LAION-5B database. Similar to Google’s Imagen, this model uses a frozen CLIP ViT-L/14 text encoder to condition the model on text prompts.
(出典:Stable Diffusionの公式Githubリポジトリ)
ウマたんざっくり要約すると「CLIPによるテキスト条件付けをして潜在拡散モデルで画像を生成したよ。学習にはLAION提供のデータを使ったよ」ということを言っているね!
CLIPはDALL・E2と一緒で潜在拡散モデルは画像の特徴をおおまかに捉えた低次元の潜在空間に変換してあげて拡散過程を適用させて計算量を減らしているアプローチになります。
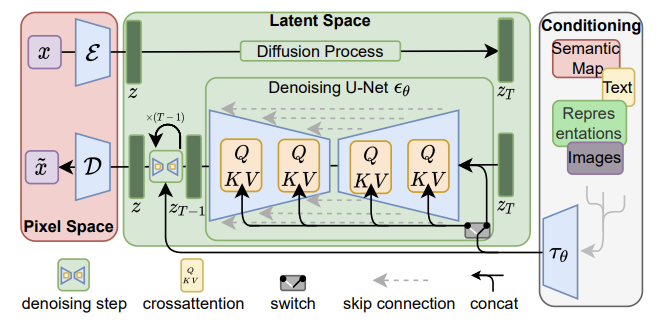 (出典:High-Resolution Image Synthesis with Latent Diffusion Models)
Stable DiffusionではLAIONという非営利組織が提供するLAION-5BというデータセットのサブセットLAION-AESTHETICSを利用して学習しています。
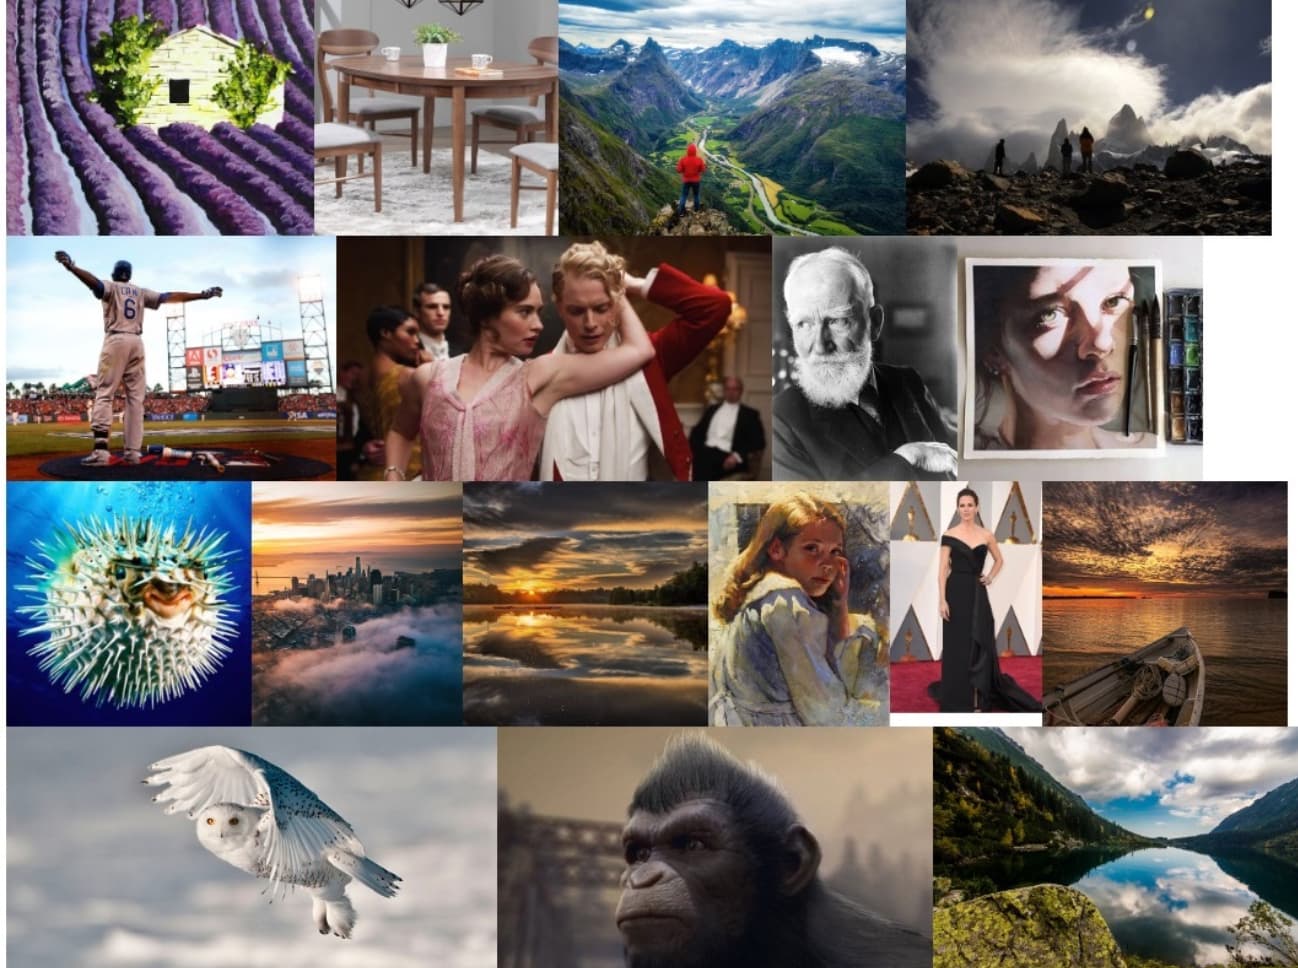
LAION-5Bは、前述のCLIPでフィルタリングされた58億5千万組の画像・テキストデータセットです。
そのLAION-5Bから美しい画像のみをピックアップして構成されているLAION-AESTHETICSを元に学習することで高画質の美しい画像をアウトプットできるようにしているのも特徴の1つです。
詳しくは以下の記事で解説していますのでチェックしてみてください!
 【原理は?】Stable Diffusionの使い方や仕組み・特徴について分かりやすく解説!当サイト【スタビジ】の本記事では、画像生成系AIとして話題のStable Diffusionの使い方や仕組み・特徴について解説していきたいと思います。画像生成系AIのStable Diffusionを理解して画像生成系AIの流れに乗り遅れないようにしましょう!
Imagen
続いてImagen。
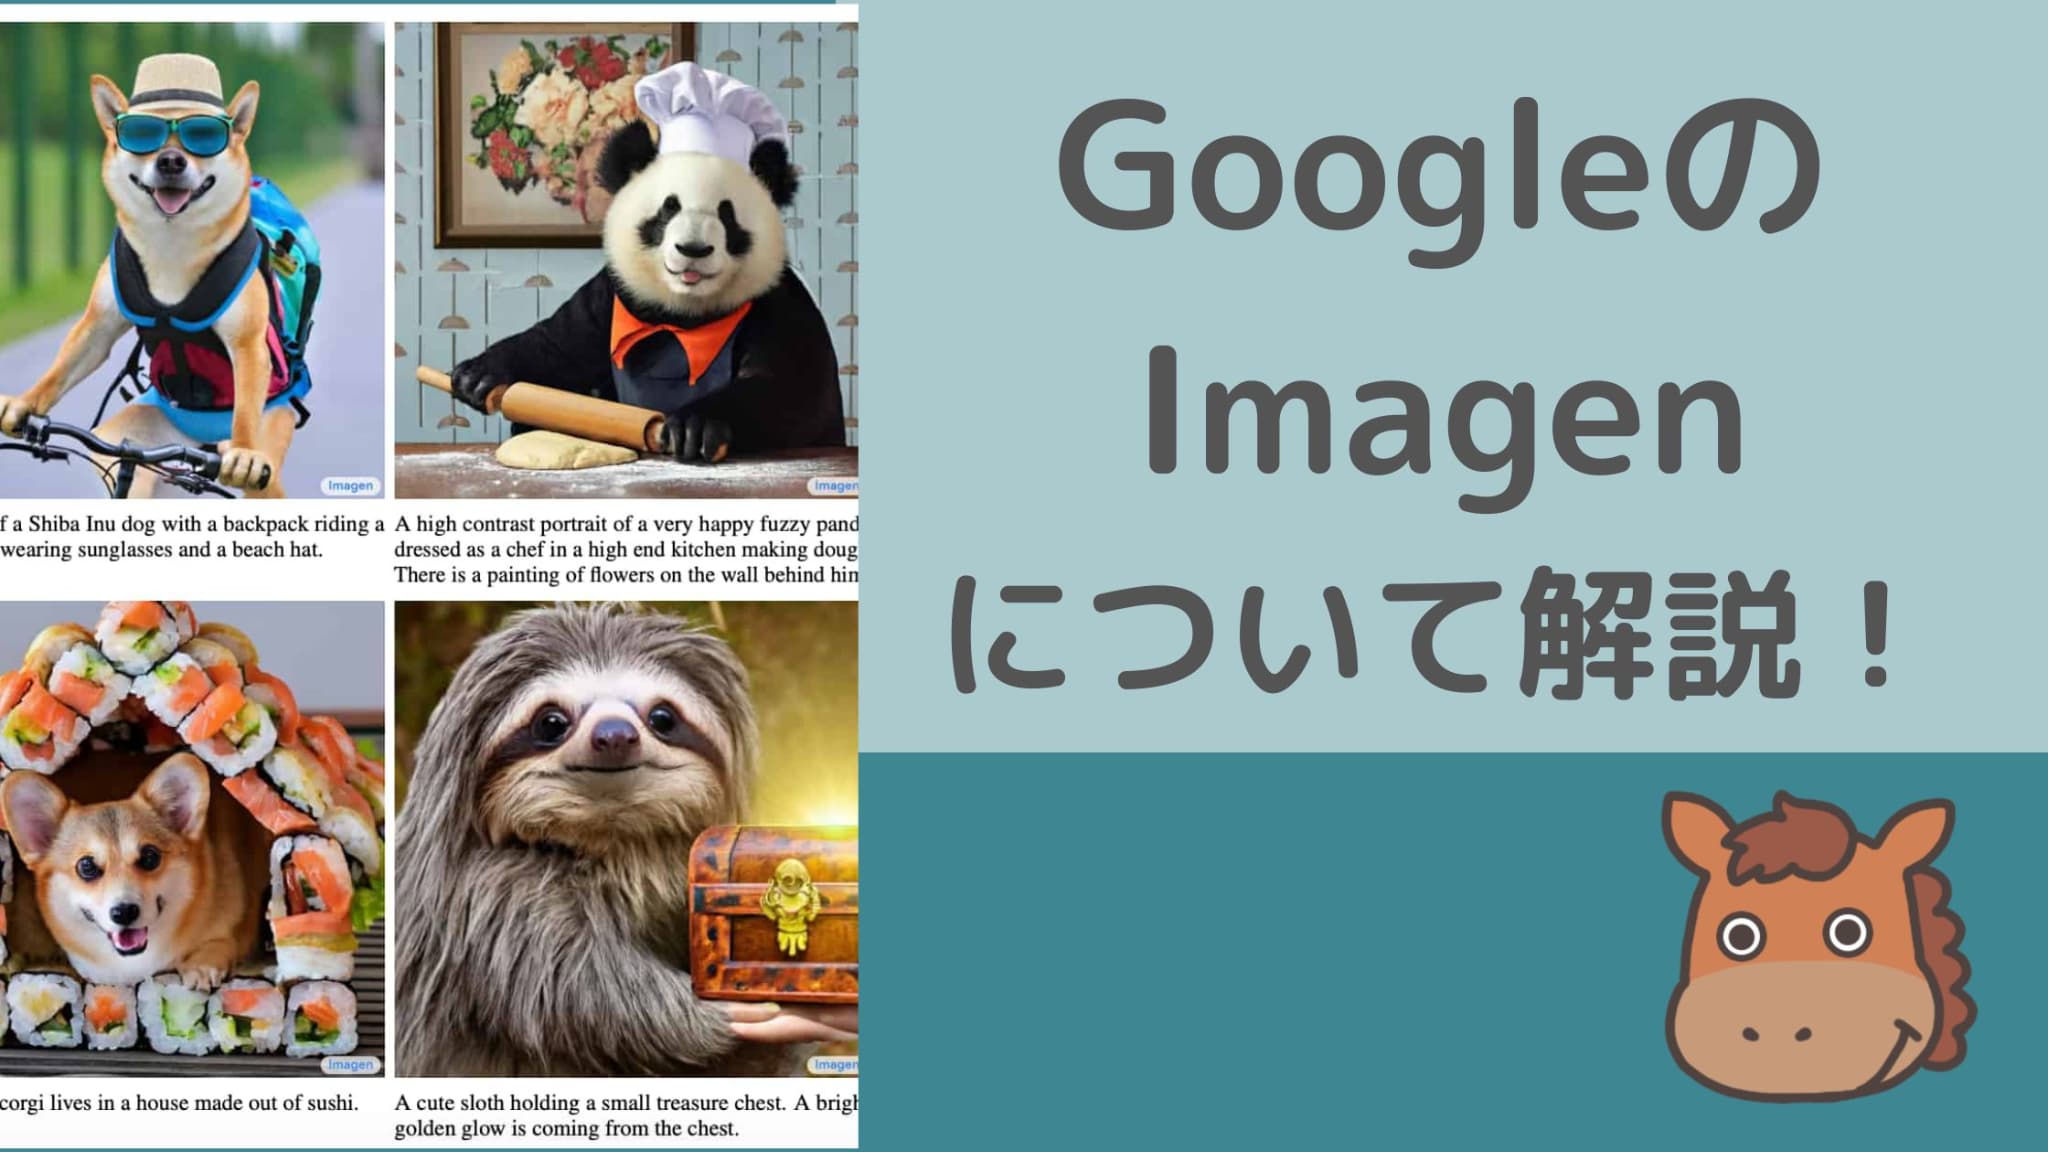
ImagenはGoolgleが2022年5月にリリースした画像生成系AIで以下は実際にImagenが生成した画像群です。
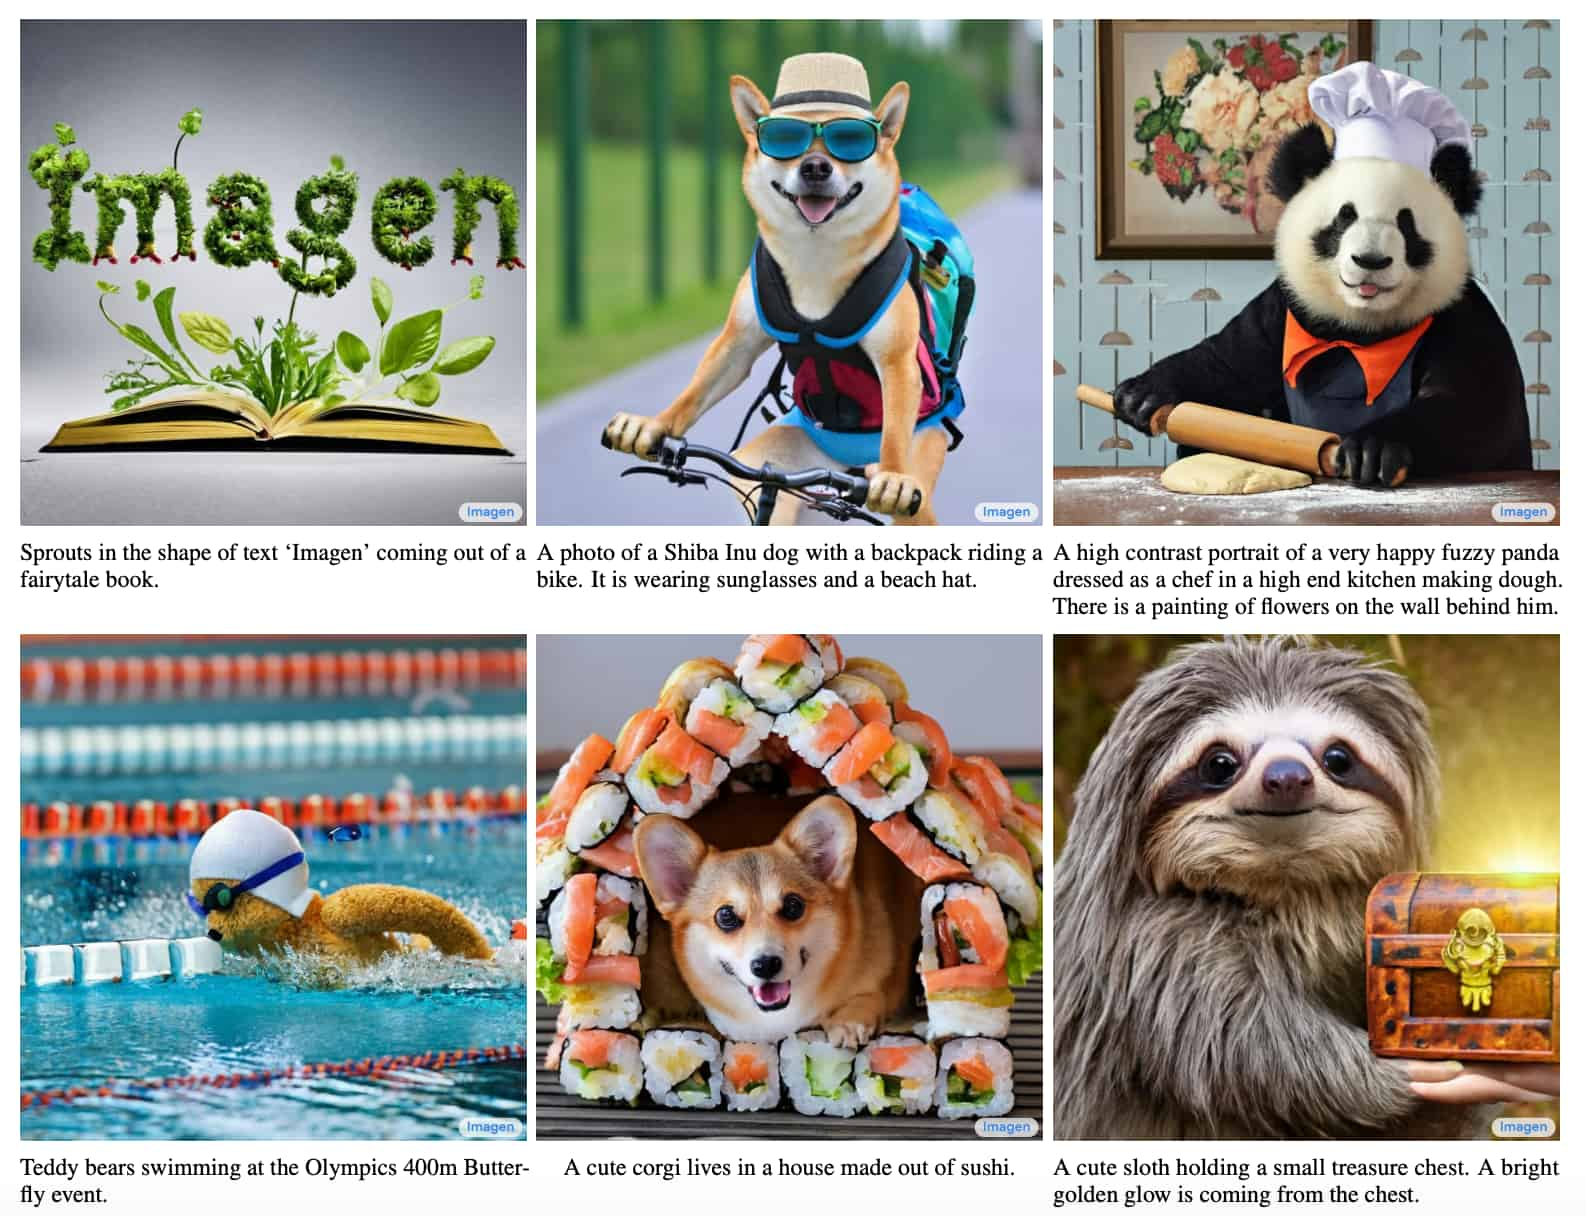
論文とGoogle公式のリリースHPは以下です。
それでは、Imagenのアーキテクチャを見ていきましょう!
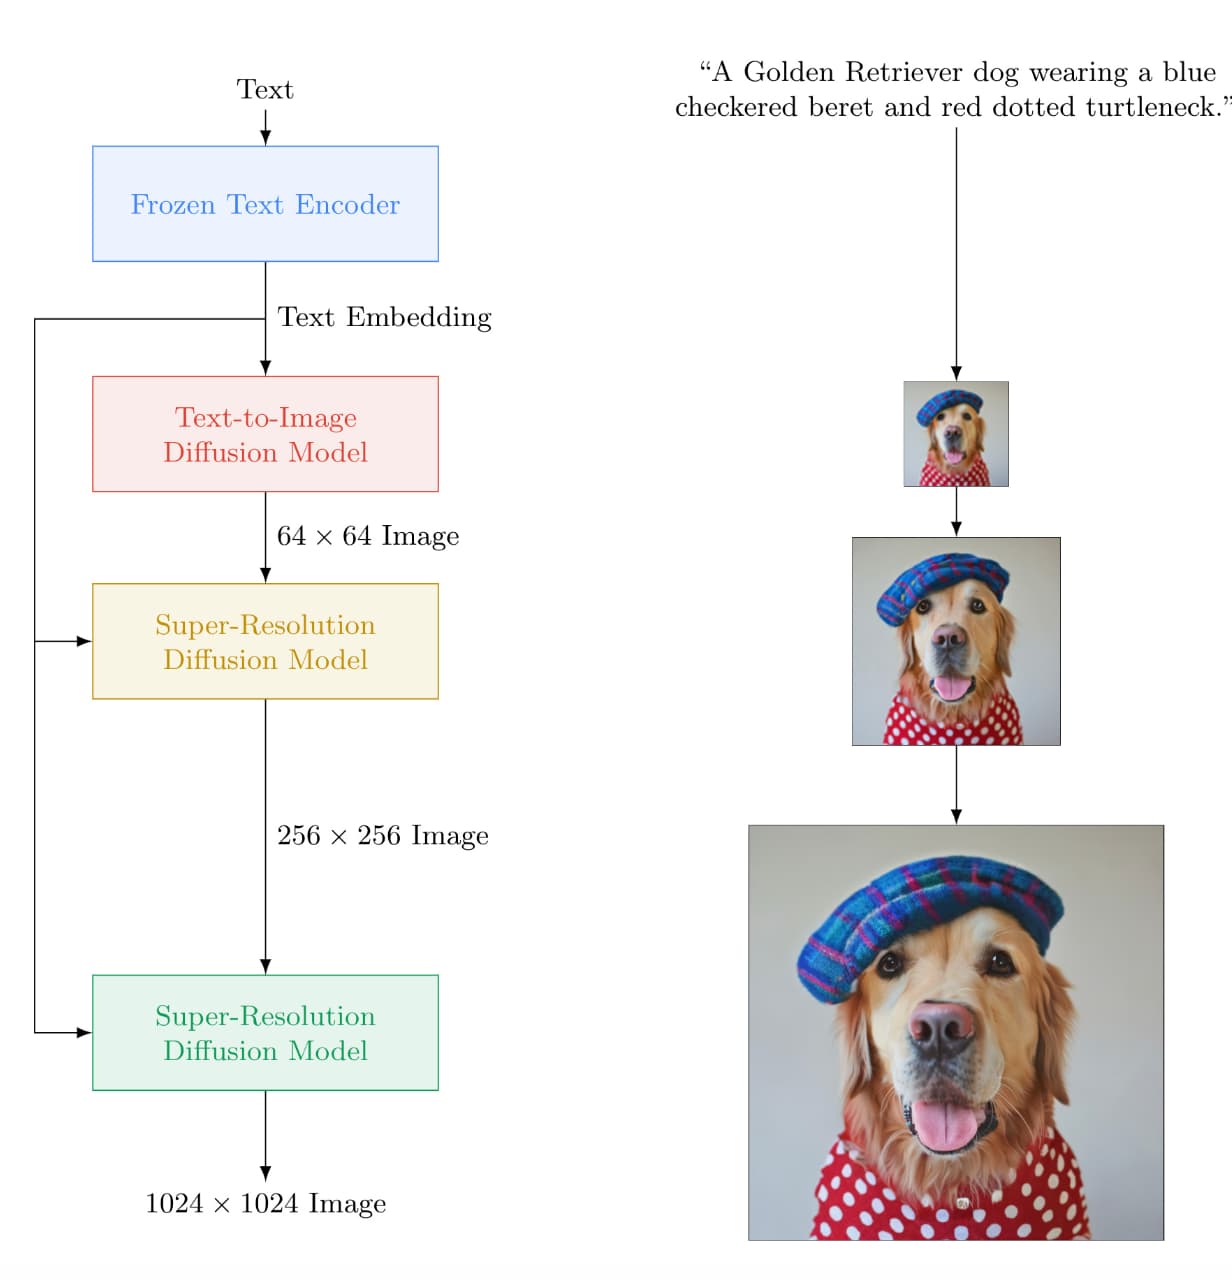
左側がImagenのアーキテクチャになります。
非常にシンプルでして、
- Frozen Text Encoder:まず最初にテキストをエンコーディング
- Text-to-Image Diffusion Model:テキストを画像に変換する拡散モデル
- Super-Resolution Diffusion Model × 2:画像の解像度を上げる拡散モデル
の流れになっています。
Imagenについて詳しくは以下の記事で解説しています!
 Googleの画像生成系AI「Imagen」について分かりやすく解説!DALL・E2との違いは!?当サイト【スタビジ】の本記事では、Googleの画像生成系AI「Imagen」について解説していきます。様々な画像生成系AIが登場する中、DALL・E2を上回る精度で話題になったImagenのアーキテクチャについて詳しく見ていきましょう!
拡散モデル まとめ
ここまでご覧いただきありがとうございました!
今回は画像生成分野において多くの手法に用いられている拡散モデルについて簡単にまとめてきました!
拡散モデルの概要を理解した後は、実際に画像生成技術を触ってみることが大事です!
ウマたん頭の良い人たちが研究開発した知識をガンガン社会実装していこう!
生成系AIを利用する方法を知りたい方は当メディアが運営するスタアカの以下のコースを是非チェックしてみてください!
スタアカは業界最安級のAIデータサイエンススクールです。
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
AIデータサイエンスを学んで市場価値の高い人材になりましょう!
データサイエンスやAIの勉強方法は以下の記事でまとめています。
 【5分で分かる】データサイエンティストに必要なスキルと独学勉強ロードマップ!当サイト【スタビジ】の本記事では、データサイエンティストに求められるスキルとそれを身に付けるための勉強法について徹底的にまとめていきます!入門者でも、しっかりデータサイエンティストについて理解しある程度独学で駆け出しの状態までいけることを目指します。
 【これだけ!】AI(人工知能)の勉強ロードマップを徹底的に解説!当サイト【スタビジ】の本記事では、AIを勉強するロードマップについて徹底的に解説していきます。まずは、AIの概要について理解して統計学の基本知識・機械学習の基本知識・Pythonでの実装・インフラ周りの知識などを包括的に理解していきましょう!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「大規模言語モデル(LLM)・生成系AI」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。