重回帰分析における偏回帰係数の求め方をわかりやすく解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では偏回帰係数・標準偏回帰係数について解説していきます。回帰係数は回帰分析における変数の係数を意味していますが、係数ごとの単位が異なると比較ができない問題があります。今回は重回帰分析に用いられる偏回帰係数・標準偏回帰係数の意味について解説していきます。
こんにちは!
スタビジ編集部です!
今回は偏回帰係数・標準偏回帰係数について解説していきます!
偏回帰係数・標準偏回帰係数は回帰分析における変数の係数(回帰係数)の1種であり、普通の回帰係数とは異なる意味を持ったものとなります。
ウマたん偏回帰係数・標準偏回帰係数を理解することで、係数を比較、すなわち変数の効果を比較することができます!意味をしっかり理解していきましょう!
この記事では、偏回帰係数・標準偏回帰係数の意味・定義式について解説していきます!
以下のYoutube動画で詳しく解説していますのであわせてチェックしてみてください!

偏回帰係数の定義と求め方について解説!
まず偏回帰係数について解説していきます!
偏回帰係数とは「重回帰分析における変数の係数」と定義されています。
もっと詳しく言うと「ある一つの変数以外を固定し、その一つの変数を1単位増加/減少した際に、目的変数がどれだけ増加/減少するか」を意味します。
つまり他の変数の影響を除外したときの変数の重みと考えることができます!
ウマたん単回帰分析では回帰係数というけど、重回帰分析では偏回帰係数と呼ぶんだ!ただ重回帰分析で回帰係数と呼んでも問題はないよ!
次は求め方について解説します。(ここでは説明変数が2個の場合を考えます)
重回帰分析は最小二乗法による最適化によって偏回帰係数を求めていきます。したがって、残差平方和を最小にする偏回帰係数を求めていきます。
この残差平方和をで偏微分し、最終的には以下のような偏回帰係数が求められます。ただしは各変数の平方和を示しています。
そしては以下の通りです!
ウマたん重要なのはこの式を覚えることではなく、最小二乗法による最適化で偏回帰係数が決まることを覚えておこう!
標準偏回帰係数の定義と求め方について解説!
次は標準偏回帰係数を解説していきますが、その前に偏回帰係数の弱点について解説していきます!
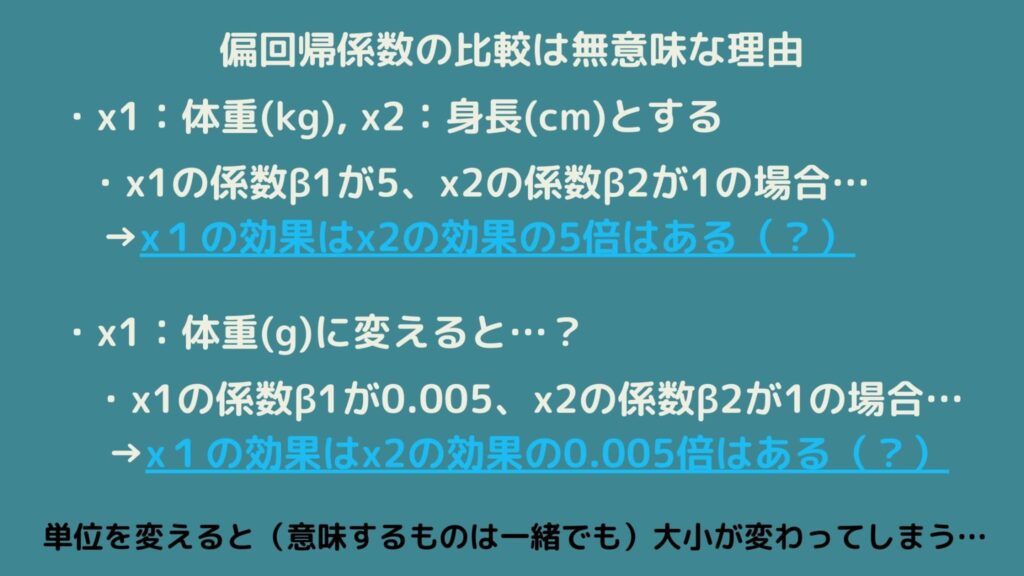
偏回帰係数の弱点はずばり、各変数の偏回帰係数の大小を比較することができない点が挙げられます。
例を見ていきましょう!重回帰式から偏回帰係数を算出したとします。
説明変数は体重(kg)を意味していますが、の単位をgに変換して求めた偏回帰係数をとします。
この時、, が成立することが分かります。
したがって、ある説明変数をa倍したらその係数は倍になり、sの他の説明変数に影響はないとわかります!
そうなると、「各変数は単位が異なるし、単位を変更すると偏回帰係数の大きさも変化してしまうので偏回帰係数の大小の比較ができない」と考えることができますね!
これを解消したものが標準偏回帰係数となります。
標準偏回帰係数とは「各説明変数・目的変数を標準化した重回帰式で算出された偏回帰係数」と定義されています。
標準化を行うことで各変数の単位がなくなるため、標準偏回帰係数は大小を比較することができます!
次は標準偏回帰係数の求め方です。(ここでも説明変数が2個の場合を考えます)
まず各変数に対して標準化を行います。ただしは各変数の平均、は各変数の標準偏差を示しています。
これらの標準化された変数を予測式に代入して整理すると…
ウマたん標準偏回帰係数は偏回帰係数と関係があることがわかったね!これで係数の大小比較が可能になるよ!
偏回帰係数・標準偏回帰係数 まとめ
ここまでご覧いただきありがとうございました!
本記事では、偏回帰係数、標準偏回帰係数についてまとめました!
今回は回帰分析を使ったので、どのような手法なのか知りたい方はこちらもご覧ください!
 回帰分析の理論とRでの実装!当サイト【スタビジ】の本記事では、統計学・データサイエンスの基本である回帰分析について理論とRでの実装を見ていきます。回帰分析についてしっかりおさえておくことで機械学習など高度な手法についても理解が深まります。
このようなデータサイエンスの力を身に付けるためにはスタビジの記事やスクールを活用すると良いでしょう。
当メディアでは、データサイエンティストの経験を詰め込んだデータサイエンス特化のスクール「スタアカ(スタビジアカデミー)」を運営していますので,興味のある方はぜひチェックしてみてください!
AIデータサイエンス特化スクール「スタアカ」
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
データサイエンティストとしての経験をふまえてエッセンスを詰め込んだのがこちらのスタビジアカデミー、略して「スタアカ」!!
当メディアが運営するスクールです。
月額1,280円のライトプランで、統計学から機械学習・生成AIまで全コースが受講し放題です!
プレミアムプランでは、24時間以内の質問対応と現役データサイエンティストとの1on1(30分×4回)を実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
他のスクールのカリキュラムはPythonでの機械学習実装だけに焦点が当たっているものが多く、実務に即した内容になっていないものが多いです。
そんな課題感に対して、実務で使うことの多いSQLや機械学習のビジネス導入プロセスの理解なども合わせて学べるボリューム満点のコースになっています!
Pythonが初めての人でも学べるようなカリキュラムにしておりますので是非チェックしてみてください!
ウォルマートのデータを使って商品の予測分析をしたり、実務で使うことの多いGoogleプロダクトのBigQueryを使って投球分析をしたり、データサイエンティストに必要なビジネス・マーケティングの基礎を学んでマーケティングプランを作ってもらったりする盛りだくさんの内容になってます!
データサイエンスに関する記事はこちら!
 【初心者必見】統計学入門に必要な知識と独学勉強方法を簡単に学ぼう!当ブログ【スタビジ】の本記事では、統計学入門に必要な知識をカンタンにまとめ、それらをどのように効率的に独学で勉強していけばよいかをお話ししていきます。統計学は難しいイメージが少しありますが、学び方をしっかり考えれば大丈夫!
 【データサイエンティスト厳選18冊】データサイエンスを学ぶ上でオススメな本・教材!当ブログ【スタビジ】の本記事では、データサイエンスを学ぶ上でオススメできる本を厳選して紹介していきます。ここではデータサイエンティストになるために習得するスキルをデータサイエンスと称しております。いくつかの観点に切り分けて見ていきます。
データサイエンスを勉強できるスクールやサイトは、ぜひこちらを参考にしてみてください!
 【徹底比較】データサイエンティストになるための学習ができるスクール9選!当サイト【スタビジ】の本記事では、データサイエンティストへの学習ができるスクールを紹介していきます。スクールに通ったからと言ってデータサイエンティストになれるわけではありませんが、データサイエンティストへの基本を着実に固めることは可能です…
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「統計学概要」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。