F検定についてPythonを使いながら解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では、F検定について解説してきます。まず検定とはある仮説が正しいか確認するために用いる手法です。その中でもF検定は2種類あります。ひとつは「2変数のばらつきが同じである」という仮説が正しいか確認する、もうひとつは「複数の群の平均が同じである」という仮説が正しいか確認します。今回は2変数のばらつきを確認するF検定について解説を行いつつ、Pythonで実装していきます!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
今回はF検定について解説していきます。F検定は主に2つの目的で用いられることが多いです。初めに「2変数のばらつきが同じである」という帰無仮説の検定、次に「複数の群の平均が同じである」という帰無仮説の検定が挙げられます!今回は前者の方を解説していきます!
この記事では、そんなF検定の定義と評価指標について解説していきながらPythonで実装していきます!
以下のYoutube動画でも解説していますのであわせてチェックしてみてください!

 統計的検定とは?具体例と種類について見ていこう!当サイト【スタビジ】の本記事では、統計検定の具体例と種類についてまとめていきます。おさえておきたいのはt検定とカイ二乗検定の2つ!この2つの意味と使い方をしっかりおさえておくことでビジネスレベルでは問題ありません。
F検定について解説!
まずはF検定でも、「2変数のばらつきが同じである」という帰無仮説の検定を見ていきましょう!
例で考えていきましょう!ある学校の2つのクラスで数学のテストを行ったと考えます。
クラスの点数はそれぞれ以下のようになったとしましょう!
それぞれのクラスから抽出したテスト結果はそれぞれ11人分です。
この時、2つのクラスは同じくらいの成績を持つ生徒で構成されていると考え、テストの点数のばらつきは大体同じであるといった仮説が考えられます。
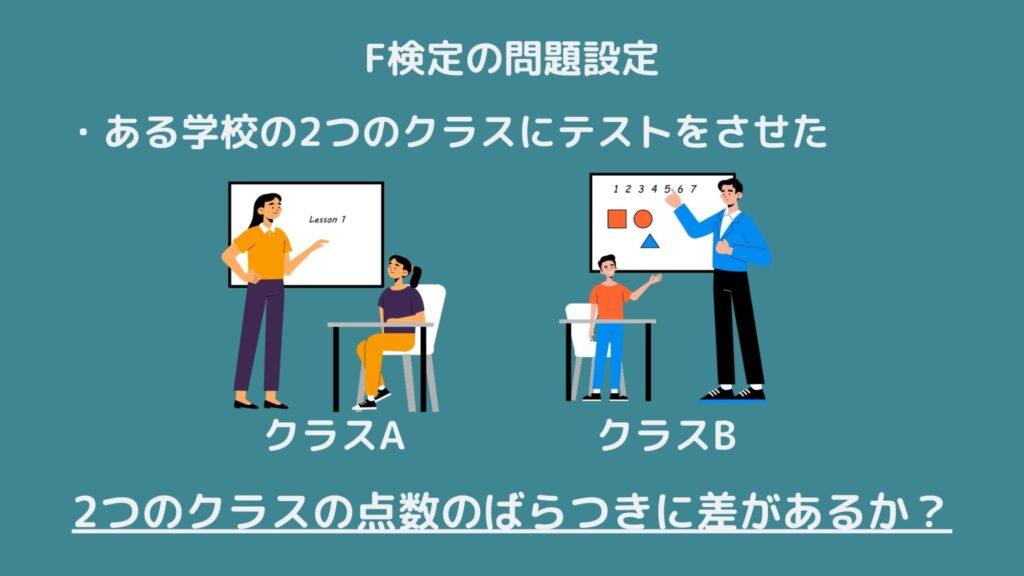
このような問題設定が出た場合、「等分散性の検定」と呼ばれるF検定の出番となります!
ここからはF検定の手順を解説していきます!
手順その1:仮説設定
検定には必ず帰無仮説と対立仮説があります。
帰無仮説とは「ある仮説が正しいのか検証するための仮説」です。大抵は「差がない」ことを示していることが多いです。
一方、対立仮説とは「帰無仮説とは反対の意を持つ仮説」です。大抵は「差がある」ことを示していることが多いです。
今回において、帰無仮説は「2つのクラスの点数のばらつきには差がない」、対立仮説は「2つのクラスの点数のばらつきには差がある」と設定できますね!
帰無仮説:
対立仮説:
手順その2:有意水準の設定
次に有意水準を設定します。有意水準を設定することで、帰無仮説を棄却できるか決まってきます。一般的には0.05 or 0.01ですが、今回は有意水準を0.05で設定します!
手順その3:F分布を用いた計算
次はF検定の肝となるF分布を用いた計算を解説していきます。
ある変数が正規分布に従い、別の変数が正規分布正規分布が従っているとき、Fは自由度のF分布に従います。
この時、それぞれの母集団から抽出した不偏分散を、と表す時、
となります。
今回の帰無仮説はなので、帰無仮説下のFは以下の通りになりますね!この式から不偏分散の比を表していることが分かります!
今回の例では、となりました。
すると、となりますね。
棄却域・p値の算出
Fを求めることができたので、F分布表を見ながら有意かどうか見ていきます。
F検定における棄却域は以下の通りです。不偏分散の大きさによって式が変化していることに注意してください!
今回の例題ではです。
サンプルサイズはそれぞれ11。
そしてネットや参考書などに記載されているF分布表を見てみると、となるので、先ほど算出したF値3.85の方が大きくなります。
したがって有意となるため、帰無仮説は棄却されるので、はと異なると考えられます!
 ロボたん
今回の結果は各クラスの点数のばらつきは異なると分かったね!
ウマたんその通り!このように等分散であるか確認したいときにF検定は使えるんだ!
F検定をPythonで実装!
実際にF検定をPythonで実装してみましょう!
import statistics as stat
from scipy.stats import f

Class_A = [90,88,85,84,80,79,78,74,71,69,60]
Class_B = [99,97,89,75,73,68,65,64,61,59,40]

print("グループAの不偏分散:", stat.variance(Class_A))
print("グループBの不偏分散:", stat.variance(Class_B))
F = stat.variance(Class_B)/stat.variance(Class_A)

p_value = 1 - f.cdf(F, len(Class_A)-1, len(Class_B)-1)
print("P値:", p_value)ここではp値が算出されました。
p値とは「今回の事象が帰無仮説において、実際の結果と同程度の結果が起きる確率」とされています。もしp値が低ければ、実際の結果が帰無仮説において起きる可能性は非常に低いことを示すところがポイントです!
つまり帰無仮説が棄却されることにつながります!
ウマたんp値が0.02225…なので、帰無仮説下において今回の標本分布が得られる確率は2%程度でしか起こらないことが分かるので有意と分かるね!つまりクラスのテストのばらつきは等しくないと分かった!
F検定 まとめ
ここまでご覧いただきありがとうございました!
本記事ではF検定についてまとめました!
検定にはt検定、カイ二乗検定もあるので、ぜひ勉強してみましょう!また統計的検定を基礎から学びたい方にはこちらの記事も参照してみて下さい!
統計的検定とは?具体例と種類について見ていこう!当サイト【スタビジ】の本記事では、統計検定の具体例と種類についてまとめていきます。おさえておきたいのはt検定とカイ二乗検定の2つ!この2つの意味と使い方をしっかりおさえておくことでビジネスレベルでは問題ありません。
このようなデータサイエンスの力を身に付けるためにはスタビジの記事やスクールを活用すると良いでしょう。
そして僕の経験を詰め込んだデータサイエンス特化のスクール「スタアカ(スタビジアカデミー)」を運営していますので,興味のある方はぜひチェックしてみてください!
AIデータサイエンス特化スクール「スタアカ」
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
データサイエンティストとしての自分の経験をふまえてエッセンスを詰め込んだのがこちらのスタビジアカデミー、略して「スタアカ」!!
当メディアが運営するスクールです。
月額1,280円のライトプランで、統計学から機械学習・生成AIまで全コースが受講し放題です!
プレミアムプランでは、24時間以内の質問対応と現役データサイエンティストとの1on1(30分×4回)を実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
他のスクールのカリキュラムはPythonでの機械学習実装だけに焦点が当たっているものが多く、実務に即した内容になっていないものが多いです。
そんな課題感に対して、実務で使うことの多いSQLや機械学習のビジネス導入プロセスの理解などもあわせて学べるボリューム満点のコースになっています!
Pythonが初めての人でも学べるようなカリキュラムにしておりますので是非チェックしてみてください!
ウォルマートのデータを使って商品の予測分析をしたり、実務で使うことの多いGoogleプロダクトのBigQueryを使って投球分析をしたり、データサイエンティストに必要なビジネス・マーケティングの基礎を学んでマーケティングプランを作ってもらったりする盛りだくさんの内容になってます!
データサイエンスに関する記事はこちら!
 【初心者必見】統計学入門に必要な知識と独学勉強方法を簡単に学ぼう!当ブログ【スタビジ】の本記事では、統計学入門に必要な知識をカンタンにまとめ、それらをどのように効率的に独学で勉強していけばよいかをお話ししていきます。統計学は難しいイメージが少しありますが、学び方をしっかり考えれば大丈夫!
 【データサイエンティスト厳選18冊】データサイエンスを学ぶ上でオススメな本・教材!当ブログ【スタビジ】の本記事では、データサイエンスを学ぶ上でオススメできる本を厳選して紹介していきます。ここではデータサイエンティストになるために習得するスキルをデータサイエンスと称しております。いくつかの観点に切り分けて見ていきます。
データサイエンスを勉強できるスクールやサイトは、ぜひこちらを参考にしてみてください!
 【徹底比較】データサイエンティストになるための学習ができるスクール9選!当サイト【スタビジ】の本記事では、データサイエンティストへの学習ができるスクールを紹介していきます。スクールに通ったからと言ってデータサイエンティストになれるわけではありませんが、データサイエンティストへの基本を着実に固めることは可能です…
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「統計学概要」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。