第1種の過誤・第2種の過誤について解説!有意水準・検出力についても詳しく!
目次
 ウマたん
当サイト【スタビジ】の本記事では、第1種の過誤・第2種の過誤について解説していきます。第1種の過誤・第2種の過誤とは「仮説が正しいにも関わらず棄却されること」「仮説が間違っているにも関わらず棄却されないこと」と定義されています。統計的検定では第1種の過誤・第2種の過誤によって間違った判断を行ってしまう可能性があるため、非常に重要な概念となります。今回はこれらの定義と有意水準・検出力について解説します!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
今回は第1種の過誤・第2種の過誤について解説していきます!第1種の過誤・第2種の過誤とは「仮説が正しいにも関わらず棄却されること」「仮説が間違っているにも関わらず棄却されないこと」と定義されています。つまり本来正しい結果が歪んでしまい、間違った判断を行ってしまうことを意味しています。
ウマたん統計的検定において非常に重要な概念なので、ここでしっかり押さえておきましょう!
この記事では、第1種の過誤・第2種の過誤、有意水準・検出力について解説します!
以下のYoutube動画でも解説していますのであわせてチェックしてみてください!

第1種の過誤・第2種の過誤について解説!
早速、第1種の過誤・第2種の過誤について解説していきましょう!
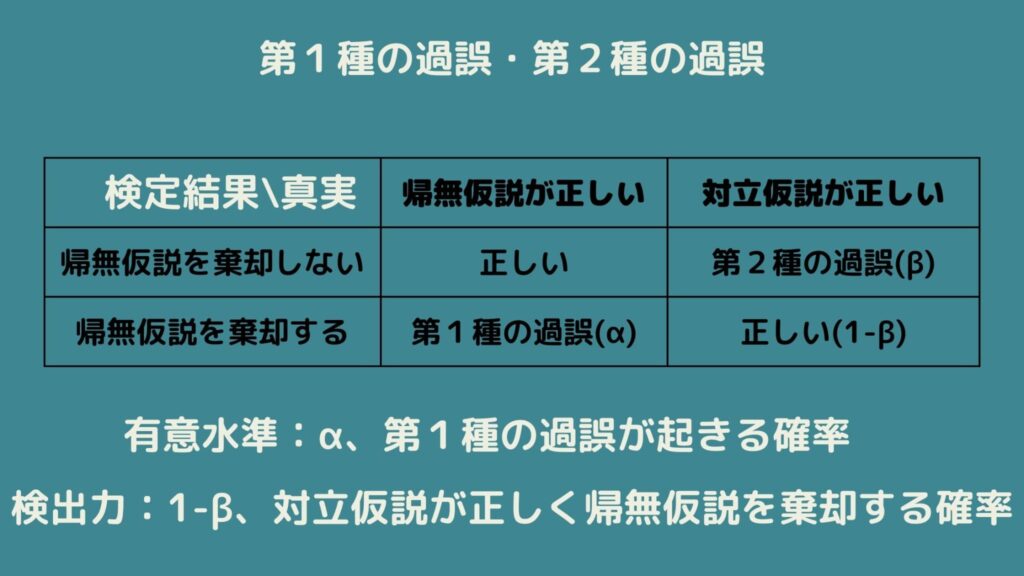
第1種の過誤・第2種の過誤を表でまとめると以下の通りになります!
これだと分かりづらいと思うので、例を挙げてみましょう。
とある患者がガンを患っているか確認したいといったケースを考えます。
この時、統計的検定で本当にガンを患っているかを確認するとして、帰無仮説を「この患者はガンを患っていない」、対立仮説を「この患者はガンを患っている」と設定します。
通常、帰無仮説は「差がない」「効果がない」「関係がない」といった仮定をします。
第1種の過誤とは帰無仮説が正しいにも関わらず帰無仮説を棄却してしまう誤りです。
すなわちこのケースでは、「患者がガンを患っていないにも関わらず、検査の結果、ガンを患っていると判断される」ことになります。
一方で、第2種の過誤とは帰無仮説が正しくないのにも関わらず帰無仮説を棄却しない選択をしてしまう誤りです。
すなわちこのケースでは、「この患者がガンを患っているにも関わらず、検査の結果、ガンを患っていないと判断される」ことになります。
この時、第1種の過誤・第2種の過誤が起きる確率がどちらも低ければ低いほど良いのですが、残念なことに、サンプルサイズが同じならこれらはトレードオフの関係にあることに注意しましょう!(両方を同時に下げるには、サンプルサイズを大きくするのが基本です)
したがって第1種の過誤・第2種の過誤のバランスをとることが重要です!
たとえば今回のケースでは、
「患者がガンを患っていないにも関わらず、検査の結果、ガンを患っていると判断される」ケースと、
「この患者がガンを患っているにも関わらず、検査の結果、ガンを患っていないと判断される」ケースでは、
どちらがなるべく起こってほしくないでしょうか?
仮に患者がガンを患っていないにも関わらず、検査の結果ガンを患っていると判断されたとしても、それほど重大な問題ではありません。
一方でこの患者がガンを患っているにも関わらず、検査の結果ガンを患っていないと判断されてしまうのは、大きな問題に発展する可能性があります。
すなわち今回のケースでは第2種の過誤を極力下げる努力が大事になります。
そうした結果ほとんどの人をガンと診断するようになっては元も子もないので結局はバランスなのですが、問題設定や領域によってこの第2種の過誤と第1種の過誤のバランスは変わってきますので注意しましょう!
有意水準・検出力について解説!
そして第1種の過誤・第2種の過誤と関連がある概念が有意水準・検出力となります。
有意水準とは、帰無仮説が正しいにもかかわらずそれを棄却してしまう確率のことであり、有意水準は第1種の過誤を犯す確率そのものを意味していることがわかります。
一方、検出力とは「帰無仮説が正しくないとき、帰無仮説を棄却する確率」を意味しています。
この時、は第2種の過誤を犯す確率を意味しています。
ウマたん数学的な要素は省きますが、実際に検出力を式で導出することができます!
第1種の過誤・第2種の過誤 まとめ
本記事では第1種の過誤・第2種の過誤についてまとめました!
検定にはt検定・カイ二乗検定・F検定がありますので、こちらの記事も見てみると良いでしょう!
 【5分で分かる】t検定の概要とPythonやRでのやり方紹介!当サイト【スタビジ】の本記事では、推計統計学の基本であるt検定についてまとめていきます。統計的検定にはいくつかの種類がありますが、中でも一番定番で様々な場面に登場するのがこちらのt検定なんです。ぜひマスターしておきましょうね!
 カイ二乗検定についてわかりやすく解説!Pyhonでの実装を一緒に見ていこう!当サイト【スタビジ】の本記事では、統計的検定の1つであるカイ二乗検定についてまとめていきます!カイ二乗検定はビジネスシーンで使用することが多く分かっていると非常に役立ちます。RでもPythonでも簡単に使うことができるのでぜひマスターしてくださいね!
 F検定についてPythonを使いながら解説!当サイト【スタビジ】の本記事では、F検定について解説してきます。まず検定とはある仮説が正しいか確認するために用いる手法です。その中でもF検定は「複数の変数のばらつきが同じである」という仮説が正しいか確認します。今回は2変数のばらつきを確認するF検定について解説を行いつつ、Pythonで実装していきます!
このようなデータサイエンスの力を身に付けるためにはスタビジの記事やスクールを活用すると良いでしょう。
そして僕の経験を詰め込んだデータサイエンス特化のスクール「スタアカ(スタビジアカデミー)」を運営していますので,興味のある方はぜひチェックしてみてください!
AIデータサイエンス特化スクール「スタアカ」
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
データサイエンティストとしての自分の経験をふまえてエッセンスを詰め込んだのがこちらのスタビジアカデミー、略して「スタアカ」!!
当メディアが運営するスクールです。
月額1,280円のライトプランで、統計学から機械学習・生成AIまで全コースが受講し放題です!
プレミアムプランでは、24時間以内の質問対応と現役データサイエンティストとの1on1(30分×4回)を実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
他のスクールのカリキュラムはPythonでの機械学習実装だけに焦点が当たっているものが多く、実務に即した内容になっていないものが多いです。
そんな課題感に対して、実務で使うことの多いSQLや機械学習のビジネス導入プロセスの理解なども合わせて学べるボリューム満点のコースになっています!
Pythonが初めての人でも学べるようなカリキュラムにしておりますので是非チェックしてみてください!
ウォルマートのデータを使って商品の予測分析をしたり、実務で使うことの多いGoogleプロダクトのBigQueryを使って投球分析をしたり、データサイエンティストに必要なビジネス・マーケティングの基礎を学んでマーケティングプランを作ってもらったりする盛りだくさんの内容になってます!
データサイエンスに関する記事はこちら!
 【初心者必見】統計学入門に必要な知識と独学勉強方法を簡単に学ぼう!当ブログ【スタビジ】の本記事では、統計学入門に必要な知識をカンタンにまとめ、それらをどのように効率的に独学で勉強していけばよいかをお話ししていきます。統計学は難しいイメージが少しありますが、学び方をしっかり考えれば大丈夫!
 【データサイエンティスト厳選18冊】データサイエンスを学ぶ上でオススメな本・教材!当ブログ【スタビジ】の本記事では、データサイエンスを学ぶ上でオススメできる本を厳選して紹介していきます。ここではデータサイエンティストになるために習得するスキルをデータサイエンスと称しております。いくつかの観点に切り分けて見ていきます。
データサイエンスを勉強できるスクールやサイトは、ぜひこちらを参考にしてみてください!
 【徹底比較】データサイエンティストになるための学習ができるスクール9選!当サイト【スタビジ】の本記事では、データサイエンティストへの学習ができるスクールを紹介していきます。スクールに通ったからと言ってデータサイエンティストになれるわけではありませんが、データサイエンティストへの基本を着実に固めることは可能です…
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「統計学概要」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。