自然言語処理領域で重要なWord2Vecの仕組みとPython実装についてわかりやすく解説!
目次
 ウマたん
当サイト【スタビジ】の本記事では、Word2Vecについて解説していきます!Word2Vecは単語をベクトル化する技術。Word2Vecの登場により自然言語処理領域に大きなブレークスルーが起きました。理解しておきましょう!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です!
この記事では自然言語処理領域の中で非常に重要なWord2Vecについて簡単に解説していきます。
最近の大規模言語モデルは自然言語処理領域の進化の過程で生まれてきましたが、その自然言語処理の領域の今まで登場してきた技術をしっかりおさえておくことは非常に重要です。
ここでしっかり理解しておきましょう!
以下のYoutube動画でも解説していますのでチェックしてみてください!

Word2Vecとは?
まずWord2Vecとはどんな技術なのでしょうか?
Word2Vecは2013年にGoogleの研究員であるTomas Mikolovらによって発表された手法です。
論文は以下になります。
Word2Vecは、その名の通り「ワードをベクトルに変換する技術」です。
ベクトル化することで意味合い的にこの単語とこの単語は近いよねー、この単語は遠いよねーみたいなことがベクトルの向きに落とし込めるんです!
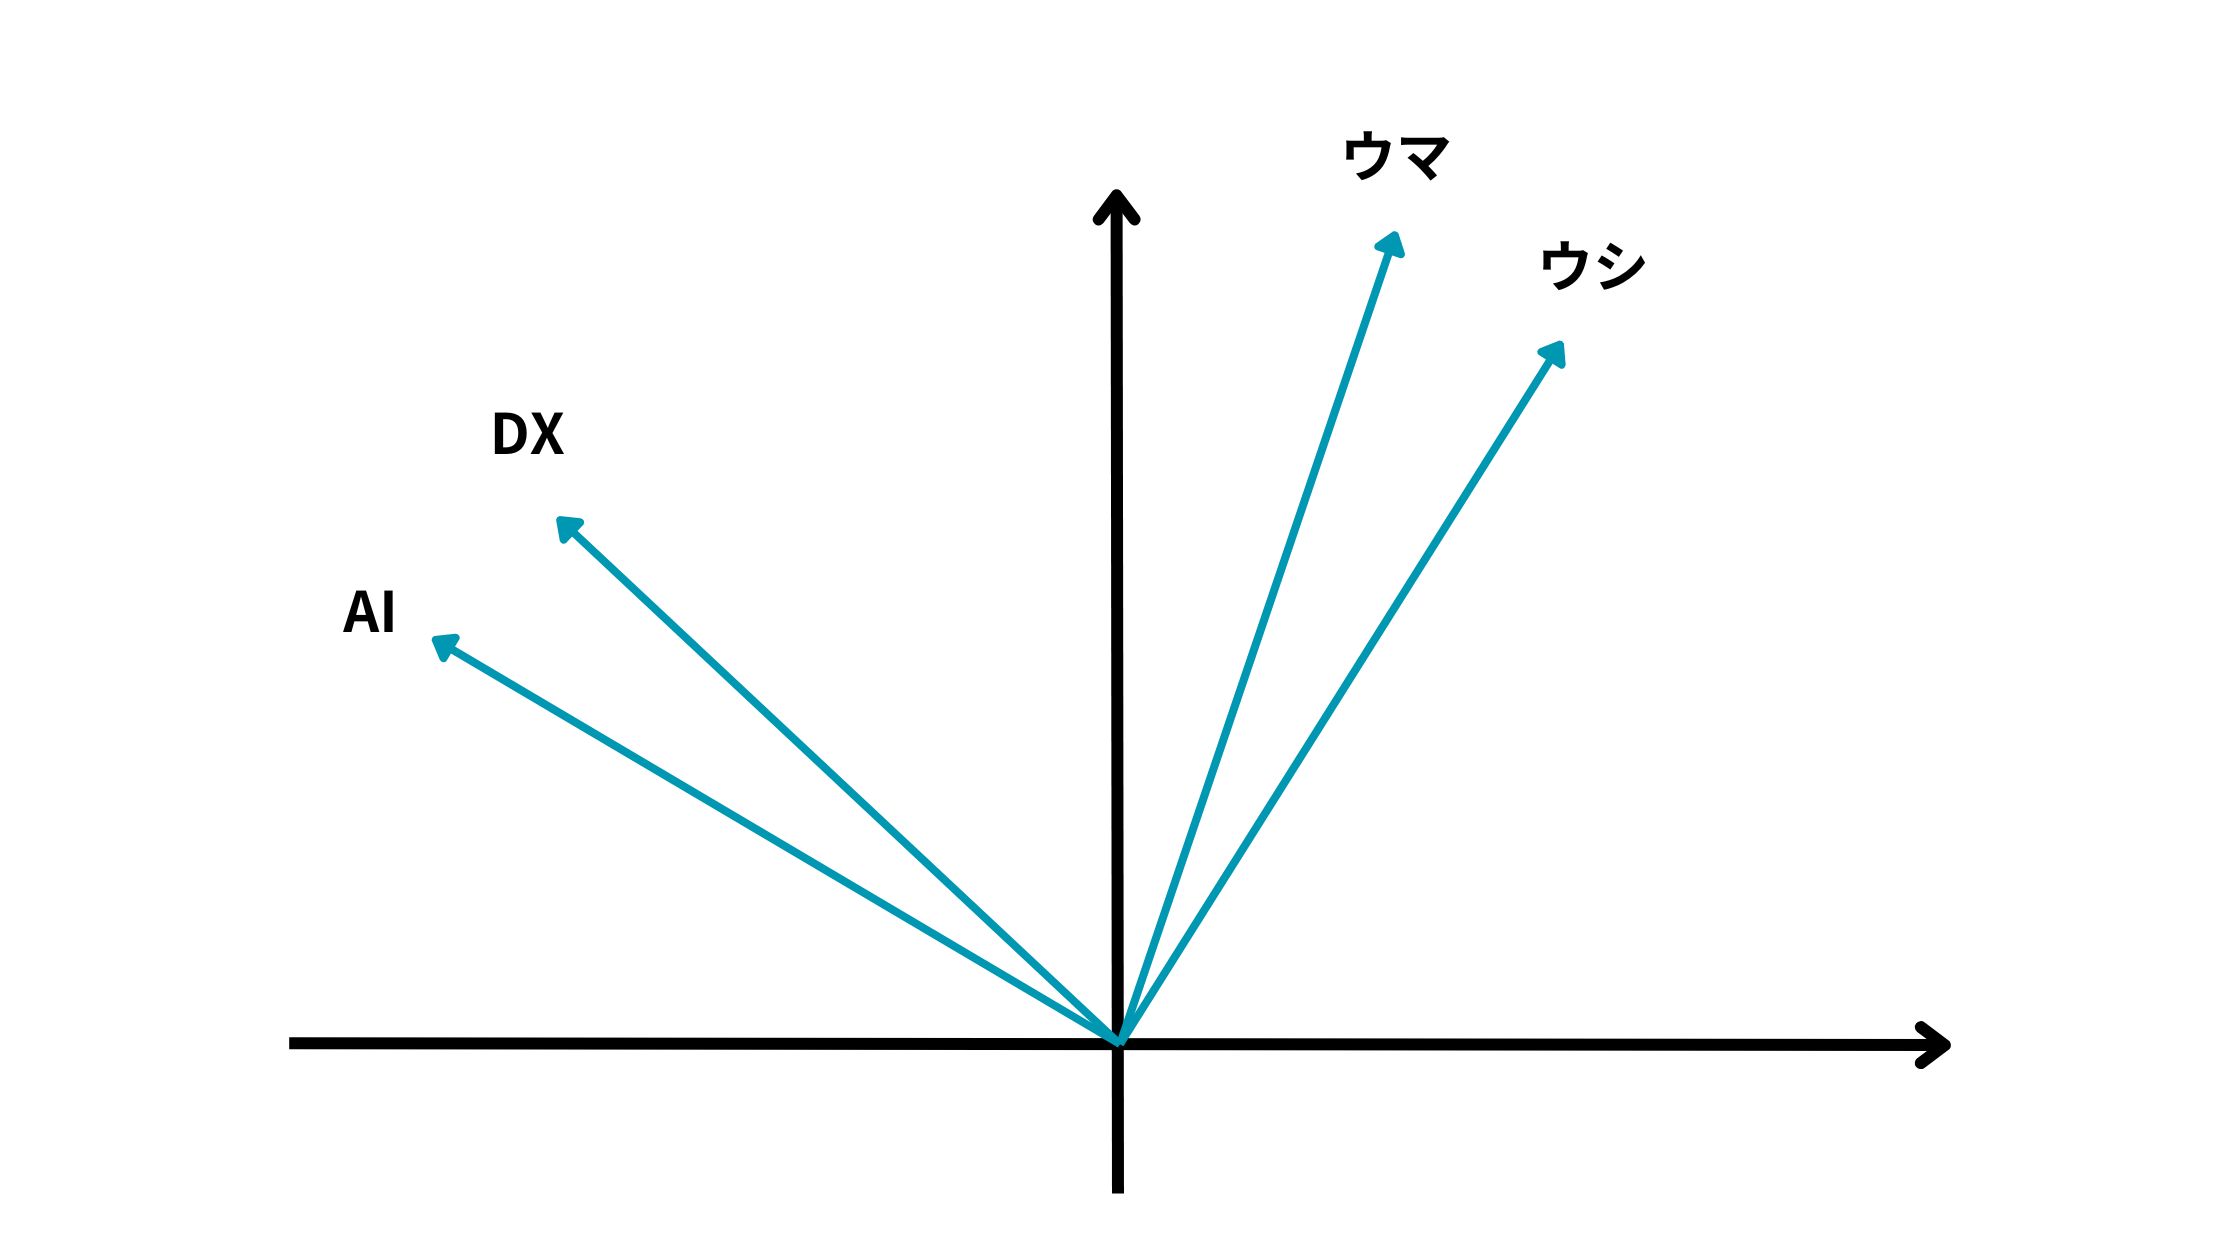
上記の例だとAIとDXは近いベクトル方向を持っている一方で、ウマとウシは遠いベクトル方向を持っているように見えます。
これは簡易的な例ですが、単語をベクトル化することでどの単語同士が近い意味を持つのか遠い意味を持つのかを解釈しようとする試みなのです!
例えば以下のように
AI というワードが[0.2, 0.4, 0.5・・・・]というようなベクトルになるイメージです。
そして、ベクトル化の便利なところは様々な演算を施せることです。
有名な例として、
になるという例があります。
KingのベクトルからManのベクトルを引いて、Womanのベクトルを足してあげると、Queenのベクトルに非常に近いベクトルが生成できるのです。
ウマたん我々のイメージと合致することがベクトル演算によって表現できているのは面白い!
自然言語処理の世界では、文書や単語をベクトルに置き換えてベクトル表現の状態で比較したり推論したりします。
ベクトル化する方法としてカウントベースと推論ベースがあり、Word2Vecは推論ベースになります。
例えばカウントベースには代表的なアプローチとしてtf-idfというものがあり、文章に登場する単語の数を数えてそれをベクトル化します(これは文章のベクトル化なので単語とは違いますが)。
TFはその文書内での単語の頻出度を表しており、IDFはその単語が全ての文書の中でどれくらいの文書で登場するかすなわち単語の希少度を表しており、それらをもとに算出されるのがtf-idfです。
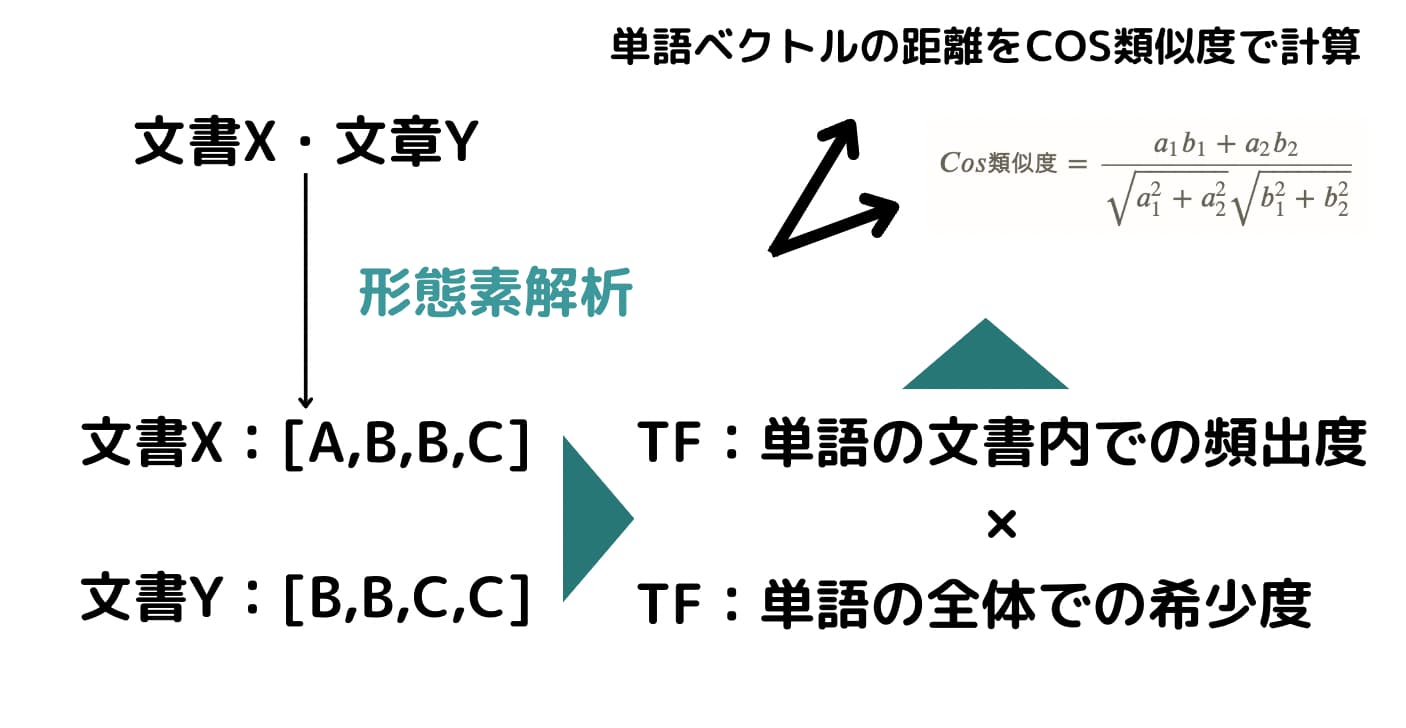 以下の記事で解説していますのでチェックしてみてください。
 Pythonで文書類似度算出!MeCabで形態素解析後にTf-idfとCos類似度を使ってみよう当サイト【スタビジ】の本記事では、形態素解析器であるMeCabとPythonを用いて形態素解析を行いその後Tf-idfとCos類似度を使い最終的に文章の類似度を算出していきます。また、文章の著者が誰なのかをMeCabとLight gbmを用いて予測していきます。非常に簡単に実装できるかつ応用度が高いです!自然言語処理の世界に入るきっかけにしてくださいね!
一方でWord2Vecは推論ベースでベクトル化していきます。次から詳しい仕組みについて見ていきましょう!
Word2Vecの仕組み
それでは続いて簡単にWord2Vecの仕組み・アルゴリズムについて確認していきましょう!
Word2Vecの論文内では2つのアプローチが提案されています。
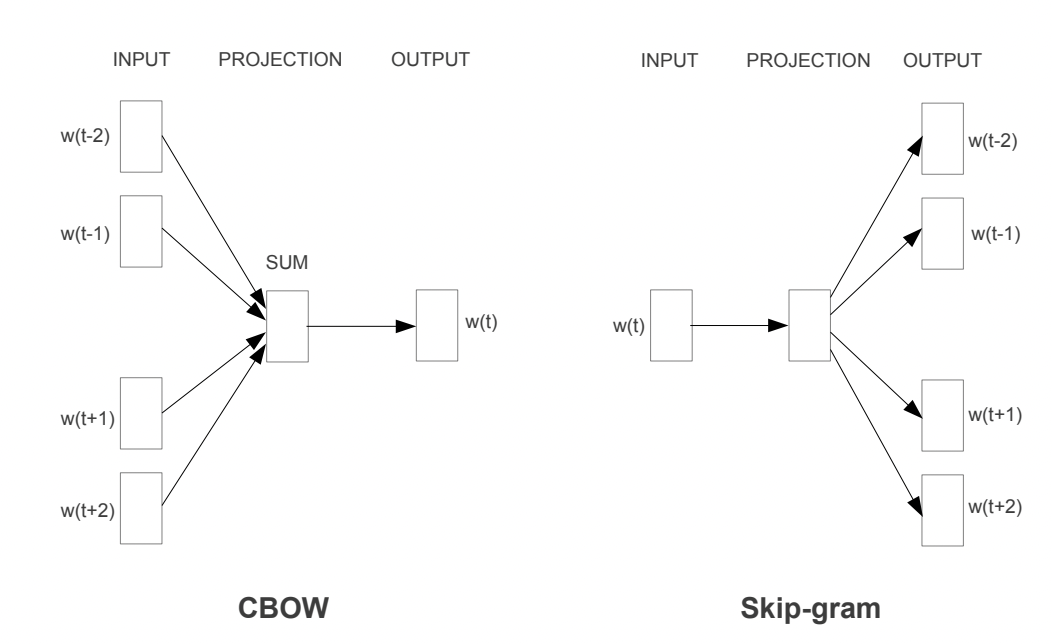
それぞれについて見ていきましょう!
CBOW
CBOWは、前後の文脈から対象となる単語を推論するアプローチです。
例えば、
「雨が降りそうだから傘を持っていこうと思う」という文章があった時にその文章は以下のように分解することができます。
この単語のかたまりのうち傘の部分をマスクしてみましょう!
この状態で前後関係からマスクした「?」の部分を推測するのがCBOWです。
前後複数個の単語からマスクした単語を予測するわけです。
まずそれぞれの単語をOne-hot ベクトル化します。
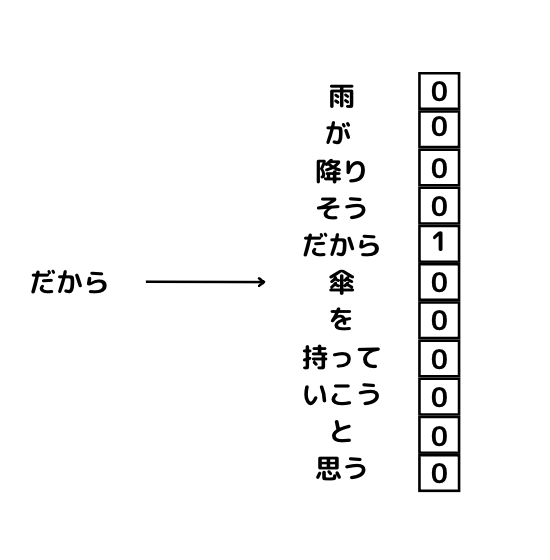
これらのOne-hotベクトル化したものそれぞれに対して重み行列によって次元圧縮して平均を取ったものを最終的に重み行列で元の次元に戻して予測するモデルを構築します。
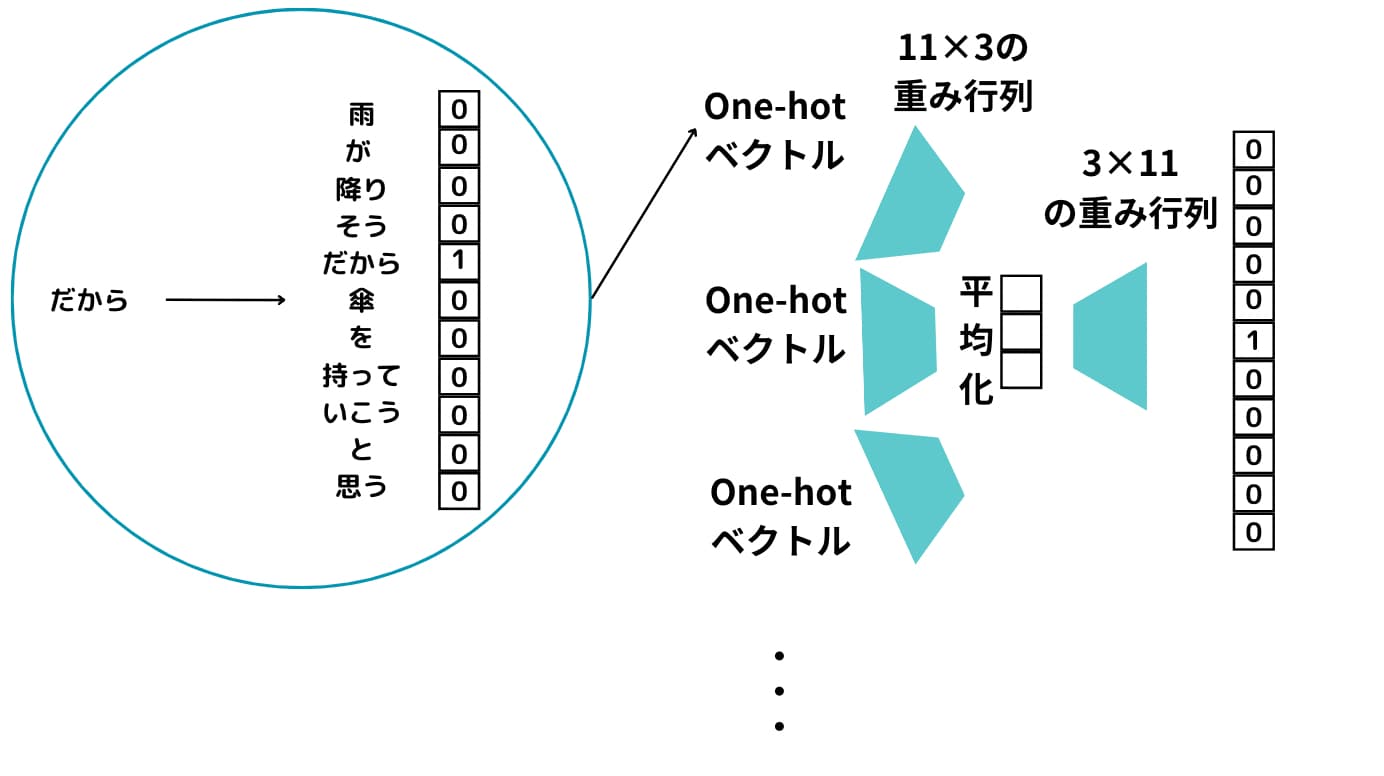
シンプルな2層構造のニューラルネットワークになることが分かりますね!
この時上手く出力結果が、「傘」になるようにニューラルネットワークの重みを調整します。
この過程で出力される重み行列の各行がWord2Vecで求められる単語ベクトルになるんです!
つまり、特定単語の前後から特定単語を予測する問題を解いている過程で生成されるベクトルがまさにWord2Vecで手に入れたい単語ベクトルになるんです。
 【入門】自然言語処理でできることをいくつかPythonで実装してみる!当サイト【スタビジ】の本記事では、自然言語処理についてPythonでの実装と合わせてまとめていきたいと思います。実際にテキスト情報を形態素解析で分解してテキスト類似度を計算したり、空欄を予測したりすることができるんです!
Skip-gram
Skip-gramはCBOWの逆です。
特定の単語から前後の単語を予測するモデルを構築します。
Skip-gramの方が精度が高いですが、計算負荷が高く処理に時間がかかります。
ちなみにWord2Vecの派生版で文書をベクトル化するアプローチであるDoc2Vecについては以下の記事で解説していますので是非チェックしてみてください!
 自然言語処理領域で重要なDoc2Vecの仕組みとPython実装についてわかりやすく解説!当サイト【スタビジ】の本記事では、Doc2Vecについて解説していきます!Doc2Vecは文書をベクトル化するアプローチでWord2Vecの派生型です。Pythonでの実装と合わせて理解しておきましょう!
Word2VecをPythonで実装
それでは、Word2VecをPythonで実装してみましょう!
Pythonでの実装方法は極めて簡単です。
以下がコードです。MeCabという形態素解析のツールを使っているのですが、MeCabを使えるようにするには少々前準備が必要なので使ったことがない人は以下を参考にしてみてください。
Pythonで文書類似度算出!MeCabで形態素解析後にTf-idfとCos類似度を使ってみよう当サイト【スタビジ】の本記事では、形態素解析器であるMeCabとPythonを用いて形態素解析を行いその後Tf-idfとCos類似度を使い最終的に文章の類似度を算出していきます。また、文章の著者が誰なのかをMeCabとLight gbmを用いて予測していきます。非常に簡単に実装できるかつ応用度が高いです!自然言語処理の世界に入るきっかけにしてくださいね!
from gensim.models import Word2Vec
import MeCab


# MeCabのTokenizer初期化
m = MeCab.Tagger("-Owakati")

# サンプルの文章データ
raw_sentences = [
    "猫は外を歩いている。",
    "夏の夜は暑くて寝苦しい。",
    "彼はりんごとオレンジを食べた。",
    "電車は時間通りに到着した。",
    "子供たちは公園で遊んでいる。"
]

# 文章を単語に分割
sentences = [m.parse(sentence).strip().split() for sentence in raw_sentences]

# Word2Vecモデルの初期化とトレーニング
model = Word2Vec(sentences, vector_size=100, window=5, min_count=1, workers=4)

# モデルの保存
model.save("word2vec_example.model")

# 保存したモデルのロード
model = Word2Vec.load("word2vec_example.model")

# 似ている単語を取得
similar_words = model.wv.most_similar("猫", topn=5)
print(similar_words)
これで猫と近いベクトル表現を持つ単語を取得できます。
今回は自分でサンプル文章を用意して学習しましたが、本来はもっと大量の文章で学習します。
もしくは学習済みモデルを利用するのが良いでしょう!
当メディアが運営する教育サービス「スタビジアカデミー」の自然言語処理コースでは、livedoorニュースのテキストを利用してWord2Vecで学習していますので参考にしてみてください。
Word2Vec まとめ
ここまでご覧いただきありがとうございました!
本記事では、Word2Vecについて簡単に解説してきました!
Word2Vecは自然言語処理分野の中で非常に有名な手法ですので是非この機会におさえておきましょう!
ちなみにOpenAIがEmbeddingAPIという単語をベクトル化するAPIを提供しており、そちらを使えば簡易的に単語をベクトル化することが可能です(少々API利用料がかかりますが・・・)。
以下の記事で詳しく解説しているのでぜひチェックしてみてください!
 OpenAIのEmbeddings APIを使って文章の類似度算出をPythonで実装!当サイト【スタビジ】の本記事では、OpenAIのEmbedding APIについての解説と実際にPythonでEmbeddingAPIを使ってテキストの類似度を測るデモを実装していきます。Embedding APIを使うことで非常に安価に高精度の自然言語処理プログラムが作れるのでぜひ理解しておきましょう!
先ほどもお伝えしましたが、自然言語処理についてもっと詳しく知りたいという方は当メディアが運営する教育サービス「スタアカ(スタビジアカデミー)」の自然言語処理講座をチェックしてみてください。
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
データサイエンティストとしての自分の経験をふまえてエッセンスを詰め込んだのがこちらのスタビジアカデミー、略して「スタアカ」!!
月額1,280円のライトプランで、統計学から機械学習・生成AIまで全コースが受講し放題です!
プレミアムプランでは、24時間以内の質問対応と現役データサイエンティストとの1on1(30分×4回)を実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
他のスクールのカリキュラムはPythonでの機械学習実装だけに焦点が当たっているものが多く、実務に即した内容になっていないものが多いです。
そんな課題感に対して、実務で使うことの多いSQLや機械学習のビジネス導入プロセスの理解なども合わせて学べるボリューム満点のコースになっています!
Pythonが初めての人でも学べるようなカリキュラムにしておりますので是非チェックしてみてください!
ウォルマートのデータを使って商品の予測分析をしたり、実務で使うことの多いGoogleプロダクトのBigQueryを使って投球分析をしたり、データサイエンティストに必要なビジネス・マーケティングの基礎を学んでマーケティングプランを作ってもらったりする盛りだくさんの内容になってます!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「自然言語処理」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。