多変量解析の基礎をRで実装しながら学んでいこう!

目次
 ウマたん
本記事では、データの構造把握に役立つ多変量解析について見ていきます。多変量解析とは予測的な観点ではなくあくまで現状データの構造把握に端を発していることが特徴です。Rでの実装も同時に行いながら理解を深めていきましょう!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です。
統計学の分野で、記述統計学→推計統計学→単変量解析と来て、続いて応用的に登場するのが多変量解析!
複数の変数が存在するデータの構造を把握しパターンを見出すことに秀でた手法です。
 ロボたん
多変量解析って難しそう!単純ではないんでしょ?
ウマたんそんなに難しくない!ただ、いきなり理論から入ってしまうとモチベーションが続かない場合が多いからRでの実装も行いながら学んでいこう!
多変量解析は、昔から存在する手法であっても現在も実務で使われているケースが多いです。
多変量解析をマスターしておくことで必ず実務の場面で役立ちます。
ということで、この記事ではそんな多変量解析について見ていきたいと思います!
多変量解析とは
まずは、多変量解析とはどのような手法群なのか詳しく見ていきましょう!
以下のYoutube動画でも詳しく解説していますよ!

多変量解析とは、その名の通り「複数の変数を持った手元のデータを解析して何かしらの知見を得ること」。
よくマーケティングの文脈で用いられるのが、売れる商品の傾向を多変量解析で見ていった時に「おむつとビールの売上に相関があった」と。
これによりビールとおむつを近くに置くことで売上がアップしたそうな。
※ウォルマートの例で、本当の話なのかは紆余曲折あります
このように大量にある商品の売上の相関を調べることで、新たな傾向を見つけることができました。
この手の分析はアソシエーション分析と呼ばれ、回帰分析を行う前手に使われることが多いです。
このように統計学に端を発する多変量解析では、既存の大量データの構造を分析して何かしらの特徴を得ることを最終ゴールとします。
実は、その部分が機械学習と違う部分。
機械学習は現状のデータ構造の把握よりもとにかく未知データの予測精度を上げることを最終ゴールとすることが多いです。
機械学習と統計学の違いについては以下の記事で詳しくまとめています!
 機械学習と統計学/多変量解析の違いについてデータサイエンティストがモノ申す!!当サイト【スタビジ】の本記事では、データサイエンスの領域の機械学習と統計学の違いについて考察していきます。定義と境界が曖昧な2つの領域ですが、目的の違いを理解しておくことが大事。機械学習は予測精度を上げることを目的とし統計学はデータ構造の把握をすることを目的とします。
多変量解析の種類とRでの実装
続いて多変量解析にはどんな種類があるのか見ていきましょう!
適宜Rでの実装もあわせておこなっていきますよー!
重回帰分析
多変量解析の中でまず初めに覚えておいてほしい手法が、重回帰分析。
回帰分析とは「ある変数を用いて他の変数を説明(予測)するモデルを作ること」です。
土地の価格を築年数や駅からの距離や広さなどの変数で説明するみたいなモデルがよくカリキュラムに出てきますねー!
n個のサンプルがあるデータセットで一つの目的変数をp個の説明変数で説明するモデルを作ると以下のようになります。
:目的変数、:ある定数、:ある係数、:誤差項を表しています。また添え字のiはサンプルを表します。
重回帰分析は全ての手法の原点であり、絶対に抑えて欲しい手法です。
重回帰分析についてはRでの実装方法含め以下の記事で詳しくまとめていますのでチェックしてみてください!
回帰分析の理論とRでの実装!当サイト【スタビジ】の本記事では、統計学・データサイエンスの基本である回帰分析について理論とRでの実装を見ていきます。回帰分析についてしっかりおさえておくことで機械学習など高度な手法についても理解が深まります。
ウマたん一番オーソドックスな手法だね!
主成分分析
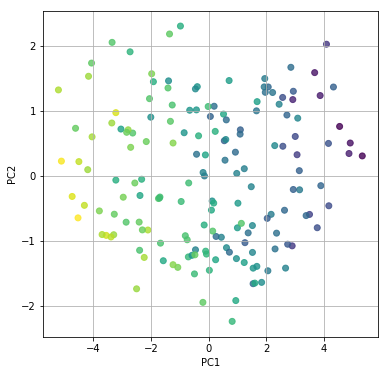
主成分分析は、1900年代前半にピアソンやホテリングにより導かれた手法であり長い歴史を持っています。
教師データ(正解データ)がいらない手法であり、手元にあるデータの次元を圧縮し構造化するのに優れています。
良く主成分分析の例として取り上げられるのが学校の成績の例。
生徒それぞれに対して算数・国語・理科・社会の点数が変数として存在します。
そんなデータセットに対して主成分分析をかけると、見事に2つの変数に集約することができます。
算数と理科は理系の能力、国語と社会は文系の能力。元々4つあった変数を2つの理系・文系という能力に集約することができるのです。
データの構造を分かりやすくすることが可能です。
変数が多くデータの構造が分かりにくい時は、主成分分析をかけてみると良いでしょう。
主成分分析については以下の記事で詳しくまとめています!
 主成分分析とは?簡単な説明とPythonでの実装!当サイト【スタビジ】の本記事では、実務の基礎分析にて使われることの多い主成分分析について詳しく見ていきます。最後にはカンタンなPythonでの実装も載せていますのでぜひ参考にしてみてください!
コレスポンデンス分析
多変量解析手法の1つでありアンケート調査の可視化などに使われる「コレスポンデンス分析」
コレスポンデンス分析は、データの可視化に非常に優れた手法であり、マーケティングの場でよく使われます。
それでは、早速コレスポンデンス分析をRで実装してみます。
使用するデータは、統計科学研究所の「成績データ」。以下のURLからダウンロードできます。
https://statistics.co.jp/reference/statistical_data/statistical_data.htm
| kokugo | shakai | sugaku | rika | ongaku | bijutu | taiiku | gika | eigo |
| 30 | 43 | 51 | 63 | 60 | 66 | 37 | 44 | 20 |
| 39 | 21 | 49 | 56 | 70 | 72 | 56 | 63 | 16 |
| 29 | 30 | 23 | 57 | 69 | 76 | 33 | 54 | 6 |
| 95 | 87 | 77 | 100 | 77 | 82 | 78 | 96 | 87 |
| 70 | 71 | 78 | 67 | 72 | 82 | 46 | 63 | 44 |
| 67 | 53 | 56 | 61 | 61 | 76 | 70 | 66 | 40 |
| 29 | 26 | 44 | 52 | 37 | 68 | 33 | 43 | 13 |
9科目の点数が166人分入ってます。
166人から30人抽出してコレスポンデンス分析にかけてみます。
コレスポンデンス分析はMASSパッケージのcorrepという関数で行うことが可能です。
コードは以下のように非常に簡単に実装が可能なんです。
library(MASS)
seiseki<-read.csv('seiseki.csv')
seiseki<-seiseki[c(1:30),]
seiseki.ca<-corresp(seiseki,nf=2)
biplot(seiseki.ca)
最後の行で、結果をプロットしています。
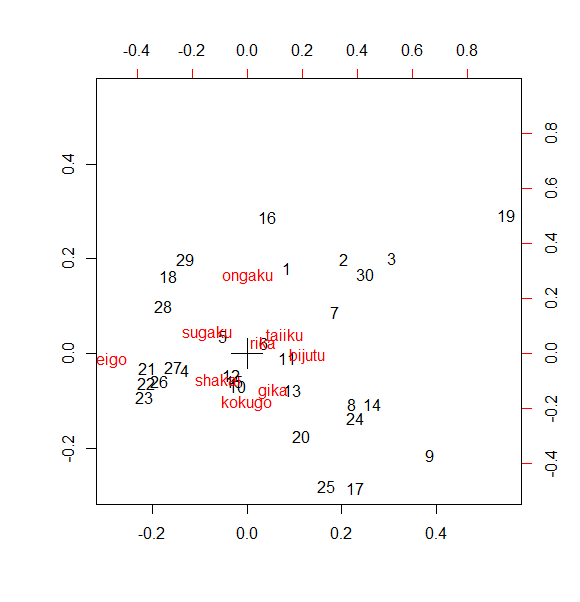
音楽と英語が他の科目と少し離れていることが分かります。
これにより、科目同士の近さや生徒の強い科目などが可視化することができました。
コレスポンデンス分析については以下の記事で詳しくまとめています!
 コレスポンデンス分析とは?Rでのやり方を見ていこう!当サイト【スタビジ】の本記事では、マーケティングで用いられることの多い統計的手法「コレスポンデンス分析」について簡単に解説していきたいと思います。Rを使えば簡単に実装できるので合わせて実装方法も見ていきますよー!
コンジョイント分析
消費者にとって、商品のどんな機能が響くのか知りたい場合に用いられる「コンジョイント分析」
直接的に機能の良し悪しを聞くのではなく様々なスペックの商品に点数を付けてもらうことにより機能の効用値を算出するのがコンジョイント分析になります。
コンジョイント分析を行うことで、消費者にとって最適なスペックを把握することができます。
それでは、コンジョイント分析をRで実装していきましょう!
パッケージ「conjoint」を用います。
library(conjoint)
data(tea)#サンプルデータ
#コンジョイント分析用のデータ
print(tprof) #各プロファイルの表示
print(tlevn) #各水準
head(tprefm) #効用データ(100人分)
Conjoint(tprefm, tprof, tlevn) #コンジョイント分析
teaというデータセットに入っている、プロファイルデータを使ってコンジョイント分析を行います。
tprofは以下のようなプロファイルデータ。
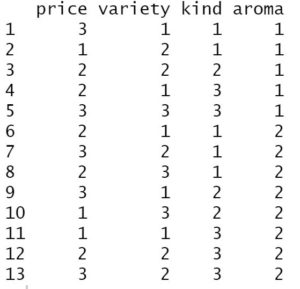
tlevnにはそれぞれの水準データが入っています。
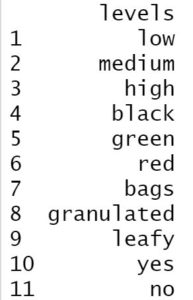
分かりにくいのですが、この商品プロファイルは3水準×3水準×3水準×2水準になっており、priceの水準が「low/medium/high」、varietyの水準が「black/green/red」、kindの水準が「bags/granulated/leafty」、aromaの水準が「yes/no」。
最後にそれらに対する効用値が100人分入ったデータがtprefm。
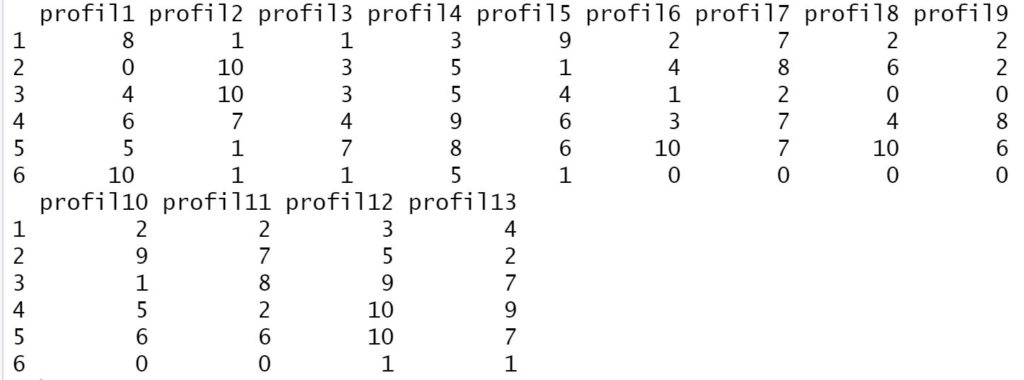
これらのデータをコンジョイント分析にかけると、自動的にグラフをプロットしてくれます。
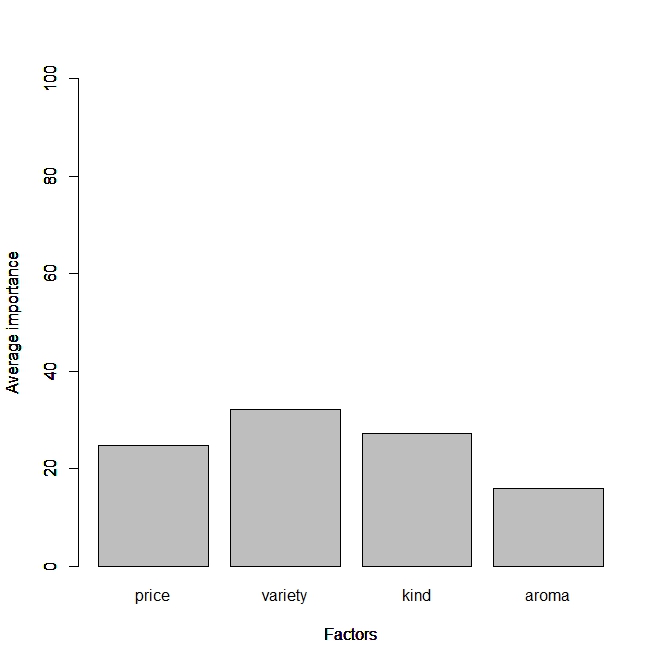
これにより要因ごとの寄与率が分かります。varietyの寄与率が若干高いですねー。
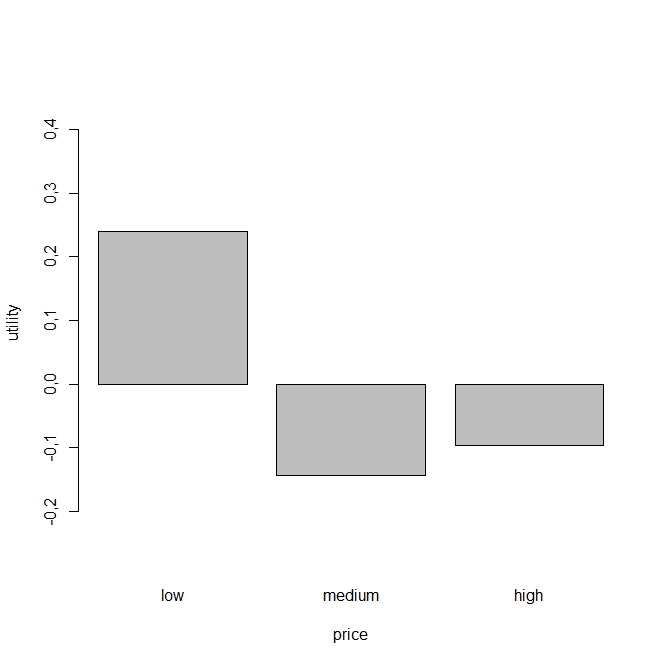
価格の部分効用値が分かります。
コンジョイント分析については以下の記事で詳しくまとめています!
コンジョイント分析とは?特徴とRでのやり方を見ていこう!当サイト【スタビジ】の本記事では、マーケティングにおける消費者調査の分析に使われるコンジョイント分析をカンタンに解説していきます。Rでの実装も合わせておこなっていくので、ぜひ自分の手を動かして実装してみてくださいね!
階層的クラスター分析
教師なし学習の定番として取り上げられるクラスター分析!
手元のデータの特徴を基に、ある規則によってグループ分けします。
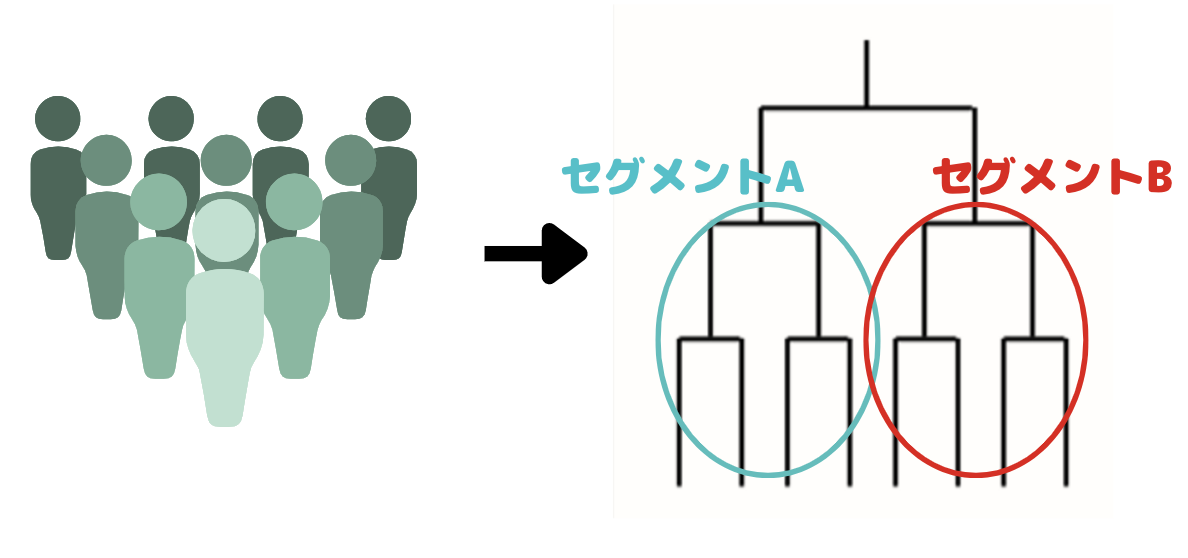
クラスター分析には階層的なタイプと非階層的なタイプがあり、階層的なタイプの方がどのようにグループ分けされたかが可視化され分かりやすくなっています。
一方、大規模データでは非階層的クラスター分析の方が計算負荷が低いため、実データでは専ら非階層的クラスター分析が使われるのが一般的です
クラスター分析については以下の記事でまとめています!
 【5分で分かる】クラスター分析のPythonとRでの実装方法を見ていこう!当サイト【スタビジ】の本記事では、クラスター分析についてまとめていきます。クラスター分析は教師なし学習の定番手法で、データの構造や傾向を把握するのに非常に役立ちます。クラスター分析を利用してデータを可視化してみましょう!
k-means
k-means法はまさに非階層のクラスター分析!
一般的にビジネスの場では膨大なデータを扱うことが多いため非階層的クラスター分析が良く用いられます。
k-means法では、パラメータを基にクラスターの数をあらかじめ決めておきます。
そのクラスターの数に応じて何回かの分類処理を経て最終的にクラスター分けを行うのがk-means法の特徴です。
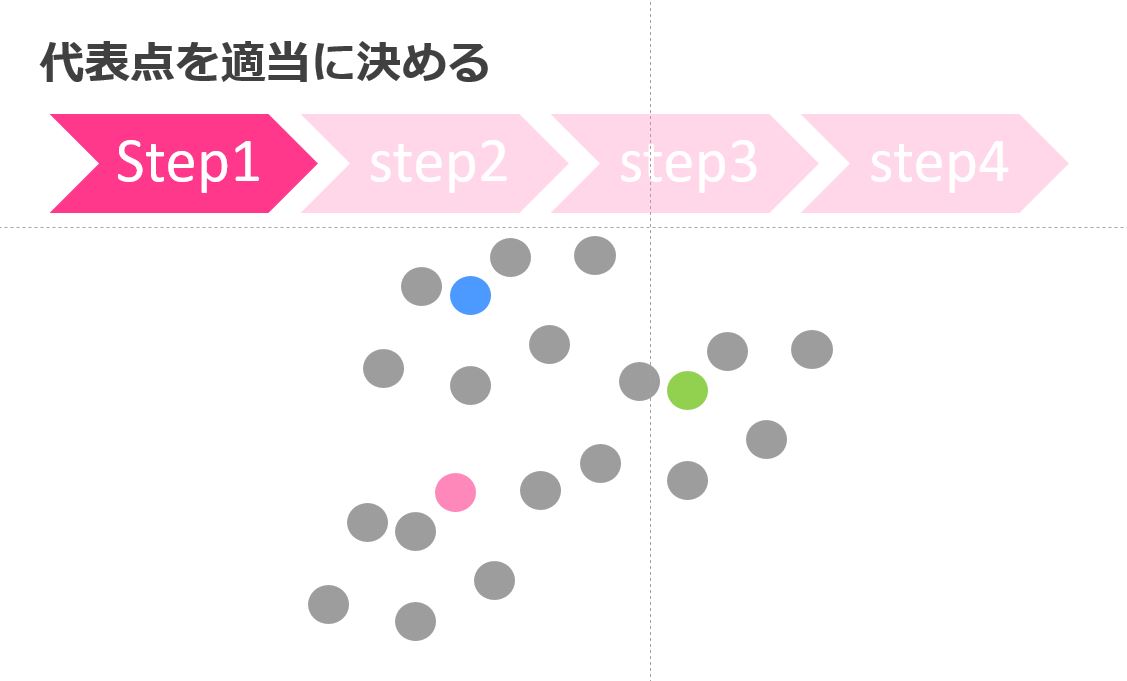
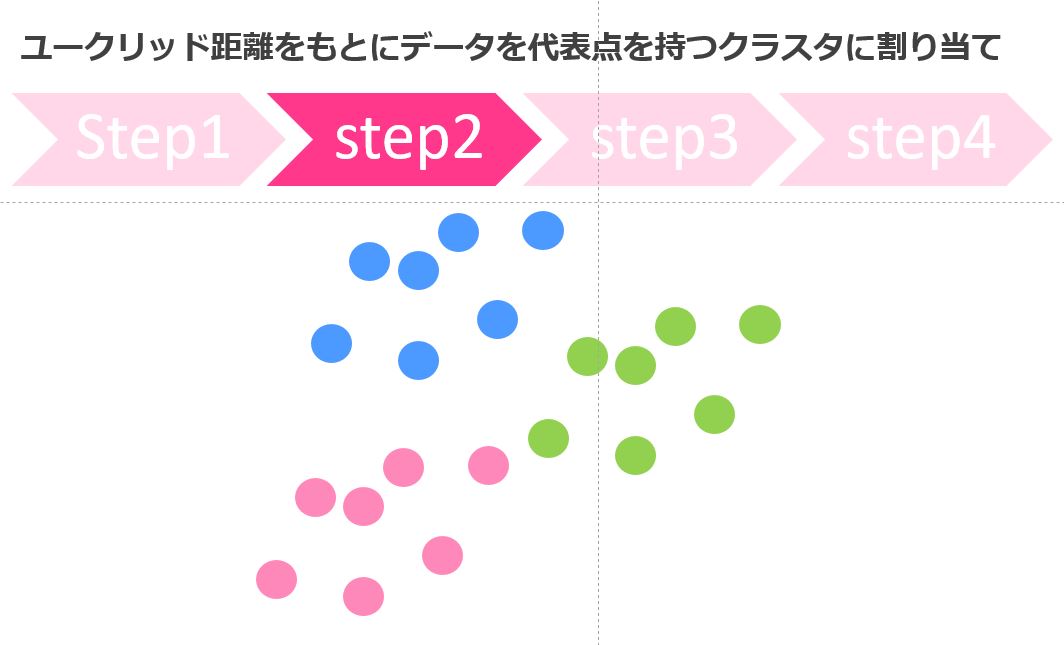
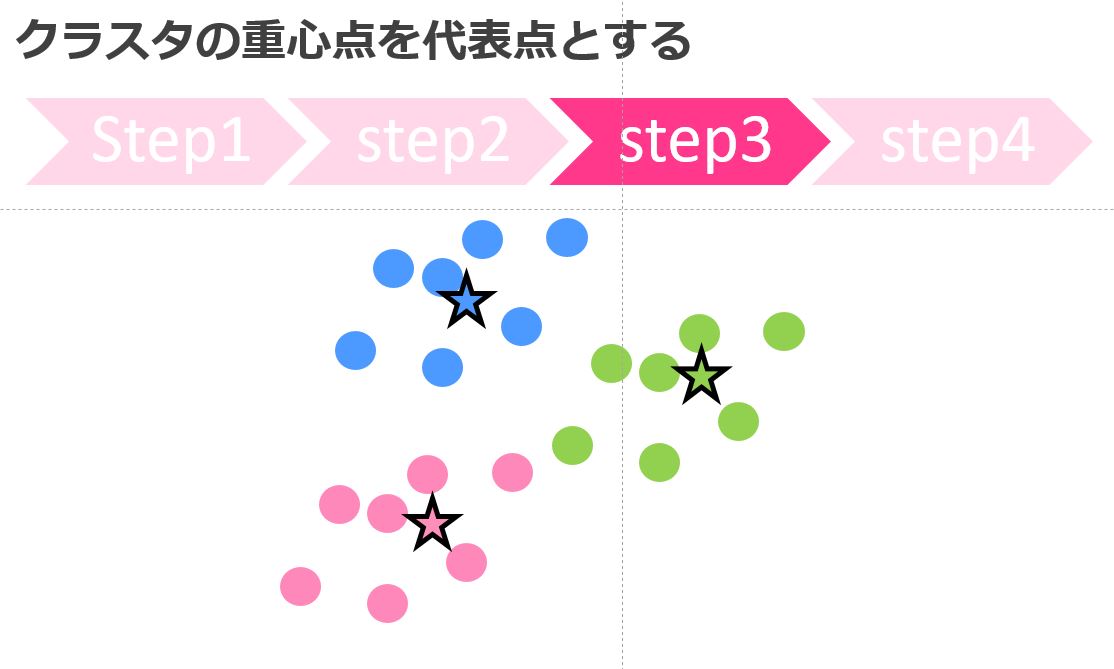
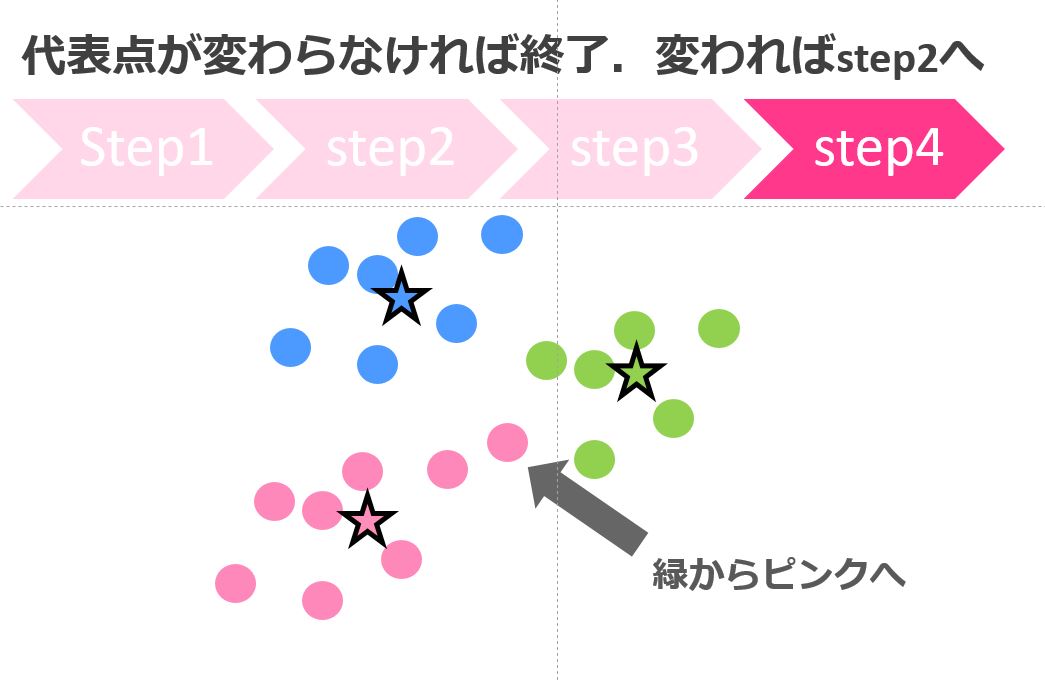
Rのパッケージで簡単に実装できるのでおこなってみましょうー!
irisというめちゃんこ有名なR内のデータセット(150サンプル5変数で花びらの特徴を表したデータセット)を使います。
3つの花のタイプに分かれているので、そのラベルがk-means法とx-means法で上手く分類できるかどうか見ていきますよー!
data<-iris
data_train<-data[,-5]#5列目はラベルなので削除
km<-kmeans(data_train,3)
km$cluster
table(data[,5],km$cluster)#本物のラベルとグループ分けを比較

# ----xmeans------
xm<-xmeans(data_train,3)
table(data[,5],xm$cluster)#本物のラベルとグループ分けを比較
実際に行ってみた結果がこちら
■k-means法
| 1 | 2 | 3 | |
| setosa | 0 | 50 | 0 |
| versicolor | 48 | 0 | 2 |
| virginica | 14 | 0 | 36 |
Verginicaは少し外してますが、それ以外は比較的当たってますね!
正答率は89%です。
k-means法について以下の記事でまとめていますのでよければチェックしてみてください!
【5分でわかりやすく解説】k-means法とは?RとPythonで実装してみよう!当サイト【スタビジ】の本記事では、非階層クラスター分析のk-means法について徹底的に解説していきます。メリットとデメリットがあるので使う際は注意しましょう!x-means法という改良手法も合わせて一緒に見ていきますよー!
ロボたん使えたら便利そうな手法ばかりだけど、やっぱり勉強が大変そう、、、
ウマたんそんなキミのために、学習方法を紹介していくよ!
多変量解析を学ぶ方法
多変量解析について詳しく見てきましたが、どのように勉強すれば良いのか勉強法について見ていきましょう!
多変量解析は統計学の基礎知識を身に付けた後に学ぶ手法群です。
統計学の基礎知識がまだ身に付いていないよ、という方は以下の記事を参考にしてみてください!
 【初心者必見】統計学入門に必要な知識と独学勉強方法を簡単に学ぼう!当ブログ【スタビジ】の本記事では、統計学入門に必要な知識をカンタンにまとめ、それらをどのように効率的に独学で勉強していけばよいかをお話ししていきます。統計学は難しいイメージが少しありますが、学び方をしっかり考えれば大丈夫!
書籍で学ぶ
多変量解析に関しては有用な書籍がいくつかあります。
書籍で学べる自信のある人はぜひ書籍で学んでみましょう!
多変量解析入門

多変量解析の幅広い知識を身に付けたいなら手っ取り早いのがこちらの多変量解析法入門。
基礎となる回帰のお話から主成分分析などの話が丁寧に分かりやすく載っています。
単回帰、重回帰、判別分析、主成分分析のところは丁寧に読み込んでおくと良いでしょう。
データ解析モデリング

緑本とデータサイエンス界隈で呼ばれる超名著!
多変量解析における回帰系の分析手法から複雑な混合分布を仮定した一般化線形混合モデルの話までの流れを理解しておく上で非常に有用な本です。
多変量解析の世界からベイズ統計学・機械学習への橋渡しに最適です。
他の多変量解析の本に関しても以下の記事でまとめていますのでチェックしてみてくださいね!
 厳選7冊!多変量解析を勉強する上でおすすめな本!当サイト【スタビジ】の本記事では、推計統計学の発展手法である多変量解析手法を学ぶのにおすすめな書籍をまとめていきます。多変量解析はデータの解釈を行うことに端を発しており、機械学習はデータの予測を行うことに端を発しています。
Webサービスで学ぶ
多変量解析を学ぶのであればWebサービスを利用してみるのも手です!
手前味噌ですが、以下のUdemy講座で分かりやすく多変量解析の各手法の説明とPython(Rじゃなくてすいません)による実装をまとめています!
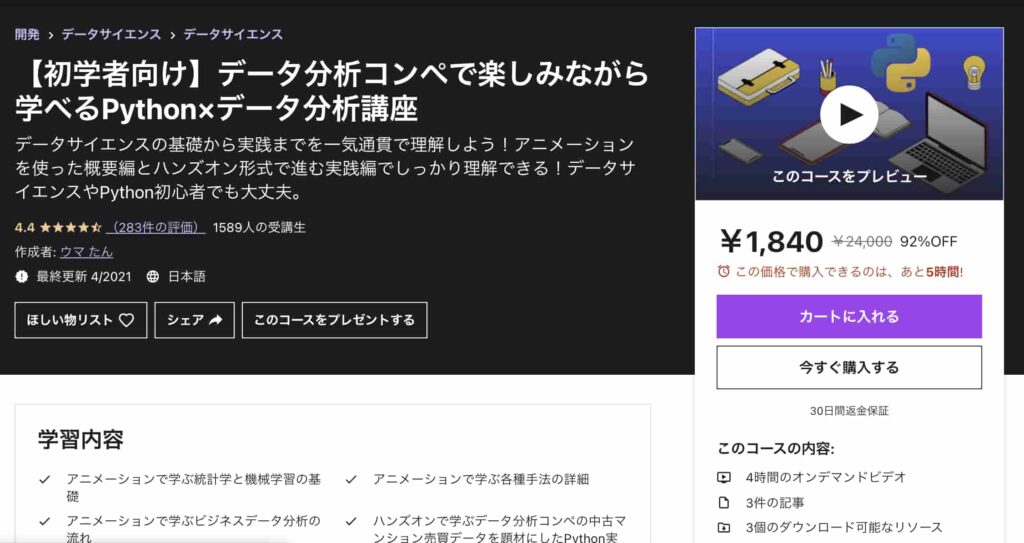
【初学者向け】データ分析コンペで楽しみながら学べるPython×データ分析講座
| 【オススメ度】 | |
|---|---|
| 【講師】 | 僕自身!今なら購入時に「NZWCLGF4BTZENY6E」という講師クーポンコードを入れると90%オフ以上の割引価格になりますのでぜひご受講ください! |
| 【時間】 | 4時間 |
| 【レベル】 | 初級~中級 |
このコースは、なかなか勉強する時間がないという方に向けてコンパクトに分かりやすく必要最低限の時間で重要なエッセンスを学び取れるように作成しています。
アニメーションを使った概要編とハンズオン形式で進む実践編に分かれており、概要編ではYoutubeの内容をより体系的にデータ分析・機械学習導入の文脈でまとめています。
データサイエンスの基礎について基本のキから学びつつ、なるべく堅苦しい説明は抜きにしてイメージを掴んでいきます。
是非興味のある方は受講してみてください!
ウマたん今なら購入時に「NZWCLGF4BTZENY6E」という講師クーポンコードを入れると90%オフ以上の割引価格になりますのでぜひご受講ください!
\30日以内なら返金無料/
スタアカ(スタビジアカデミー)で学ぶ
 公式サイト:https://toukei-lab.com/achademy/
| 【価格】 | ライトプラン:1280円/月 プレミアムプラン:149,800円 |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | データサイエンスを網羅的に学ぶ 実践的なビジネスフレームワークを学ぶ SQLとPythonを組みあわせて実データを使った様々なワークを行う マーケティングの実行プラン策定 マーケティングとデータ分析の掛け合わせで集客マネタイズ |
データサイエンティストとしての自分の経験をふまえてエッセンスを詰め込んだのがこちらのスタビジアカデミー、略して「スタアカ」!!
当メディアが運営するスクールです。
多変量解析だけでなくデータサイエンスに必要な広範な範囲を網羅的に学ぶことが可能です!
24時間以内の質問対応と現役データサイエンティストによる1週間に1回のメンタリングを実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
他のスクールのカリキュラムはPythonでの機械学習実装だけに焦点が当たっているものが多く、実務に即した内容になっていないものが多いです。
そんな課題感に対して、実務で使うことの多いSQLや機械学習のビジネス導入プロセスの理解などもあわせて学べるボリューム満点のコースになっています!
ウォルマートのデータを使って商品の予測分析をしたり、実務で使うことの多いGoogleプロダクトのBigQueryを使って投球分析をしたり、データサイエンティストに必要なビジネス・マーケティングの基礎を学んでマーケティングプランを作ってもらったり・Webサイト構築してデータ基盤構築してWebマーケ×データ分析実践してもらったりする盛りだくさんの内容になってます!
\今すぐ試す/
ご受講お待ちしております!
データサイエンティストを目指す人向けのスクールに関しては以下の記事で比較しておりますので是非チェックしてみてください!
 【徹底比較】データサイエンティストになるための学習ができるスクール9選!当サイト【スタビジ】の本記事では、データサイエンティストへの学習ができるスクールを紹介していきます。スクールに通ったからと言ってデータサイエンティストになれるわけではありませんが、データサイエンティストへの基本を着実に固めることは可能です…
多変量解析 まとめ
本記事では、多変量解析の手法とRでの実装、そして最終的には多変量解析の勉強法について見てきました!
最後に多変量解析の種類についてまとめておきましょう!
ロボたんこの後はどうやって勉強を進めたら良いの?
ウマたん機械学習やディープラーニングなどさらに高度な手法を学ぶか、Pythonの能力を磨くか自分の進みたい方向に進むとよいよ!
以下の記事でそれぞれの勉強法についてまとめているのでチェックしてみてください!
 【入門】機械学習のアルゴリズム・手法をPythonとRの実装と一緒に解説!当サイト【スタビジ】の本記事では、入門者向けに機械学習についてカンタンにまとめていきます。最終的にはどのように機械学習を学んでいけばよいかも見ていきます。細かい手法の実装もPython/Rを用いておこなっていくので適宜参考にしてみてください。
 【初心者向け】ディープラーニングの勉強ロードマップまとめ!当サイト【スタビジ】本記事では、ディープラーニングの学習方法について詳しくまとめていきます!ディープラーニングは難しいと思われがちですが、アルゴリズムは意外とシンプルで実装自体も非常に簡単なんです!Pythonでの実装もおこなっていきますよー!
 【Python独学勉強法】Python入門を3ヶ月で習得できる学習ロードマップ当サイト【スタビジ】の本記事では、過去僕自身がPythonを独学を駆使しながら習得した経験をもとにPythonを効率よく勉強する方法を具体的なコード付き実装例と合わせてまとめていきます。Pythonはできることが幅広いので自分のやりたいことを明確にして勉強法を選ぶことが大事です。
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、手を動かして身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。
スタアカを見てみる