ロジスティック回帰の理論とRによる実装方法を徹底解説!
目次
 ウマたん
本記事では、ロジスティック回帰についてRでの実装と共に見ていきます。ロジスティック回帰は2値分類問題において解釈がしやすく実務の場でもよく用いられている手法です。最後に理論と実装をより深く学ぶ勉強法も紹介していきますよー!
データサイエンティストのウマたん(@statistics1012)です!
一般化線形モデルの一つである、ロジスティック回帰。
有名であり基本的な手法ですが、実務でもよく使われる汎用性の高い手法です。
ロジスティック回帰は多変量解析という分野以外に機械学習という枠組みでも基本的な手法として出てきます。
この記事では、そんなロジスティック回帰について見ていきたいと思います。
ウマたんビジネスの場でもよく出てくる手法だから要チェックだ!
ロジスティック回帰の適用場面
回帰分析は目的変数に負の値でも正の値でもとる連続変量を考えていました。
より正確にいうと、線形回帰において説明変数を与えた時のの条件付き分布には正規分布を仮定しています。
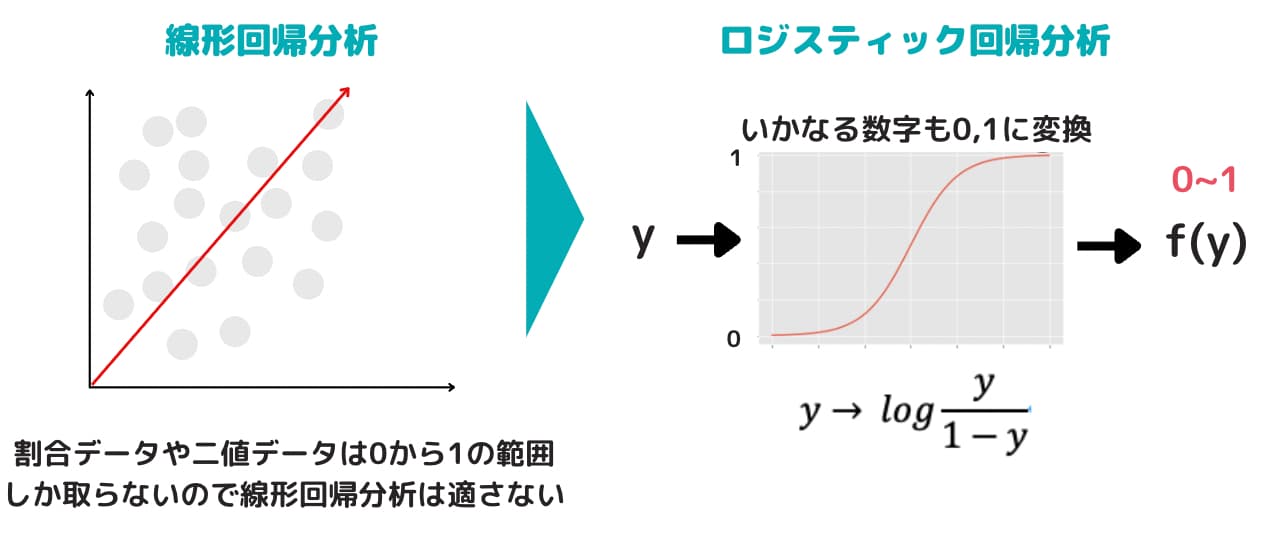
しかし、世の中には、「100人中70人の病気が治った。」や「ある会社が倒産したかどうか」などの割合データや二値データが存在します。
どちらも、値は0から1の範囲しかとりません。
この時、線形回帰を行うとどうなるでしょうか。
推定された目的変数は負の値になったり1を超える場合もあり、扱いに困ってしまいます。
そんな時に用いる方法がロジスティック回帰です。
以下の動画でも解説していますので是非チェックしてみてください!

その他の手法含む機械学習系、その他のAI用語を一挙にまとめた以下の記事も合わせて要チェックです!
 【これだけはおさえておきたい!】ビジネスで役立つAI用語45選まとめ!当サイト【スタビジ】の本記事では、ディープラーニング系/機械学習系/統計学系の3つのカテゴリに分けて重要な用語を説明していきます!
ロジスティック回帰モデル
それでは、具体的にロジスティック回帰モデルとは何なのか見ていきましょう
Using components of linear regression reflected in the logit scale, logistic regression iteratively identifies the strongest linear combination of variables with the greatest probability of detecting the observed outcome.
引用元:Google-“Logistic Regression: A Brief Primer”
ロジスティック回帰が用いられる場面は目的変数が二値もしくは割合データの場合です。
二値や割合データが従う分布として最も考えられやすいものは二項分布です。
例えば、「個体中個体が生存した」というデータは、に従うと考えます。この時、が未知パラメータになります。
このと(線形予測子と呼びます。)を紐付ける関数を考えてみましょう。
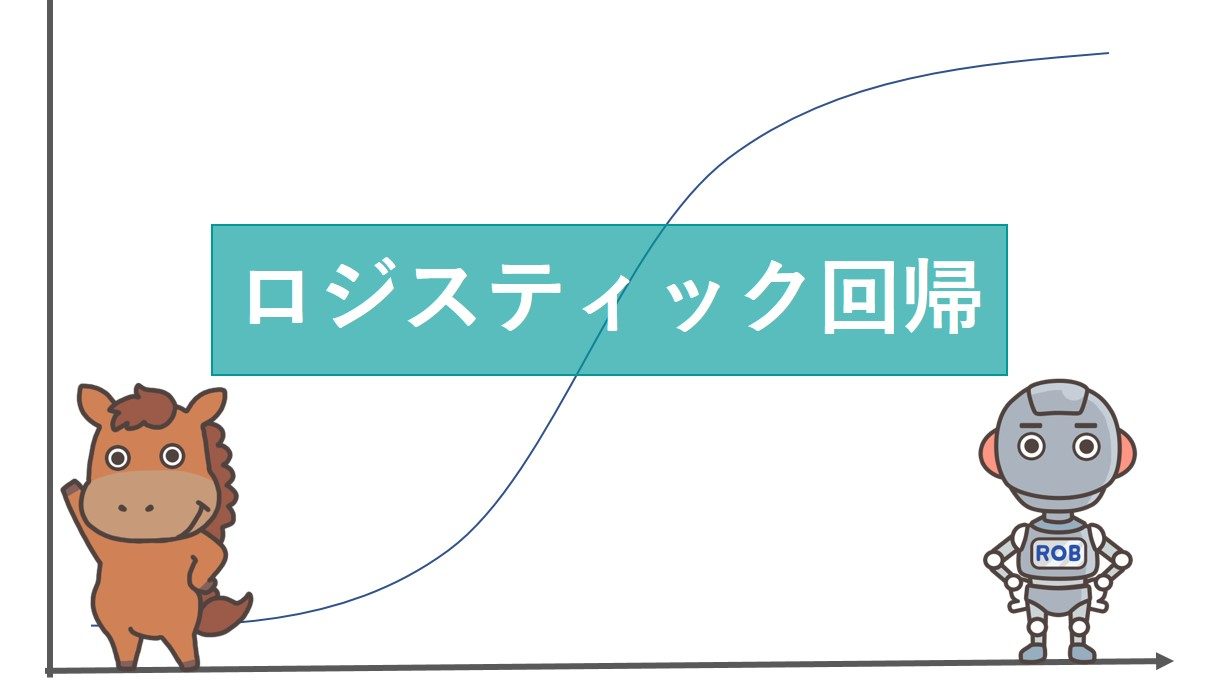
は0から1の範囲の値しか取らないので、が正の無限大になっても負の無限大になっても0~1の範囲に収まっており、また、単調な関数が良いです。そこで、次の様な関数を用いてと紐付けます。
この右辺の関数のことをロジスティック関数と呼びます(だからロジスティック回帰)。
こうすることで、を求めればが分かり、の従う分布を把握できる様になりました。
では次に、どの様にしてを求めていくかを考えていきます。
先ほどの式を右辺がだけになる様に変換すると下の式の様になります。
左辺はをで割って対数をとったものになっています。を成功の確率と解釈すれば、は失敗の確率と捉えることができます。
このはオッズと呼ばれます。オッズは結果の解釈で重要になるので後で改めて説明します。
また、オッズの対数をとるこの変換をロジット変換と呼び、とも表したりします。
この変換によって、回帰分析っぽくなりました。
さて、ここからの推定に入っていきます。
の推定方法
ロジット変換によって回帰分析っぽい式になりました。
ロジスティック回帰ではの推定方法は重み付き最小二乗法と最尤法の二種類があります。
重み付き最小二乗法
最小二乗法によっての推定を行いたいのですが、最小二乗法を用いる時によいとされるのは目的変数の条件付き分布がサンプルに対して等分散の正規分布に従うと考えられる時です。
ここで、の分布を考えてみましょう。
まず、得られているデータからを作るためとします。は二項分布に従うと考えているため、期待値と分散は次の様になります。
次に、の分散をデルタ法で近似します。
二項分布と正規分布の性質よりが十分大きい時、正規分布に従うと見なせます。
そして、重みをにかけることで、等分散性を確保してから最小二乗法を行います。
重みを付けているため重み付き最小二乗法と呼びます。
最尤法
重み付き最小二乗法は複雑な計算も必要なく手計算でも可能ですが、一つ大きな問題があります。それは、である時の二値データでは解析できないことです。
無理やり解析しても結果は不安定なものになります。そこで、現在ではコンピュータの発展により最尤法による推定が主流です。
目的変数は二項分布に従うというところから、尤度関数を導きます。
同時確率関数は
となるので、対数尤度関数は
ここから、をの式の方で書き直して、パラメータをのみにします。
そして、微分することでを推定します。
この計算は式で綺麗に求めるのは難しいためニュートン法などの数値計算方法を用いる必要があります。
ロジスティック回帰の結果解釈
得られたをどの様に解釈すれば良いでしょうか。
線形回帰であれば、偏回帰係数は他の変数が一定である基でその変数を1単位増加させた時に目的変数へ与える影響を表していました。
しかし、ロジスティック回帰の場合では、の大きさがロジスティック関数で変換されるので、よく分かりません。
そこで、オッズを使って解釈します。説明変数が3個のモデルで左辺をオッズにした式を下に示します。
ここで、変数1が1単位増えた時の式は次の様になります。
すると、変数1が1単位増える前の式との関係は次の様になります。
すなわち、「変数1が1単位増えるとオッズ比が倍になる。」という解釈ができます。
ロジスティック回帰で実際にデータ分析
続いて、ロジスティック回帰モデルの人工データを用いてロジスティック回帰・Lasso・Ridgeの精度比較を行います。
Lasso・Ridgeは回帰分析の一種でスパースなデータセットに対して効果的です。
スパース推定に関してはこちらの記事にまとめていますのであわせてご覧ください!
 スパース推定とは?理論とオススメ本を紹介!当サイト【スタビジ】の本記事では、スパース推定についてまとめていきます。スパース推定とは特定のパラメータを0と推定すること。はたしてパラメータを0と推定することでどのようなメリットがあるのでしょうか?
実験の設定と手順
実験の流れは簡単にこんな感じです。
- 人工データを生成
- データを解析
- 指標を算出して結果を格納
- 1~3を100回繰り返す
- 結果の平均とばらつきで比較
人工データ生成
今回のデータの生成モデルを次に示します。
線形回帰のときと同様で、説明変数は次元であり、平均0・独立で発生させています。
また、は次元ベクトルであり、変数1と変数2のみが目的変数へ寄与があります。
つまり、かなりスパースな設定になっています。
今回は、を5,10,50と変化させて実験してみます。
シミュレーション実験
シミュレーション実験をしてみましょう。
サンプルサイズは1100とします。
100個のデータを学習データ、残りの1000個のデータをテストデータとして実験します。
今回用いるコード(の場合)を載せておきます。
実行する前に入っていないパッケージはインストールしておいてください。
library(MASS)
library(mvtnorm)
library(glmnet)
library(ggplot2)
library(tidyr)

times <- 100 ##シミュレーション回数

n_train <- 100
n_test <- 1000
p <- 50 #変化させて実験

β0 <- 1 ##定数項
β <- c(1,-1,numeric(p-2))
β <- c(β0,β)

μ <- numeric(p)
Σ <- diag(p)


DISC <- data.frame(glm=numeric(times)+NaN, lasso=numeric(times)+NaN, ridge=numeric(times)+NaN)

for(t in 1:times){
  X <- rmvnorm((n_train+n_test),μ,Σ)
  X <- cbind(rep(1,(n_train+n_test)),X)
  q <- 1/(1+exp(-X%*%β))
  m <- rep(1,(n_train+n_test))
  # m <- floor(runif((n_train+n_test),10,31)) ##m~U(10,30)で発生(割合データになる)

  y <- c()
  for(i in 1:(n_train+n_test)) y <- c(y,rbinom(1,m[i],q[i]))

  data <- cbind(X,y,m)
  data <- as.data.frame(data)
  colnames(data) <- c("Int",paste0('x', 1:p),"y","m")

  ##学習データとテストデータを作成
  data_train <- data[1:n_train,]
  data_test <- data[-(1:n_train),]

  ##glm(普通の線形回帰)
  result_glm <- glm(formula=as.formula(paste("cbind(y,m-y) ~",paste(paste0('x', 1:p), collapse= "+"))),
                    data=data_train[,colnames(data_train)!="Int"], family=binomial(link="logit"))

  ##glmnet(lasso)
  result_lasso <- cv.glmnet(x=as.matrix(data_train[,!(colnames(data_train) %in% c("Int","y","m"))]),
                            y=cbind(data_train$m-data_train$y,data_train$y), family="binomial",alpha=1)

  ##glmnet(ridge)
  result_ridge <- cv.glmnet(x=as.matrix(data_train[,!(colnames(data_train) %in% c("Int","y","m"))]),
                            y=cbind(data_train$m-data_train$y,data_train$y), family="binomial",alpha=0)

  ##テストデータの誤判別率を算出
  qhat_glm <- 1/(1+exp(-as.matrix(data_test[,!(colnames(data_test) %in%
                                                 c("y","m"))])%*%as.matrix(result_glm$coefficients)))
  yhat_glm <- ifelse(qhat_glm<0.5,-1,1)
  y_glm <- ifelse(data_test$y==0,-1,1)
  disc <- y_glm*yhat_glm
  DISC$glm[t] <- length(disc[disc<0])/length(disc)

  qhat_lasso <- 1/(1+exp(-as.matrix(data_test[,!(colnames(data_test) %in%
                                                   c("y","m"))])%*%coefficients(result_lasso,s="lambda.min")))
  yhat_lasso <- ifelse(qhat_lasso<0.5,-1,1)
  y_lasso <- ifelse(data_test$y==0,-1,1)
  disc <- y_lasso*yhat_lasso
  DISC$lasso[t] <- length(disc[disc<0])/length(disc)

  qhat_ridge <- 1/(1+exp(-as.matrix(data_test[,!(colnames(data_test) %in%
                                                   c("y","m"))])%*%coefficients(result_ridge,s="lambda.min")))
  yhat_ridge <- ifelse(qhat_ridge<0.5,-1,1)
  y_ridge <- ifelse(data_test$y==0,-1,1)
  disc <- y_ridge*yhat_ridge
  DISC$ridge[t] <- length(disc[disc<0])/length(disc)

  cat("t=",t," ")
}

##ggplotで箱ひげ図を描く
g <- ggplot(gather(DISC), aes(y=value,x=key))
g <- g + geom_boxplot()
g <- g + xlab("Method")
g <- g + ylab("Error Rate")

plot(g)ばらつきも含めて見たいので結果を箱ひげ図で表します。
通常のロジスティック回帰はglmと表記してあります。
・の結果

やはり説明変数の数も多くないのでどの手法も同程度ですね。
・の結果
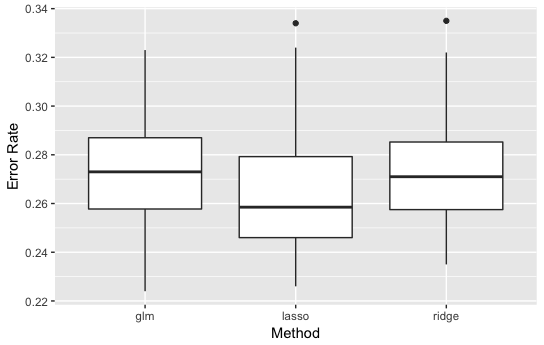
Lassoが少し良い精度を示しているように見えます。
・の結果
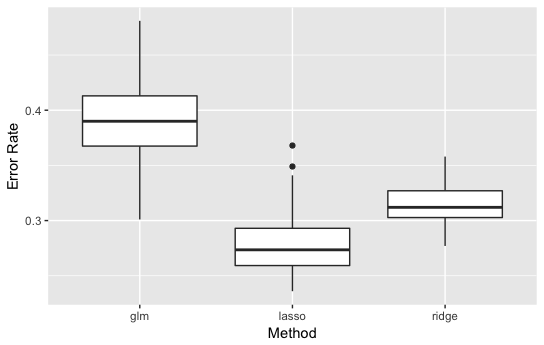
かなり、差が出ました。
線形回帰のときと同様でLassoタイプのロジスティック回帰が最も良くなりました。
また、実行してみるとglm()ではのとき警告メッセージが出てきてしまいます。これは、変数の数が多くて推定が不安定になったからと考えられます。
どうでしょうか。結果は予想通りでしたね!
精度比較の結果よりシミュレーションでロジスティック回帰モデルのデータの作り方や実際の解析の仕方を伝えたかったので分かっていただけたら嬉しいです!
ロジスティック回帰の勉強法
ロジスティック回帰の理論と実装について見てきました。
より深く知りたい方に向けてロジスティック回帰のおすすめ勉強法を紹介していきます。
理論を書籍で勉強
理論に関しては書籍にエッセンスが詰まっていますので、書籍を用いて勉強することをオススメします。
以下の2冊がオススメ!


特にデータ解析のためのモデリング入門は通称緑本と呼ばれていて、ロジスティック回帰などの一般化線形モデリングから階層ベイズなどの統計モデリングの応用まで幅広く学べる良書です。
実装をWebサービスで勉強
書籍で勉強だけしていてもイメージがわかないと思うので是非当メディアが運営する以下のスクール「スタアカ(スタビジアカデミー)」で手を動かしながら学んでみてください!
公式サイト:https://toukei-lab.com/achademy/
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
データサイエンティストとしての自分の経験をふまえてエッセンスを詰め込んだのがこちらのスタビジアカデミー、略して「スタアカ」!!
当メディアが運営するスクールです。
月額1,280円のライトプランで、統計学から機械学習・生成AIまで全コースが受講し放題です!
プレミアムプランでは、24時間以内の質問対応と現役データサイエンティストとの1on1(30分×4回)を実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
他のスクールのカリキュラムはPythonでの機械学習実装だけに焦点が当たっているものが多く、実務に即した内容になっていないものが多いです。
そんな課題感に対して、実務で使うことの多いSQLや機械学習のビジネス導入プロセスの理解などもあわせて学べるボリューム満点のコースになっています!
ウォルマートのデータを使って商品の予測分析をしたり、実務で使うことの多いGoogleプロダクトのBigQueryを使って投球分析をしたり、データサイエンティストに必要なビジネス・マーケティングの基礎を学んでマーケティングプランを作ってもらったりする盛りだくさんの内容になってます!
ロジスティック回帰 まとめ
本記事では。ロジスティック回帰について見てきました!
最後に簡単にまとめておきましょう!
ロジスティック回帰を勉強した後は、統計学をより深めるか様々な機械学習手法を学ぶか、より広範にデータサイエンスを学ぶとよいでしょう!
以下の記事をぜひ参考にしてみてください!
 【初心者必見】統計学入門に必要な知識と独学勉強方法を簡単に学ぼう!当ブログ【スタビジ】の本記事では、統計学入門に必要な知識をカンタンにまとめ、それらをどのように効率的に独学で勉強していけばよいかをお話ししていきます。統計学は難しいイメージが少しありますが、学び方をしっかり考えれば大丈夫!
 【入門】機械学習のアルゴリズム・手法をPythonとRの実装と一緒に解説!当サイト【スタビジ】の本記事では、入門者向けに機械学習についてカンタンにまとめていきます。最終的にはどのように機械学習を学んでいけばよいかも見ていきます。細かい手法の実装もPython/Rを用いておこなっていくので適宜参考にしてみてください。
 【5分で分かる】データサイエンティストに必要なスキルと独学勉強ロードマップ!当サイト【スタビジ】の本記事では、データサイエンティストに求められるスキルとそれを身に付けるための勉強法について徹底的にまとめていきます!入門者でも、しっかりデータサイエンティストについて理解しある程度独学で駆け出しの状態までいけることを目指します。
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「統計学概要」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。