【初心者向け】Pythonでできること7選!サンプルコードをまじえて解説!

目次
 ウマたん
当サイト【スタビジ】の本記事では、Pythonでできることを7つまとめていきます!!Pythonで何ができるのか分からない状況から深い理解にもっていきますよー!実際にPythonでの実装例や勉強方法も取り上げているのでぜひご自分の環境で手を動かして実装してみてくださいね!
こんにちは!
データサイエンティストのウマたん(@statistics1012)です。
大学院時代は統計学専攻でRをメインに使っていましたが、社会人になってからはもっぱらPythonを使っています。
 ロボたん
RとPythonってどっちの方がよいのー?
ウマたんデータ解析の言語としてはRとPythonぶっちゃけどっちでもよいんだけど、やっぱりできることの幅はPythonの方が広いかなー!
実際のところ、RからPythonに移行してみてできることの幅は大きく広がりました!!
実際にPythonを学ぶにつれてPythonのできることの幅の広さに驚きPythonの魅力にのめり込んでいきました!
 【Python独学勉強法】Python入門を3ヶ月で習得できる学習ロードマップ当サイト【スタビジ】の本記事では、過去僕自身がPythonを独学を駆使しながら習得した経験をもとにPythonを効率よく勉強する方法を具体的なコード付き実装例と合わせてまとめていきます。Pythonはできることが幅広いので自分のやりたいことを明確にして勉強法を選ぶことが大事です。
とはいえ、Pythonでできることや学ぶ意味を知ってからじゃないと本腰入れて勉強できないですよねー!
そこで、この記事ではPythonで何ができるのか!について見ていきたいと思います。
実際にPythonでのコード例も記載しているのでぜひ参考にしてみてくださいねー!
ちなみに以下のUdemy講座でPythonで出来ることについて僕自身が話していますので詳しく知りたいという方はぜひ受講してみてください!
Pythonとは

まず、Pythonとはどんな言語なのか簡単にみていきましょう!
Pythonとは1991年に開発され現在全世界で非常に幅広い人に使用されている言語です。
他のプログラミング言語と比較してコードがシンプルで分かりやすく、エンジニアでなくても使いやすいのが特徴です。
ロボたんシンプルだとあんまりたくさんのことが出来ないんじゃないのー?
ウマたんいいや!シンプルでありながらも非常に多くのことができるんだよー!ビックリするはず!
そう、Pythonは簡単で分かりやすい言語でありながら非常に多くのことができる優秀な言語なんです!
最初に学ぶプログラミング言語としても最適ですよー!
Pythonでできること7つ【コード例】
そんなシンプルでプログラミング初心者にもやさしいPythonができることの幅広さはプログラミング言語の中でも随一!!
実際に何ができるのか具体的な例と共にみていきましょう!
以下のYoutube動画でも解説しています!

データ集計・加工・描画
データの集計・加工・描画に便利なnumpy/pandas/matplotlibなどのフレームワークが用意されており、簡単に行うことができます!
これらは、データ解析を行う下準備に必要になってくるので必須な初歩スキルです!
Rだとdplyrパッケージによって同等の処理ができますが、Pythonの方が圧倒的に使いやすいです。
簡単にIrisデータというあやめの花のデータをカンタンに加工・集計していきますよ!
###  1.データ集計・加工・描画

# ライブラリの読み込み
from sklearn import datasets
import pandas as pd

# irisデータの読み込み
iris = datasets.load_iris()
iris
##irisデータの可視化


data_df = pd.DataFrame(iris.data,columns=iris.feature_names)
target_df = pd.DataFrame(iris.target).rename(columns={0:'target'})

data_df.head()
##data_dfの上部5行が表示


data_df.shape
##行列構造が表示される (150,4)


target_df.head()
##target_dfの上部5行が表示


target_df.shape
##行列構造が表示される (150,1)


data_df.describe()
##統計量がカラムごとに表示される


data_df.columns
##カラム名が表示される


target_df['target'].unique()
##目的変数のカテゴリが表示


target_df['target'].value_counts()
##カテゴリごとのデータ数を集計


df = pd.concat([target_df,data_df],axis=1)
df.head()
##目的変数と説明変数を結合して可視化


df.groupby('target')['sepal length (cm)'].mean()
##目的変数でグルーピングして説明変数の平均を取る
実際に順を追って実装してみてくださいね!
data_df.head()
##data_dfの上部5行が表示
data_df.describe()
これだけの記述で統計量が確認できちゃうんです!
df.groupby('target')['sepal length (cm)'].mean()target
0 5.006
1 5.936
2 6.588
Name: sepal length (cm), dtype: float64
groupbyは非常にデータ集計に有用なので是非使いこなせるようにしてくださいね!
機械学習を使った回帰・分類
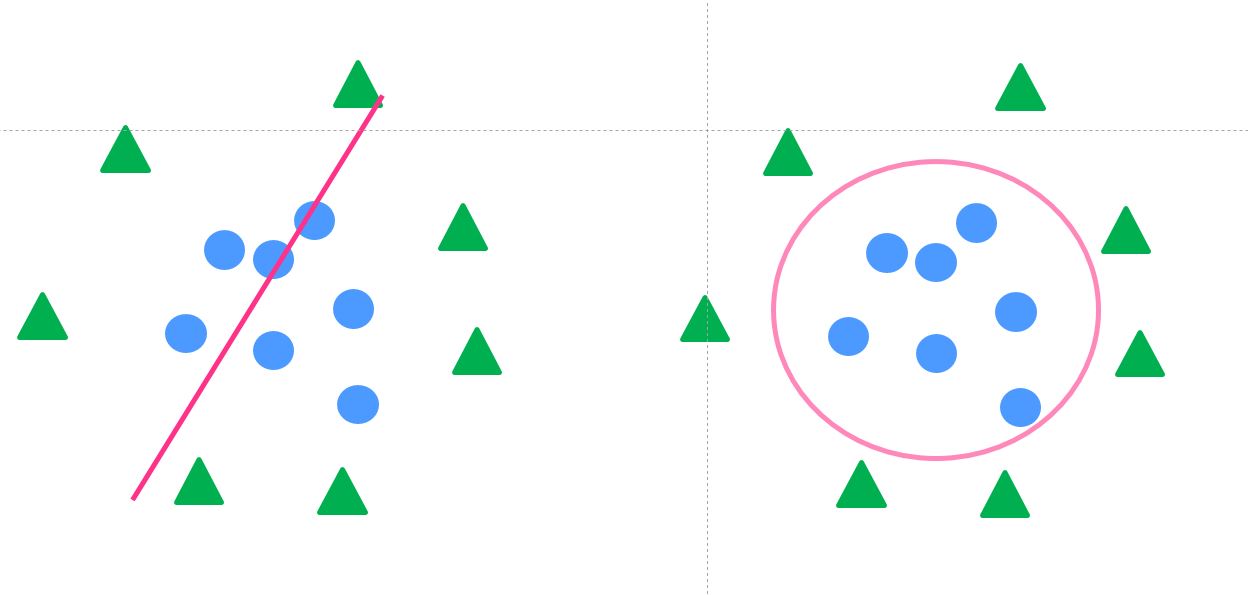
やはり、Pythonの特徴は機械学習フレームワークの充実。
様々な回帰・分類手法を実際に実装することが可能です。
最新の手法も比較的早くライブラリに実装されるので、最新のトレンドをキャッチアップしやすいのが特徴です。
機械学習手法は非常に多くの種類があります。
その中でも最もよく使われる手法の1つであるLight gbmについて見ていきましょう!
Light gbmは決定木と勾配ブースティングを組み合わせた勾配ブースティング木の1種で非常に強力なことから実務でもデータ分析コンペでもよく用いられます。
ここでは、データ分析コンペ DataDojoの「中古マンション価格予測チャレンジ」というコンペのデータに対してLight gbmを実装してみたいと思います。
国産データコンペのNishika(2026年3月にサービス終了)で開催されていたトレーニングコンペで、今はDataDojoで同じコンペに無料で参加できます。
Pythonであればいとも簡単に実装することができるんです!
まず DataDojoにGoogleアカウントでログインし、コンペの「データ」タブから学習データ(train.zip)とテストデータ(test.csv)をダウンロードしてください(※ログインしないとデータをダウンロードできません)。
ダウンロードしたデータに対してデータフレームを作成し、前処理を施した上でLight gbm を適用させていきます。
コードは以下になります。
import glob
import pandas as pd
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_absolute_error as mae

files = glob.glob("train/*.csv")
data_list = []
for file in files:
    data_list.append(pd.read_csv(file, index_col=0))
df = pd.concat(data_list)

def data_pre(df):
    nonnull_list = []
    for col in df.columns:
        nonnull = df[col].count()
        if nonnull == 0:
            nonnull_list.append(col)
    df = df.drop(nonnull_list, axis=1)

    df = df.drop("市区町村名", axis=1)

    df = df.drop("種類", axis=1)

    dis = {
        "30分?60分":45,
        "1H?1H30":75,
        "2H?":120,
        "1H30?2H":105
    }
    df["最寄駅:距離(分)"] = df["最寄駅:距離(分)"].replace(dis).astype(float)

    df["面積(㎡)"] = df["面積(㎡)"].replace("2000㎡以上", 2000).astype(float)


    y_list = {}
    for i in df["建築年"].value_counts().keys():
        if "平成" in i:
            num = float(i.split("平成")[1].split("年")[0])
            year = 33 - num
        if "令和" in i:
            num = float(i.split("令和")[1].split("年")[0])
            year = 3 - num
        if "昭和" in i:
            num = float(i.split("昭和")[1].split("年")[0])
            year = 96 - num
        y_list[i] = year
    y_list["戦前"] = 76
    df["建築年"] = df["建築年"].replace(y_list).astype(float)

    year = {
        "年第1四半期": ".25",
        "年第2四半期": ".50",
        "年第3四半期": ".75",
        "年第4四半期": ".99"
    }
    year_list = {}
    for i in df["取引時点"].value_counts().keys():
        for k, j in year.items():
            if k in i:
                year_rep = i.replace(k, j)
        year_list[i] = year_rep
    df["取引時点"] = df["取引時点"].replace(year_list).astype(float)

    for col in ["都道府県名", "地区名", "最寄駅:名称", "間取り", "建物の構造", "用途", "今後の利用目的", "都市計画", "改装", "取引の事情等"]:
                df[col] = df[col].astype("category")

    return df

df = data_pre(df)

df_train, df_val =train_test_split(df, test_size=0.2)

col = "取引価格(総額)_log"
train_y = df_train[col]
train_x = df_train.drop(col, axis=1)

val_y = df_val[col]
val_x = df_val.drop(col, axis=1)

trains = lgb.Dataset(train_x, train_y)
valids = lgb.Dataset(val_x, val_y)

params = {
    "objective": "regression",
    "metrics": "mae"
}

model = lgb.train(params, trains, valid_sets=valids, num_boost_round=1000, callbacks=[lgb.early_stopping(100)])

df_test = pd.read_csv("test.csv", index_col=0)
df_test = data_pre(df_test)

predict = model.predict(df_test)
df_test["取引価格(総額)_log"] = predict
df_test[["取引価格(総額)_log"]].to_csv("submit_test.csv")
LightGBM 4.0からearly_stopping_roundsの引数はなくなったので、callbacksでlgb.early_stopping(100)を渡しています。
最後の部分でテストデータの予測値をsubmit_test.csvに書き出しているので、コンペの「提出」タブからアップロードすれば自動で採点されます(評価指標はRMSEです)。
以下の記事でより詳しくLight gbmの実装についてまとめていますのでチェックしてみてください!
 【図解で解説】LightGBMの仕組みとPythonでの実装を見ていこう!当サイト【スタビジ】の本記事では、最強の機械学習手法「LightGBM」についてまとめていきます。LightGBM の特徴とPythonにおける回帰タスクと分類タスクの実装をしていきます。LightGBMは決定木と勾配ブースティングを組み合わせた手法で、Xgboostよりも計算負荷が軽い手法であり非常によく使われています。
ちなみにディープラーニング(深層学習)まわりの手法も比較的カンタンに実装できちゃいます。
一般的な機械学習と比較すると高度な手法ですが、それでもPythonを使えば簡単に実装することができるんですよー!
TensorflowやKerasなどの使いやすいフレームワークが用意されているのです。
実際にディープラーニングを実装しているコードを以下に記載しておきます。
以下は手書き文字の分類タスクにディープラーニングを適用させています。
import numpy as np
from sklearn.model_selection import train_test_split
import tensorflow as tf
from tensorflow.keras.datasets import mnist
from tensorflow import keras
from tensorflow.keras.layers import Dense, Activation
from tensorflow.keras.models import Sequential
from tensorflow.keras.utils import to_categorical


# Kerasに付属の手書き数字画像データをダウンロード
np.random.seed(0)
(X_train_base, labels_train_base), (X_test, labels_test) = mnist.load_data()

# Training set を学習データ(X_train, labels_train)と検証データ(X_validation, labels_validation)に8:2で分割する
X_train,X_validation,labels_train,labels_validation = train_test_split(X_train_base,labels_train_base,test_size = 0.2)

# 各画像は行列なので1次元に変換→X_train,X_validation,X_testを上書き
X_train = X_train.reshape(-1,784)
X_validation = X_validation.reshape(-1,784)
X_test = X_test.reshape(-1,784)

#正規化
X_train = X_train.astype('float32')
X_validation = X_validation.astype('float32')
X_test = X_test.astype('float32')
X_train /= 255
X_validation /= 255
X_test /= 255

# labels_train, labels_validation, labels_test をダミー変数化して y_train, y_validation, y_test に格納する
y_train = to_categorical(labels_train)
y_validation = to_categorical(labels_validation)
y_test = to_categorical(labels_test)

# パラメータの設定
n_features = 784
n_hidden   = 100
bias_init = 0.1

# 学習率
rate       = 0.01

# Sequentialクラスを使ってモデルを準備する
model = Sequential()

# 隠れ層を追加
model.add(Dense(n_hidden,activation='relu',input_shape=(n_features,)))
model.add(Dense(n_hidden,activation='relu'))
model.add(Dense(n_hidden,activation='relu'))

# 出力層を追加
model.add(Dense(10,activation='softmax'))

# TensorFlowのモデルを構築
model.compile(optimizer=tf.optimizers.Adam(rate),
              loss='categorical_crossentropy', metrics=['mae', 'accuracy'])

# Early stoppingを適用してフィッティング
log = model.fit(X_train, y_train, epochs=3000, batch_size=100, verbose=True,
                callbacks=[keras.callbacks.EarlyStopping(monitor='val_loss',
                                                     min_delta=0, patience=10,
                                                         verbose=1)],
                validation_data=(X_validation, y_validation))

# Test dataで予測を実行。
pred_test = model.predict_classes(X_test)

validation = (pred_test == labels_test)
size       = validation.size
size
correct    = np.count_nonzero(validation)
print(f"{correct}/{size} correct ({correct*100/size:.3f}%)")
具体的には以下の記事にまとめていますので見てみてください!
 【入門】ディープラーニング(深層学習)の仕組みとPython実装のやり方!当サイト【スタビジ】の本記事では、ディープラーニングの仕組みやPythonでの実装方法について解説していきます。ディープラーニングってなんとなくブラックボックスなイメージがあるかもしれませんが、実はシンプルなアルゴリズムなんですよー!
本当に色々な機械学習手法が実装できます。
機械学習手法はここで取り上げたLight gbm やディープラーニング以外にもたくさんの手法がありますので気になる方は以下の記事でチェックしてみてください!
 【入門】機械学習のアルゴリズム・手法をPythonとRの実装と一緒に解説!当サイト【スタビジ】の本記事では、入門者向けに機械学習についてカンタンにまとめていきます。最終的にはどのように機械学習を学んでいけばよいかも見ていきます。細かい手法の実装もPython/Rを用いておこなっていくので適宜参考にしてみてください。
WEBスクレイピング

WEBスクレイピングとはWEB上の情報をクロールして抽出することのできる方法です。
毎回手動でデータを引っ張ってくるのは非常に面倒であるため、スクレイピングを使って自動でデータを引っ張ってくることが多いです。
非常に応用の範囲が広い技術で、様々な場面で用いられています。
例えば、スクレイピングを使うことで株価の情報などを自動的に日々抽出して自動売買するなど応用が可能です。
スクレイピングはPythonの「Requests」「beautifulsoup」というライブラリを使えば簡単に実装可能です。
ただスクレイピングはサーバーに負荷がかかるのでスクレイピングが対象サイト内で禁止されていないか注意しましょう!
実際にURLを渡すとページ内pタグのテキストを返してくれるスクレイピングを実装したコードを載せておきます。
#!/usr/bin/python3
# -*- coding: utf-8 -*-
#ライブラリーインポート
import requests
from bs4 import BeautifulSoup
from time import sleep

#スクレイピング
class Scr():
    def __init__(self, urls):
        self.urls=urls

    def geturl(self):
        all_text=[]
        for url in self.urls:
            r=requests.get(url)
            c=r.content
            soup=BeautifulSoup(c,"html.parser")
            article1_content=soup.find_all("p")
            temp=[]
            for con in article1_content:
                out=con.text
                temp.append(out)
            text=''.join(temp)
            all_text.append(text)
            sleep(1)
        return all_text

sc=Scr(["https://toukei-lab.com/conjoint","https://toukei-lab.com/correspondence"])
print(sc.geturl())
スクレイピングについて詳しく知りたい方は以下の記事を見てみてください!
 【初心者向け】PythonのBeautiful Soupでスクレイピングを実装してみよう!当サイト【スタビジ】の本記事では、初心者向けにPythonでスクレイピングを行う上での注意点や実装方法そして勉強方法についてまとめていきます!スクレイピングは比較的カンタンに実装できますが、奥が深く他の知識と組み合わせることで高いシナジーが見込める分野です。
データベース操作
なんとPythonからSQLを使うことも出来ちゃうんです!
 SQLを最速でマスターできる勉強方法とオススメ本・サイト当サイト【スタビジ】の本記事では、SQLを勉強するのにオススメな本と勉強法についてまとめていきます!SQLはデータサイエンスの基本であり必ずマスターしておかなくてはいけない言語です。早い段階から手を動かすことで理解が深まりますよー!
もちろんSQLの知識は必要ですか、PythonからSQLに接続しDB操作しSQLの記述で抽出・加工し戻すことが可能です。
PythonでSqlite3を使用するコード例を以下に載せておきます。
import sqlite3

dbname = 'trains.db'

conn=sqlite3.connect(dbname)
c = conn.cursor()

# executeメソッドでSQL文を実行する
create_table = 'create table toukeilab (id value,name verchar)'
c.execute(create_table)

# SQL文に値をセットする場合は,Pythonのformatメソッドなどは使わずに,
# セットしたい場所に?を記述し,executeメソッドの第2引数に?に当てはめる値をタプルで渡す.
sql = 'insert into toukeilab (id, name) values (?,?)'
namelist = (1, "uma")
c.execute(sql, namelist)

conn.commit()

select_sql = 'select * from toukeilab'

c.execute(select_sql)
result=c.fetchone()

conn.close()

print(result)
以下の記事で詳しくまとめていますのでよければ見てみてください!
 【DB作成】PythonのSqlite3を使ってデータベースを操作する方法を見ていこう!当サイト【スタビジ】の本記事では、PythonのSqlite3を使ってデータベース操作をおこなっていきます。PythonでSQL扱えると便利!もちろんPythonだけでなくSQLの知識も必要になるので注意してくださいねー!
API連携
外部アプリケーションのAPIを叩いてデータ連携することが可能です。
現在は様々なアプリケーションにおいてAPIが公開されているので、どんどんAPIを取り入れていくことが重要です!!
ちなみにGoogle search consoleのAPIを叩いて検索クエリを抽出するコード例を以下に載せておきまーす!
import pandas as pd
from googleapiclient.discovery import build
from oauth2client.service_account import ServiceAccountCredentials

url = ['https://www.googleapis.com/auth/webmasters.readonly']
file = '[JSONファイルの置き場所]'
credentials = ServiceAccountCredentials.from_json_keyfile_name(url, file)
webmasters = build('webmasters', 'v3', credentials=credentials)

domain = '[あなたのドメイン]'
dimensions = ['query', 'page']
startDate = '2019-10-01'
endDate = '2019-11-01'
rowLimit = 5000

body = {
    'startDate': startDate,
    'endDate': endDate,
    'dimensions': dimensions,
    'rowLimit': rowLimit
}

response = webmasters.searchanalytics().query(siteUrl=domain, body=body).execute()
df = pd.io.json.json_normalize(response['rows'])

for i, d in enumerate(dimensions):
    df[d] = df['keys'].apply(lambda x: x[i])

df.drop(columns='keys', inplace=True)
df.to_csv('{}.csv'.format(start_date), index=False)
print(df)
詳しい内容は以下の記事を見てみてください!
 Pythonを使ってGoogle search console(サーチコンソール)のAPIを叩いてみた!当サイト【スタビジ】の本記事では、Pythonを使ってGoogle search console(サーチコンソール)のAPIを利用してみます。PythonはAPIを利用するのに非常に便利です。Googleプロダクトは各種APIを提供していてAPIを使うことで様々なことができるので試してみましょう!
またChatGPTのAPIとPythonを組み合わせることでより自由な処理が可能になります。
例えば、”田中さんの6/30のスケジュールを教えてー!”と入力するとGPTのAPIと連携し、言葉から必要な関数を判別・実行して結果(この例だとスケジュール内容)を返答するプログラムを作成できます。
GPTのAPIを呼ぶ処理は以下になります。
def run_conversation(prompt):
    # GPTのAPIへのリクエストを定義
    input_list = [{"role": "user", "content": prompt}]
    tools = [
        {
            "type": "function",
            "name": "get_schedule",
            "description": "特定の日付のスケジュールを取得して返す",
            "parameters": {
                "type": "object",
                "properties": {
                    "date": {
                        "type": "string",
                        "description": "日付"
                    },
                    "person": {
                        "type": "string",
                        "description": "人の名前"
                    },
                },
                "required": ["date","person"]
            }
        }
    ]
    response = client.responses.create(
        model="gpt-6-luna",
        input=input_list,
        tools=tools,
        tool_choice="auto",
    )
詳しくは以下の記事を見てください!
 ChatGPTの便利API機能「Function calling」をPythonで実装!自分だけのAI Agentを作ってみよう!当サイト【スタビジ】の本記事では、ChatGPT(正確にはGPTモデル)のAPIに新しく追加されたFunction callingという機能について解説していきたいと思います。実際にPythonを使ってFunction callingでどんな処理が構築できるのか実装していきますよ!
このように生成系AIもPythonを使って実装することが出来ます。
当メディアが運営するスタアカの以下のコースで詳しく解説しているので、チェックしてみて下さい!
Pythonを使ったAPI利用についてはより詳しく以下の記事でまとめています!
 【5分で分かる】Pythonを使って様々なサービスのAPIを利用してみよう!当サイト【スタビジ】の本記事では、Pythonを使ってSlackやGoogleのAPIを利用していきます!APIを利用することで非常に様々なことができるので是非試してみましょう!APIを使えるようになると幅が広がりますよ!
自動化
Pythonではブラウザ操作などを自動化することもできます!
例えば「Selenium」というWeb ブラウザの操作を自動化するためのフレームワークをPythonで動かすことが出来ます
Seleniumをpip installするだけではなく、Chromeブラウザを操作するためのChrome Driverのダウンロードが必要です。
この時、使っているChromeブラウザのバージョンとChrome Driverのバージョンが一致するように気を付けましょう!
ここが一致しないと上手く動作しません。
Chrome Driverは以下のページからダウンロードしてください。
自分が使っているChromeブラウザのバージョンはブラウザ右上の3点リーダーメニューから以下のように確認することができます。
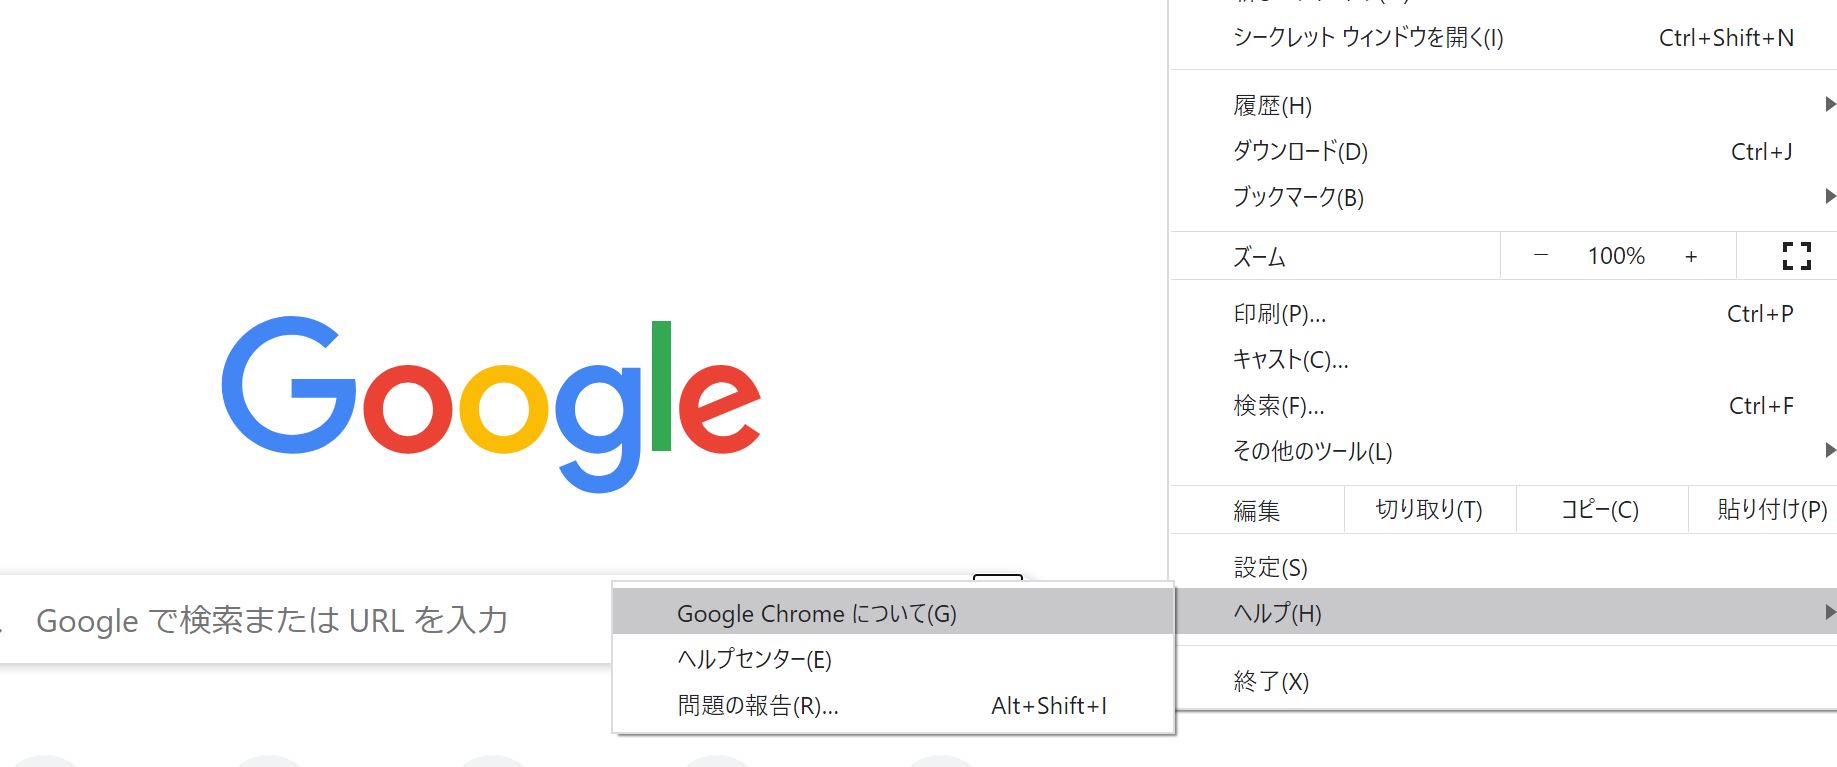
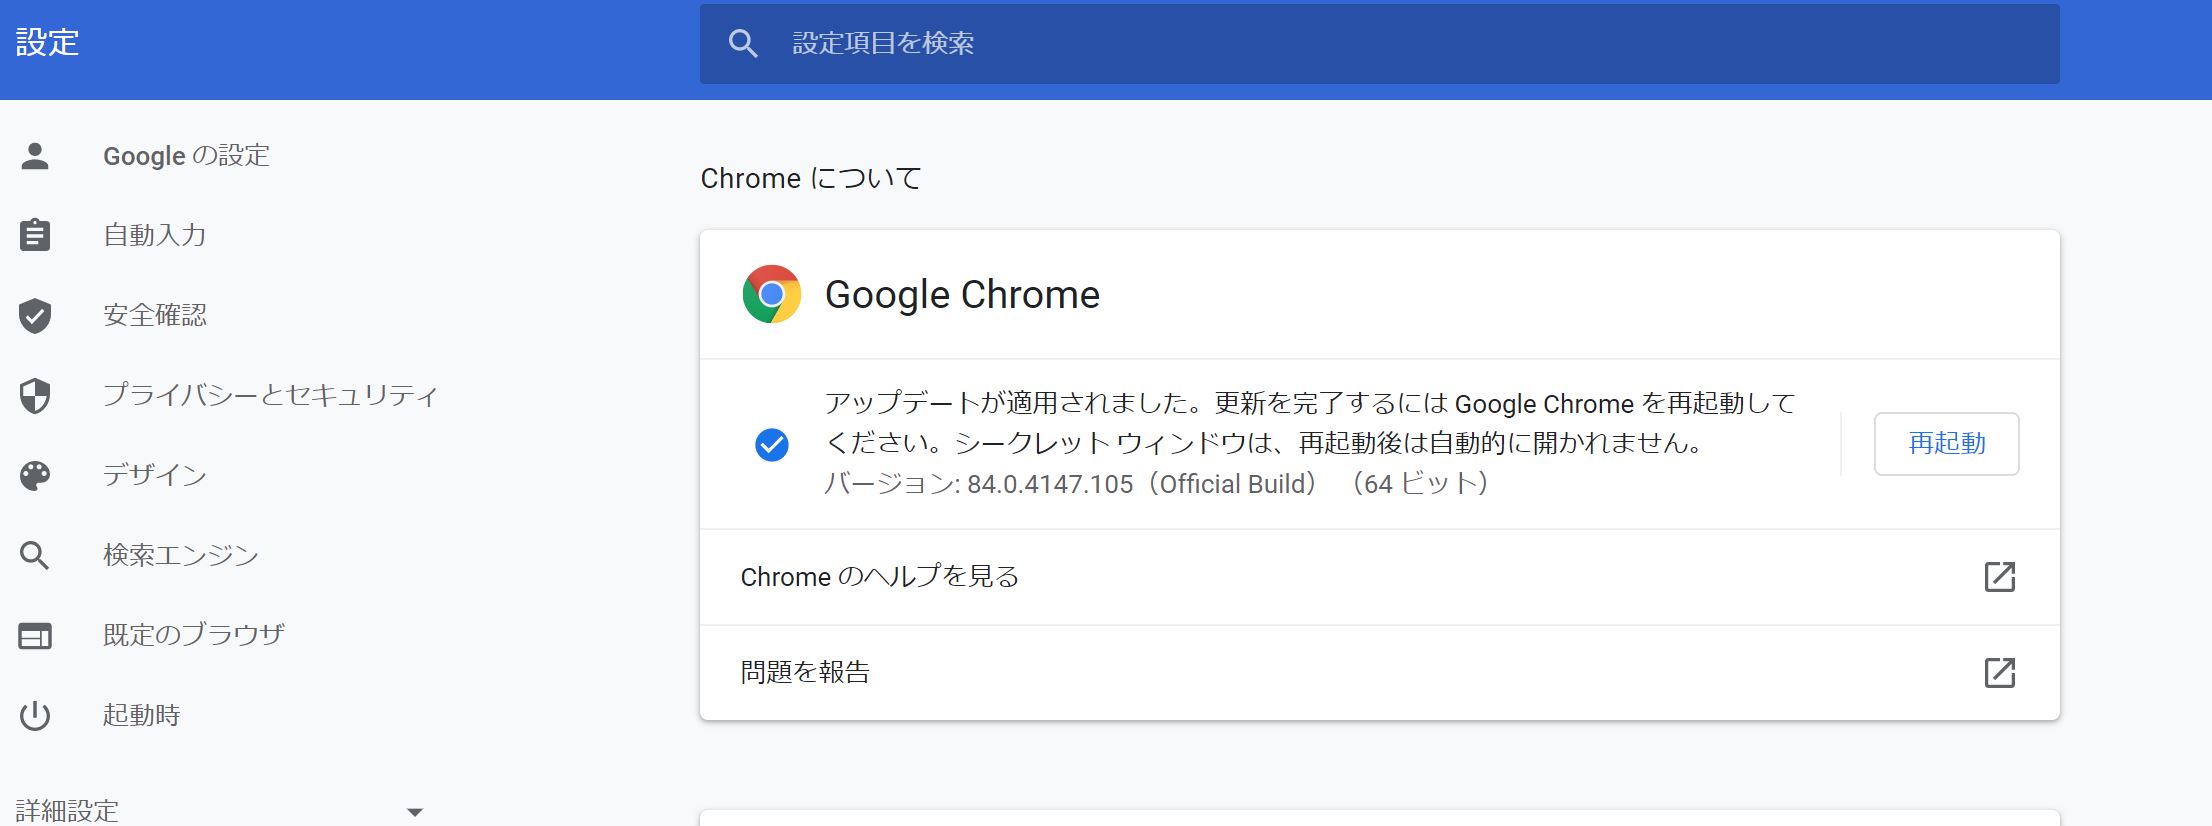
この場合使っているChromeブラウザのバージョンは84なので、Chrome Driverのバージョンも84を選ぶようにしましょう!
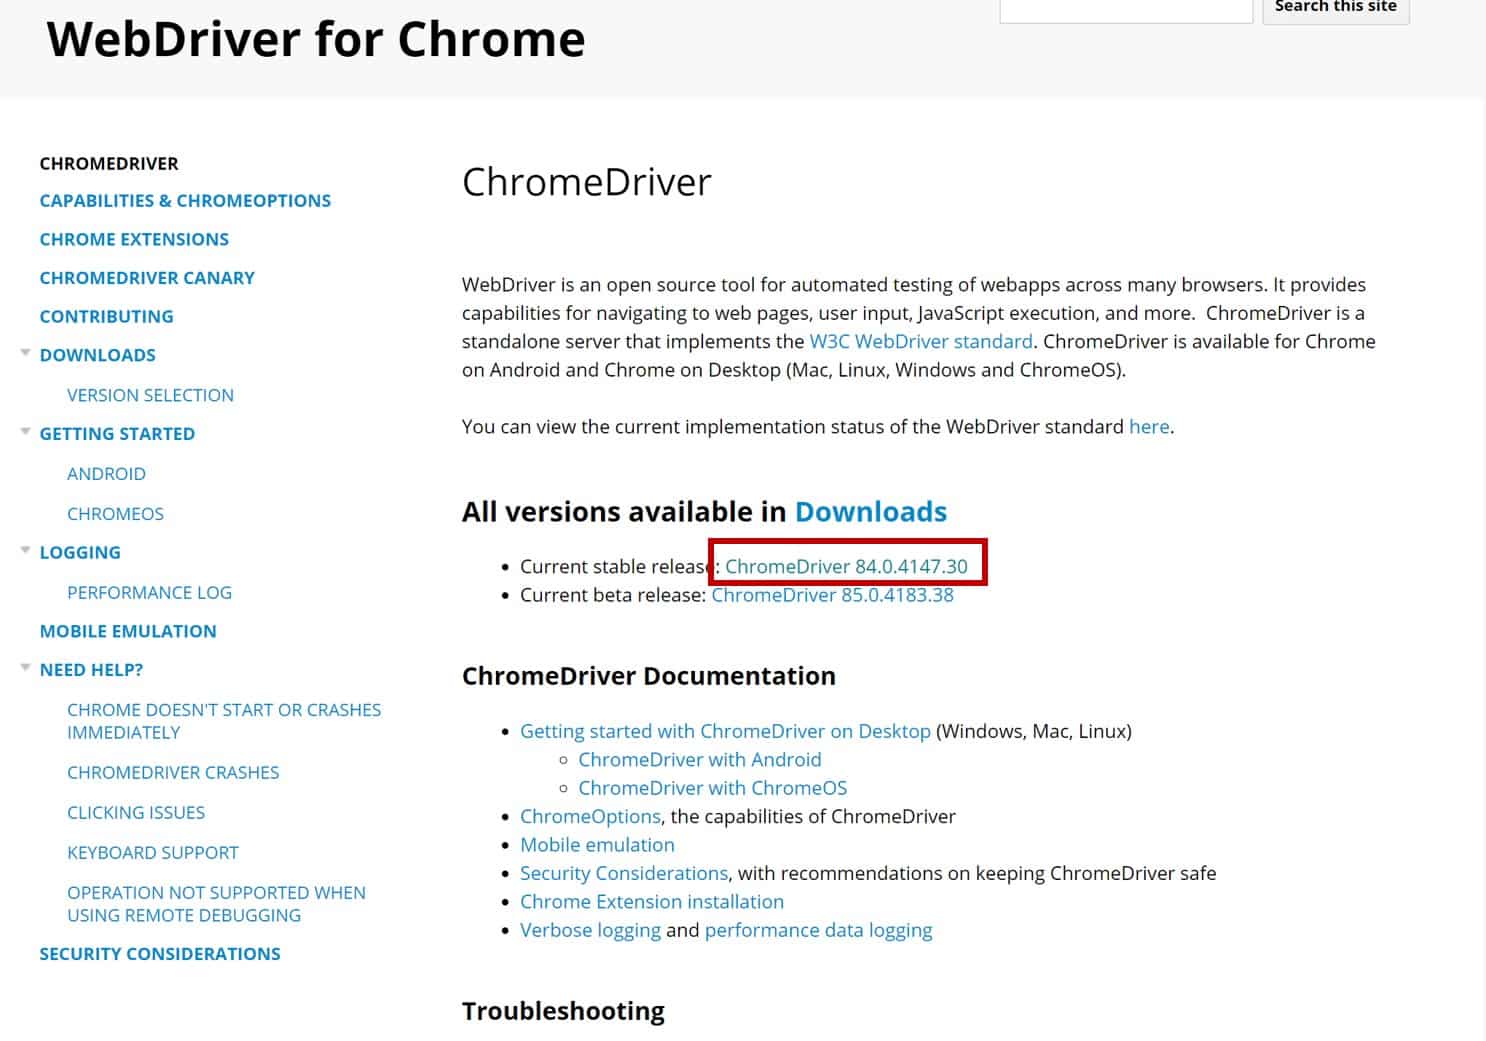
ダウンロードしたChrome Driverは任意のディレクトリフォルダに格納しておきましょう。
Googleで検索をして上位1位のサイトをクリックしてh2タグの情報を取得して、画面をスクリーンショットで保存する処理を以下にまとめています。
from selenium import webdriver
import time

driver = webdriver.Chrome()

#Googleのブラウザを開く
driver.get('https://www.google.com/')
time.sleep(2)

#スタビジを検索
search_box = driver.find_element_by_name('q')
search_box.send_keys('スタビジ')
search_box.submit()
time.sleep(2)

#検索結果1位をクリック
g = driver.find_elements_by_class_name("g")[0]
r = g.find_element_by_class_name("r")
r.click()

#h2の要素を取得
for h2 in driver.find_elements_by_tag_name("h2"):
    print(h2.text)

#画面キャプチャ
driver.maximize_window()
driver.save_screenshot('スタビジ.png')

#ブラウザを閉じる
driver.quit()
SeleniumをPythonで動かす方法に関しては以下の記事で詳しくまとめていますので、ぜひチェックしてみてください!
 【コード付き】Selenium×Pythonの使い方!Chromeブラウザを自動操作してみようー!当サイト【スタビジ】の本記事では、SeleniumをPythonで動かしてChromeブラウザ上で行う操作を自動化していきます。非常に簡単なコードを記述するだけで操作できるのでぜひ試してみてください!Seleniumを駆使すれば普段の単純労働が全自動になるかもしれませんよ!
また、Pythonの自動化については以下の記事で詳しくまとめています。
 Pythonの自動化で出来ることの例と独学実装ロードマップを徹底解説!【PyAutoGUI/Selenium】当サイト【スタビジ】の本記事では、Pythonで出来る自動化について徹底的に見ていきたいと思います!様々な業務を自動化して、ルーティン業務をなくしていくことであなたの仕事や生活は格段に楽になるはずです!Pythonの自動化で出来ること・勉強ロードマップ・そして最終的に簡単な実装を見ていきます。
Webアプリケーション開発
最後がWebアプリケーション開発!!
機械学習やAPI連携・スクレイピングだけでなく、FlaskやDjangoなどのフレームワークを用いれば、サーバーサイド言語としてWebアプリケーション開発に用いることができるんです!!!
 【違いは?】Flask vs Django!PythonのWebアプリケーションフレームワークを徹底比較!当サイト【スタビジ】の本記事では、PythonのWebアプリケーションフレームワークである「Flask」と「Django」の違いを徹底的に比較していきます!なんとなーく分かっているようで分からない2つのフレームワークの違いをこの機会にしっかりおさえておきましょう!
Webアプリケーションの開発は、Pythonの真骨頂でありRとの大きな違いでもあります。
ただ、RubyやPHPなどの言語と比較すると処理速度が遅いなどのデメリットも存在します。
PythonでのWebアプリ開発については以下の記事で詳しくまとめていますのでチェックしてみてください!
 【入門初心者向け】PythonでWebアプリを作ってみた!開発方法徹底解説!当サイト【スタビジ】の本記事では、PythonのWebアプリケーションフレームワークを用いてWebアプリを開発していく方法を徹底解説していきます。実際にDjangoでの実装とFlaskでの実装をおこなっていったあと、勉強法についても見ていきましょう!
Flaskを用いて、有意差を計算するWebアプリケーションを作成した記事を以下にまとめています。
 Flaskでできることを確認しながら簡単なWebアプリを作ってみよう!当サイト【スタビジ】の本記事では、Pythonの軽量WebアプリケーションフレームワークであるFlaskを使って簡単なWebアプリケーションを作成していきたいと思います。Pythonを開発言語としても使えるようになると、幅が広がりますよー!
またDjangoでの開発については以下の記事でまとめています。
 PythonのDjangoを使ってWebアプリを実装しHerokuでデプロイしていくステップと勉強法本記事では、PythonのDjangoを使って簡易的なWebアプリケーションを作成し、さらにそれをHeokuというサービスにデプロイしていく方法についてまとめていきます!Djangoは簡単にWebアプリケーションを作成できるフレームワーク…
 Djangoの学習におすすめのサイトと勉強を進める上での注意点本記事では、PythonのDjango(ジャンゴ)というWebアプリケーションを作成するフレームワークを学習する方法をまとめていきます!Djangoは簡単にWebアプリケーションを作成できるフレームワークなのですが、なかなか学習するのに苦…
Pythonのメリット
Pythonでできることは分かってもらえたと思いますが、これらを実装できる言語は他にもあります。
ロボたん他の言語があるのに、なんでPythonを使う必要があるのー??
ウマたんうんうん、確かに疑問に思うのも無理はない!Pythonにどんなメリットがあるのか見ていきましょう!
データ分析が絡むなら単体で強力
まあデータ分析関係なら基本的にPythonの右に出る言語は今のところいないでしょう。
Rはグラフ描画に、Stanはモデリングに優れていたりしますが、総合的にはやはりPythonですねー!!
 統計解析を行う上で便利なプログラミング言語を比較!当サイト【スタビジ】の本記事では、統計解析において便利なプログラミング言語「Python/R/Stan/SQL」を比較していきます。それぞれのプログラミング言語にどのような特徴があるのか、どのように勉強していけばよいのか見てきますよー!
データ分析がしたいならPythonを選んでおいて問題はないです。
コードがシンプル
Pythonはコードの階層構造を大事にしており、それがズレると構文エラーを起こします。
最初は慣れないかもしれませんが、慣れると非常に構文がスッキリしていてどんな人が書いた構文でも比較的読みやすいです!
Udemyの以下の講座で、Python記法のルールが身に付くので興味のある方はぜひチェックしてみてください!
コードもシンプルで済みます。
できることの幅が広い
さきほど見てきましたが、できることが7つもあるのです!!
そんな言語は他には存在しません。
スクレイピングで時系列データで情報を吸い上げて、それを基に予測を行いそれを出力するWebアプリケーションなどもPythonで完結できちゃいますね
ロボたんわー!いいことばかり!デメリットはないの??
ウマたんデメリットは処理速度が遅いところかなー!多様性に適用するために速度が犠牲になっているんだ!
Pythonを勉強する方法
Pythonで出来ることやPythonを使うメリットが分かったところで、そんなPythonをどのように勉強していけばよいのでしょうか?
僕自身、なかなかPythonの勉強が捗らず苦労した経験があります。
そんな僕がオススメするPythonの勉強方法をまとめていきます!
僕自身、Udemy・PyQなどのサービスをコスパよく利用していました。
Pythonはできることの幅が広いので、まずはPythonを使って何をしたいのかを明確にするべきです。
Pythonで出来ることについては以下のUdemy講座を僕自身が公開していますので是非参考にしてみてください!
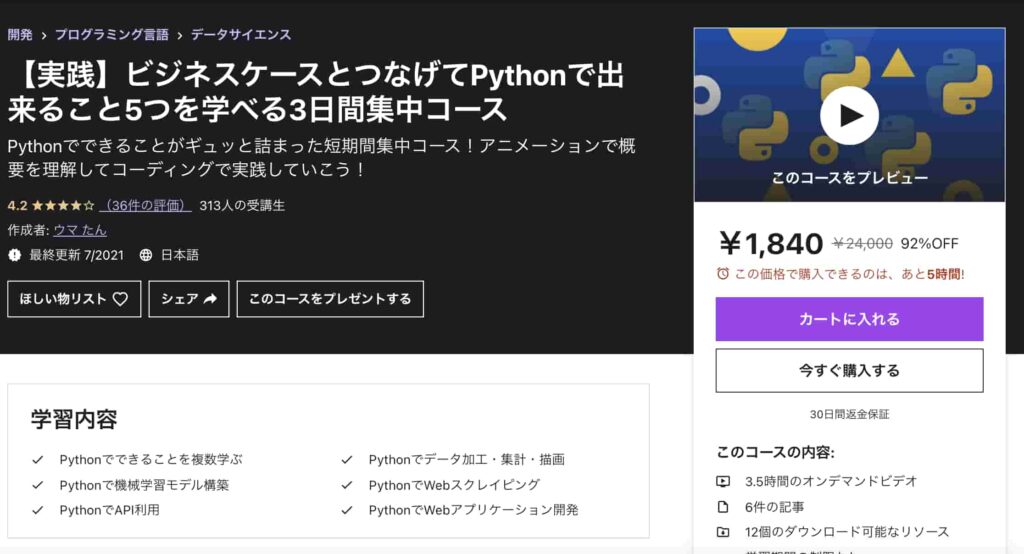
【実践】ビジネスケースとつなげてPythonで出来ること5つを学べる3日間集中コース
| 【オススメ度】 | |
|---|---|
| 【講師】 | 僕自身!今なら購入時に「FLSHDGEJURXF」という講師クーポンコードを入れると90%オフ以上の割引価格になりますのでぜひご受講ください! |
| 【時間】 | 3.5時間 |
| 【レベル】 | 初級~中級 |
手前味噌ですが、まずPythonについて理解してみるのにオススメなコースを僕自身が出しています!
Pythonで出来ることのうち以下の5つを網羅して学んでいきます。
データ集計・加工・描画と機械学習モデル構築に関してはKaggleというデータ分析コンペティションのWalmartの小売データを扱いながら学んでいきます。
WebスクレイピングとAPI利用とWebアプリケーション開発に関しては、楽天の在庫情報を取得してSlackに自動で通知するWebアプリケーションを作成して学んでいきます。
Pythonで何ができるのか知りたい!という方には一番はじめにまず受けていただきたいコースです!
Pythonを使って実現したいことが明確でない人と明確な人では勉強法が違いますので別々にみていきますね。
ちなみにこの記事で紹介してきたPythonで出来ることについては以下の書籍で小説形式でまとめていますのでよければ見てみてください!

価格は300円ちょっとですし、Kindle unlimitedであれば無料で読めるのでぜひチェックしてみてくださいね!
Pythonで何がしたいのか明確な人にオススメの勉強法
まずは、Pythonで何がしたいのか明確な人!
独学で自走できる人におすすめのサービスを紹介していきます!
Udemy
公式サイト:https://www.udemy.com/
| 【価格】 | 1200円~(コース売り切り型) |
|---|---|
| 【オススメ度】 |
何がしたいのか明確な人はUdemyで自分の実現したいことを解説してくれている講座を受講してみるとよいでしょう!
Udemyは世界最大のオンライン学習プラットフォームなんです!
コースは買い切り制で気に入らなかったら返品もできるので非常におすすめです。
こちらも手前味噌ですが、僕自身がデータ分析関連のUdemyコースを公開しています!!
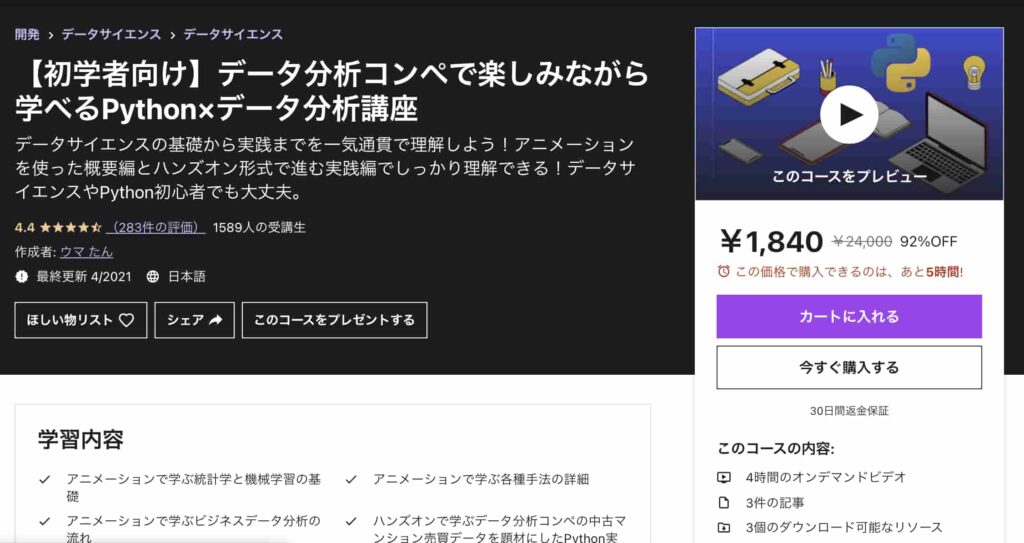
【初学者向け】データ分析コンペで楽しみながら学べるPython×データ分析講座
| 【オススメ度】 | |
|---|---|
| 【講師】 | 僕自身!今なら購入時に「FLSHDGEJURXF」という講師クーポンコードを入れると90%オフ以上の割引価格になりますのでぜひご受講ください! |
| 【時間】 | 4時間 |
| 【レベル】 | 初級~中級 |
僕自身がUdemyの色んなコースを受けてみた中で、他のコースにはないこんなコースあったらいいなみたいなコースを作ってみました。
このコースは、なかなか勉強する時間がないという方に向けてコンパクトに分かりやすく必要最低限の時間で重要なエッセンスを学び取れるように作成しています。
アニメーションを使った概要編とハンズオン形式で進む実践編に分かれており、概要編では体系的にデータ分析・機械学習導入の文脈でまとめています。
データサイエンスの基礎について基本のキから学びつつ、なるべく堅苦しい説明は抜きにしてイメージを掴んでいきます。
統計学・機械学習の基本的な内容を学び各手法の詳細についてもなるべく概念的に分かりやすく理解できるように学んでいきます。
そしてデータ分析の流れについては実務に即したCRISP-DMというフレームワークに沿って体系的に学んでいきます!
データ分析というと機械学習でモデル構築する部分にスポットがあたりがちですが、それ以外の工程についてもしっかりおさえておきましょう!
続いて実践編ではデータコンペの中古マンションのデータを題材にして、実際に手を動かしながら機械学習手法を実装していきます。
ここでは、探索的にデータを見ていきながらデータを加工し、その上でLight gbm という機械学習手法を使ってモデル構築までおこなっていきます。
是非興味のある方は受講してみてください!
PyQ
 公式サイト:https://pyq.jp
| 【価格】 | 3040円/月~ |
|---|---|
| 【オススメ度】 |
PyQはPythonに特化したサービスです。
完全オンライン学習サービスで、定額制で全ての講座を受講することができます。
実際に手を動かすことをかなり重視しているので、楽しくモチベーションを保ちながら進めることが可能です。
インターフェイスが使いやすくてサクサク進められます。

正直Pythonを素早く身に付けて実装してみたい!かつお金も安く済ませたい!ならPyQ一択です。
ただ完全自力なので、モチベーションが続かないと厳しいです。
以下の記事でPyQの体験を基に詳しくレビューしています。
 【体験談】PyQの評判は?3か月本気でPythonを勉強してみたので徹底レビュー!PyQはPythonを学ぶ上で非常にオススメで評判の高いサービスです。ただ、他のサービスとの違いが分かりにくいのも事実。そこで当サイト【スタビジ】では、実際にPyQを3か月体験した僕がPyQのメリット・デメリット・評判について徹底的にレビューしていきます!
Pythonで何がしたいのか明確でない人にオススメの勉強法
さて、Pythonで何がしたいのか明確でない人はまずはそれを見つけることが大事なのですが無理やり見つけてUdemyで講座を購入してもなかなかモチベーションが保てず途中で辞めてしまう可能性大です。
そんな人にオススメのサービスを紹介しておきましょう!
スタビジアカデミー(スタアカ)
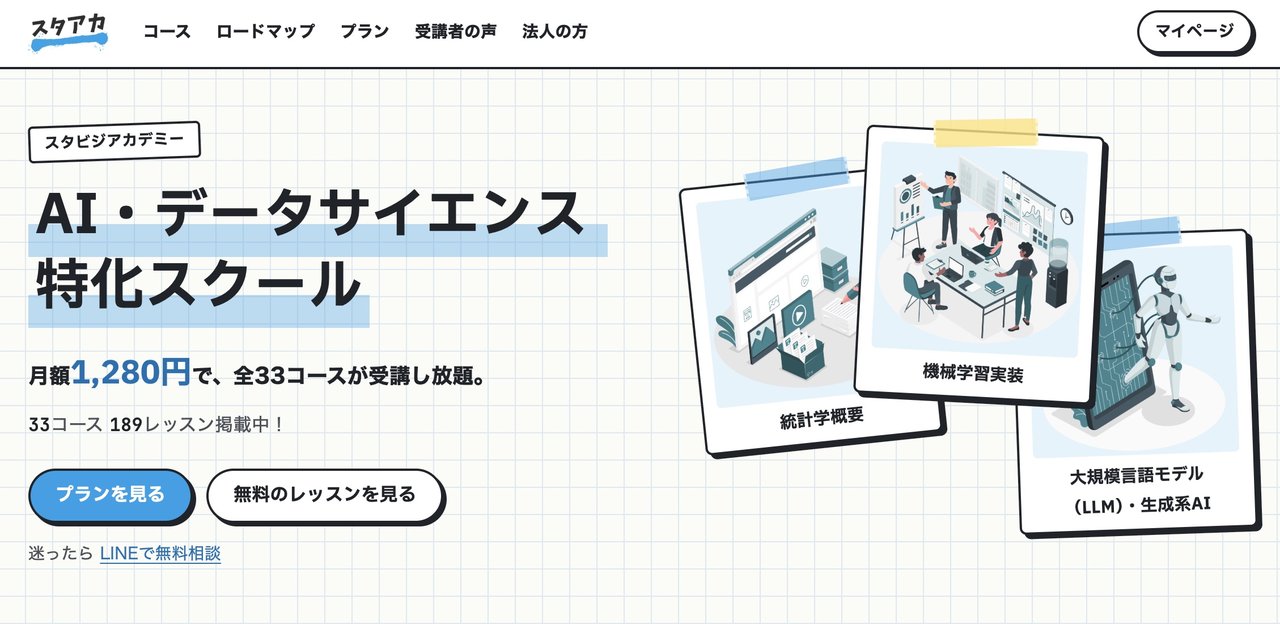
公式サイト:https://toukei-lab.com/achademy/
| 【価格】 | ライトプラン:1,280円/月(全コースが受講し放題) プレミアムプラン:129,800円(通常149,800円・買い切り) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【学習範囲】 | 統計学・機械学習・ディープラーニングを網羅的に学ぶ 生成AI(LLM・RAG・プロンプトエンジニアリング)を学ぶ SQLとPythonを組み合わせて実データを使った様々なワークを行う 実践的なビジネスフレームワークを学ぶ マーケティングの実行プラン策定 |
データサイエンティストとしての自分の経験をふまえてエッセンスを詰め込んだのがこちらのスタビジアカデミー、略して「スタアカ」!!
当メディアが運営するスクールです。
月額1,280円のライトプランで、統計学から機械学習・生成AIまで全コースが受講し放題です!
プレミアムプランでは、24時間以内の質問対応と現役データサイエンティストとの1on1(30分×4回)を実施します!
カリキュラム自体は、他のスクールと比較して圧倒的に良い自信があるのでぜひ受講してみてください!
ウォルマートのデータを使って商品の予測分析をしたり、実務で使うことの多いGoogleプロダクトのBigQueryを使って投球分析をしたり、データサイエンティストに必要なビジネス・マーケティングの基礎を学んでマーケティングプランを作ってもらったりする盛りだくさんの内容になってます!
テックアカデミー
公式サイト:https://techacademy.jp/
| 【価格】 | 163,900円~(4週間) |
|---|---|
| 【オススメ度】 | |
| 【サポート体制】 | |
| 【受講形式】 | オンライン形式 |
| 【データサイエンティスト範囲】 | ベーシックな内容、ビジネスサイドはなし |
価格は3か月で284,900円!
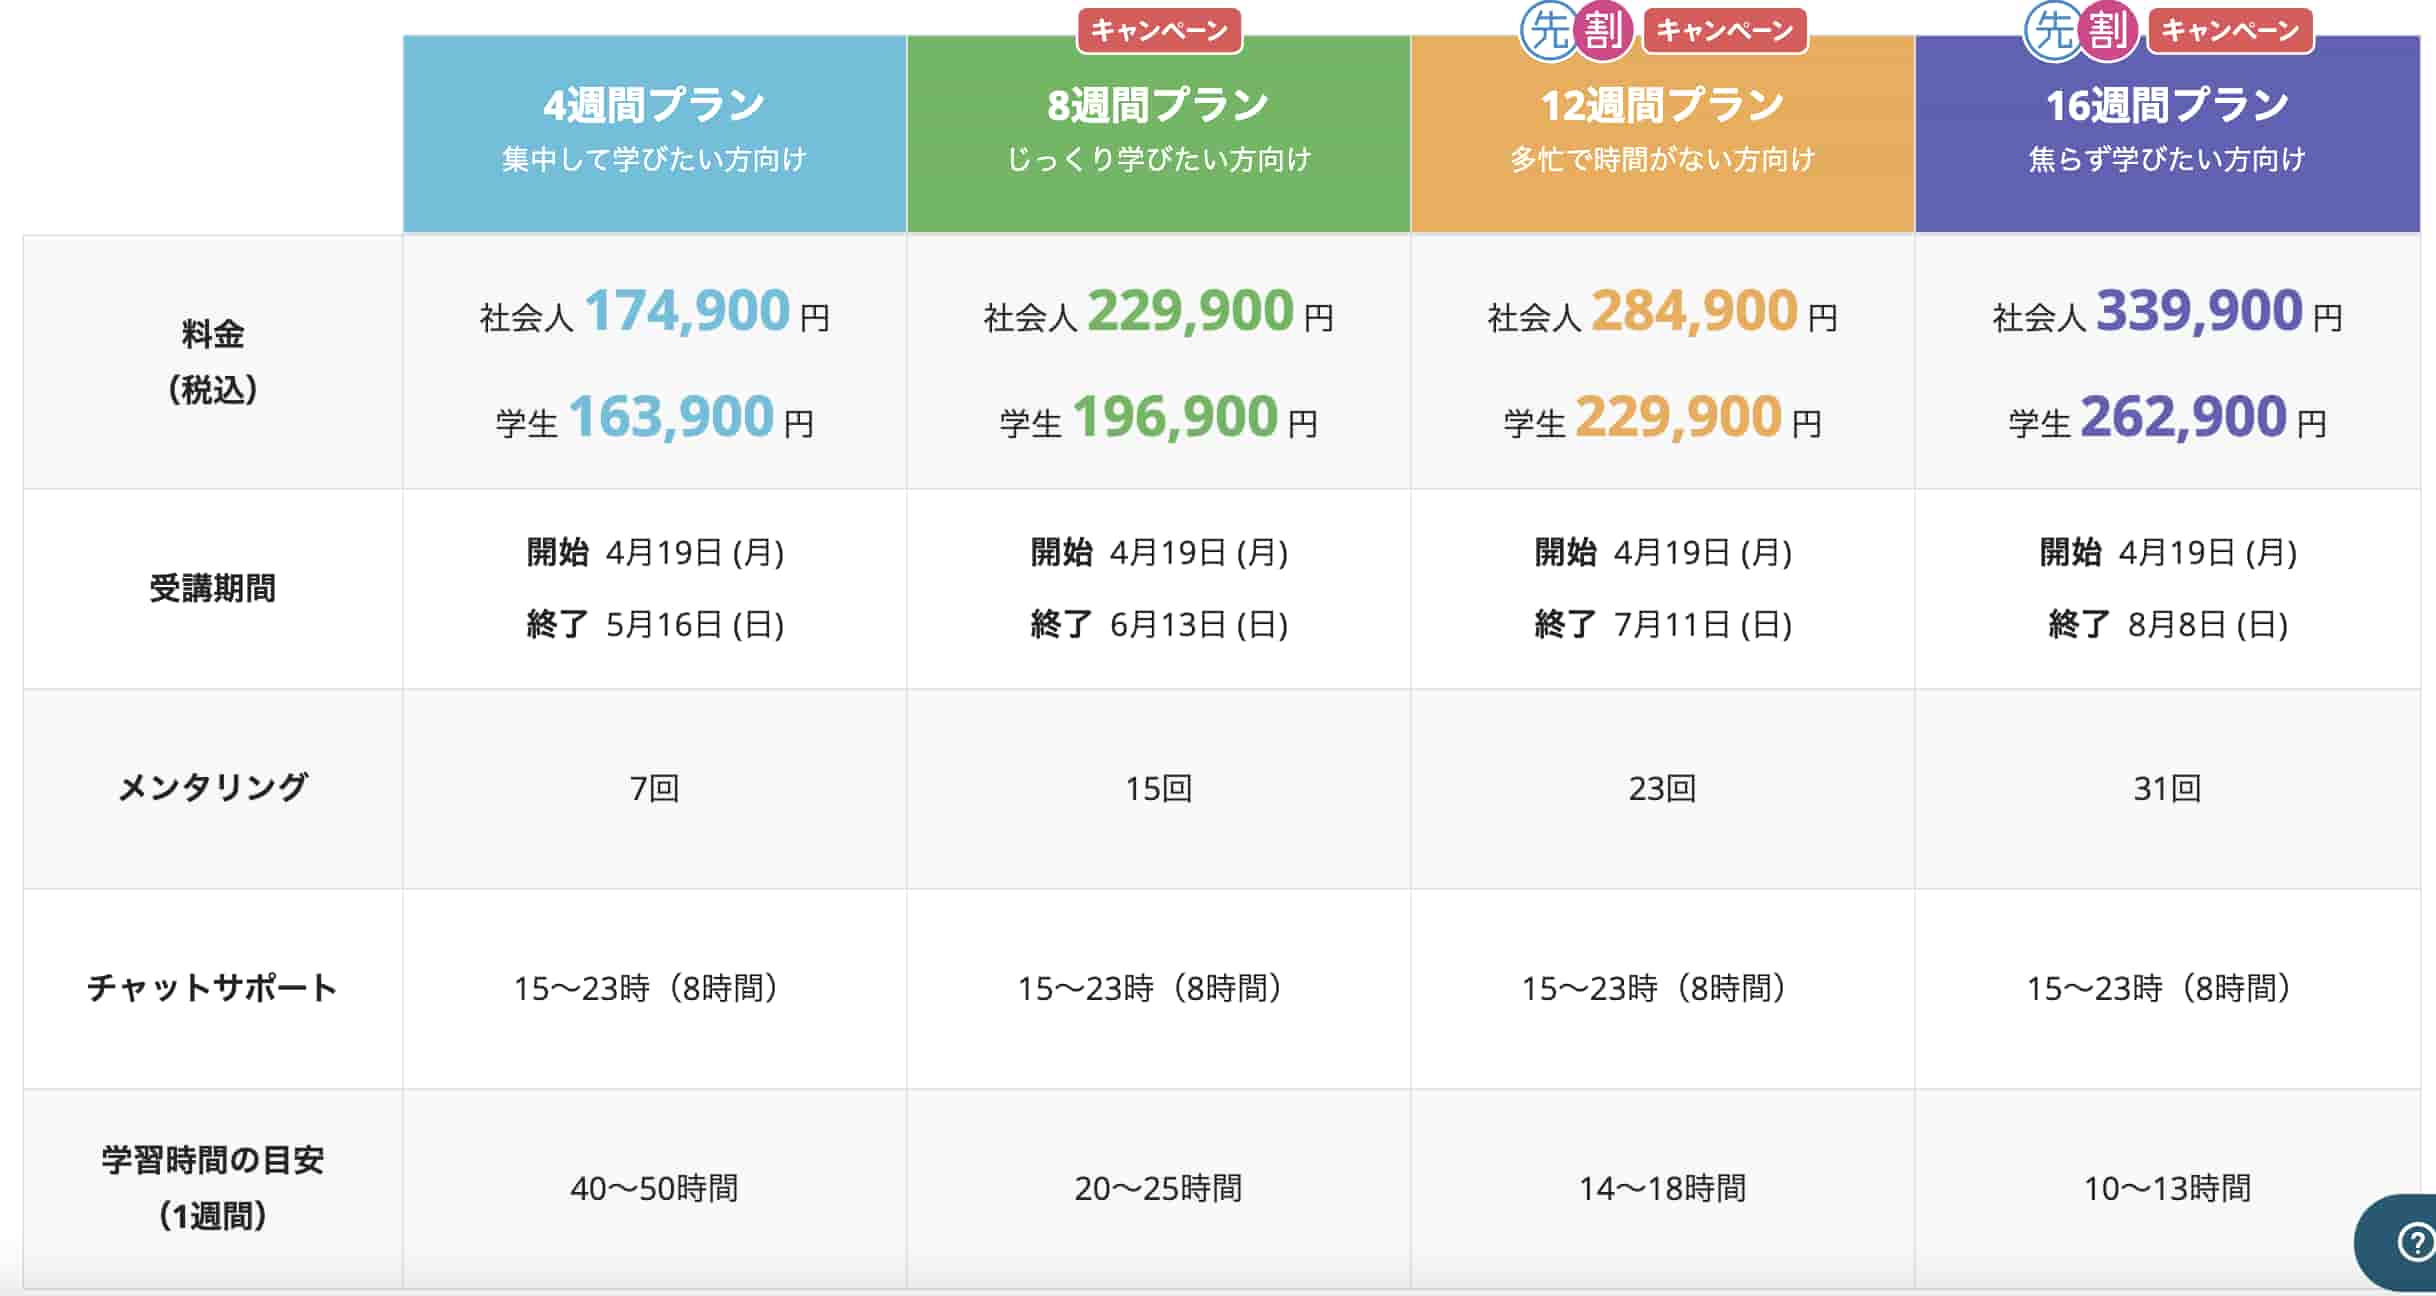
日本最大級のプログラミングスクールで安心して受講することのできるプログラミングスクールになっています。

他のプログラミングスクールと比較して、メンターサポート制度が非常に充実しているのが特徴です。
特にメンターのレスポンスの速さは異常!!
15時~23時の時間内であれば、誰かしらが高速レスポンスで返してくれます。
チャットサポートとは別に専任のパーソナルメンターが付きます。
メンターとの相性もありますが、合わなければ代えてもらうこともできます。
テックアカデミーのAIコースの先生、超美人!!だけどすごくしっかりしていて、進め方も的確だしこれはかなり力がつくという確信があります
— ayaka@python (@ayakapython) November 28, 2018
メンターの人に頼めば自分の裁量でカリキュラムの範囲外まで詳しく学べるので自分でガツガツやる気のある人には非常にオススメです!
しっかり自分の中で目標を持ってメンターを使い倒すくらいの気概を持って進めましょう!
やる気があればメンターの方と一緒に深い内容まで踏み込んで学ぶことが可能です!
僕自身カリキュラムを猛スピードで終わらせてメンターの人とガンガン壁打ちしながら色んな分野を学んだ過去があります。
ウマたん結局はプログラミングスクールは環境なので、それをどう使うかは自分次第!!
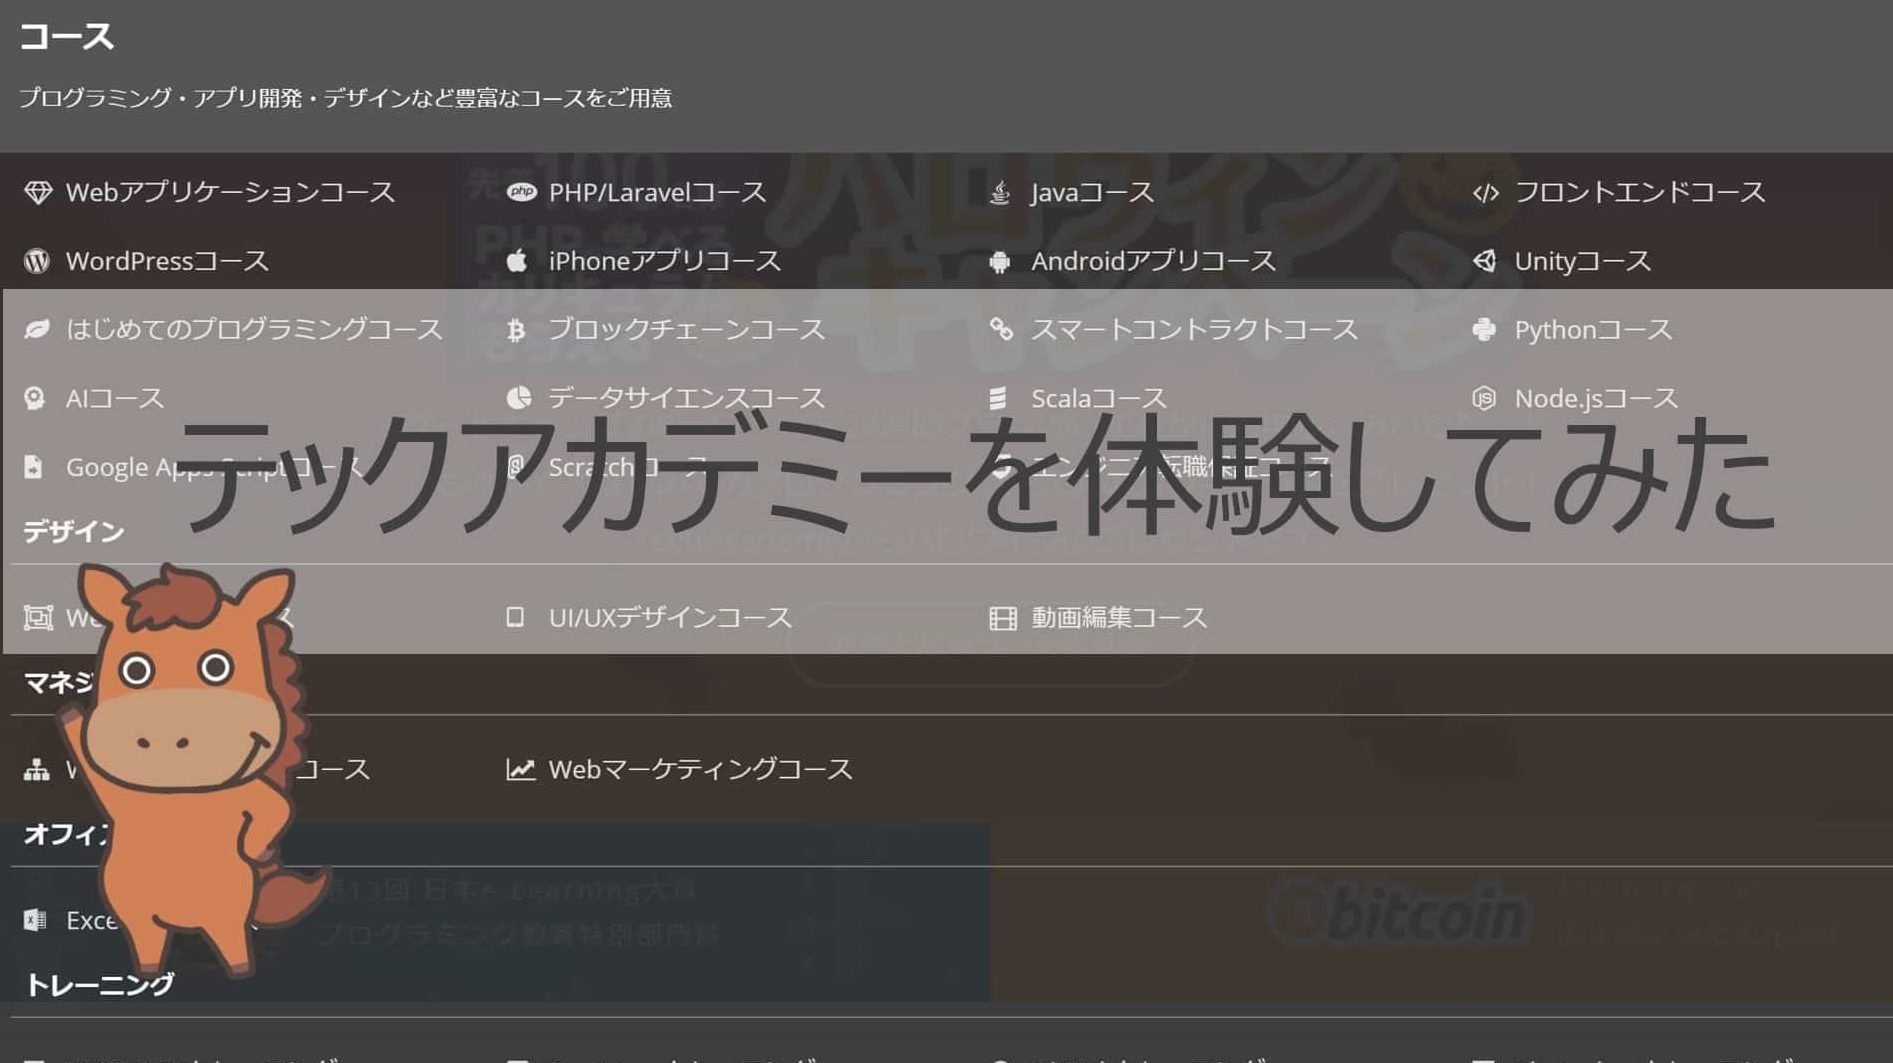
ちなみにテックアカデミーのデータサイエンティスト系の講座には以下のようなコースがあります。
ある程度言語を触ったこのある方であればAIコースやデータサイエンスコースを単体で受講してしまっても問題ありません。
また、テックアカデミーのAIコースではディープラーニングで画像認識が出来ることが最終目的でWebアプリケーションの開発などは行いません!
無料体験もできますので、不安な方はまずは無料体験を試してみることをオススメします!
以下の記事で体験談をより詳しくまとめていますので是非チェックしてみてください!
 【体験談】テックアカデミー評判は?3か月本気受講してみたので徹底レビュー!当ブログ【スタビジ】では、様々なプログラミングスクールの中からテックアカデミーのメリット・デメリット・評判について3か月の体験談をもとに赤裸々にレビューしていきます。
Pythonを学べるプログラミングスクールは他にもたくさんあります。以下の記事でまとめていますので是非見てみてください!
 【2022年最新】Python学習に最適なオンラインスクールおすすめ6選当サイト【スタビジ】の本記事では、実際にスクールに通ったりWebサービスを利用したりしながらPythonを習得した僕がおすすめするオンラインメインのスクールを紹介していきます。正直Python学習スクールは乱立し過ぎていてどれを選べばよいのか難しい!そんな人にぜひ読んで欲しいです
また、Pythonの勉強に関しては以下の記事で詳しくまとめていますのでチェックしてみてください!
【Python独学勉強法】Python入門を3ヶ月で習得できる学習ロードマップ当サイト【スタビジ】の本記事では、過去僕自身がPythonを独学を駆使しながら習得した経験をもとにPythonを効率よく勉強する方法を具体的なコード付き実装例と合わせてまとめていきます。Pythonはできることが幅広いので自分のやりたいことを明確にして勉強法を選ぶことが大事です。
PythonでできることのFAQ
最後に今まで解説してきたことをFAQ形式でまとめておきましょう!
Q1. Pythonでどんなことができるの?
Q2. Pythonにはどんなメリットがあるの?
Q3. Pythonを勉強するのにどんなサービスがあるの?
Pythonでできること まとめ
このように実際にあらためて見ていくと本当にPythonはできることの幅の広い優れたプログラミング言語だなーと思います。
ロボたんPythonってこんなにたくさんのことができるんだねー!知らなかったよー!
ウマたんデータ分析だけの言語と思われがちだけど、実は色んなことができるんだよー!
Pythonの勉強に関しては以下の記事で詳しくまとめていますのでチェックしてみてください!
【Python独学勉強法】Python入門を3ヶ月で習得できる学習ロードマップ当サイト【スタビジ】の本記事では、過去僕自身がPythonを独学を駆使しながら習得した経験をもとにPythonを効率よく勉強する方法を具体的なコード付き実装例と合わせてまとめていきます。Pythonはできることが幅広いので自分のやりたいことを明確にして勉強法を選ぶことが大事です。
ウマたん目指せPythonマスター!
また、Pythonでは作れるものを以下の記事で解説しているので、興味がある方は以下の記事をチェックしてみて下さい。
 初心者でもできる!Pythonで作れるもの3選!当サイト【スタビジ】の本記事では、初心者でもPythonを使って作ることが出来るものを3つ紹介します!Pythonを勉強してみたい方は、本記事で実際に手を動かして、Pythonで出来ることのイメージをつかんでみて下さい!
できることがたくさんあってもやりたいことがないとなかなかプログラミング言語は継続しません。
プログラミングの勉強を挫折せず効率よく進める方法は以下の記事を見てみてください!
【やる気UP!】プログラミングを挫折しない!たった3つの方法当サイト【スタビジ】の本記事では、プログラミングを挫折しないで独学で勉強し続けられる方法についてまとめていきます。プログラミングを挫折し続けてきたからこそ伝えられる価値があると思い、今までの経験を基に徹底的にお話しいていきますよー!
大学院は理系の統計科学研究室で、ベイズ統計学・時系列分析・異常検知を研究。日系・外資の消費財メーカーのデータサイエンティストを経て、現在は会社を経営しながらデータサイエンティストとして働いています。
読んだ内容を、スタアカの「Python基礎」コースで身につける
データサイエンス・AIを、動画と課題で体系的に学べるオンラインスクール。最初のレッスンは無料で見られます。